快速导读:STARWM 用自监督动力学训练的交叉注意力决定哪里该重建,双流解码在停止梯度隔离下只把相关区域写入潜空间,在 DMC 视频背景干扰下保持稳健。
模型基强化学习里的世界模型,理想状态是:在紧凑潜空间里忠实模拟环境动力学,同时别被任务无关像素拖着跑。重建式模型接地扎实,却按像素面积分摊梯度;去掉重建又可能误删仍相关的外观细节。
STARWM(arXiv:2609.30667 ,NeurIPS 2026,乌尔姆大学与德国宇航中心)用自监督动力学训练交叉注意力,决定“哪里该重建”,再用停止梯度把路由与内容提取隔开。默认无奖励版本在随机视频干扰上最强,奖励增强的 STARWM-R 则在顺序视频干扰上补齐短板。
英文题目:STARWM: Self-Supervised Trained Attention Routing for Robust World Models
论文出处:arXiv 每日论文精选 · arXiv:2609.30667
原始论文:PDF / 论文页面
这篇论文解决什么问题?
DreamerV3 一类方法用稠密重建保证观察空间接地,但大面积动态背景会占用表示容量,形成重建偏差。
重建无关方法用对比、一致性或冗余削减避开该偏差,却缺少像素级 grounding,可能丢掉对策略仍有用的细节。
把重建与辅助目标硬塞进同一潜空间,往往会陷入梯度拉扯:一边要留住一切,一边只要特定子空间。需要机制显式回答“重建应作用在何处”。
核心创新
- 把 where-to-attend 与 what-to-extract 拆开:自监督训路由,重建只塑形被关注区域内容。
- 停止梯度隔离,避免重建/RSSM 梯度改写注意力,缓解目标冲突。
- 双流解码+残差 VAE:相关内容进 RSSM,无关背景只服务重建且不进想象。
- 路由监督源可换:默认无奖励自监督,STARWM-R 可接入任务奖励。
方法概览
在 DreamerV3 编码器中层特征上做 N 个可学习 query 的交叉注意力,得到空间软掩码。注意力参数仅由逆动力学与时序对比等自监督信号训练;下游用停止梯度后的掩码把特征分成进入 RSSM 的动力学实体 token,与只服务重建、想象时丢弃的残差/背景流。双流解码:动力学流空间广播回绘,残差流走辅助 VAE 瓶颈吸收无关细节,再按覆盖掩码特征级合成。奖励增强变体 STARWM-R 把奖励梯度接到路由。
- STARWM 截获编码器中层 C×H×W 特征,加位置编码后由 N 个可学习 query 做缩放点积注意力,得到 N 张空间软掩码,用于跟踪不同实体或肢体。
- 路由监督默认来自逆动力学(由相邻注意力池化特征预测动作)与时序对比学习;关键是停止梯度:下游 RSSM 与解码只看到 sg(A),注意力参数不被重建损失改写。
- 双流解码:动力学流把 RSSM 特征按掩码空间广播回绘;残差流经辅助 VAE 瓶颈吸收非预测背景,想象滚动时丢弃。两者在特征级按覆盖掩码合成后再上采样重建,避免软掩码在像素级偷偷编码形状。
- 总损失在 Dreamer 骨干项之外加 λinv Linv、λctr Lctr 与残差 KL。若自监督不足以消歧智能体与时间一致背景,STARWM-R 增加奖励预测头,把任务相关性接入空间掩码。
逐图理解论文
注意力路由
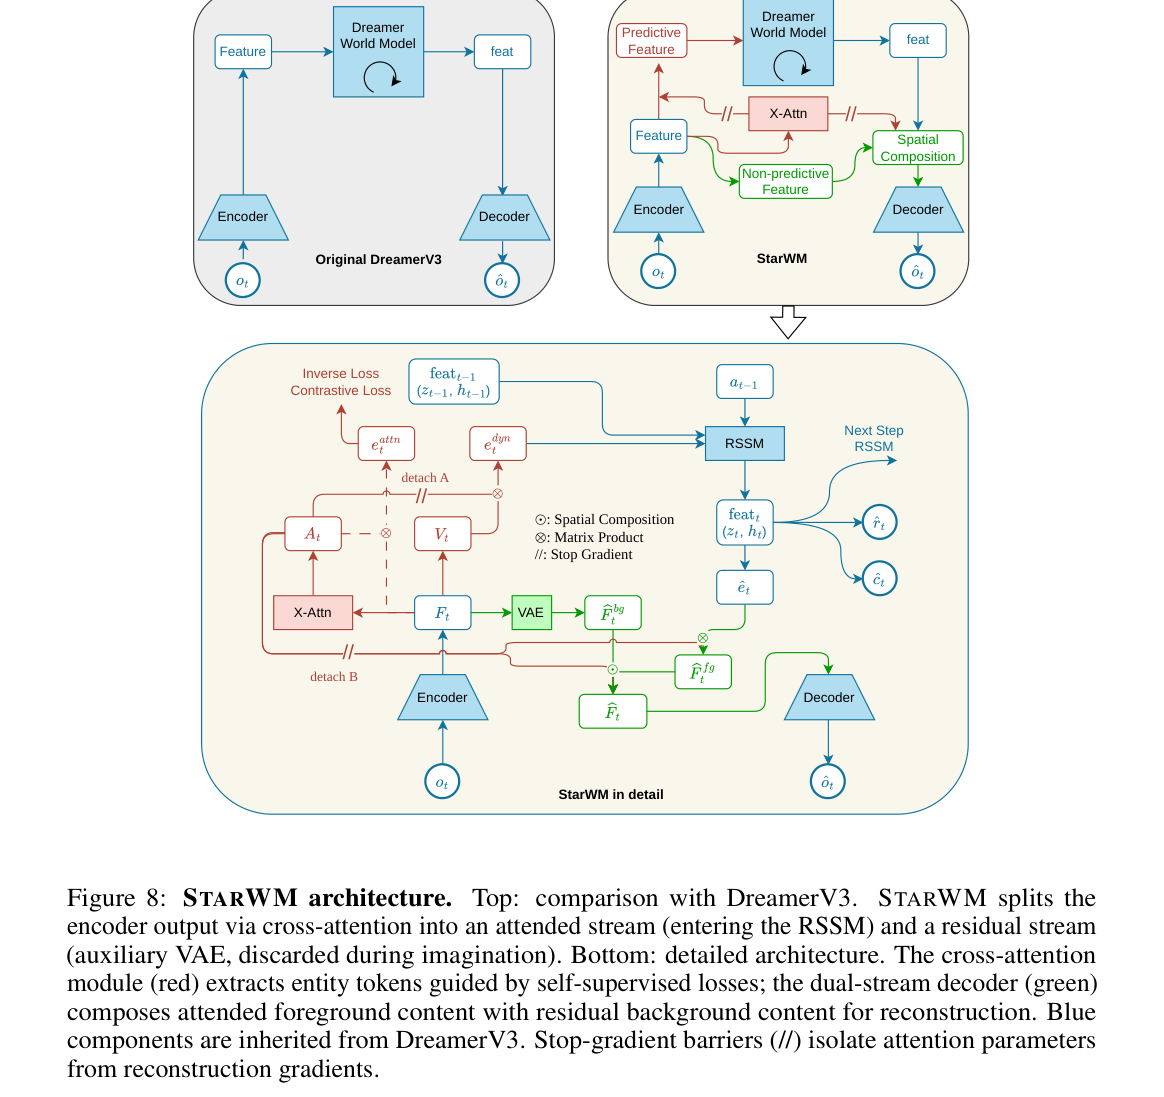
图8对比 DreamerV3 单流与 STARWM 双流,并展开 X-Attn、RSSM、残差 VAE 与空间合成细节,是方法主图。
关键证据
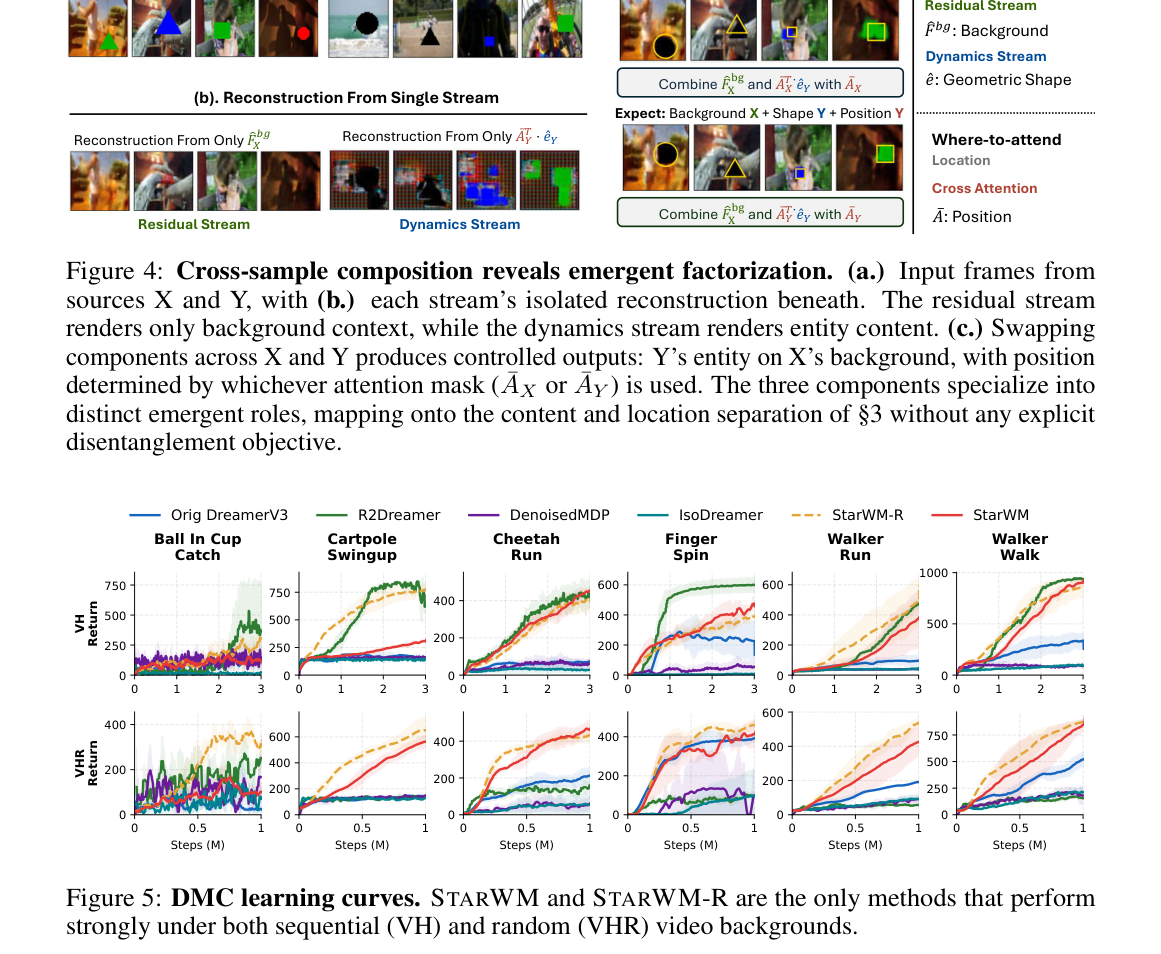
图5给出六任务在 VH/VHR 下的学习曲线:STARWM 与 STARWM-R 在两类视频干扰下都保持高回报,多数基线在 VHR 崩溃。
结论与局限
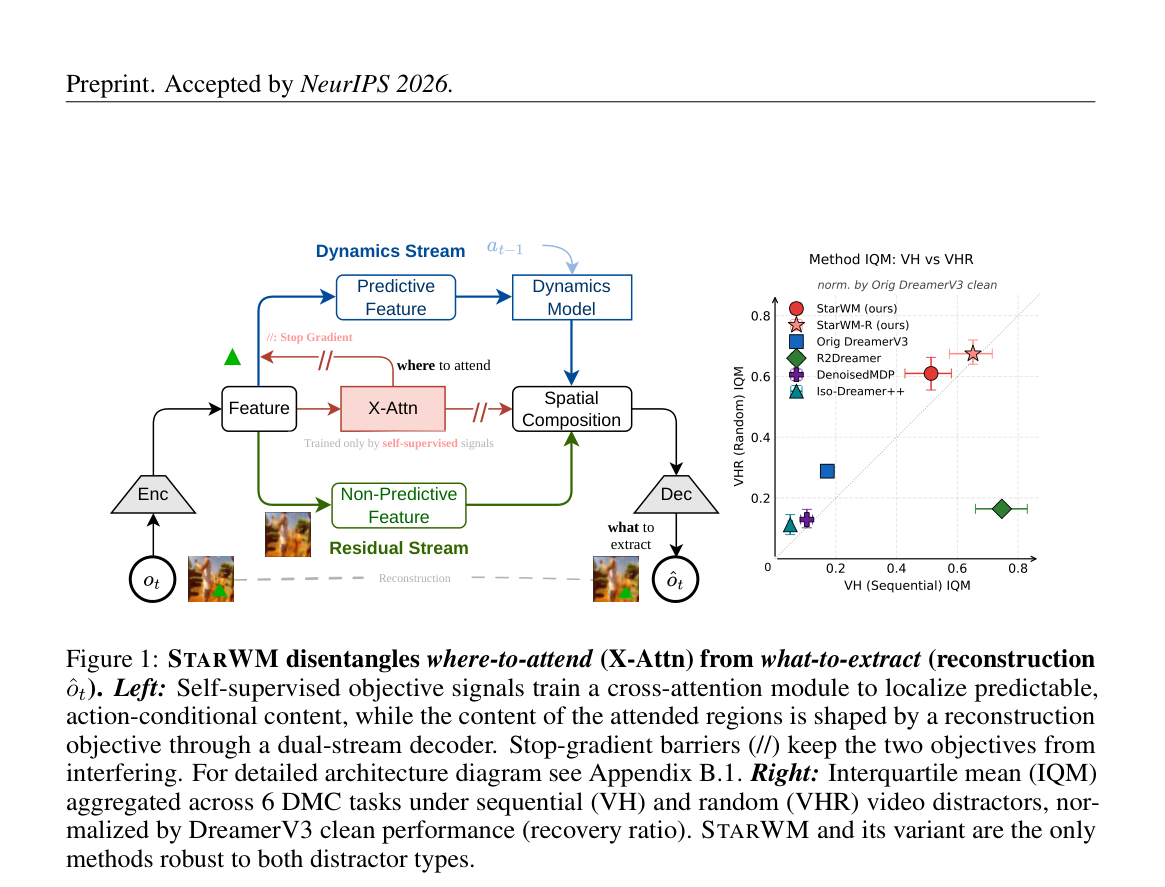
图1左侧画 where-to-attend 与 what-to-extract 分离及停止梯度;右侧 VH–VHR IQM 散点显示 STARWM/STARWM-R 独居双强象限。适合开篇总览与特色图。
实验如何设计?
- 诊断环境 NoisyShape:探针颜色/形状/尺寸,并看 15 步开放环想象是否仍保真、是否丢掉干扰。
- DMC 六任务(Walker Walk/Run、Cheetah Run、Cartpole Swingup、Finger Spin、Ball-in-cup Catch),观察 64×64,对比 Clean、VH(DAVIS 顺序视频硬背景,3M 步)与 VHR(每步随机帧,1M 步)。
- 基线含 DreamerV3、R2-Dreamer、DenoisedMDP、Iso-Dream++;报告回报曲线、注意力图、跨样本组合与大量消融。
关键结果与论文证据
- NoisyShape 上 STARWM 在编码与 H15 想象中对 shape 等属性近乎满分(H15 shape 99.57%),而 DreamerV3 的 H15 shape 约 28.95%,说明相关状态被长期保住(页24)。
- 图1右侧 IQM:STARWM 与 STARWM-R 是唯二在 VH 与 VHR 都处于高位的方法;R2-Dreamer 在顺序视频强、随机帧弱。
- VHR Walker Walk 上 STARWM 回报约 851,相对 DreamerV3≈517、R2≈158 优势明显;Clean 上与 PyTorch DreamerV3 接近,稳健性不是靠牺牲干净环境换来的(页24)。
- 图5学习曲线与图6注意力显示:查询稳定锁在智能体肢体,而非视频背景;跨样本组合进一步出现背景/实体/位置的涌现分解(图4)。
- 消融表明:自监督指导与梯度隔离需同时成立,重建梯度若回流注意力会破坏路由。
阅读时需要注意
- 时间一致背景会部分裹挟对比信号,默认 STARWM 在部分 VH 任务不如 R2,需要 STARWM-R。
- 方法绑在 DreamerV3 式 RSSM 上;query 数与损失权重仍需调节。
- 真实机器人杂乱场景的迁移仍主要在附录压力测试中展示。
关联工作
- 与 Dreamer 族、R2-Dreamer/DreamerPro 构成重建 vs 重建无关对照。
- 与 TIA、DenoisedMDP、Iso-Dream 对照“共享潜空间分解”的梯度张力问题。
- Slot Attention/DETR 提供 query 与广播解码元件,但 STARWM 坚持用动力学自监督而非重建来训练注意力。