快速导读:WorldAttention 用分层KV缓存与混合稀疏注意力的系统级共设计,在保留全历史交互记忆的同时把注意力与显存开销压到可实时运行。
文本条件交互视频世界模型要边生成边听指令:用户可能突然提起几十秒前出现过的主体或场景,模型必须从历史视觉记忆里召回细节,又不能让KV缓存把GPU显存撑爆。滑动窗口能压复杂度,却把早期帧永久丢掉;全量历史缓存又带来二次注意力开销与线性增长的KV驻留。
WorldAttention(arXiv:2609.34606 ,阿里达摩院 / 浙大 / 港科大等)给出系统级共设计:分层KV缓存(HKV)在 GPU、CPU 与 NVMe 间做页级粗到细检索,混合稀疏注意力(HSA)在检索页上用线性全局与头自适应稀疏双分支融合,并配套内核布局优化。项目页 https://alibaba-damo-academy.github.io/WorldAttention ;代码 https://github.com/alibaba-damo-academy/WorldAttention 。
英文题目:WorldAttention: An Efficient Attention Architecture for Interactive Video World Models
论文出处:arXiv 每日论文精选 · arXiv:2609.34606
原始论文:PDF / 论文页面
这篇论文解决什么问题?
交互生成不同于普通长视频:提示可在块间切换语义焦点,并要求回想更早的身份与场景一致性。若只保留最近窗口,被引用的早期视觉细节不可恢复;若保留全部KV,显存与注意力成本又随序列线性甚至平方增长。
相关工作里,MAGI-1、LongLive、Self-Forcing、SkyReels-V2 等用滑动窗口KV换取可扩展时程;BIFE 一类稀疏检索方案保留历史,但块级检索粒度粗、缓存仍持续膨胀。缺口在于:既要全历史可召回,又要把驻留与计算压到硬件可承受。
因此需要同时改写缓存组织与注意力计算:历史应按更细的语义页管理,跨存储层按访问频率驻留;注意力则应在检索后的候选上稀疏化,并用硬件友好布局兑现加速。
核心创新
- HKV:页级跨层(GPU/CPU/NVMe)KV存储与粗到细检索,在有限GPU驻留下保留全历史。
- HSA:线性全局 + 头自适应稀疏块注意力,在检索页内削减冗余计算。
- 系统级内核共设计:适配KV布局与并行执行,把稀疏/检索变成可落地吞吐。
- 在 VBench-Long / InterVBench 上同时抬升主体一致性与实时帧率。
方法概览
在自回归扩散分块解码中,当前提示与潜变量块产Query,历史块提供KV。HKV 把每个块划成约8帧的语义页,并在 L0 SRAM / L1 GPU HBM / L2 CPU DRAM / L3 NVMe 间做提示级再到页级的粗到细检索,只让活跃页驻留GPU。HSA 在检索后的页上走双分支:线性全局注意力看压缩KV全局结构,头自适应稀疏块注意力抓住局部细节,再门控融合。作者还为非连续页访问定制内核布局,把检索页重排为连续缓冲以兑现理论加速。
- 整体流水线仍是自回归扩散:视频按块生成,当前提示与潜变量块产生Query,历史块提供缓存KV。WorldAttention 作为核心注意力模块,由 HKV、HSA 与定制内核三部分组成。
- HKV 把每个历史块划成约8帧的语义页,并组织四级存储:L0 GPU SRAM 做Flash式计算缓冲,L1 GPU HBM 存放检索到的活跃页与索引,L2 CPU DRAM 放未激活块,L3 NVMe 作全历史兜底。解码时先按提示相似度做块级候选,再在候选内做页级精选,控制GPU驻留。
- HSA 面对检索页仍有时空冗余:线性全局分支处理压缩KV以保持全局结构,稀疏块注意力分支做头自适应动态块选择以抓局部细节,再门控融合输出。作者可视化不同头的稀疏模式与Top-K累积注意力,说明头间稀疏需求并不均一。
- 由于页检索带来非连续访存,作者重排KV布局、把活跃页拷入连续缓冲,并实现 Triton / ThunderKittens 稀疏核,使理论稀疏率转化为实测吞吐。
逐图理解论文
HKV机制
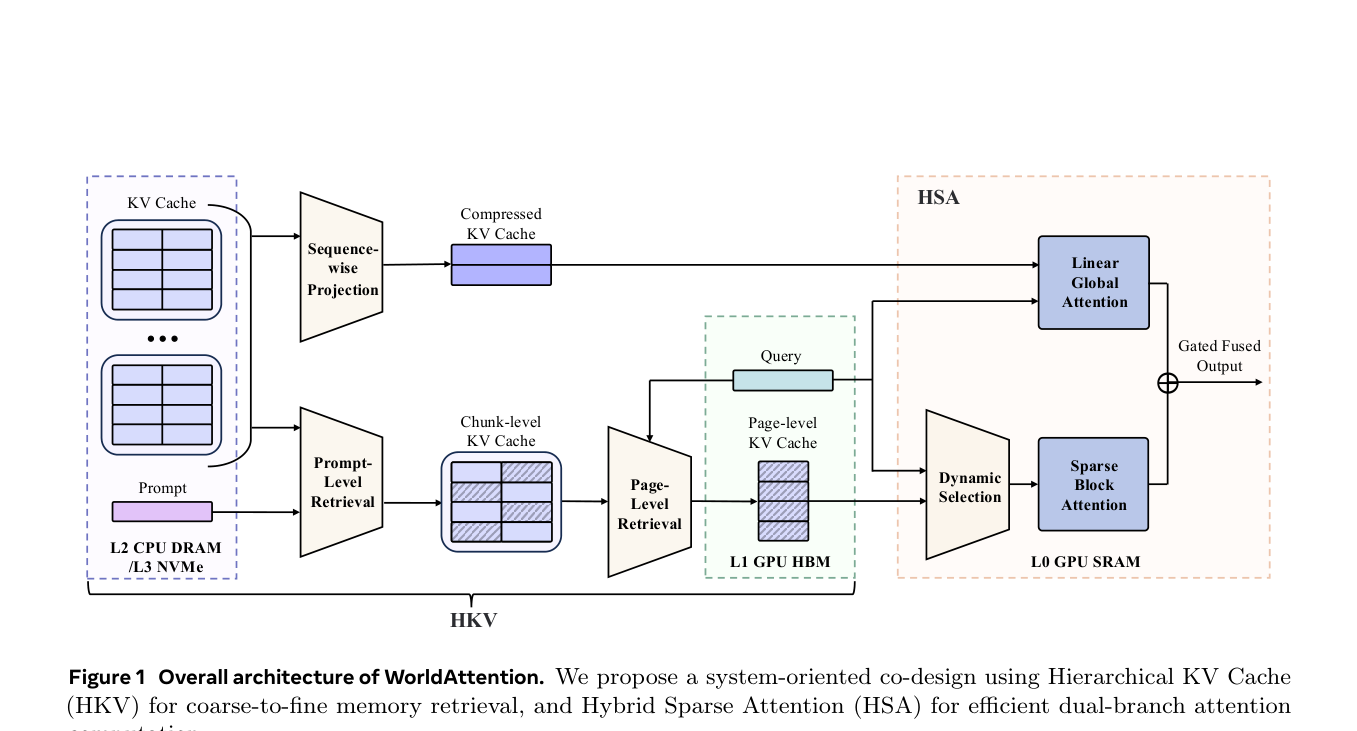
图1是方法总览:左侧 HKV 从 L2/L3 经提示级与页级检索把活跃KV送入 L1 HBM,并经序列投影得到压缩KV;右侧 HSA 用线性全局注意力与动态选择后的稀疏块注意力双分支,再门控融合输出。宜作特色图。
关键证据
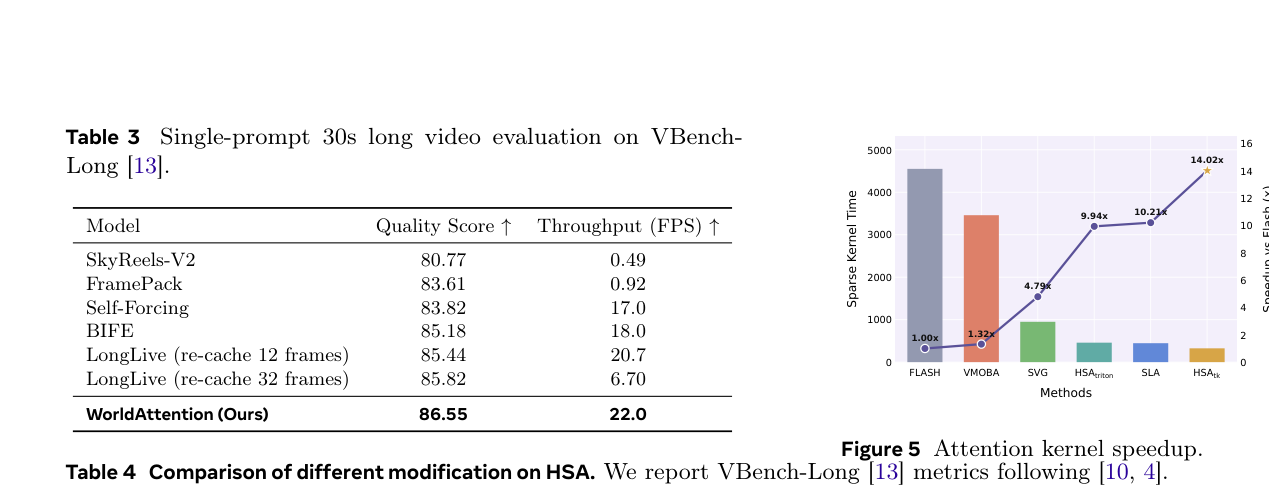
图5与同页 Table 3:WorldAttention 在单提示30秒评测上质量分 86.55、吞吐 22.0 FPS;内核对比中 HSA_tk 相对 Flash 达 14.02×,是效率主张的直接证据。
结论与局限
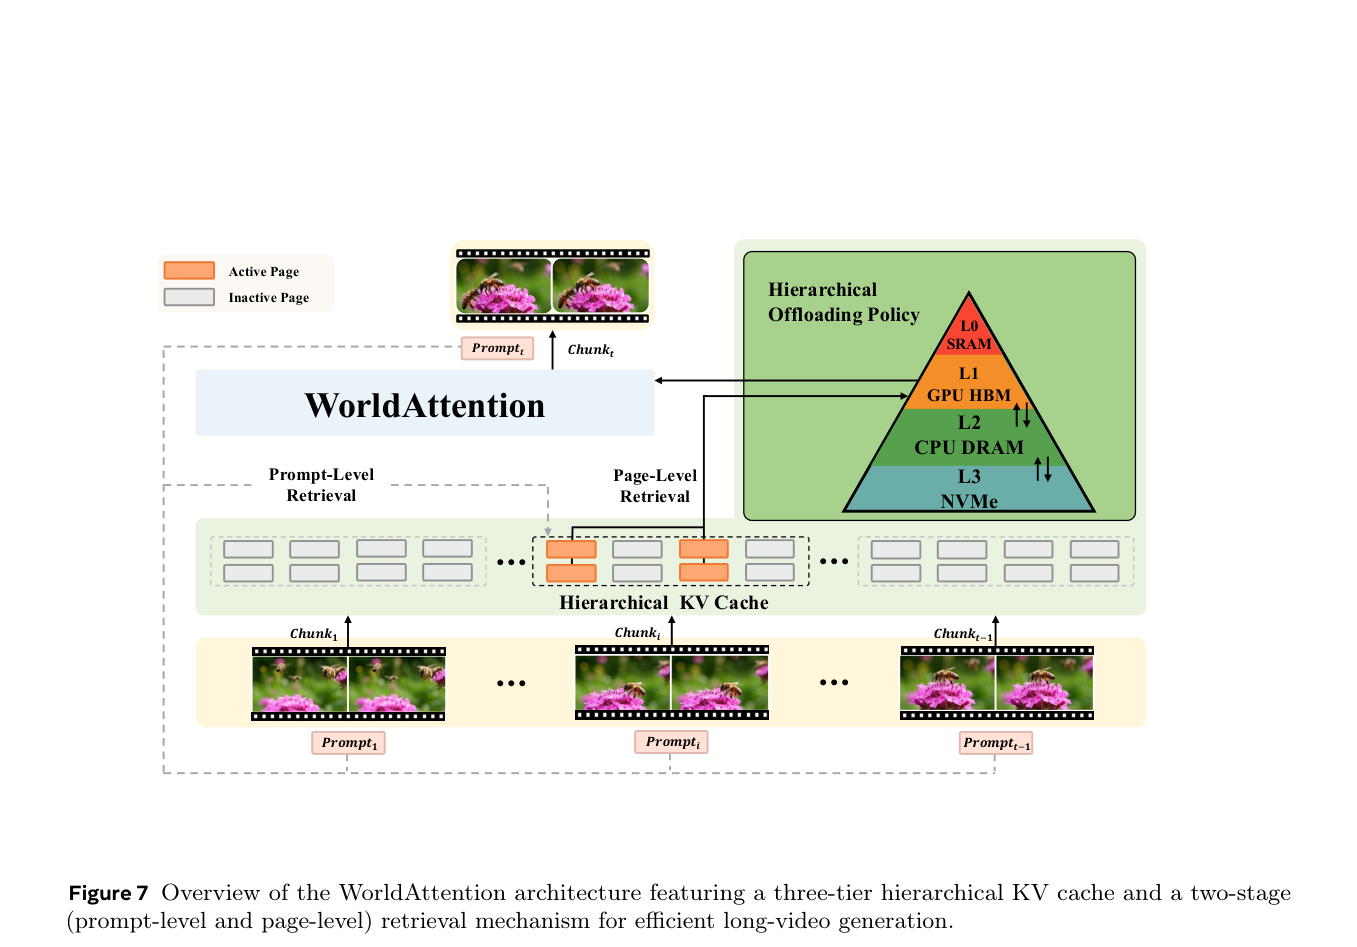
图7补充展示三层(实为四级物理介质)分层KV与两阶段检索:当前 Prompt_t 先做提示级召回,再激活页级 Active Pages 生成 Chunk_t,帮助理解全历史如何不全驻GPU。
实验如何设计?
- 主评测:将 VBench-Long 扩展到60秒,报告主体/背景一致性、运动平滑、动态程度、美学与图像质量;交互设定另报全片质量分与按10秒语义段的CLIP分。
- 对照:SkyReels-V2、Self-Forcing、BIFE、LongLive、Rolling Forcing、Infinity-RoPE 等。
- 效率:单提示30秒设置比较质量与FPS;内核侧对比 Flash、VMOBA、SVG、SLA 与 HSA 实现;端到端叠加 HKV/HSA/内核定制。
- 附录 InterVBench:200条长于50秒的交互视频,报告 VDE 与 VBench 互补指标。另做页大小、候选块数、检索策略与鲁棒性消融。
关键结果与论文证据
- VBench-Long 上 WorldAttention 主体一致性 0.9472、背景一致性 0.9691、运动平滑 0.9915,多项领先所评方法(页7,Table 1)。
- 交互60秒 Quality Score 达 85.53,高于 BIFE 的 84.38 与 LongLive 的 83.95;末段 50–60s CLIP 仍保持 25.01,显示长程提示对齐更稳(页7,Table 2)。
- InterVBench 主体一致性 0.9668;VDE-Subject / Background / Motion 分别为 0.0792 / 0.2850 / 0.0095,漂移更低(页18,Table 12)。
- 效率上,HSA_tk 相对 FlashAttention-3 达 14.02×;叠加 HKV 与内核定制后端到端约 2.21×。单卡 H100 上吞吐 22.0 FPS,质量分 86.55,同时优于对照的质量-速度折中(页8,Fig.5 / Table 3)。
- 消融显示:仅线性或仅稀疏都不够稳;HKV 在同样四页活跃预算下优于朴素页选择;默认页大小8、取4页的配置在质量与22.0 FPS之间较均衡(页8–10)。
阅读时需要注意
- 跨 CPU/NVMe 的页迁移与内核定制提高了系统复杂度,工程门槛高于纯滑动窗口。
- 活跃页预算、页大小与候选块数需要仔细折中,错误配置会同时伤及质量与延迟。
- 结论主要建立在自回归扩散交互设定与 VBench-Long / InterVBench 上,换骨干、分辨率或更开放交互协议仍需验证。
关联工作
- LongLive、Self-Forcing、SkyReels-V2 代表滑动窗口KV长视频路线。
- BIFE 代表稀疏检索保留历史的交互设定。
- SLA、SANA-Video、Sparse VideoGen 等则从稀疏/线性注意力侧加速视频DiT。