快速导读:DraftAttention2 免训练地用平均-最大池化草稿注意力图,联合决定哪些注意力块稀疏跳过、哪些用 4/8/16 位计算,并以融合内核兑现加速。
视频扩散 Transformer 用注意力建模时空依赖,但序列一长,注意力就占满大部分 DiT 时间。只做块稀疏会丢掉中等重要交互;全盘低比特又可能伤害高注意力质量块。少步采样时,这些误差更难被后续去噪步“洗掉”。
DraftAttention2(arXiv:2609.32628 ,南大 / 港科广 / Duke / NVIDIA / 浙大 / Adobe 等)提出免训练框架:用平均与最大池化构造低分草稿注意力图,一次性决定哪些块跳过、哪些走 4/8/16 位,再靠融合操作数准备与单内核分精度阶段把细粒度分配变成真实加速。
英文题目:DraftAttention2: Fast Video Diffusion with Low-Resolution-Guided Mixed-Precision Attention
论文出处:arXiv 每日论文精选 · arXiv:2609.32628
原始论文:PDF / 论文页面
这篇论文解决什么问题?
如图1(a),注意力可占 DiT 运行时间的绝大部分。分辨率与帧数上升时,代价近似随 token 数平方增长,并在每个去噪步重复。
现有高效注意力大致分两路:一路选块稀疏,一路做低比特或混精。若只保留/跳过,中等重要交互要么全算贵、要么全丢伤质量;若精度一刀切,又难把有限高精度预算用在真正关键的块上。
因此需要廉价、可排序的重要性估计,以及能在同一注意力计算里切换多精度且少搬运开销的执行方案。
核心创新
- 低分草稿同时指导块选择与 4/8/16 位精度分配,把二值保留/跳过推广为联合稀疏-混精。
- 平均+最大池化草稿互补均值与通道极值,共享排序适配各查询区域预算。
- 误差分解说明低比特恢复中等交互优于一味稀疏;融合准备与单内核兑现实际加速。
- 免训练即插即用,在少步视频扩散上质量-效率优势更明显。
方法概览
将时空 token 划成区域,对 Q/K 做 AvgPool 与 MaxPool 得到互补区域描述,混合成低分草稿注意力图并按头级预算排序:高分块分 16 位,其次 8/4 位,其余跳过。理论把输出误差拆成稀疏化误差与注意力加权量化误差,说明用低比特“救回”中等重要交互可收紧误差界。实现上融合操作数准备(重排、池化、量化)与单内核分精度阶段,共享数据搬运、softmax 统计与输出累加。
- 空间上把视频 token 划成区域。对每个区域的 Q/K 计算平均描述与通道最大描述,分别形成 Avg/Max 草稿图,再以权重 λ 混合(λ=0 退化为仅平均,复现 DraftAttention 风格引导)。
- 在每个注意力头内对所有区域对按草稿分排序:按配额依次赋予 16-bit、INT8、低比特(如 NVFP4/4-bit),剩余标记为稀疏跳过。查询区域可在同一头级预算下获得不同保留数与精度组合。
- 理论把输出误差拆成稀疏化项与注意力加权量化项,论证:用低比特计算中等重要交互,往往比直接跳过更能收紧误差界;高精度预算应留给注意力质量更大的块。
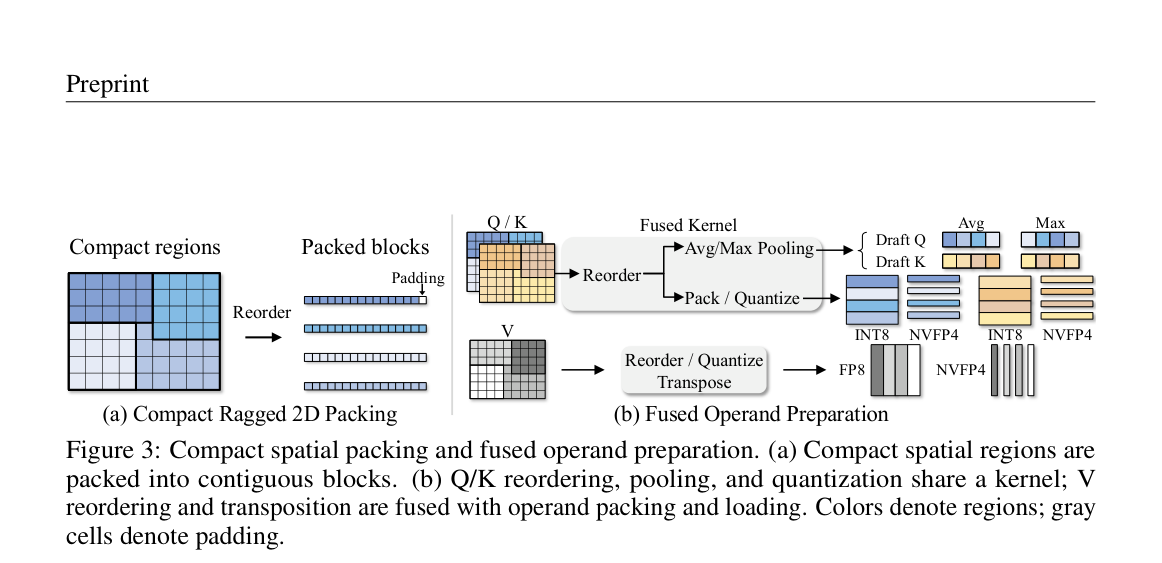
- 工程上,Q/K 重排、池化与量化融合进同一准备内核;注意力内核按精度分阶段执行,但共享 softmax 统计与输出累加,并在阶段边界按量化尺度重标定,避免多次写回再合并。
逐图理解论文
注意力瓶颈
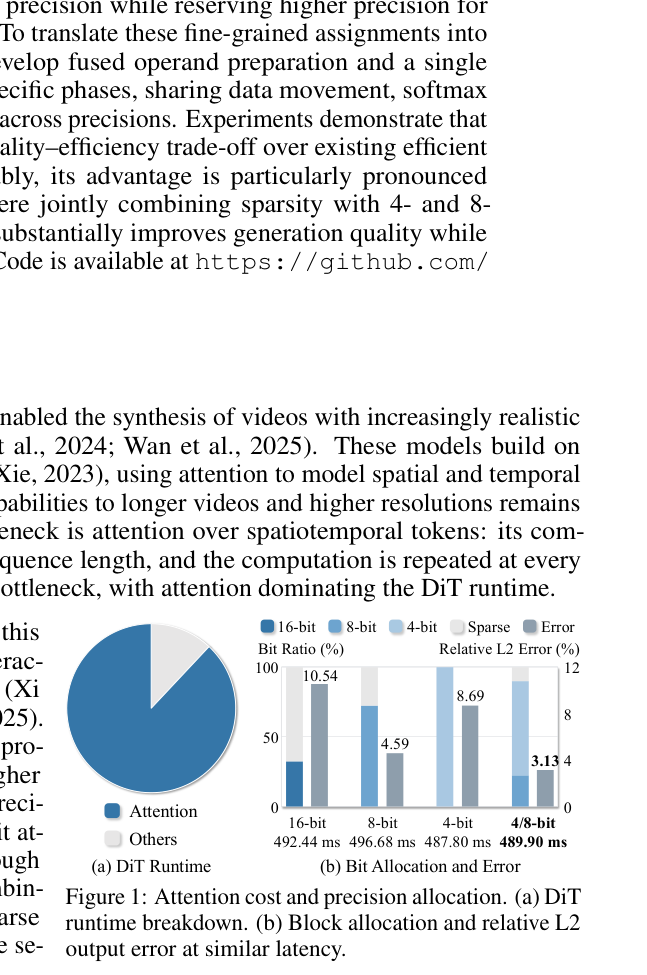
图1给出动机:(a) 注意力主导 DiT 耗时;(b) 相近延迟下 4/8 混精相对误差更低,说明联合稀疏-混精优于单一策略。
草稿分配
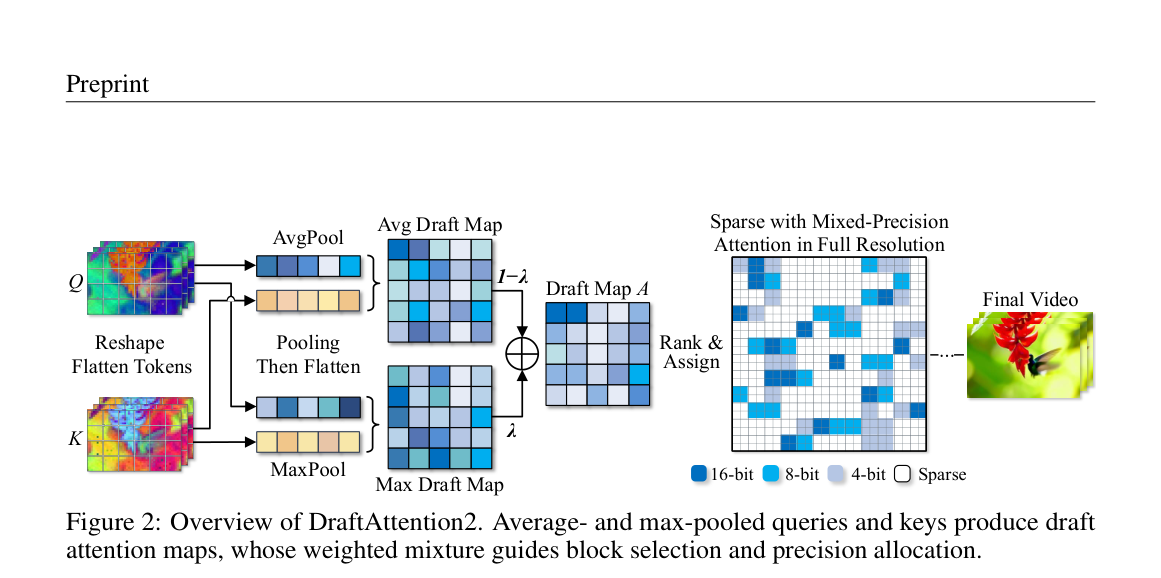
图2是方法主图:Q/K 经 Avg/Max 池化得到草稿图,加权混合后 Rank & Assign,在全分辨率上执行 16/8/4-bit 与稀疏跳过的混精注意力,最终生成视频。宜作特色图。
主结果
在混元与迷你迈克斯视频模型上,稀疏加混精可到约二点四到二点六倍加速,少步设定里对稠密输出的保真提升更明显。
实验如何设计?
- 主实验覆盖 HunyuanVideo 与 MiniMax-H3,对比 XAttn、SVG2、Sol-Attn、SVG-EAR、SVOO、SpargeAttn、SageAttn3 等。
- 指标:VBench Avg、相对稠密输出的 PSNR/SSIM/LPIPS,以及 DiT speedup;Bit 列按 0/4/8/16 百分比报告。
- 少步场景:Table 2 在 MiniMax-H3 + FL2VA Turbo LoRA(1344×768,362 帧)上测 4-step 与 8-step。
- 消融:Table 3 / Figure 5 检验 MaxPool 与混精相对单精度配置的误差-延迟折中。
关键结果与论文证据
- 图1(b) 显示:相近延迟下,4/8 混精相对 L2 误差约 3.13%,低于多种单精度稀疏或稠密分配,支持“低比特救回中等交互”的设计动机(页1)。
- 表1:在 HunyuanVideo 上,85/0/7.5/7.5 配置约 2.38× 加速且 VBench 74.70;引入更多 4-bit 后可达约 2.51×(80.7/14.4/4.8/0,VBench 75.96)。MiniMax-H3 上对应混精配置可到约 2.60×,并在同速附近优于 SpargeAttn(页7)。
- 少步扩散优势更明显:表2中联合稀疏与 4/8 混精可在接近的加速下显著提高对稠密结果的 PSNR/SSIM、降低 LPIPS,结构化细节也更稳(页8–9,图4)。
- 去掉 MaxPool 会削弱固定预算下的保真;平均-最大混合草稿对块选择与混精都有稳定收益(页9,表3/图5)。
阅读时需要注意
- 草稿基于区域统计,对强烈非局部或异常运动模式可能估计偏差。
- 加速效果依赖融合内核与具体数值格式,跨平台复现需要工程投入。
- 不同模型与采样步数下的最优 0/4/8/16 配额仍需检索,不是单一默认值通吃。
关联工作
- DraftAttention 用平均池化草稿做块稀疏选择。
- SVG 系列、AdaSpa、XAttention 代表视频扩散稀疏注意力。
- SageAttention、SpargeAttention 与 DMA/BMAttn 等推进量化与块级混精。