快速导读:FOCUS 在十个眼底数据集上统一评测 VM、VLM 与 MLLM 的跨库泛化,并同时报告性能、校准、公平与图像质量鲁棒性;明确非临床产品。
视网膜 AI 近年快速接入基础模型,但单数据集上的 AUROC 很难回答:换采集设备、换地理人群、换标注口径后,模型是否仍可靠?校准是否仍可信?亚组与图像质量差异会不会被平均分掩盖?
FOCUS(Foundation Ophthalmic Cross-Dataset Understanding under Shift,arXiv:2609.33158 ,NeurIPS 2026 Evaluations & Datasets)由 CentraleSupélec / Paris-Saclay、密歇根、圣保罗联邦大学、波尔图/奥尔堡与布宜诺斯艾利斯大学等提出。它把视觉编码器(VM)、双编码器 VLM 与多模态大模型(MLLM)放进同一套跨数据集评测层,覆盖十个公开眼底数据集上的任意糖尿病视网膜病变(Any DR)、可转诊 DR 与青光眼视神经病变(GON)三项二分类任务。需要强调:FOCUS 是研究型评测基准与公开实验框架,不是临床诊断或筛查产品,不能作为部署就绪或医疗器械结论。
英文题目:FOCUS: Benchmarking Retinal Model Generalization from Foundation Vision Encoders to Multimodal LLMs
论文出处:arXiv 每日论文精选 · arXiv:2609.33158
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有挑战数据集(IDRiD、RFMiD、BRSET、PAPILA、G1020 等)分别提供疾病标签与部分人口学/质量元数据,却很少在同一协议下同时比较 VM / VLM / MLLM,并系统报告校准、公平与质量鲁棒性。
不同模型接口差异很大:VM/VLM 输出嵌入,MLLM 输出 token 概率;若不统一评测层,看似提升可能来自提示模板、阈值或标签映射,而非真实跨数据集迁移。
医疗场景尤其需要多维证据。排名指标高并不等价于概率可信、亚组均衡或低质量图像下仍稳定。FOCUS 正是为把这些维度摊开而设计。
核心创新
- 跨十库任务对齐,贯通 VM、VLM、MLLM 三类接口。
- 性能—校准—公平—质量四轴 Arena,避免单分数掩盖风险。
- MLLM LoRA 的域内/外迁移分析,区分排序与阈值校准效应。
- 大规模实证:无单一模型族全面占优,青光眼成任务悬崖。
方法概览
构建十数据集注册与 Any DR / Referable DR / GON 任务对齐;按接口评测线性探测、零样本匹配与提示生成;四轴度量性能、ECE、公平差距与质量鲁棒;并对 MLLM 做 LoRA SFT 的域内与 OOD 对照。共报告 532 基础配置与 228 LoRA 配置。
- 数据与任务:注册 BRSET、mBRSET、PAPILA、RFMiD、RFMiD 2.0、IDRiD、Messidor-2、REFUGE、G1020、JSIEC1000 等十个眼底数据集,并按统一规则映射到 Any DR(ICDR≥1)、Referable DR(ICDR≥2 和/或可疑黄斑水肿)与 GON(如 VCDR≥0.6 或专科标注的结构风险)三项二分类。
- 模型接口:VM 做冻结特征线性探测(含 RETFound、VisionFM 等眼科编码器与 DINOv2/v3、ViT 等通才编码器);VLM 做零样本图文匹配与线性探测;MLLM 用 yes/no 提示,并以首 token 正类概率计分。
- 评测轴:性能(AUROC/AUPRC/Accuracy 等)、校准(ECE)、公平(年龄/性别等差距诊断)、图像质量鲁棒性,以及在有元数据时的覆盖与缺失诊断。图2流水线把注册—接口推理—多维评测—LoRA 适配—Arena 报告串成闭环。
- 适配实验:对 MLLM 做 LoRA 监督微调,在 BRSET/mBRSET 等上适配后,同时报告训练集内持出测试与同任务外数据集迁移的指标差,当前报告覆盖 532 个基础配置与 228 个 LoRA 适配配置。
逐图理解论文
评测缺口
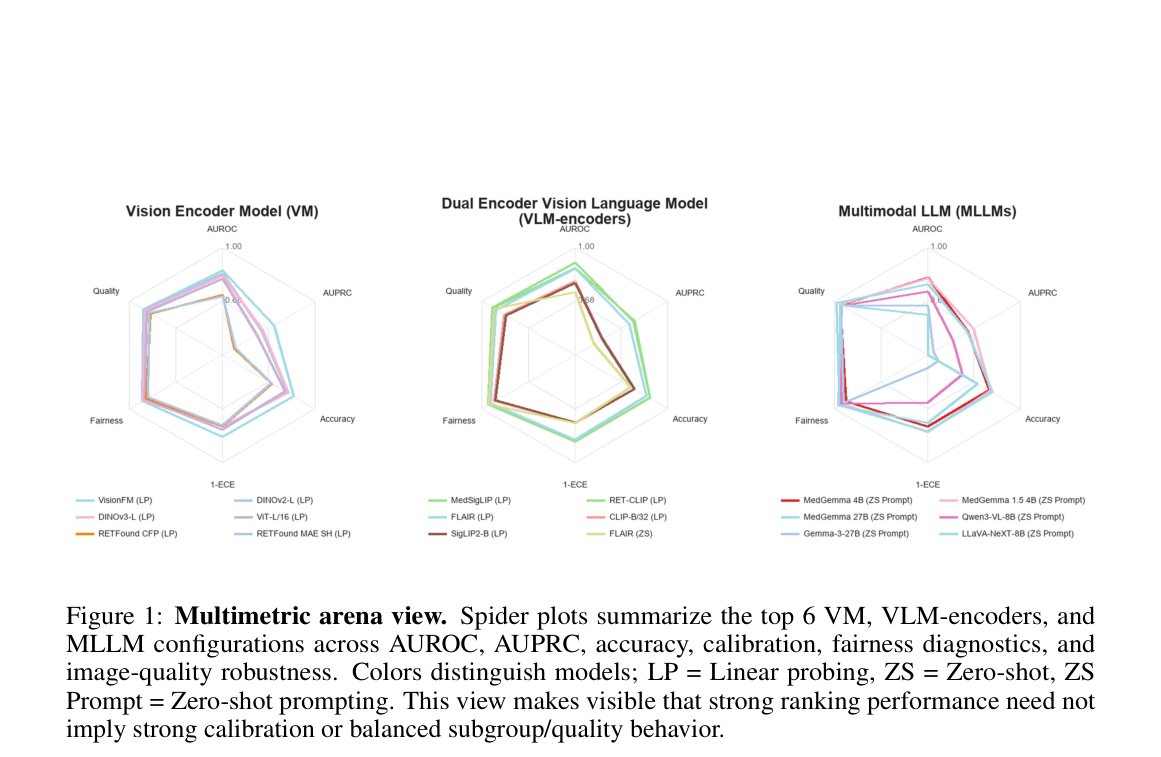
图1三张蜘蛛图对比 VM、VLM-encoder、MLLM 在 AUROC、AUPRC、Accuracy、1-ECE、Fairness、Quality 上的轮廓:高排名不等于好校准或均衡亚组,是开篇多维动机图。
FOCUS 设计
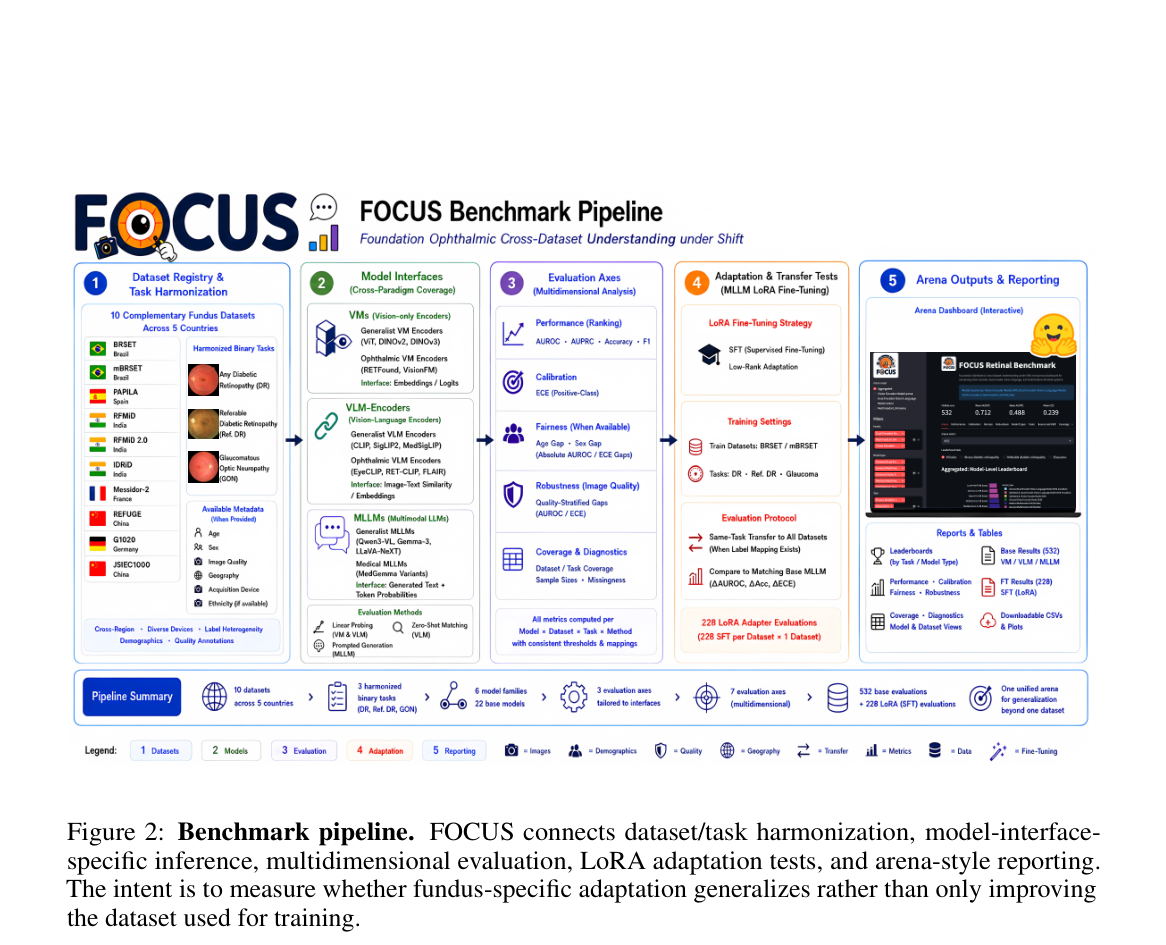
图2是 FOCUS 方法主图:十数据集注册与三项任务对齐 → VM/VLM/MLLM 接口推理 → 性能/校准/公平/质量多维评测 → LoRA 迁移测试 → Arena 看板。适合做特色图,讲清“测泛化而非只刷训练库”。
关键发现
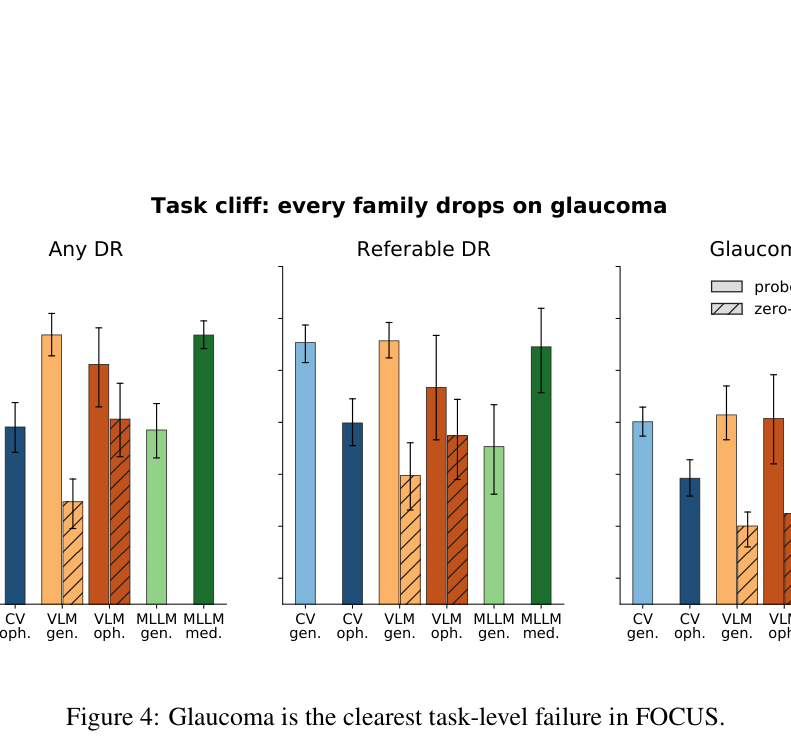
图4三栏柱图(Any DR / Referable DR / Glaucoma)显示所有模型族在青光眼任务上集体掉分,是“任务悬崖”的核心证据。
微调启示
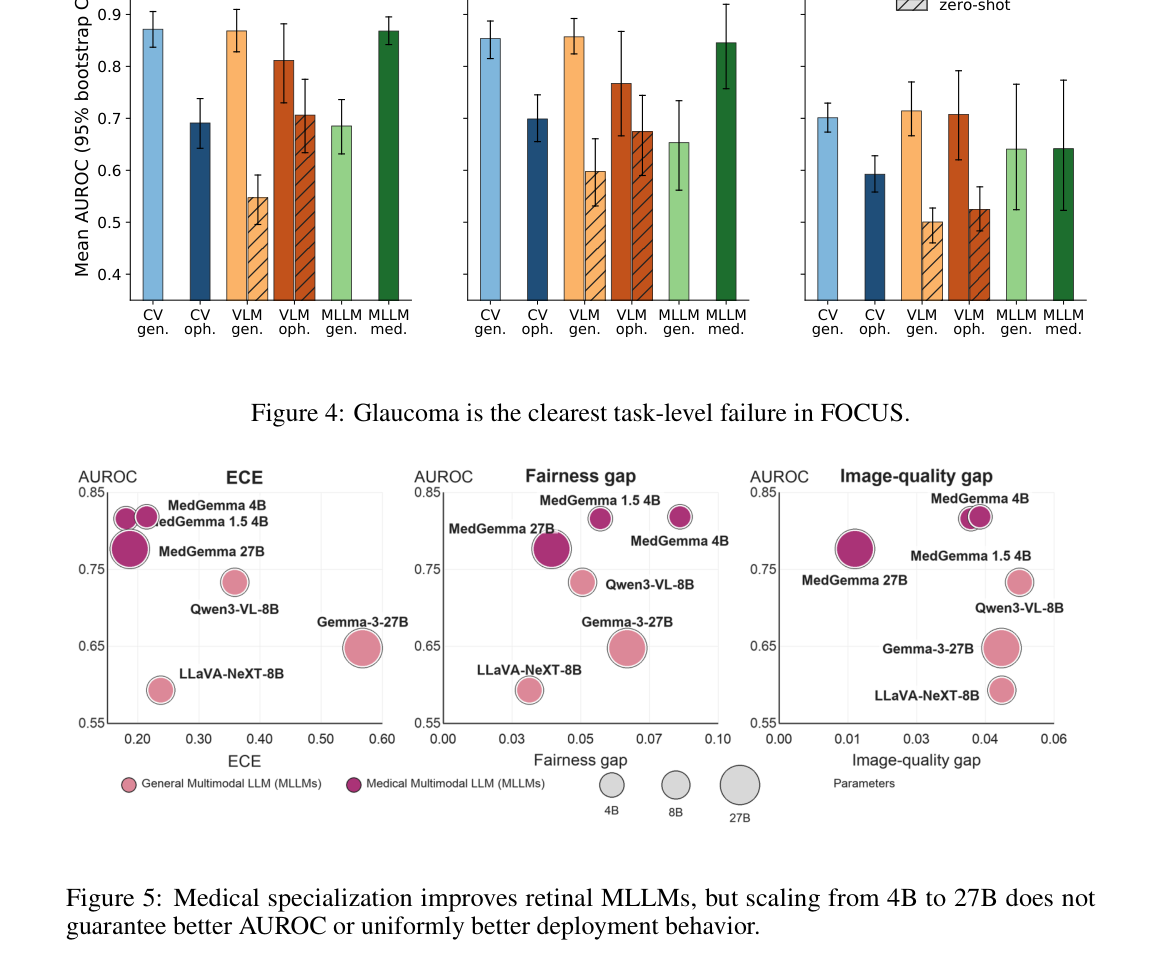
图5用气泡对比通才与医学 MLLM:医学特化抬高 AUROC 并改善 ECE,但参数从 4B 到 27B 并不自动带来更好的公平或图像质量差距。
实验如何设计?
- 基础套件:532 个 model–dataset–task–method 配置(VM 190、VLM 228、MLLM 114);方法均值见 Table 3,按任务与模型族拆开。
- 跨数据集:Table 4 给出通才 vs 眼科 VM 在各数据集的平均 AUROC 差,其中手机眼底 mBRSET 上差距最大(+0.162)。
- 任务悬崖与规模:Figure 4 对比 Any DR / Referable DR / Glaucoma;Figure 5 比较通才与医学 MLLM 在 AUROC、ECE、公平差距与图像质量差距上的部署行为。
- LoRA:Table 5 / Figure 6 报告域内与 OOD 上 AUROC、Accuracy、ECE 相对基座的增量及多重检验校正后的 q 值。
关键结果与论文证据
- Overall(Table 3):通才 VM 线性探测平均 AUROC 约 0.828,高于眼科 VM 的 0.667;医学 MLLM 约 0.803,明显优于通才 MLLM 的 0.658。没有单一模型族在性能、校准、公平、鲁棒上全面占优。
- Finding 1–2:通才预训练 VM 仍是很强且稳健的视网膜基线;眼科域预训练在手机采集 mBRSET 等偏移上未必更强。VLM 对接口极敏感:眼科 VLM 零样本可占优,但线性探测天花板常低于通才 VLM。
- Finding 3(Figure 4):青光眼是最清晰的任务级失败——各家平均 AUROC 从 DR 任务掉到青光眼,结构风险识别显著难于局部血管病变/转诊决策。
- Finding 4(Figure 5):医学特化能提升视网膜 MLLM(如固定 27B 时 MedGemma-27B 相对 Gemma-3-27B,平均 AUROC 0.648→0.797,ECE 0.36→0.19),但同族从 4B 扩到 27B 并不保证更高 AUROC 或更均匀的公平/质量行为。
- Finding 5(Table 5):LoRA SFT 主要改善阈值决策与校准(域内 Accuracy +0.033、ECE −0.040;OOD Accuracy +0.012、ECE −0.018),对平均排序 AUROC 几乎不动(+0.004 / +0.002,q 不显著)。
阅读时需要注意
- 作者明确:FOCUS 不是临床验证研究,不能用于宣称部署就绪或筛查/诊断安全性。
- 标签来自异构公开/受控来源,分级协议可能不一致;部分数据集缺少人口学或质量元数据,公平与鲁棒分析覆盖不全。
- 亚组差距是描述性诊断而非因果公平主张;生成式模型结果依赖提示、解析与 token 概率可得性。
关联工作
- 单数据集挑战(IDRiD、RFMiD、BRSET、PAPILA、G1020 等)提供疾病与部分元数据,但缺少跨族跨库统一评测。
- FunBench、LMOD 等偏眼科推理/生成评测,未同时覆盖 VM–VLM–MLLM 的分类迁移与校准公平轴。
- RETFound、VisionFM、EyeCLIP、FLAIR、MedGemma 等是 FOCUS 中的代表性眼科/医学模型族。