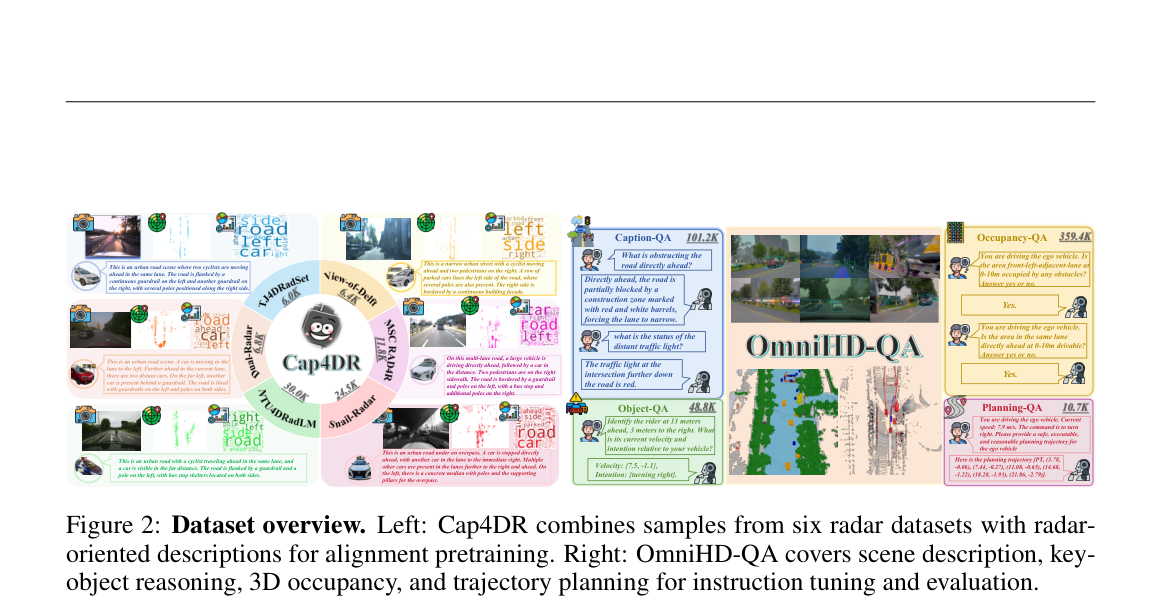
快速导读:RCVLA 用 Cap4DR/OmniHD-QA 支撑雷达—语言对齐与驾驶指令,经 RCVLA-Sem 做问答与参考轨迹,再经 RCVLA-Phys 用结构化查询与雷达簇测值做轨迹细化与 TTC 风险选择。
自动驾驶视觉语言动作(VLA)模型用自然语言做场景推理与规划,但相机中心方案主要靠视觉推断几何与运动,雨雾眩光等退化条件下容易失真。4D 雷达提供空间结构与多普勒径向速度,可补视觉之不足,但接入 VLA 需要两套能力:雷达—语言对齐支撑语义,以及在轨迹细化/选择中显式使用局部测值。
RCVLA(arXiv:2609.32681 ,同济 / 浙大 / 港科大等)给出研究原型:先建 Cap4DR 与 OmniHD-QA,再分 RCVLA-Sem(雷达落地语义推理与参考轨迹)与 RCVLA-Phys(结构化查询 + 簇级雷达测值做轨迹仲裁与 TTC 风险选择)。下文结果均为开环基准指标,不表示已部署量产系统。
英文题目:RCVLA: 4D Radar-Grounded Semantic Reasoning and Trajectory Arbitration for Autonomous Driving
论文出处:arXiv 每日论文精选 · arXiv:2609.32681
原始论文:PDF / 论文页面
这篇论文解决什么问题?
如图1对比:双系统 VLA 把语言接到另一端到端模块;感知增强 VLA 加入结构化特征;二者通常仍缺雷达引导的轨迹细化。RCVLA 把语义参考轨迹、结构化查询与 4D 雷达测值一并送入轨迹仲裁。
挑战一:标准图文预训练不含 4D 雷达—语言对齐。挑战二:语义推理偏好紧凑、可进语言模型的令牌,而轨迹安全更依赖局部几何与运动测值。混用一种表示往往顾此失彼。
因此作者同时构造对齐数据与多任务驾驶 QA,并在框架里保留语言对齐雷达令牌与簇级物理测值两条通路。
核心创新
- Cap4DR + OmniHD-QA:互补的雷达—语言预训练与多任务驾驶指令数据。
- 雷达在语义与物理层分工:语言对齐令牌服务推理,簇级测值服务轨迹仲裁。
- RCVLA-Sem 门控双向交互 + 结构化查询;RCVLA-Phys 截断扩散细化与 TTC 风险校准。
- OmniHD-QA 上语义与开环规划相对对照方法提升,消融验证两阶段互补。
方法概览
构建 Cap4DR(86,016 雷达—图—文)做 RQ-Former 对齐预训练,OmniHD-QA(520,161 QA)覆盖场景描述、关键物体、占用与规划。RCVLA-Sem:相机与雷达令牌门控双向交互,LoRA 微调 Vicuna-7B,辅助检测/占用头输出结构化查询并生成参考轨迹。RCVLA-Phys:冻结 Sem,用截断扩散在参考轨迹与锚点上细化候选,条件于物体/占用查询与簇级雷达测值,并以雷达推导 TTC 风险校准候选分数。开环评测 L2 与碰撞率;强调研究原型与开环指标,非已部署量产系统。
- Cap4DR 汇集六套雷达数据集的同步前视图像与 4D 雷达,经统一预处理后只保留可与雷达关联的实体与空间关系,多模型交叉核验后得到 86,016 对,用于 RQ-Former 对齐。OmniHD-QA 基于 OmniHD-Scenes,含 520,161 条覆盖描述、关键物体、占用与规划的问答。
- 图3:RCVLA-Sem 用图像编码器+IQ-Former 与雷达编码器+RQ-Former 提取令牌,经门控双向交互与自车状态进入带 LoRA 的 LLM,输出场景/物体/占用问答,并由 <waypoint_ego> 生成长时域参考轨迹;辅助头提供物体与占用查询。
- 图4:RCVLA-Phys 冻结 Sem,从参考轨迹与锚点构造候选,经截断扩散(条件于查询与 DBSCAN 雷达簇)细化;再用簇中心与补偿径向速度外推,计算接近速度、间距与最小 TTC,将风险用于训练软排序目标与推理分数校准。
- 训练三阶段:雷达编码器检测/占用预训练 → Cap4DR 对齐 → OmniHD-QA 上微调 Sem → 冻结 Sem 训练 Phys。实现上为六路 640×640 相机与多视角 4D 雷达点,Vicuna-7B,Phys 默认五候选与两步 DDIM。
逐图理解论文
双重缺口
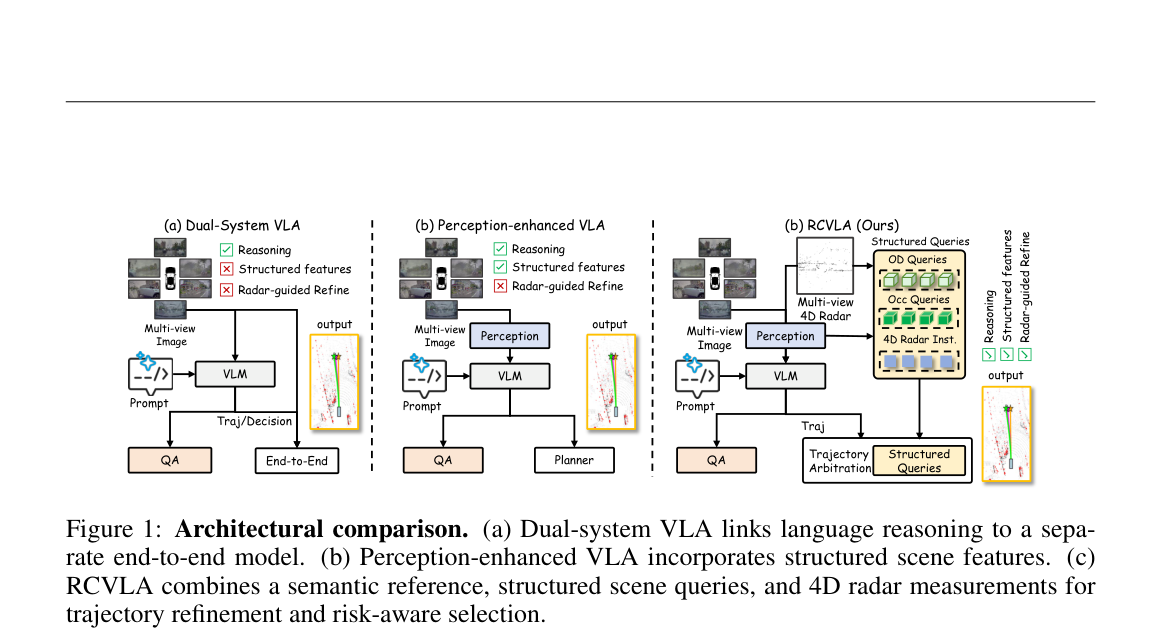
图1三列架构对比:双系统、感知增强与 RCVLA;后者同时具备推理、结构化特征与雷达引导细化。适合动机。
数据与语义阶段
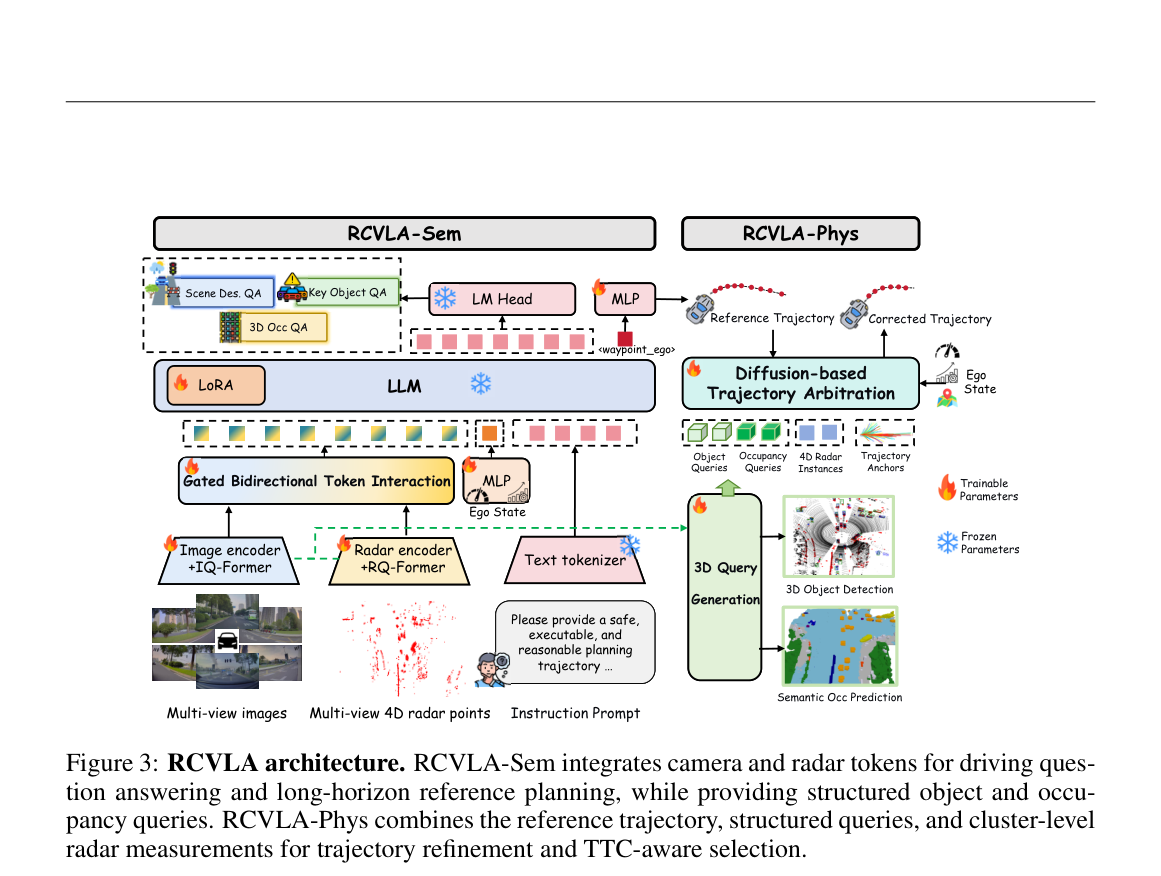
图3总览 Sem/Phys:门控双向交互生成问答与参考轨迹,扩散仲裁结合查询与雷达簇输出校正轨迹。宜作特色图。
轨迹仲裁
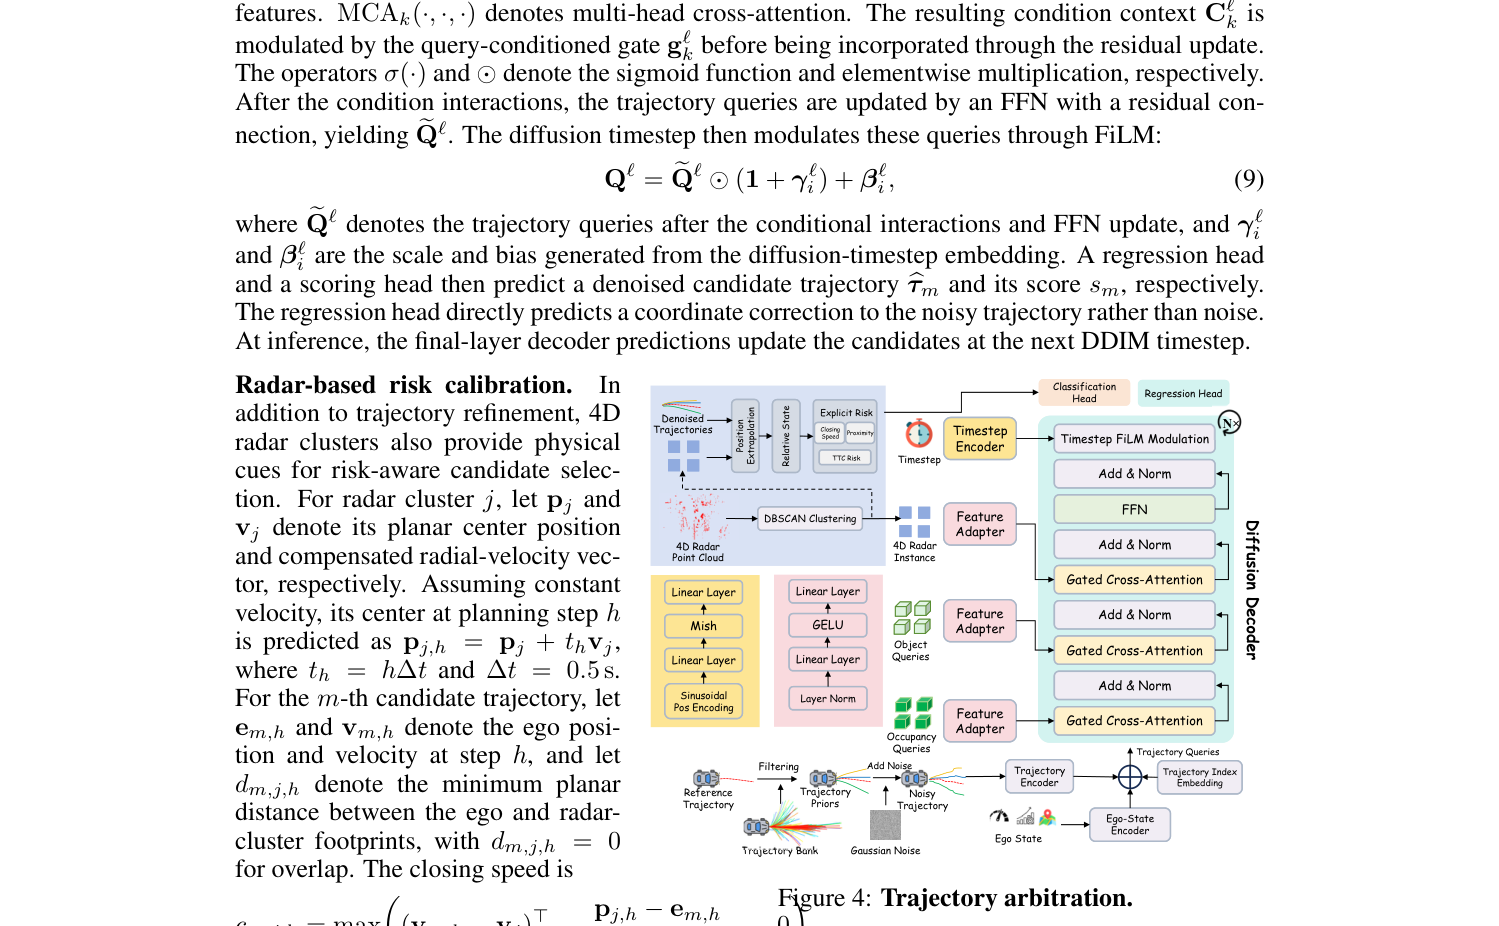
图4展开轨迹仲裁:轨迹编码、门控交叉注意、FiLM 时步调制,以及基于雷达簇的 TTC 等显式风险校准。
实验如何设计?
- 下游均在 OmniHD-QA:训练 358,185 / 测试 161,976。Cap4DR 仅用于对齐预训练。
- 语义:Table 1 描述指标;Table 2 占用类准确率、速度误差、意图准确率。
- 规划:Table 3 开环 1/2/3 s L2 与碰撞率;对照含 OmniDrive、UniAD、BEV-Planner、Constant-Velo 与通用 VLM。
- 消融:Sem 去雷达/去 RLP/令牌拼接方式;Phys 去占用/物体查询、雷达簇、风险校准;以及 0–3 s 参考延迟鲁棒性。
关键结果与论文证据
- RCVLA-Sem 将 CIDEr 从 OmniDrive 的 92.49 提到 102.41(+9.92),关键物体速度误差从 3.61 降到 2.82 m/s(约 −21.9%),占用聚合准确率 78.81%→80.41%(页7–8)。
- 可驾驶区与意图准确率仍略低于 OmniDrive(分别约 −0.48 / −1.13 个百分点),说明语义雷达融合并非全面占优。
- RCVLA-Phys 将平均 L2 从 Sem 的 0.348 m 降到 0.259 m,平均碰撞率从 0.576% 降到 0.175%;3 s 碰撞率从 1.481% 到 0.401%(页8,Table 3)。图6显示仲裁轨迹(品红)更贴近真值(绿)。
- 消融表明:去 4D 雷达损害 CIDEr 与速度误差;去占用查询对 Phys 伤害最大;雷达簇与风险校准显著降低碰撞率(页8–9)。
- 参考轨迹延迟到 3 s 时平均 L2 升至约 0.564 m,说明仲裁能部分补偿过期参考,但无法消除陈旧规划的风险(页9)。
阅读时需要注意
- 评测为开环协议,不能直接外推闭环安全或量产可行性。
- 长时域与更复杂交互仍依赖未来世界模型等工作;延迟参考会明显恶化指标。
- 部分意图/可驾驶指标仍有差距;代码计划开源,部署栈不在本文范围。
关联工作
- OmniDrive、DriveLM、Senna 代表驾驶 VLA 的语言推理路线。
- UniAD、BEV-Planner、DiffusionDrive 构成端到端/扩散规划对照。
- Talk2Radar、Text4Radar 等连接 4D 雷达与语言,但重点多在 grounding/检测。