快速导读:WM-VLM 给 VLM 加浅层生成分支作内部世界模型,先学会预测心理动作后的视觉状态,再学会用自生成视觉令牌做交错空间推理。
解空间题时,人往往会在心里旋转、平移或重组物体,再对照选项做判断;多数视觉语言模型却主要在文本链上推演,训练目标也通常只盯最终答案词元,并不直接要求预测“动作之后画面应变成什么样”。结果是:模型可以谈论空间关系,却缺少可检验的内部视觉仿真。
WM-VLM(arXiv:2609.34826 ,UCSD / MBZUAI / CMU)给 VLM 增加浅层生成分支作为内部世界模型,并采用两阶段训练:先学会按心理动作生成中间视觉状态,再学会在交错推理中使用自生成视觉令牌。作者用程序化 Tetris-2D/3D 诊断集,使中间态与答案都可核验,从而检验世界建模是否真正进入决策。
英文题目:WM-VLM: Probing Internal World Models for Interleaved Visual-Textual Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2609.34826
原始论文:PDF / 论文页面
这篇论文解决什么问题?
如图2所示:给定积木构型与“绕世界+Z轴旋转”一类指令,求解需要先形成心理动作,再想象变换后的视觉状态,最后才选答案。若中间只有文本描述而没有可用视觉状态,模型容易在三维朝向与遮挡关系上失真。
现有交错视觉-文本推理路线或依赖外部工具/外部世界模型,或在统一模型里生成中间图/潜变量。但有分析指出:去掉或腐蚀潜视觉令牌有时几乎不影响答案,暗示存在旁路与表示坍塌。
因此需要同时满足三点:任务确实依赖新视觉状态;中间态可核验;并能做替换/腐蚀实验,证明模型不是只背文本格式。
核心创新
- light MoT 浅层生成分支:用少量层为 VLM 提供内部视觉状态预测能力。
- 两阶段训练:先学会生成中间视觉状态,再学会用自预测状态做交错推理。
- Tetris-2D/3D 诊断集:中间态与答案均可程序核验,便于因果检验。
- 腐蚀/替换视觉令牌会显著掉点,说明答案确实依赖内部世界模型输出。
方法概览
采用 light MoT:理解分支由 Qwen2.5-VL-7B-Instruct 初始化(视觉编码器+语言解码器),生成分支默认仅对齐理解分支中连续 k=4 层,处理噪声视觉令牌并输出干净视觉令牌;文本与干净视觉走理解分支,噪声视觉走生成分支,两分支令牌经全局自注意力交互。两阶段训练:Stage-1 冻结理解分支,只训生成分支用流匹配预测下一视觉状态;Stage-2 解冻语言解码器,在线使用自生成视觉令牌与交叉熵联合训练,学会据此交错推理。配套程序化构建 Tetris-2D/3D,每例含问题图、心理动作、可核验中间视觉状态与选择题答案。
- 数据上,每个样本包含问题与问题图、由心理动作与视觉状态交错组成的推理轨迹、以及最终选择题答案。Tetris-2D/3D 由程序生成,保证状态转移与答案可自动核对,并划分 ID/OOD 等拆分。
- 架构采用 light MoT(图3):理解分支初始化自 Qwen2.5-VL-7B-Instruct;生成分支默认只保留与理解分支连续 k=4 层对齐的浅层参数。文本与干净视觉令牌走理解分支,噪声视觉令牌走生成分支;两分支在对齐层做全局自注意力,生成后再用干净令牌替换噪声令牌继续推理。
- 训练分两阶段。Stage-1 冻结理解分支,仅训练生成分支,用流匹配(FM-MSE)学习由当前状态与心理动作预测下一视觉状态。Stage-2 保持视觉编码器冻结,解冻语言解码器并与生成分支联合优化;在线把生成分支输出而非真值视觉令牌喂给理解分支,同时平衡交叉熵与流匹配损失,迫使模型学会使用自己的预测。
- 评测不仅看最终准确率,还报告生成嵌入与真值的余弦、检索 top-1,以及把中间视觉令牌替换为全零、随机或打乱后的准确率变化,用以支撑因果依赖。
逐图理解论文
证据缺口
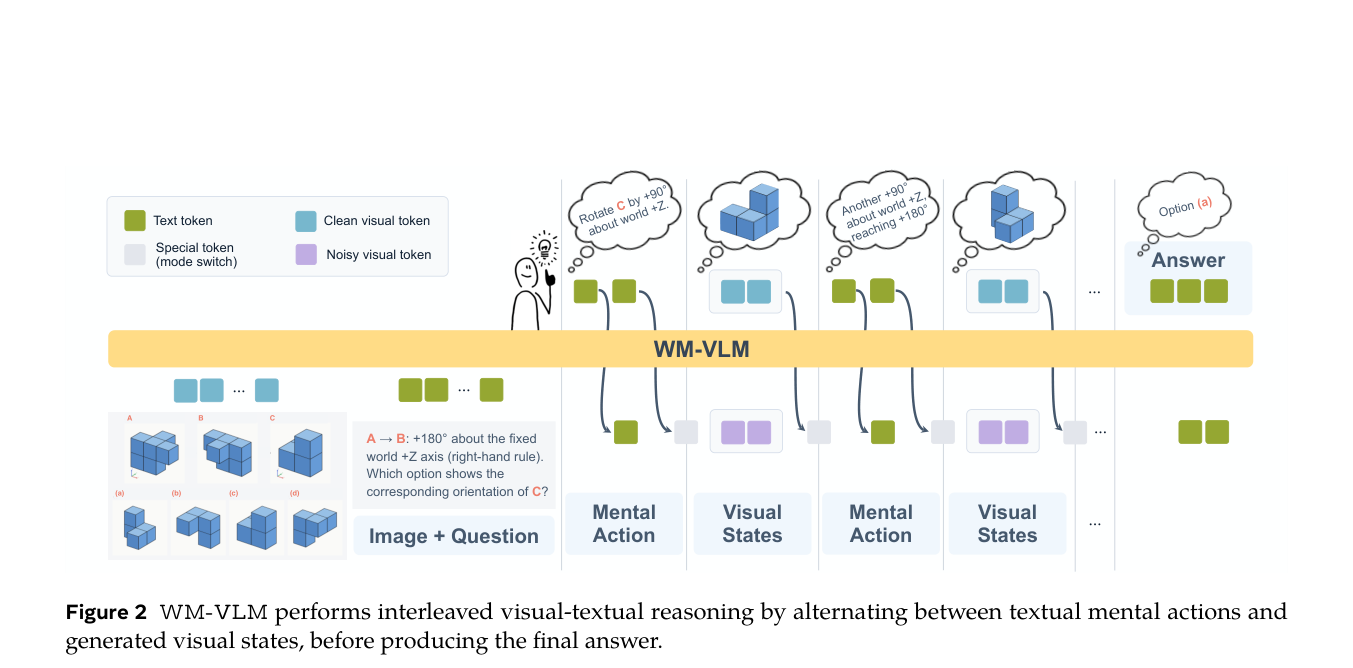
图2展示交错推理:输入图像+问题后,模型在心理动作文本与生成视觉状态之间切换,最终输出选项。含文本、特殊、干净/噪声视觉令牌图例,适合讲清任务形式。
方法结构
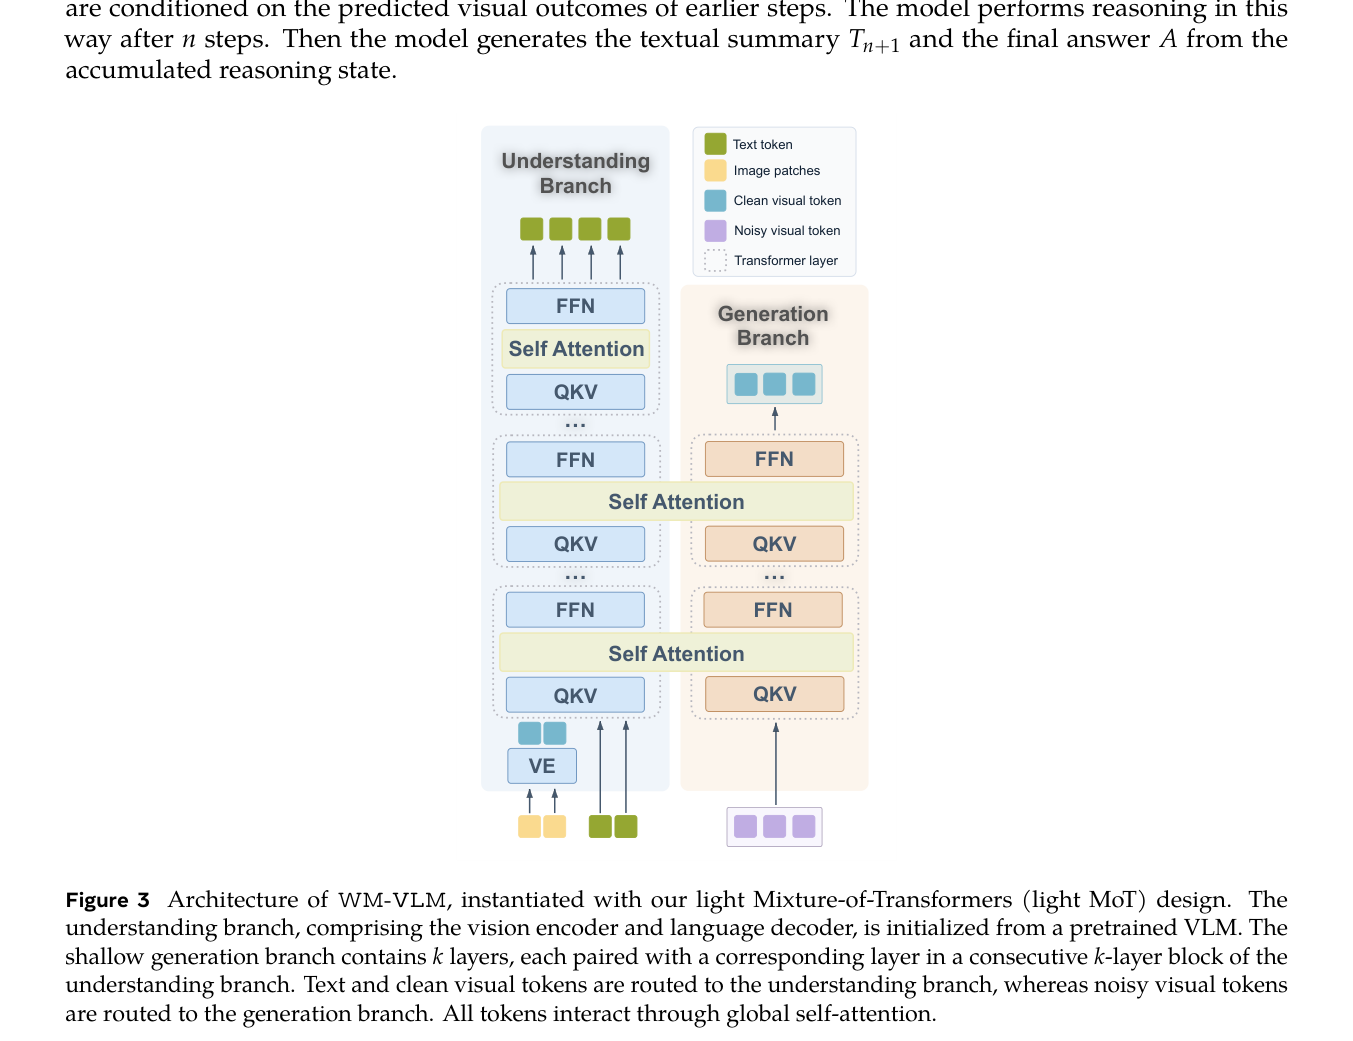
图3是 light MoT 主图:左侧理解分支处理图像块与文本并输出文本;右侧浅层生成分支把噪声视觉令牌变成干净视觉令牌;中间共享自注意力。宜作特色图。
Figure 1 The internal world model module and training objective positively contributes to solving spatial-related proble
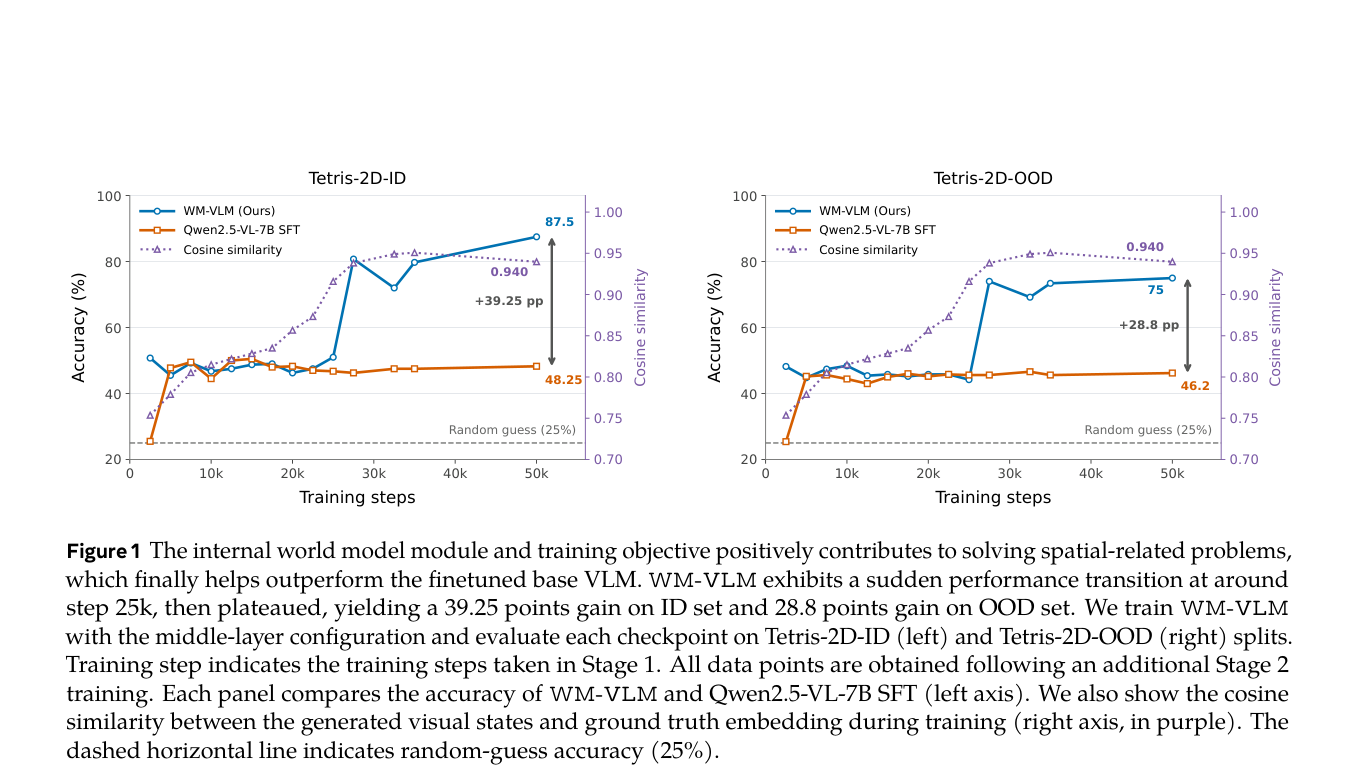
图1左右两面板分别是 Tetris-2D ID/OOD:蓝线 WM-VLM 准确率、橙线 SFT、紫线生成-真值余弦。约25k step 突然跃迁后,ID/OOD 相对 SFT 分别 +39.25/+28.8 个百分点,适合开篇讲“质量够了才有用”。
实验如何设计?
- 主表:Tetris-2D ID/OOD 与 Tetris-3D SC-ID/C-ID/OOD;对照 Qwen2.5-VL-7B-Instruct、同设定 SFT、LatentUM、Mirage、ThinkMorph 等。
- 因果与质量:视觉令牌检索正确/错误时的条件准确率;中间令牌全零/随机/打乱;像素级中间态替换作对照。
- 训练与结构消融:视觉令牌数量、CE与FM损失比、生成分支层窗口、插入深度、两阶段相对从零联合训练。
- 骨干与生成分支均围绕 7B 级 Qwen2.5-VL;视觉编码器全程冻结。
关键结果与论文证据
- 相对同设定 SFT,WM-VLM 在 Tetris-2D ID/OOD 达到 87.50/75.00(+39.25/+28.80),在 Tetris-3D 三拆分达到 91.00/66.25/71.80(最高提升 +21.75,最小也有 +16.30)(页6,Table 1)。
- 图1显示约 25k step 出现突然跃迁:当生成视觉状态与真值嵌入余弦升至约 0.94 后,准确率才从接近 SFT 水平跳到高位平台,说明“会生成”且质量够用是增益前提。
- 检索正确时 Tetris-2D-ID 准确率 89.38,检索错误时仅 35.71(−51.79);把生成令牌换成全零嵌入更会掉到 14.00(−73.50),打乱令牌也有明显下降,支持答案依赖内部视觉状态(页7–8)。
- 相较之下,替换像素级中间图对准确率影响很小,甚至略升,说明关键通路是连续视觉令牌而非外渲染像素(页8,Table 3 vs Table 4)。
- 浅层四层生成分支已接近更深配置;损失比与令牌数需要折中;作者报告从零联合训练在该设定失败,两阶段课程更关键(页9–10)。
阅读时需要注意
- 诊断任务虽可控,但距离开放视觉问答与真实具身交互仍有分布差距。
- 优化对两阶段安排与损失权重敏感;视觉状态质量不足时增益有限,OOD 检索 top-1 明显更低。
- 目前公开材料未见独立代码或项目页,复现成本更高。
关联工作
- 外部工具编辑与外部世界模型调用代表“中间态在模型外”的路线。
- Mirage、LatentUM、Monet 等探索 VLM 内连续/离散视觉潜变量。
- Mixture-of-Transformers 提供多分支路由骨架,WM-VLM 将其收成 light MoT。