快速导读:SemanTok 在灵活视频分词器上加入冻结 DINO 的编码器输入与前缀级语义头,让短 token 前缀先锁定片段语义,从而用更小的自回归模型达到更高生成保真与对齐。
自回归视频生成把片段压成离散 token 再逐个预测,扩散解码器负责还原像素。固定网格分词给简单镜头和复杂追逐同样长度,算力随序列线性涨。灵活长度、由粗到细的分词器允许推理时只生成前缀 k:前面的粗 token 应先锁定“这段视频里有什么”,后面的细 token 再补外观。
现有灵活分词器多把 REPA 打在解码器浅层,而解码器同时还看见带噪潜变量,低噪声时几乎不靠 token 也能对齐教师。SemanTok(arXiv:2610.00686,Stability AI / KIT)在 VideoFlexTok 配方上加入冻结 DINOv2:特征进入编码器,并且每个被保留的前缀都要单独预测这些特征。作者报告 201M 的 SemanTok 自回归模型可匹配或超过 3.4 倍大小的 VideoFlexTok 模型。项目页见(https://semantoken.github.io)。
英文题目:SemanTok: Predictable Semantic Tokens for Efficient Autoregressive Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2610.00686
原始论文:PDF / 论文页面
这篇论文解决什么问题?
token 必须既好预测又够解码。固定网格让所有片段同一预算;灵活前缀则要求任意截断仍能出片,并希望语义集中在短前缀,好让小模型先决定内容、大模型再修细节。
VideoFlexTok 用 nested dropout 与解码器 REPA 做到“任意前缀可解码”,但 REPA 读的是解码器隐状态,解码器输入里的带噪潜变量会泄露教师目标。图9表明低噪声时对齐几乎不依赖 token。
因此要把语义监督接到“只有 token、没有带噪潜变量”的路径上,并且不改词表、解码器接口与自回归训练配方,才能公平比较分词器本身。
核心创新
- 把冻结 DINO 同时用作编码器输入与每个保留前缀的预测目标,监督路径不看带噪潜变量。
- 不改词表、解码器与自回归接口,使语义增益可直接归因于分词器。
- 用前缀可预测性(更低比特/token)解释小模型也能先锁定内容、细节后置。
方法概览
保持 VideoFlexTok 的 VAE、因果编码器、FSQ(约 6.4 万词表)、nested dropout、流匹配解码器与解码器 REPA。拼接 DINOv2-L patch 到编码器,把类别 token 注入首个 register;Dense / Class DINO 头只从因果前缀用交叉注意力重建教师特征。自回归模型按时间优先、由粗到细预测,推理时选 k 解码任意前缀。
- 基线路径保持不变:冻结 VidTok VAE 把 17 帧、128×128 视频映到潜变量;每帧 256 个 patch 与 256 个可学习 register token 按时序交错送入因果编码器;只保留 register 输出,经 FSQ 量化到约 6.4 万词表。训练时对每个片段均匀采样 k∈{1,2,4,…,256},把后缀换成 mask,解码器用流匹配重建潜变量,并保留解码器 REPA。
- SemanTok 的增量有三处。编码器把对齐的 DINOv2-L patch 与 VAE patch 拼接后再投影;把 DINO 类别 token 的零初始化投影加到每帧第一个 register。两个独立交叉注意力头只读当前及过去帧的保留前缀:Dense DINO head 用空间 query 重建 16×16 DINO patch,Class DINO head 重建类别 token,损失均为 1−cosine,权重各 0.5。它们从不看见带噪潜变量,只有 token 能把损失打下去。没有损失指定“某个 DINO 特征必须进某个 token”,顺序由共享前缀约束与 nested dropout 涌现。
- 分词器冻结后,LLaMA 风格自回归模型按时间优先、由粗到细的顺序预测全部 TK 个索引;推理时选预算 k,解码器把任意生成前缀渲染成视频。评测扫 49M 到 2.29B 共七档模型,类别条件用 Kinetics-600,文本条件用 uCO3D(含训练未见类别)。
逐图理解论文
解码器对齐漏洞
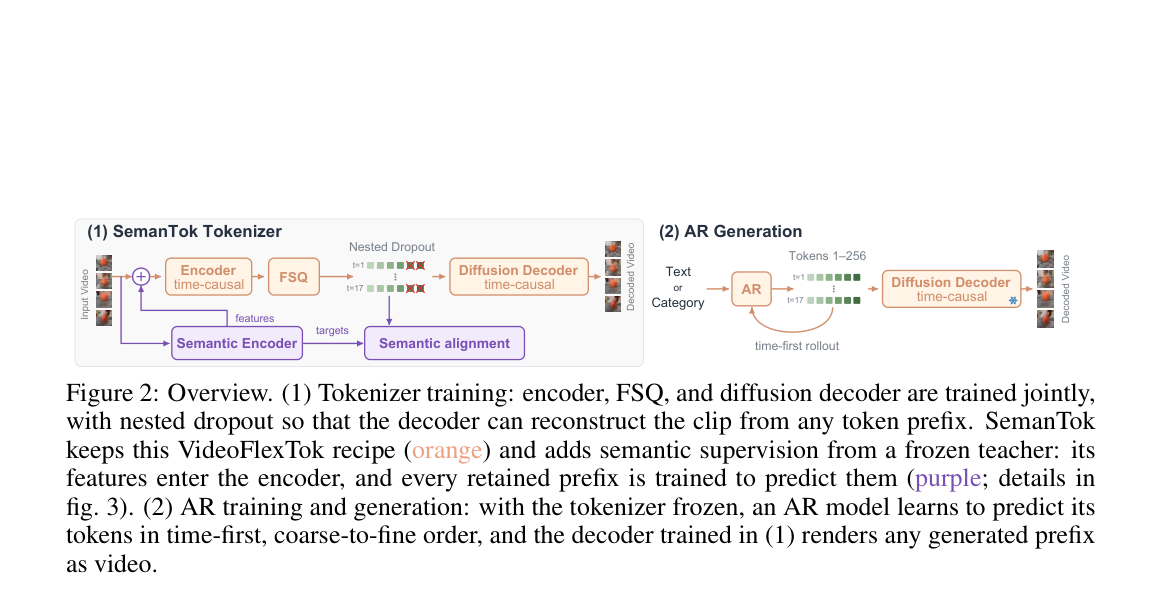
图2总览:左为分词器训练,橙色是 VideoFlexTok 的 Encoder–FSQ–nested dropout–扩散解码器,紫色是冻结教师进入编码器并监督每个保留前缀;右为冻结分词器后的时间优先自回归生成,任意前缀都可解码成视频。宜作特色图。
算力包络
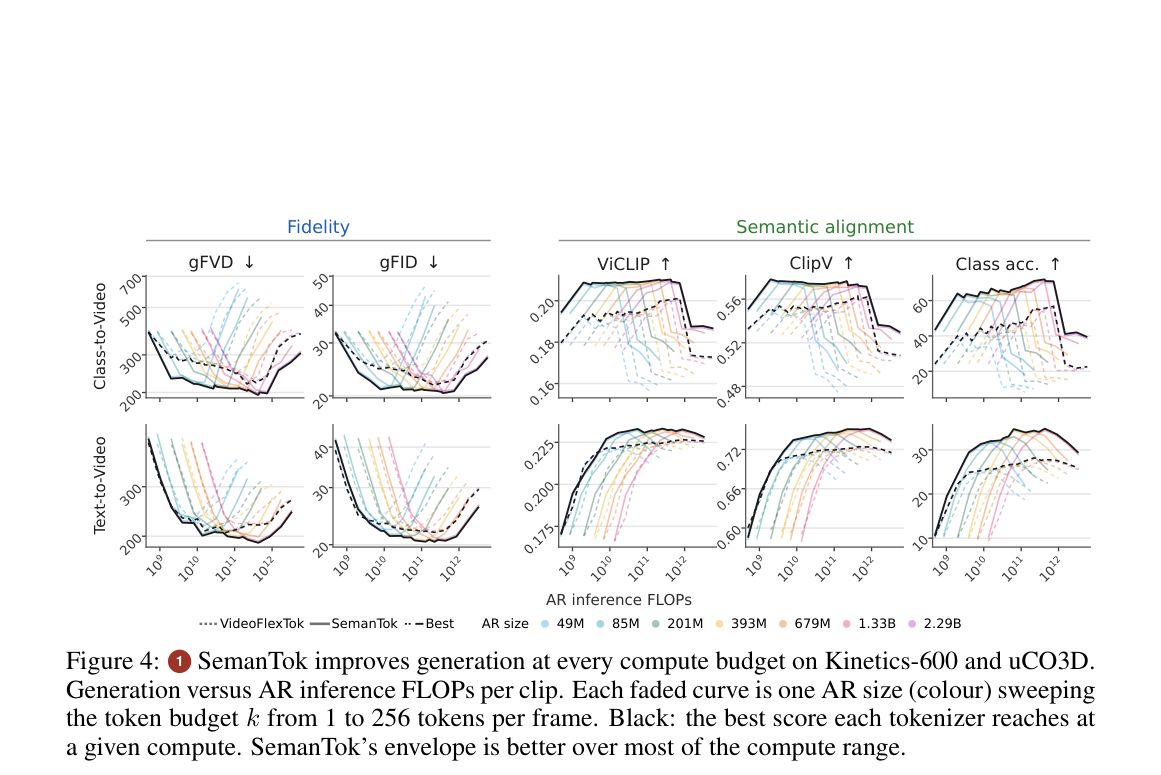
图4把生成质量对自回归推理 FLOPs 作图:上排 Kinetics-600 类别到视频,下排 uCO3D 文本到视频,五列分别为 gFVD、gFID、ViCLIP、ClipV、类别准确率。实线 SemanTok、虚线 VideoFlexTok,黑色为各算力下的最优包络。
定性与重建权衡
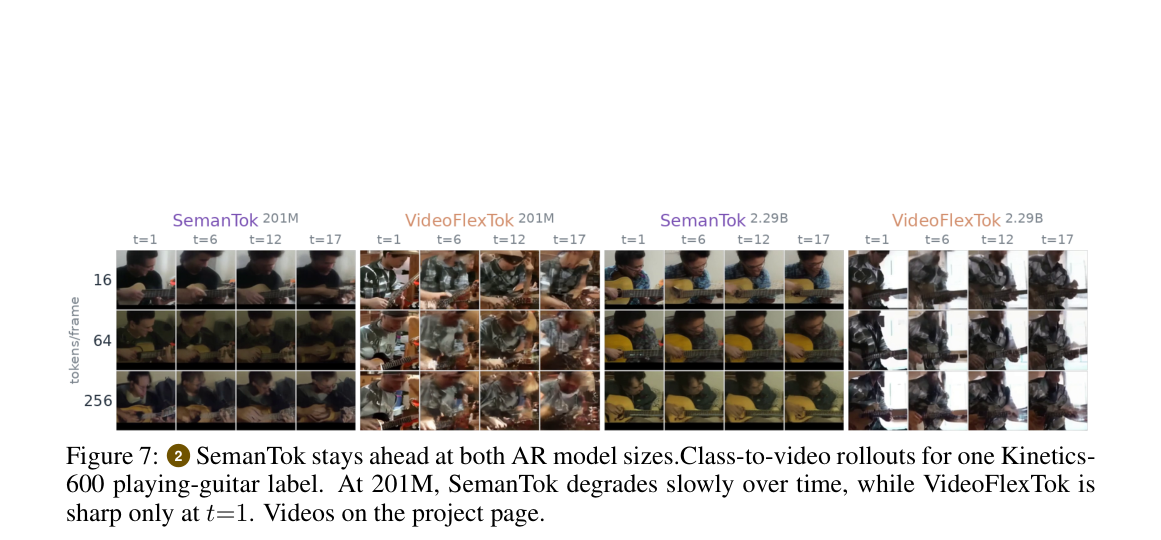
图7是 Kinetics-600「弹吉他」的定性卷出:四列对比 201M / 2.29B 的两种分词器,三行 token 预算 16/64/256,时间为 t=1,6,12,17。201M 的 VideoFlexTok 很快糊掉,SemanTok 人物与吉他更稳。
实验如何设计?
- 对照只换语义监督,词表、序列长度、采样与自回归配方与 VideoFlexTok 相同。保真度用 gFVD / gFID;语义用类别准确率、ViCLIP、ClipV,以及解码器 REPA 的 DINOv2 余弦。Kinetics-600 用 UMT-L 闭集 top-1(2048 个生成片段);uCO3D 用 InceptionV3 近邻类均值,以便对未见类仍有定义。
- 效率从两层看:达到给定分数所需的自回归参数量,以及验证交叉熵(比特/token)。所有模型都在每帧 256 token 上训练,k 只在评估时截断。另有 1.33B 模型从 1.3B 训到 65.5B token 的数据扩展实验。
- 机制实验包括:在纯噪声到较干净潜变量上读解码器 REPA;强制前 m 个真值 token 再自由生成以定位增益来自哪些位置;以及 tokenizer 重建与生成之间的 realization gap。
关键结果与论文证据
- 图4显示:在 Kinetics-600 与 uCO3D 上,SemanTok 的最优包络在大部分算力区间都优于 VideoFlexTok。正文写明 Kinetics-600 上 gFVD 降 11–24%、gFID 降 5–17%、类别准确率升 25–61%,小模型收益最大;uCO3D 上三类指标分别改进 2–13%、5–8%、22–30%(页6)。49M 的 SemanTok 在两套数据的类别准确率、ClipV、ViCLIP 上超过任意规模(直至 2.29B)的最佳 VideoFlexTok;Kinetics-600 类别准确率为 0.631 对 0.560(页7)。
- 图7的“弹吉他”类别生成中,201M 的 VideoFlexTok 几乎只在 t=1 清晰、随后崩坏,SemanTok 随时间退化更慢;放大到 2.29B 两边都更锐,但 SemanTok 仍更稳(页7)。图12的 tokenizer 重建则显示短前缀上 SemanTok 的 ClipV 更高(手电筒 k=8 时 0.85 对 0.66),VideoFlexTok 的 PSNR 更高,对应“语义优先、像素细节后置”的权衡(页13)。
- 表1:201M 模型在 uCO3D 的 ID/OOD 上,k=16 时 SemanTok 生成类别准确率相对 VideoFlexTok 分别高约 24% 与 29%。解码器 REPA 上,纯噪声时 SemanTok 在每个 k 都更高;k=32 的纯噪声读数已达到 VideoFlexTok 在 75% 干净潜变量上的水平(页7–9)。
- 机制上,k=16 时 201M 模型预测 SemanTok 前缀少约 32% 比特(8.8 对 12.9);前 4 个 token 约 37 比特/帧的类别准确率接近 VideoFlexTok 前 32 个 token(约 405 比特)。把前 16–64 个真值 token 强制写入后,生成 gFVD 领先消失,说明增益集中在早段前缀(页7–8)。
阅读时需要注意
- 论文明确:因为优先语义对齐而非重建,低预算下颜色与外观细节更弱;uCO3D 重建在 k=16 时 PSNR 大约低 2.7 dB。
- 每帧只留 1 个 token 时无法同时满足流匹配、解码器 REPA 与语义监督,uCO3D 上 k≤4 的 gFID / ClipV 会落后,尽管类别准确率仍领先。
- 评测分辨率 128×128、17 帧,对高分辨率世界模型只是前缀状态的原型;教师是图像 DINOv2 而非视频原生或语言对齐教师。
关联工作
- FlexTok / VideoFlexTok 把图像/视频压成可截断的一维序列并在解码器上做 REPA;SemanTok 保持该接口,把监督改到“前缀单独预测教师”。
- DiGIT、MAETok、VA-VAE、GigaTok 等用基础模型特征改善固定长度图像 token 的可生成性;本文把同样思想放到灵活视频前缀的早段。
- LARP / CRT 用自回归先验塑造码本,常在重建与生成间权衡;SemanTok 用短前缀可预测性来缩小 realization gap。