DocAttriBench:文档视觉问答中的答案溯源基准
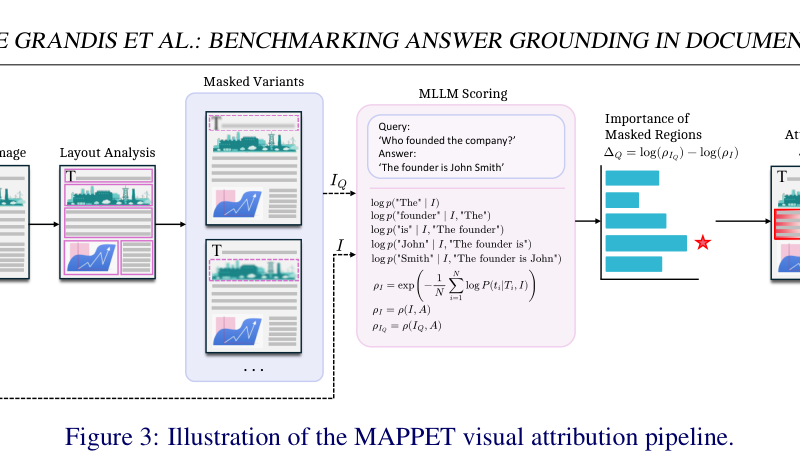
本文提出大规模文档 VQA 答案溯源基准 DocAttriBench,并用掩码困惑度方法 MAPPET 自动把答案落到文本块、表格与图像等版面元素。
本文提出大规模文档 VQA 答案溯源基准 DocAttriBench,并用掩码困惑度方法 MAPPET 自动把答案落到文本块、表格与图像等版面元素。
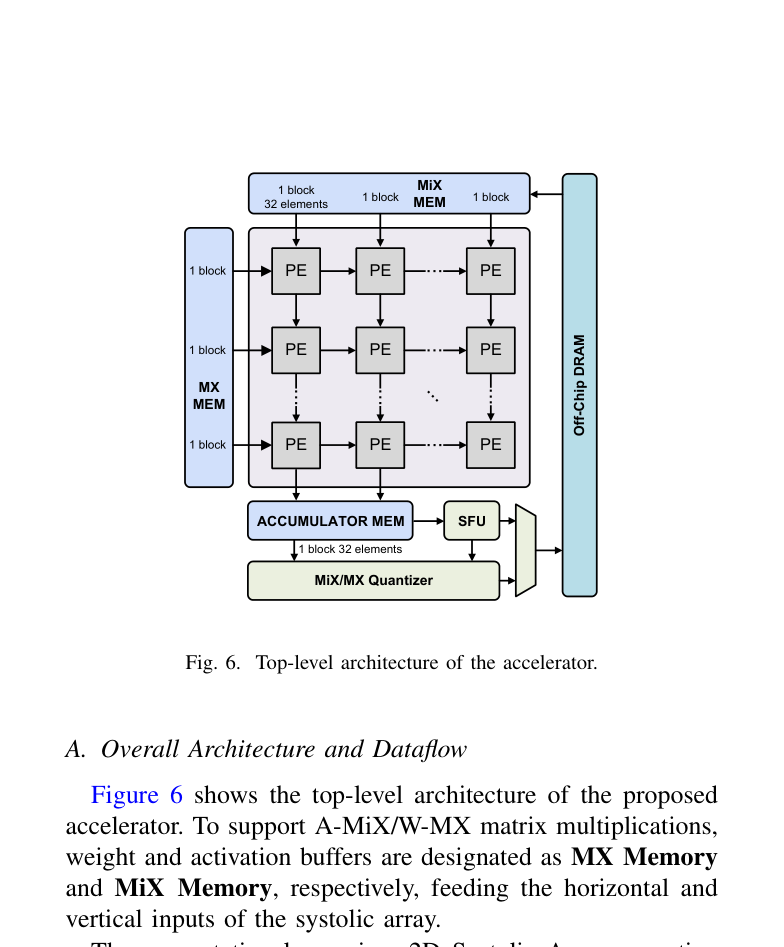
MiX 把微缩放反过来:每个元素自带相对指数、尾数在小组内共享,再与 MX 权重组合成无乘法器双格式脉动阵列,在约 4.5 bit 有效位宽上对齐或超过 NVFP4,并端到端加速视觉语言模型。
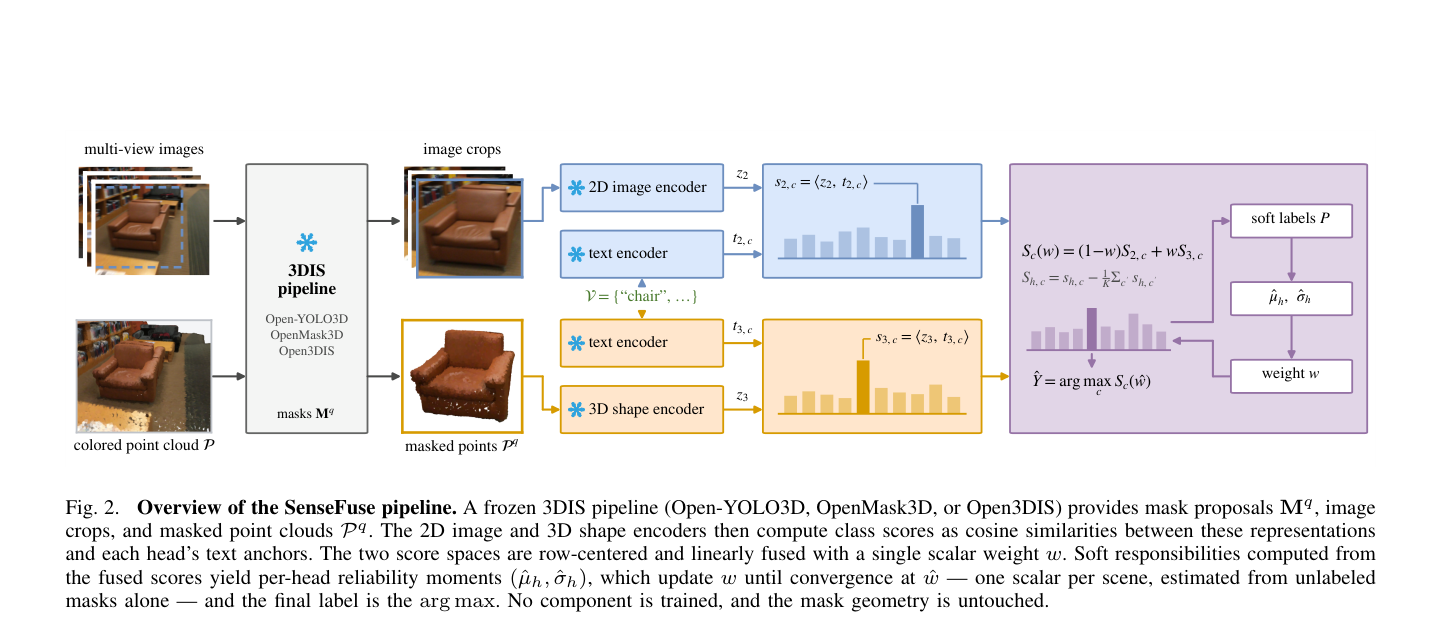
SenseFuse 只改开放词汇三维实例分割的 mask 标注阶段,用无标签敏感度在单场景未标注提议上毫秒级估计场景级融合权重,把冻结的二维图像编码器与三维形状编码器线性融合。
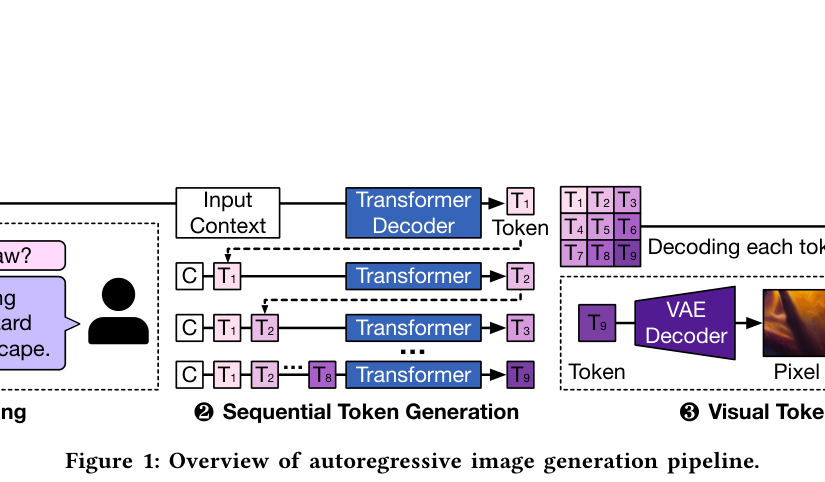
本文系统刻画自回归图像生成的注意力稀疏,发现视觉 token 空间局部性带来的对角稀疏模式,并据此设计对角感知稀疏注意力,在稠密推理质量损失有限的前提下提升吞吐与延迟。
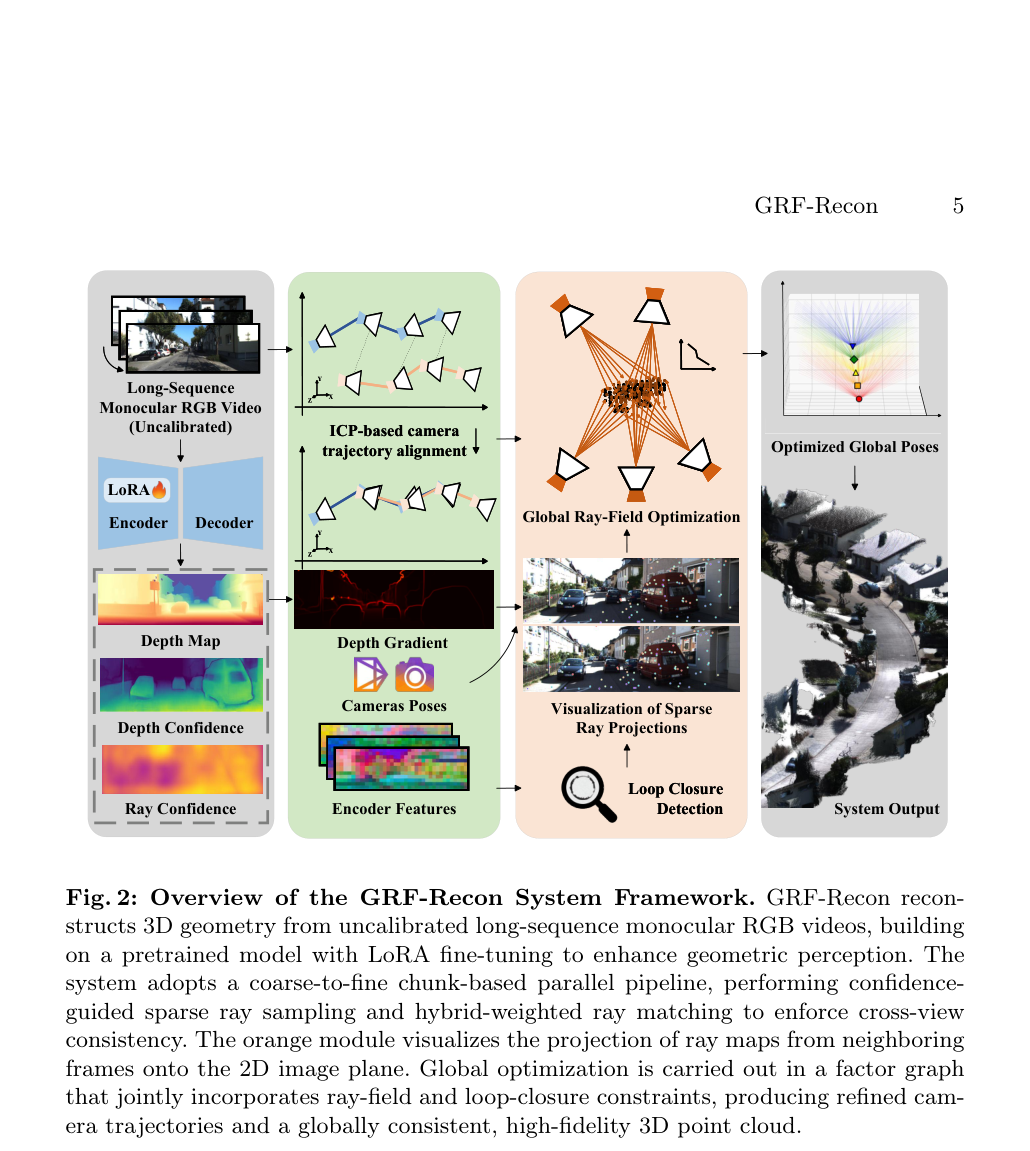
本文提出 GRF-Recon,通过重归一化 LoRA 注入单目几何先验、混合权重稀疏射线场优化与轨迹拼接,把前馈三维重建扩展到千米级未标定单目序列并抑制长期漂移。
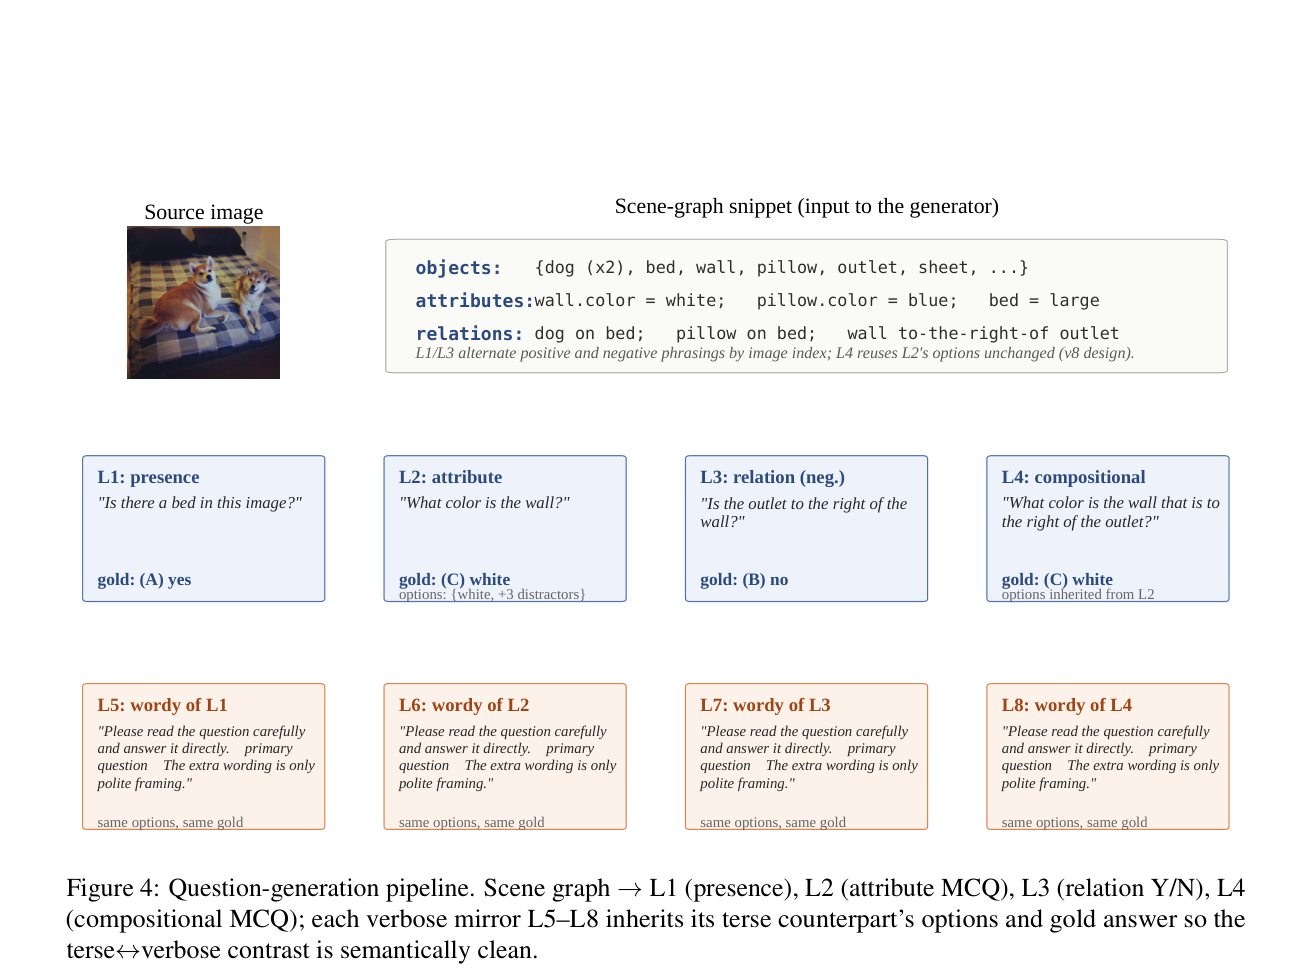
本文提出跨模态注意力在图像频率域上充当任务条件滤波器,发现冗长提示通过拓宽该滤波器的频率支持范围,显著降低了视觉-语言模型在图像损坏下的预测漂移方差。
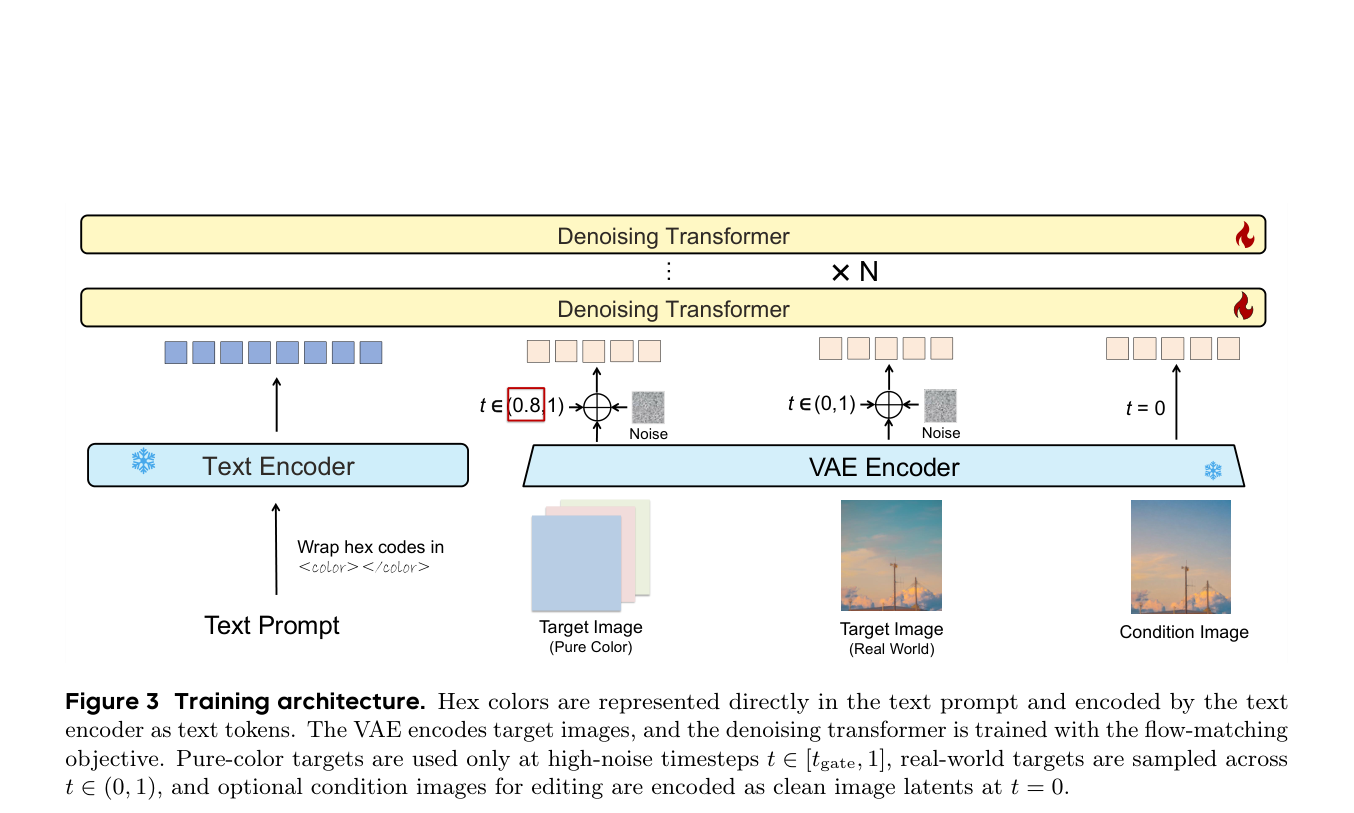
本文提出 Paint-Anything,通过构建 Paint-500K 数据集和引入高噪声纯色彩锚点监督,实现了基于 24-bit hex 提示词的统一图像生成与编辑颜色控制,并在 ACBench 和 CompColor 上显著优于基线模型。
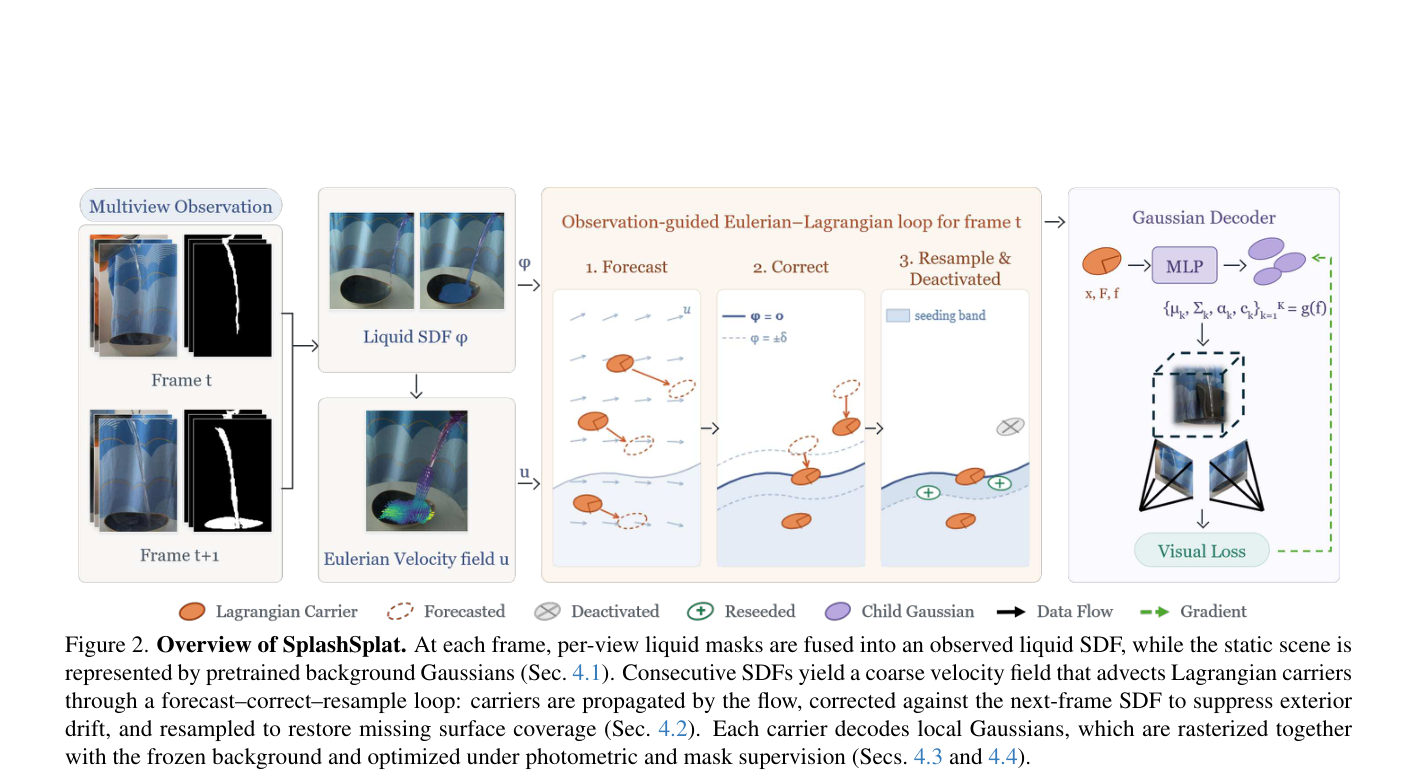
本文提出了首个同步多视角飞溅液体数据集 SplashSplat,并设计了一种基于 Lagrangian carriers 和 SDF 约束的动态高斯泼溅方法,实现了高质量的新视角合成、时间插值和风格迁移。