LAION-Mobile:在百万张智能手机照片上评估 Deepfake 检测器
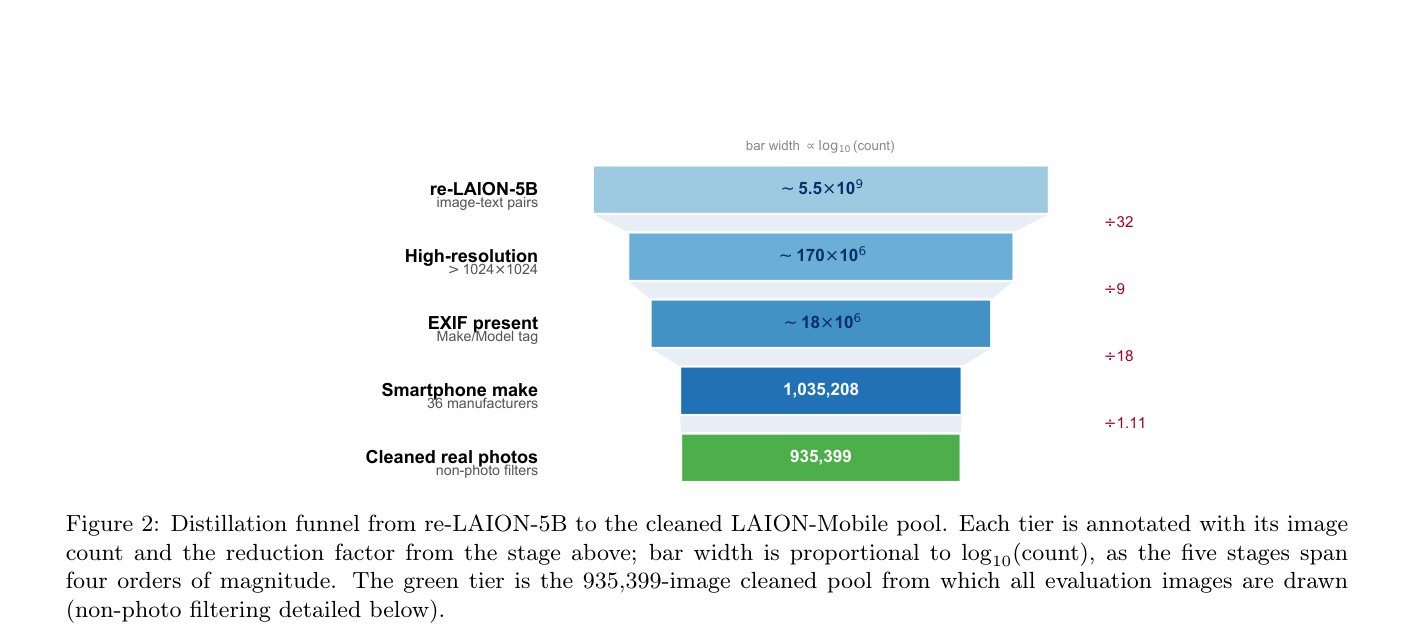
本文构建了包含约100万张智能手机照片的 LAION-Mobile 数据集,审计了12个 SOTA Deepfake 检测器,发现它们在现代 AI 生成内容上性能大幅下降,且在真实手机照片上产生高达 91% 的误报率,证实了计算摄影对检测器构成的挑战。
本文构建了包含约100万张智能手机照片的 LAION-Mobile 数据集,审计了12个 SOTA Deepfake 检测器,发现它们在现代 AI 生成内容上性能大幅下降,且在真实手机照片上产生高达 91% 的误报率,证实了计算摄影对检测器构成的挑战。
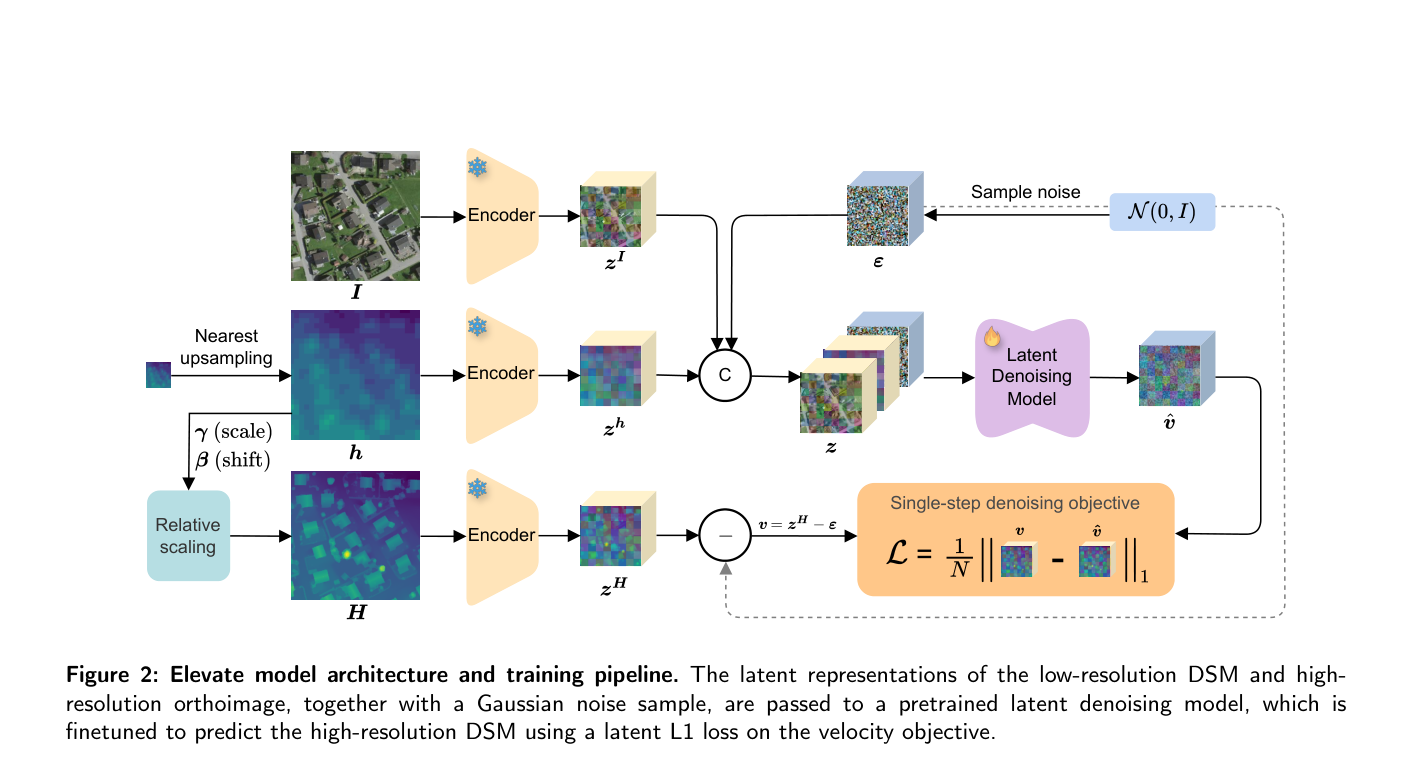
本文提出 ELEVATE 方法,利用预训练的扩散模型(Stable Diffusion)结合高分辨率 RGB 图像引导,将 5m 低分辨率 DSM 超分辨率至 0.5m,并支持单步推理与不确定性估计。
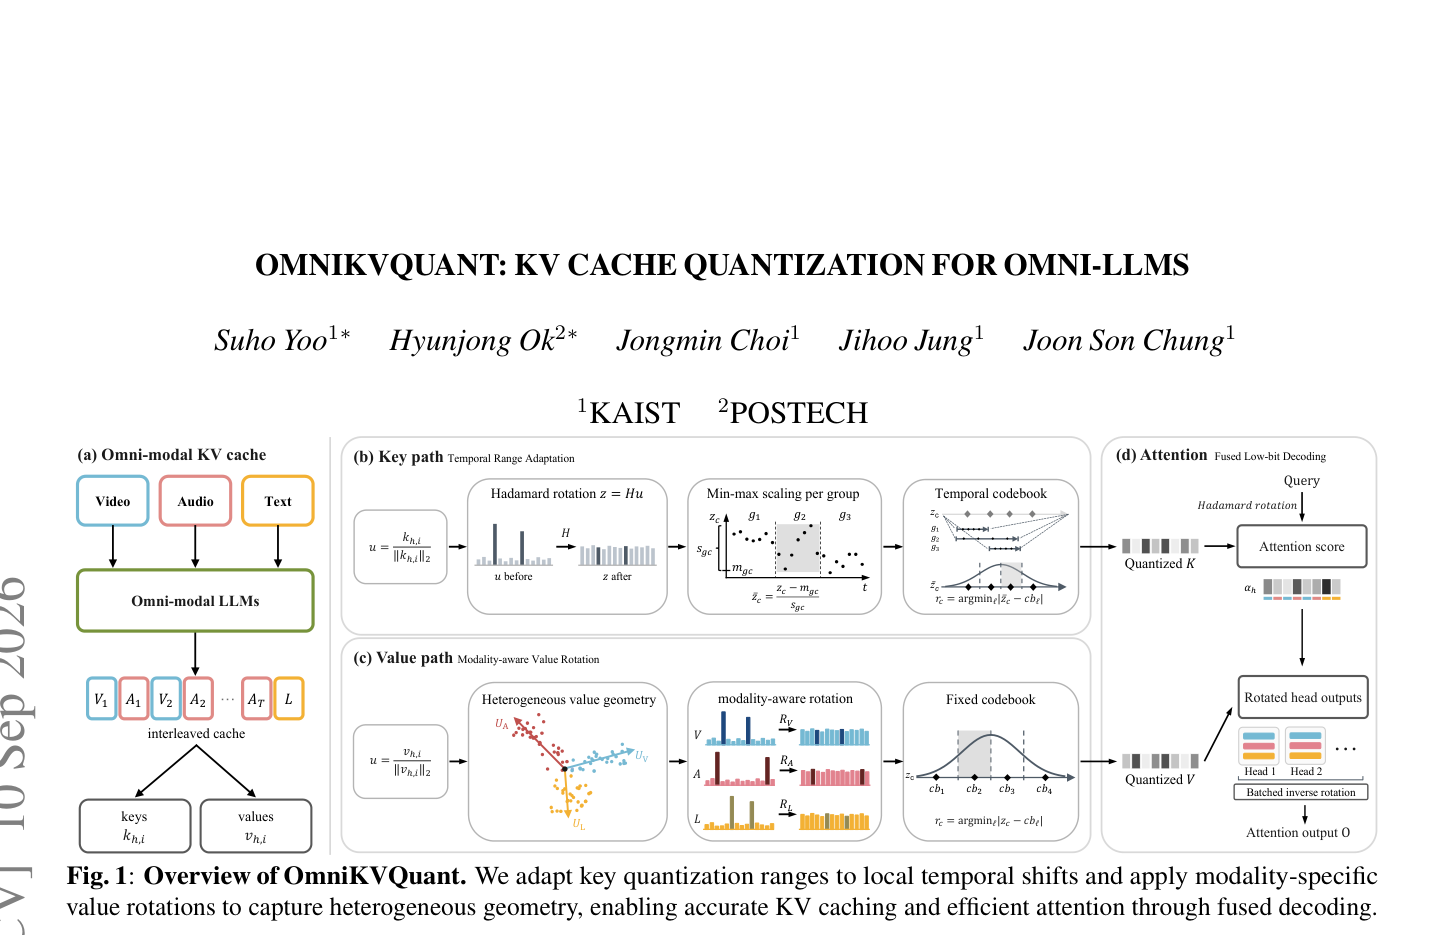
本文提出 OmniKVQuant,一种针对多模态大语言模型(Omni-LLM)的免训练 KV 缓存量化框架,通过局部时间范围自适应和模态感知值旋转,在 2-bit 精度下显著优于 TurboQuant。
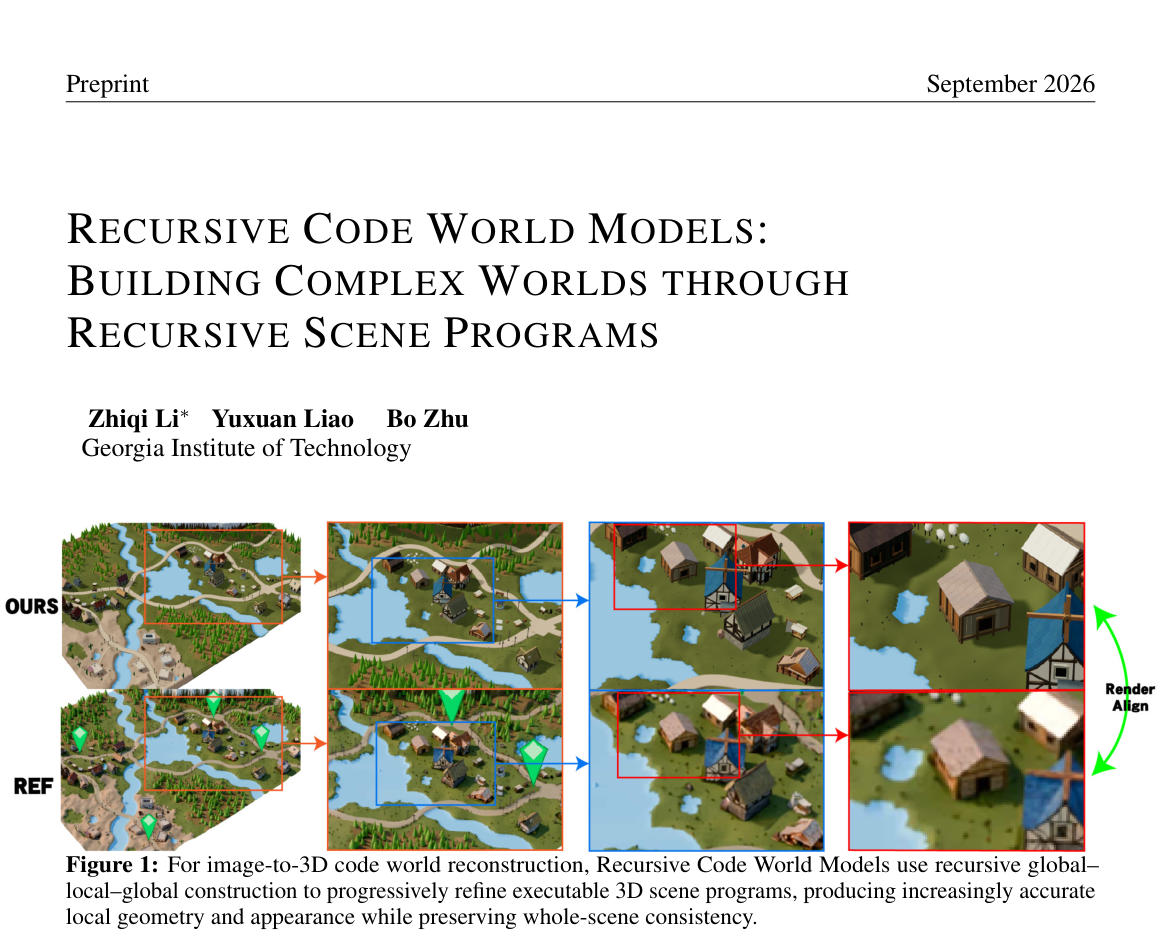
本文提出 Recursive Code World Models (RCWM) 框架,结合 Recursive Scene Programs (RSP) 表示与递归求解器,通过“建立整体-递归重构局部-回访整体”的循环,从单张参考图像重建高保真且可执行的 3D 场景程序。
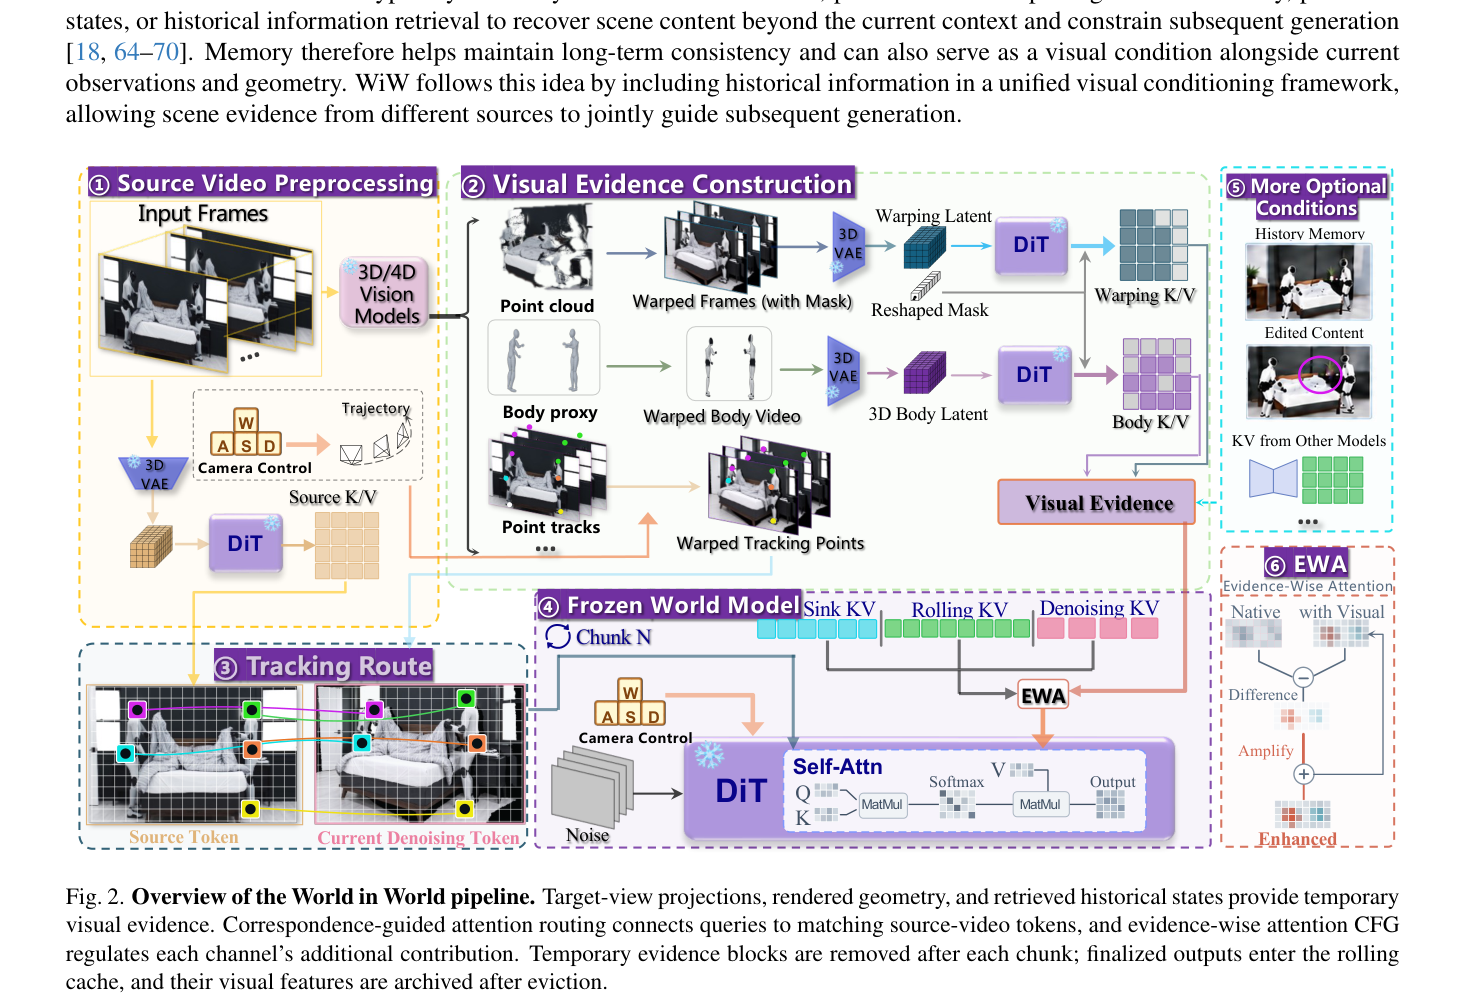
提出了一种免训练的视觉证据接口 World in World (WiW),通过原生自注意力机制将异构控制证据(源视频、投影、几何、历史)转化为冻结因果视频世界模型可读取的干净视觉状态,实现灵活且一致的长时程视频重渲染与探索。
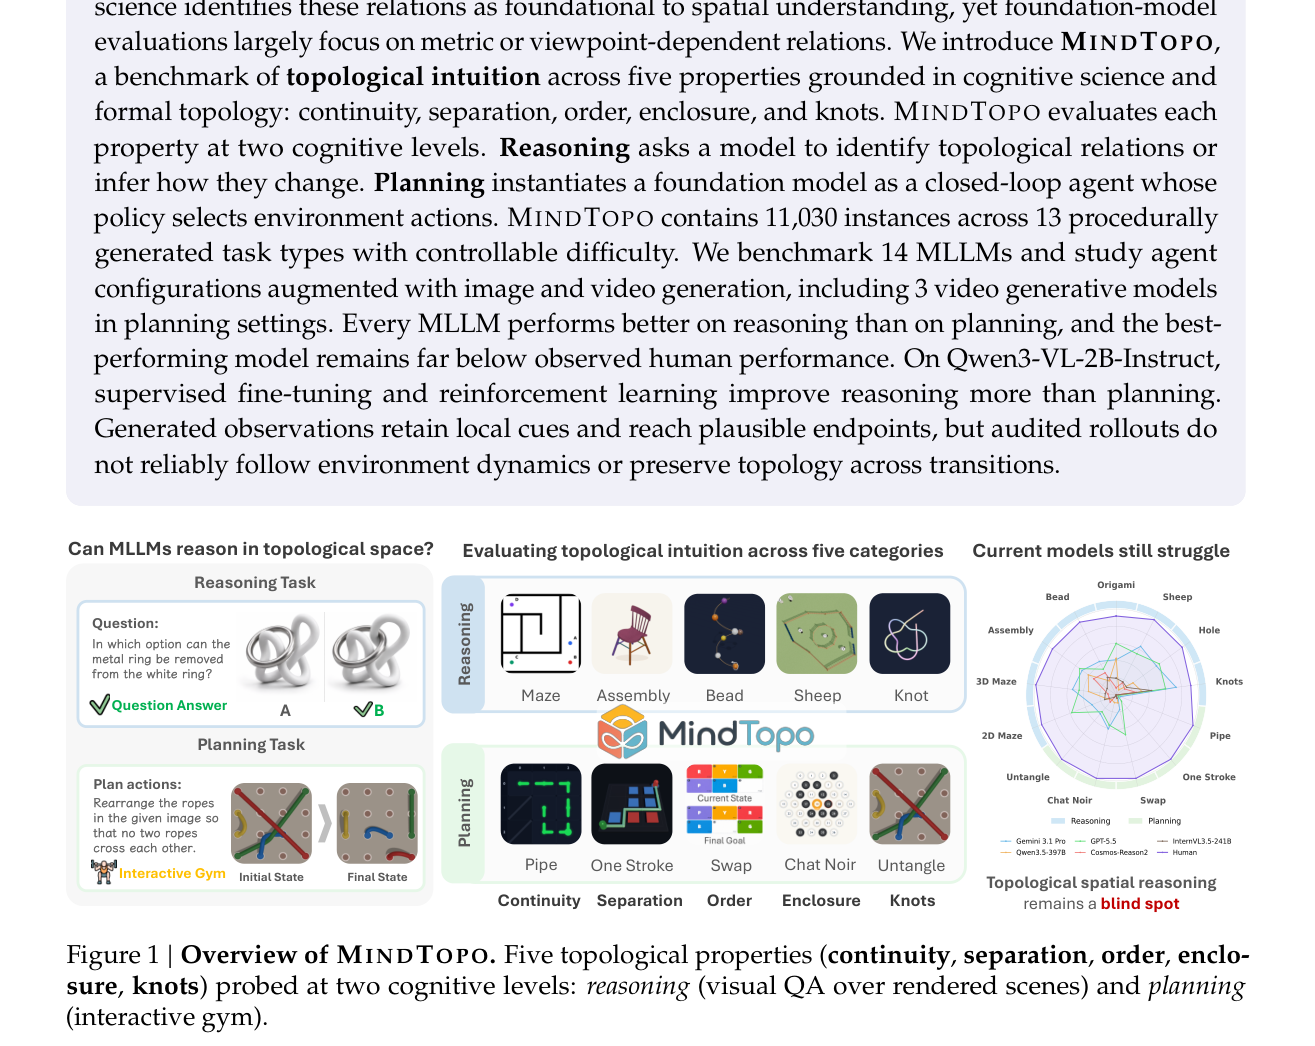
本文提出 MINDTOPO 基准,基于认知科学和形式拓扑学定义五种拓扑属性,通过推理和规划两个认知层级评估 14 个 MLLM 的拓扑直觉能力,发现模型在静态推理上表现优于交互式规划,且视频生成代理无法可靠保持拓扑不变性。
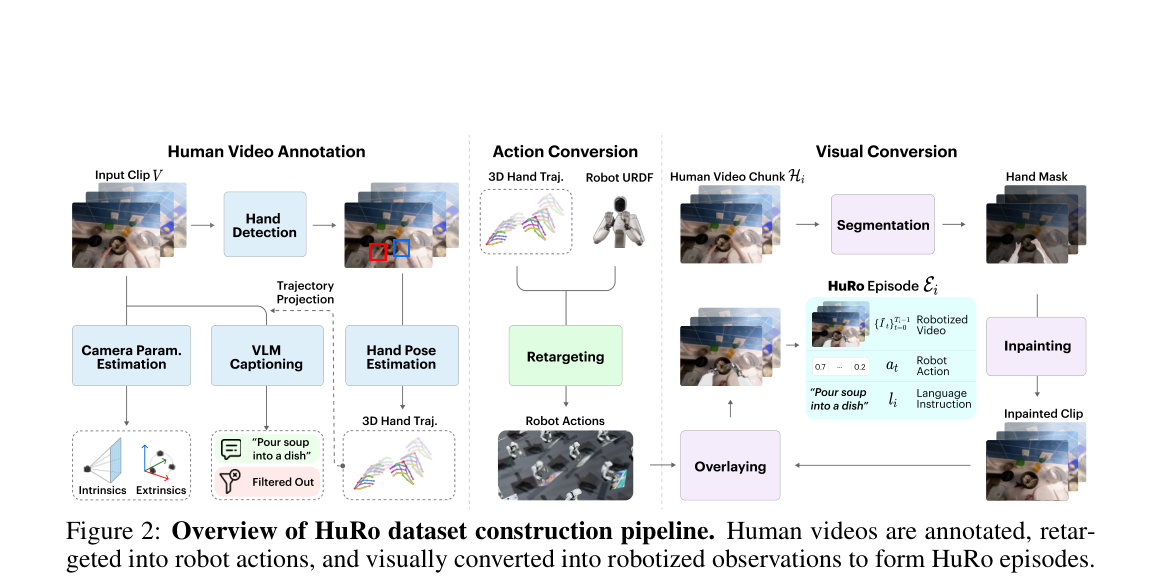
本文提出 HuRo 流水线,将大规模人类视频转化为对齐的机器人观测与动作数据,构建包含 630K 个 episode 的 HuRo 数据集,证明其作为 VLA 策略预训练源的可扩展性及在真实世界操作任务中的优越性能。
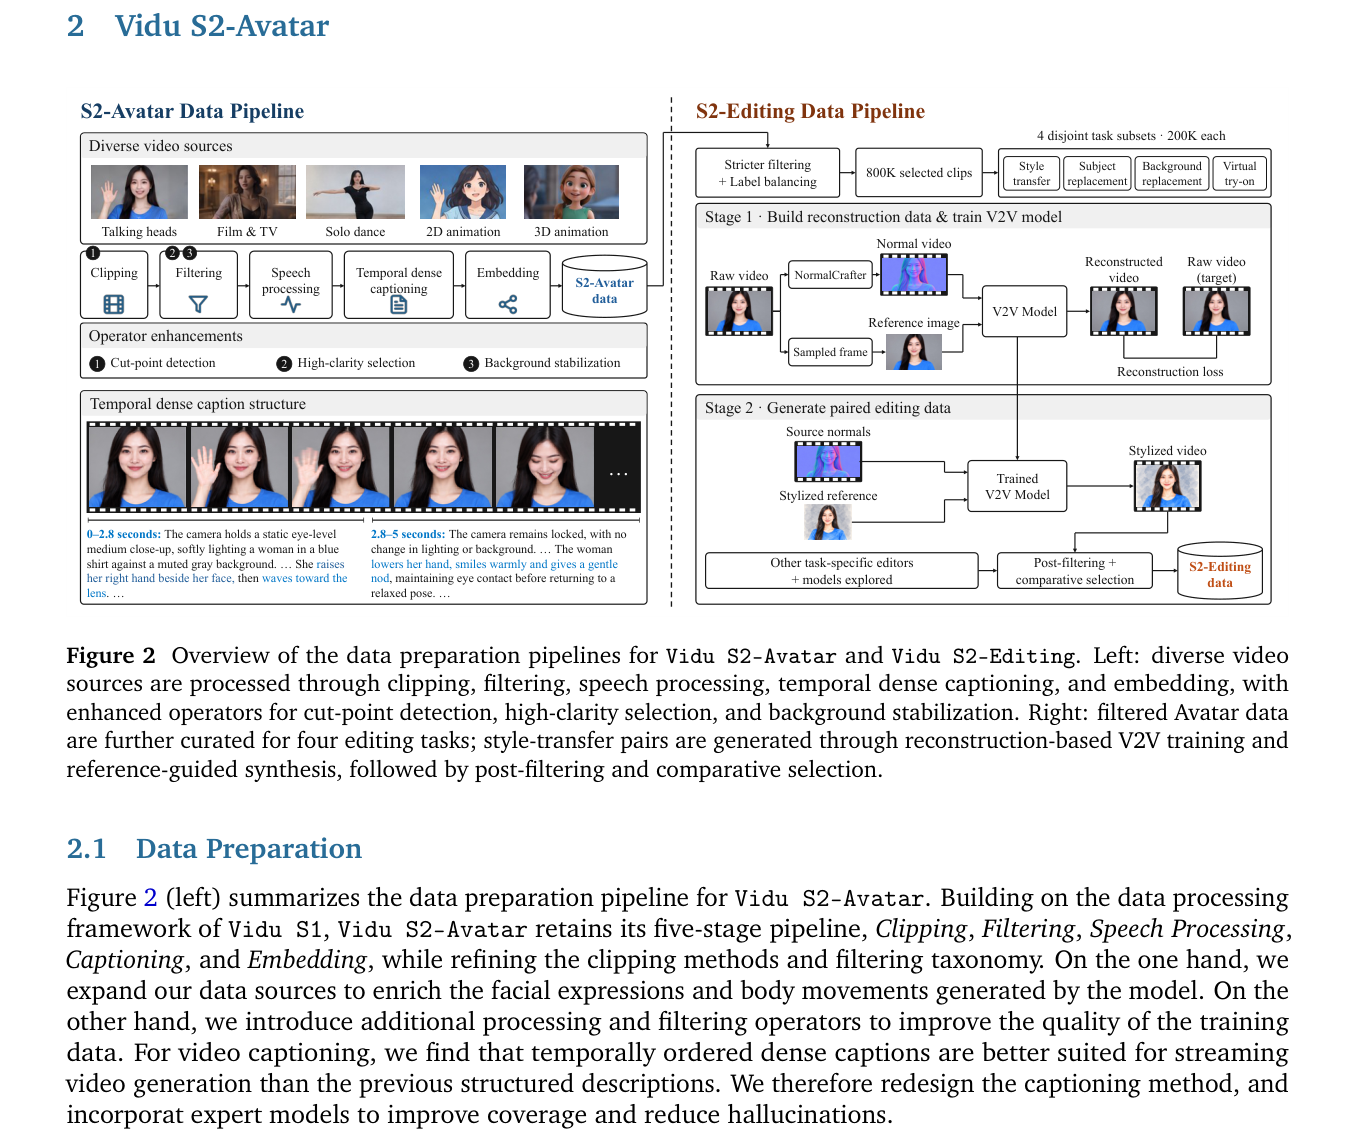
Vidu S2 提出了支持实时 720p 交互数字人生成(Vidu S2-Avatar)和实时视频流编辑(Vidu S2-Editing)的模型,并探索了实时空间视频生成,在多项基准测试中优于现有基线。
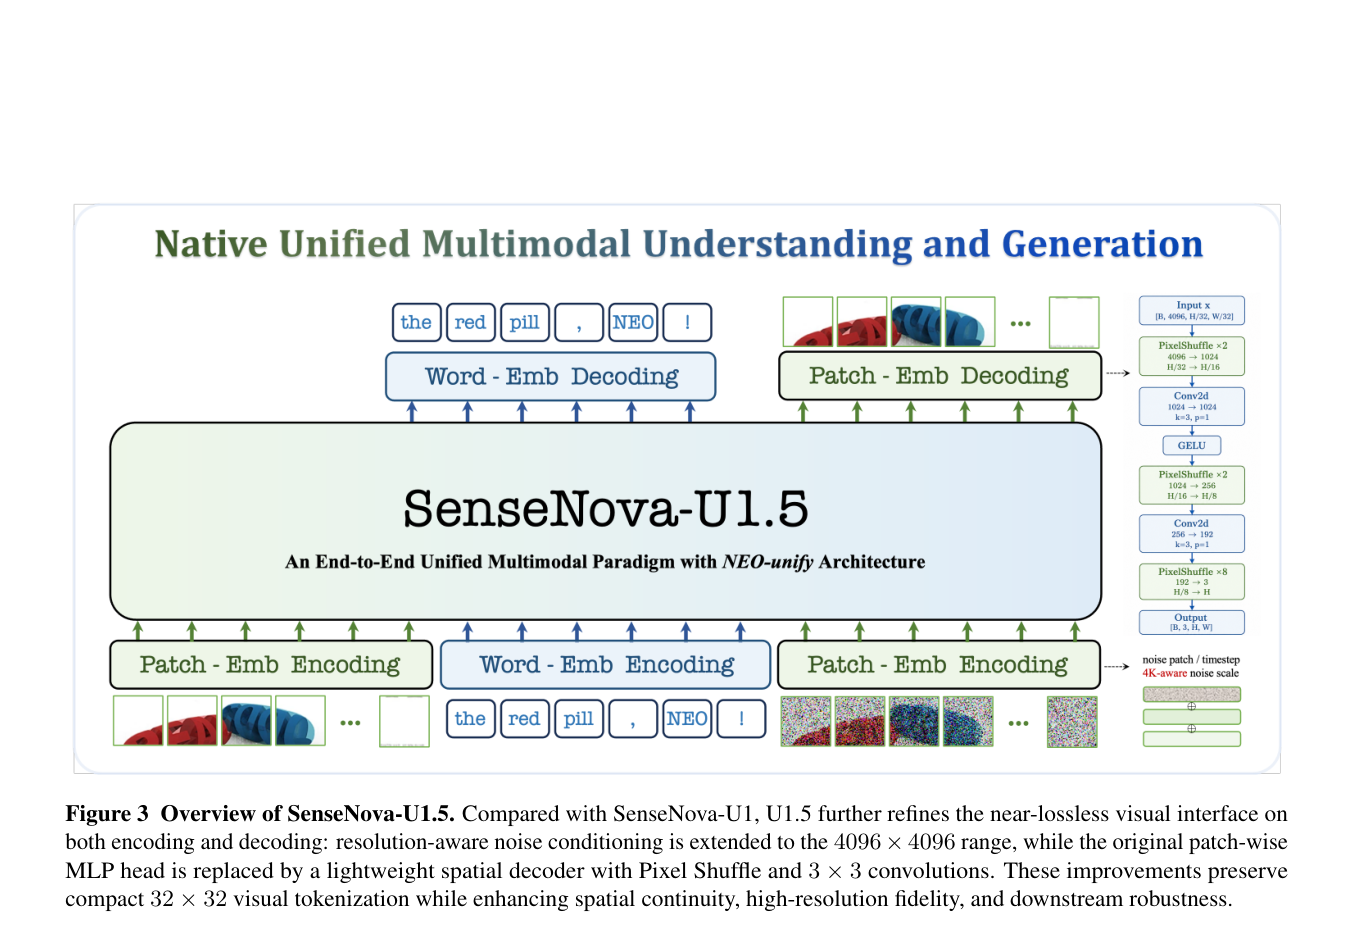
SenseNova-U1.5 是一个 8B 参数的原生统一多模态模型,通过空间联合重建解码器和多专家强化学习及蒸馏策略,在无需外部编码器和 VAE 的情况下实现了高质量的视觉理解、推理与生成。