外护栏挡提示和成片,内护栏改嵌入并中途停
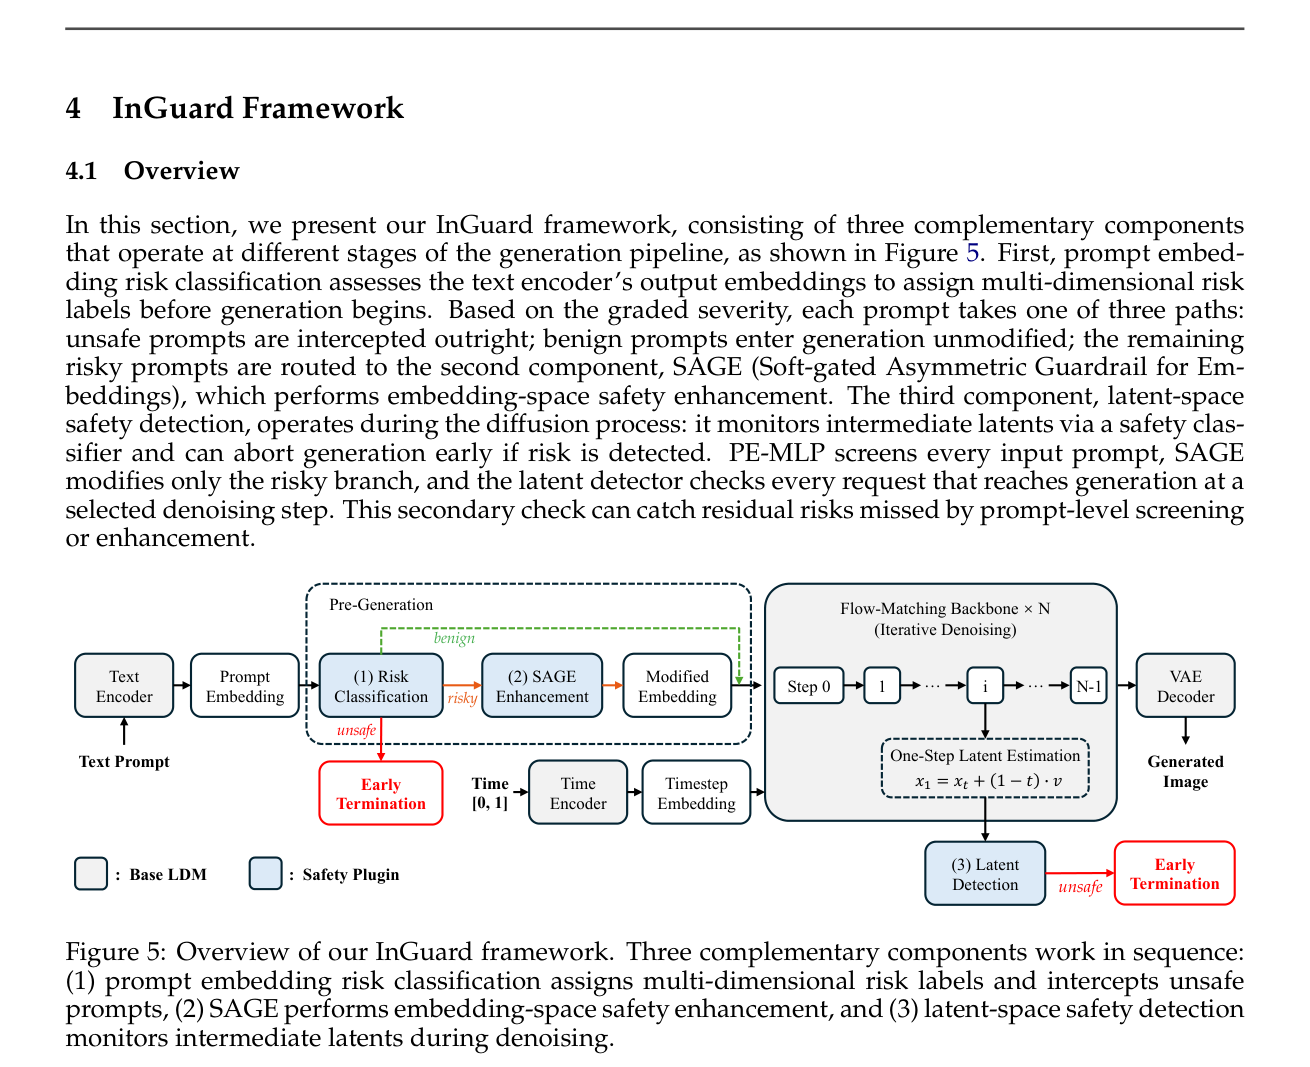
阿里 AAIG 提出 InGuard:用模型自身提示嵌入与中间潜变量做内护栏,在五套开源文生图上达到约 97.9–98.8% 安全率,并相对外护栏降低良性打扰;代码已开源。预印本。
阿里 AAIG 提出 InGuard:用模型自身提示嵌入与中间潜变量做内护栏,在五套开源文生图上达到约 97.9–98.8% 安全率,并相对外护栏降低良性打扰;代码已开源。预印本。
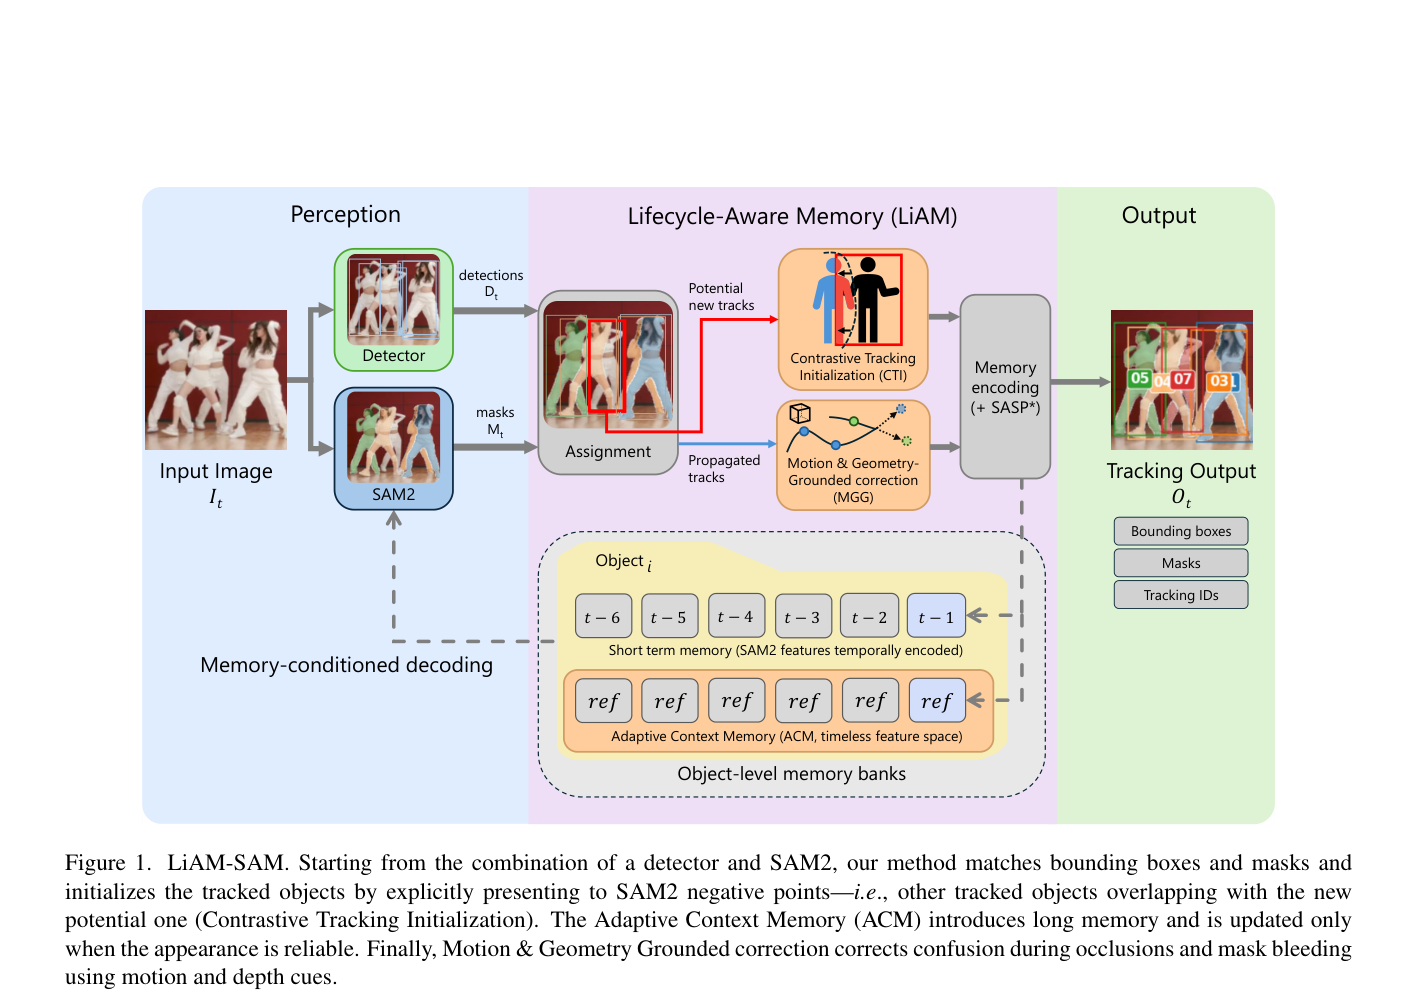
丰田欧洲把检测器提示的 SAM2 跟踪写成生命周期记忆完整性问题,用 CTI、ACM、MGG 和可选 SASP 分别处理开轨、再识别、交互漂移与注意力成本;DanceTrack 验证集消融相对基线约 +10.5 HOTA、+17.4 AssA、身份切换降约 96%。预印本,无独立代码,待核验。
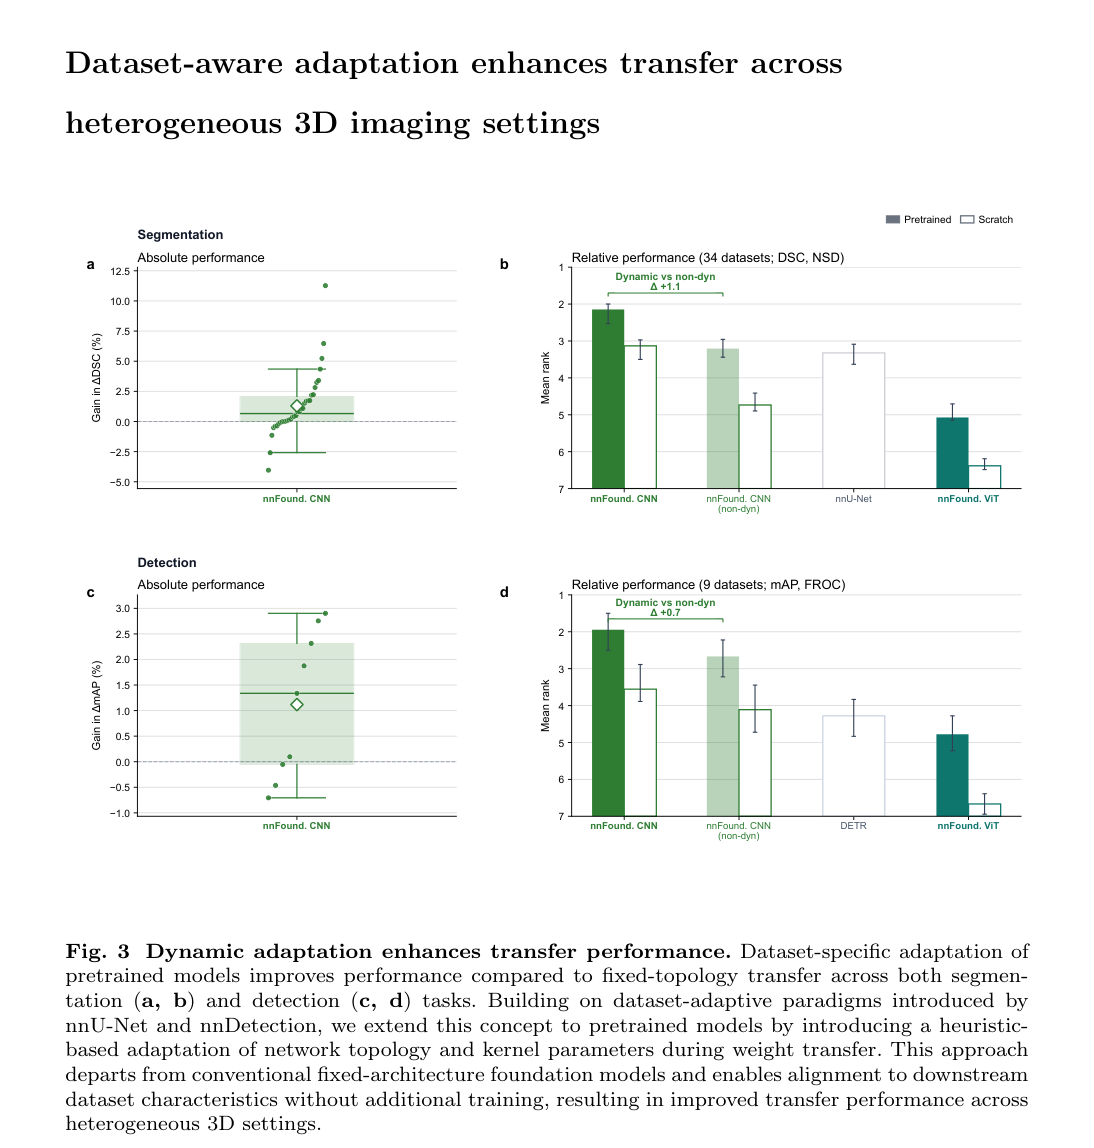
nnFoundation 在 210 万 CT/MRI/PET 体积上预训练一对 CNN 与 ViT,并在 108 项下游任务上显示可迁移的三维放射学表征,同时强调任务依赖架构与数据集感知适配。
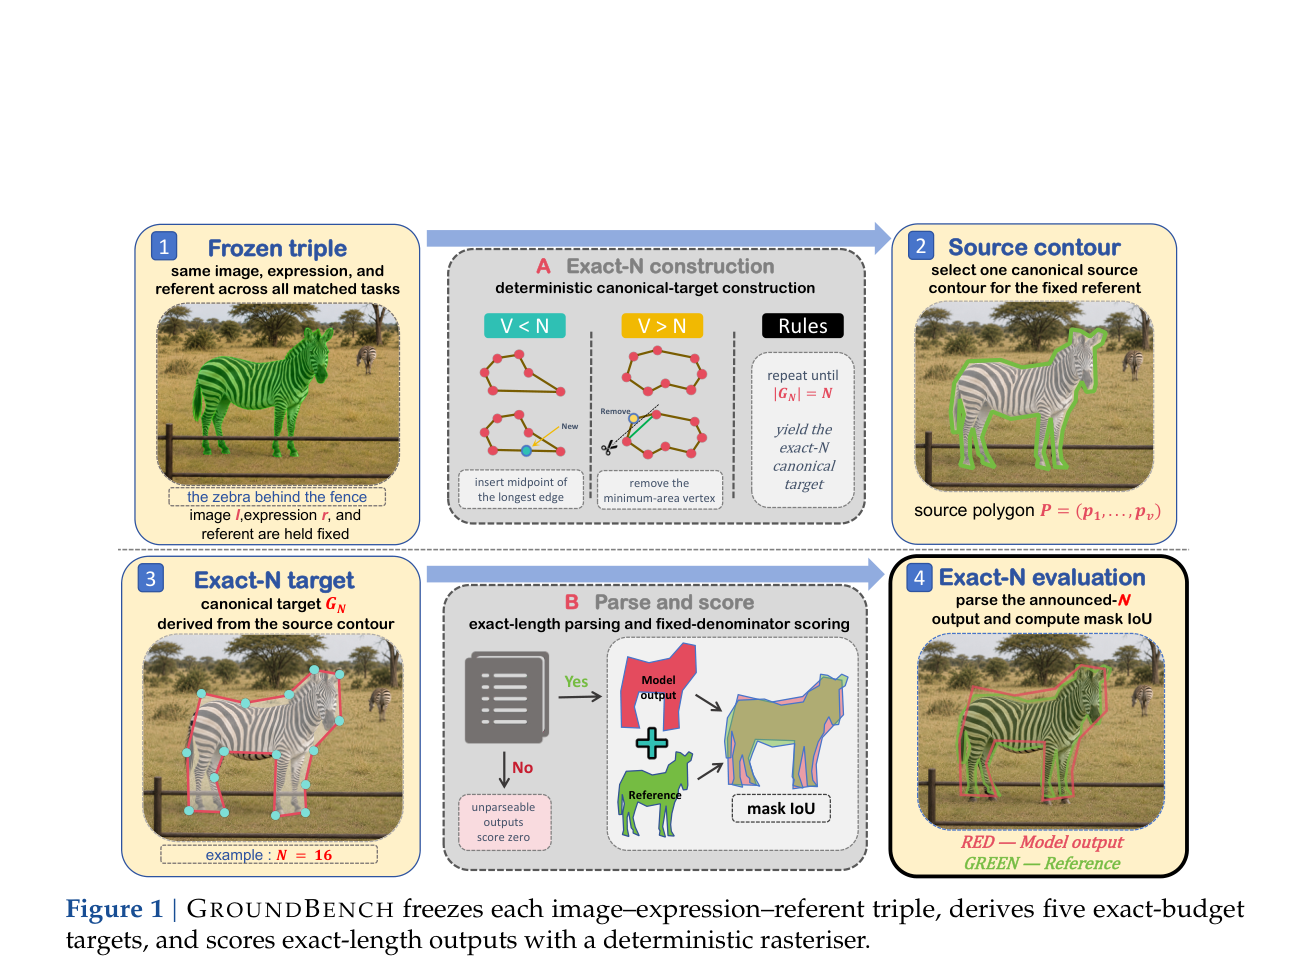
GROUNDBENCH 把同一批指称题改写成五个固定顶点数多边形目标,用固定分母交并比与合法多边形完成率审计托管视觉语言模型的输出几何缺口。
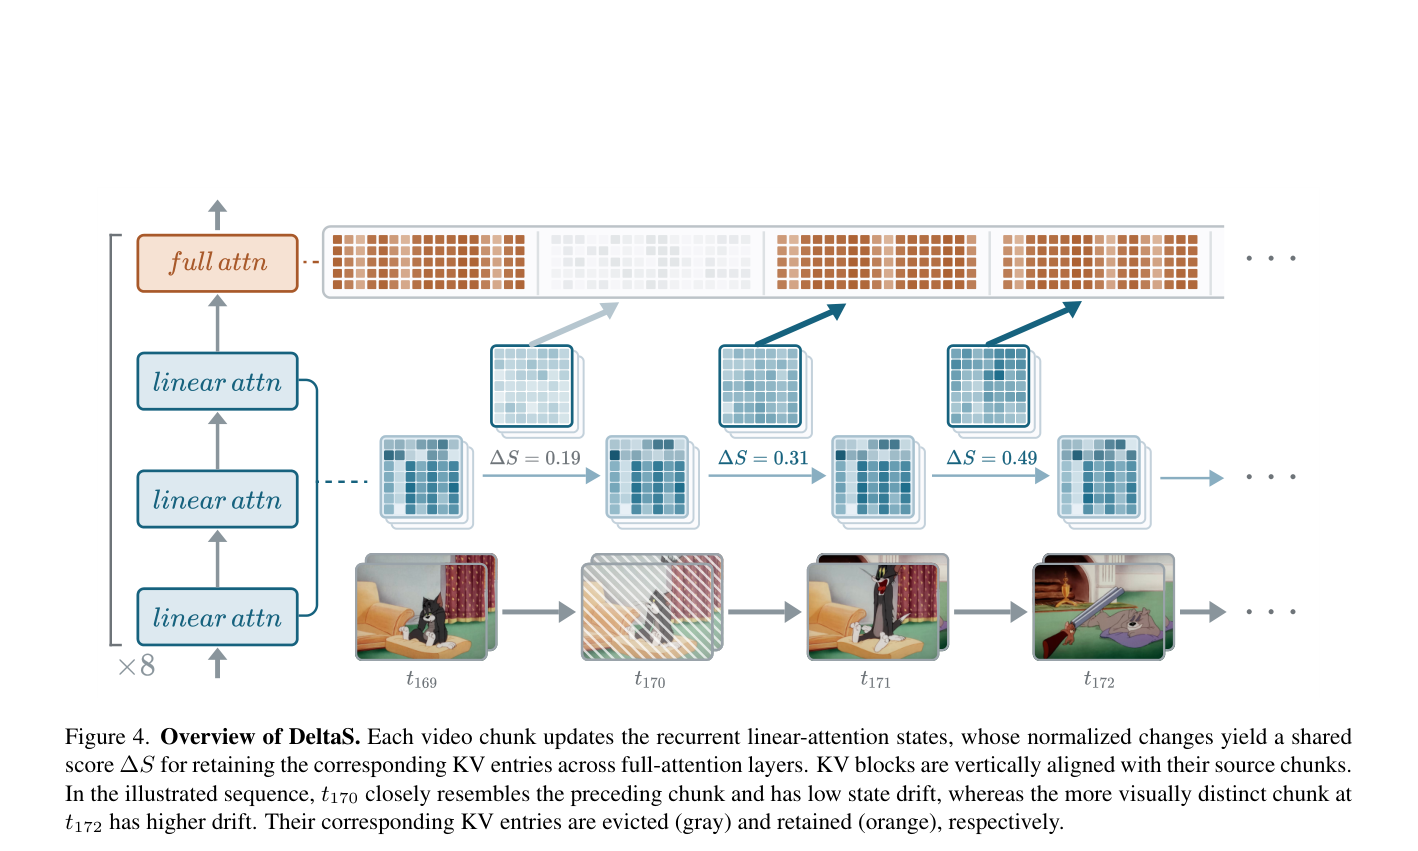
Maum AI、SNU 与 Yonsei 提出无训练的 DeltaS,用门控 delta 循环状态的归一化漂移指导混合骨干全注意力 KV 淘汰,在六套长视频基准的有界设定上高于所列对照。
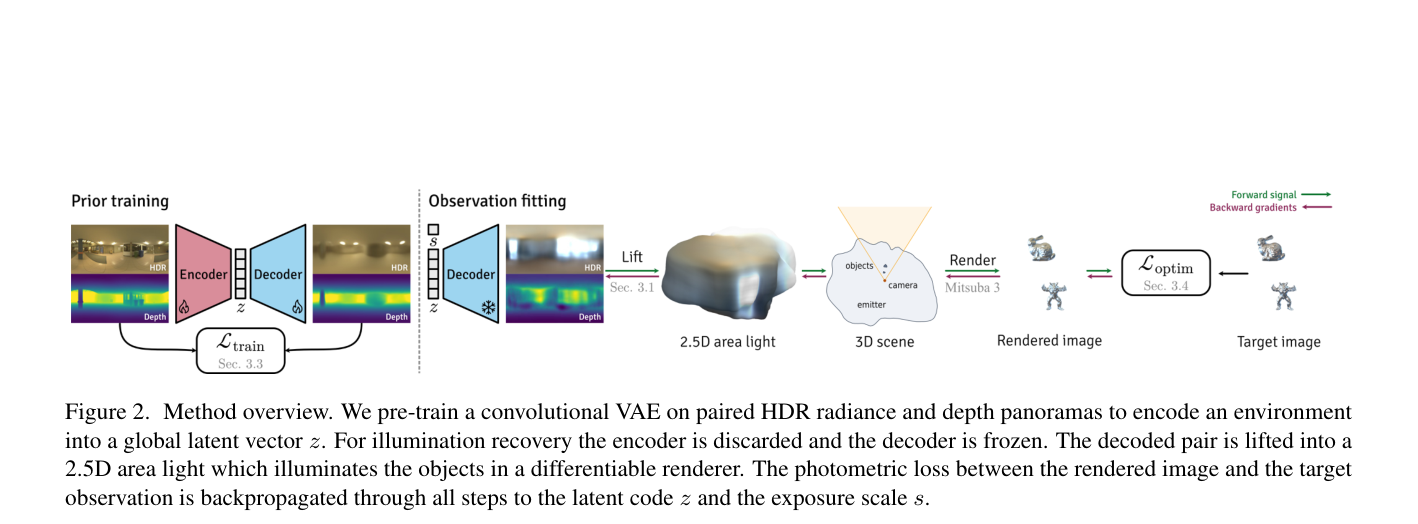
FAU Erlangen-Nürnberg 用辐射加深度的 VAE 先验,把室内光照解码成可微渲染可用的 2.5D 面光源,在合成探针与潜码拟合上高于远处环境图先验;预印本,代码待核验。
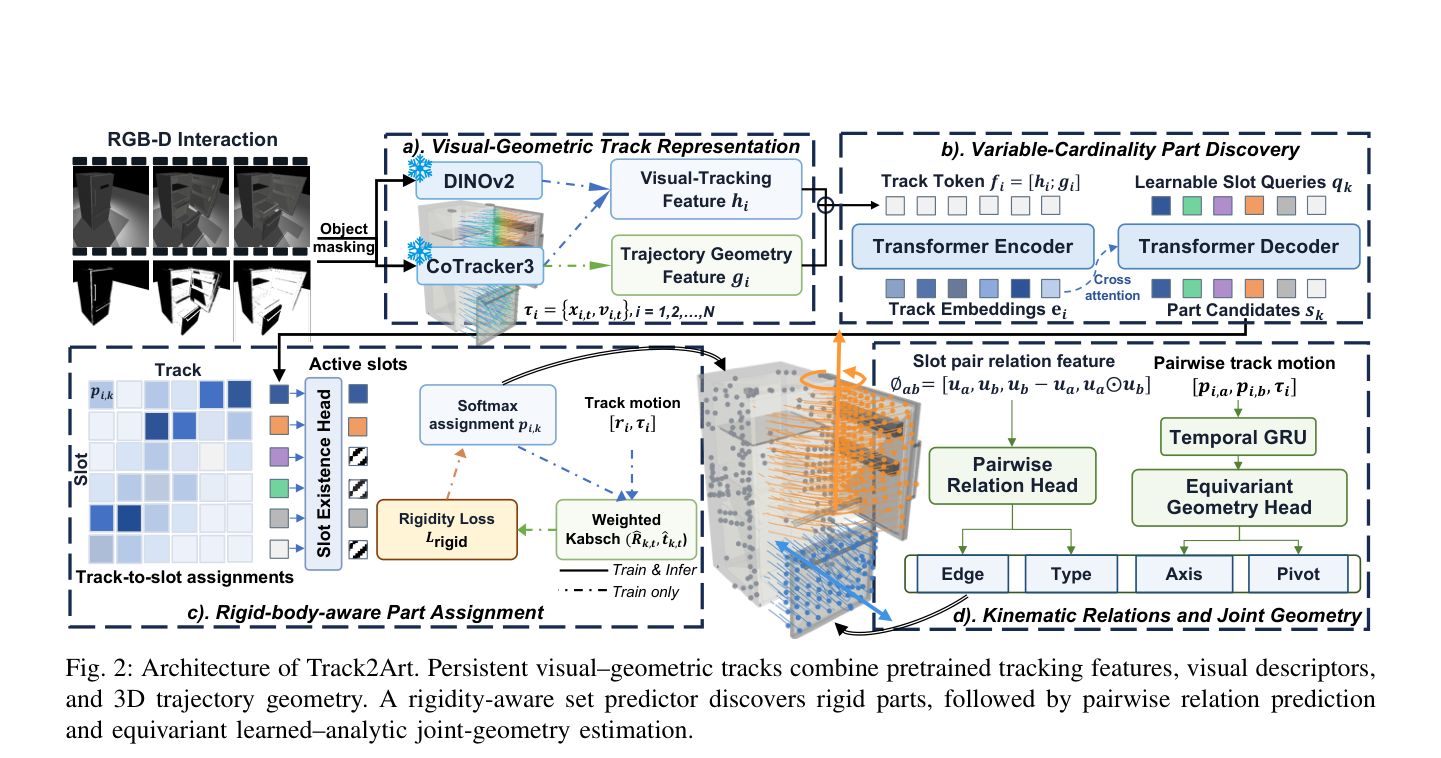
Track2Art 从带物体掩码的 RGB-D 交互视频构建持久视觉-几何轨迹 token,经可变基数刚体部件发现与旋转等变的学习-解析关节几何头,前馈恢复部件、有向运动学图、关节类型与轴枢,无需真值部件数或测试时优化。
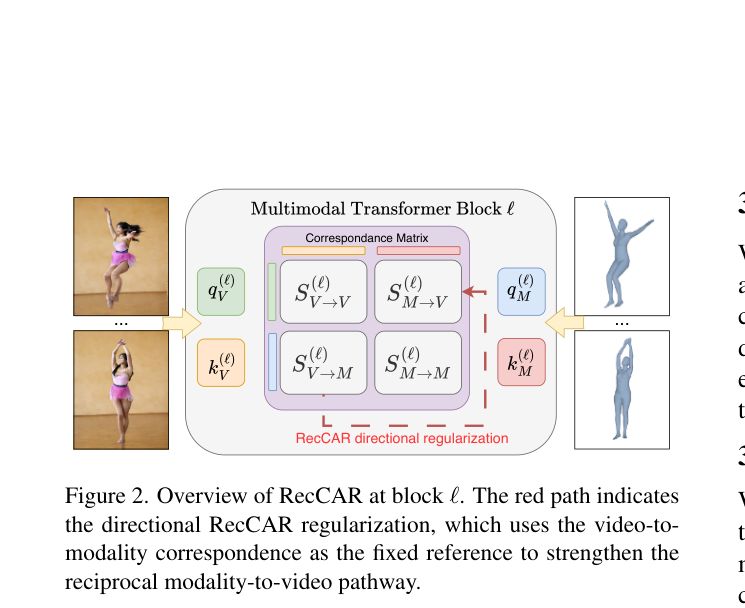
本文发现联合多模态扩散里视频到伴生模态的对应远强于反向路径,并提出 RecCAR,用停梯度 KL 把较弱的模态到视频对应拉向已建立的视频到模态对应,从而提升视频-动作与视频-音频一致性。
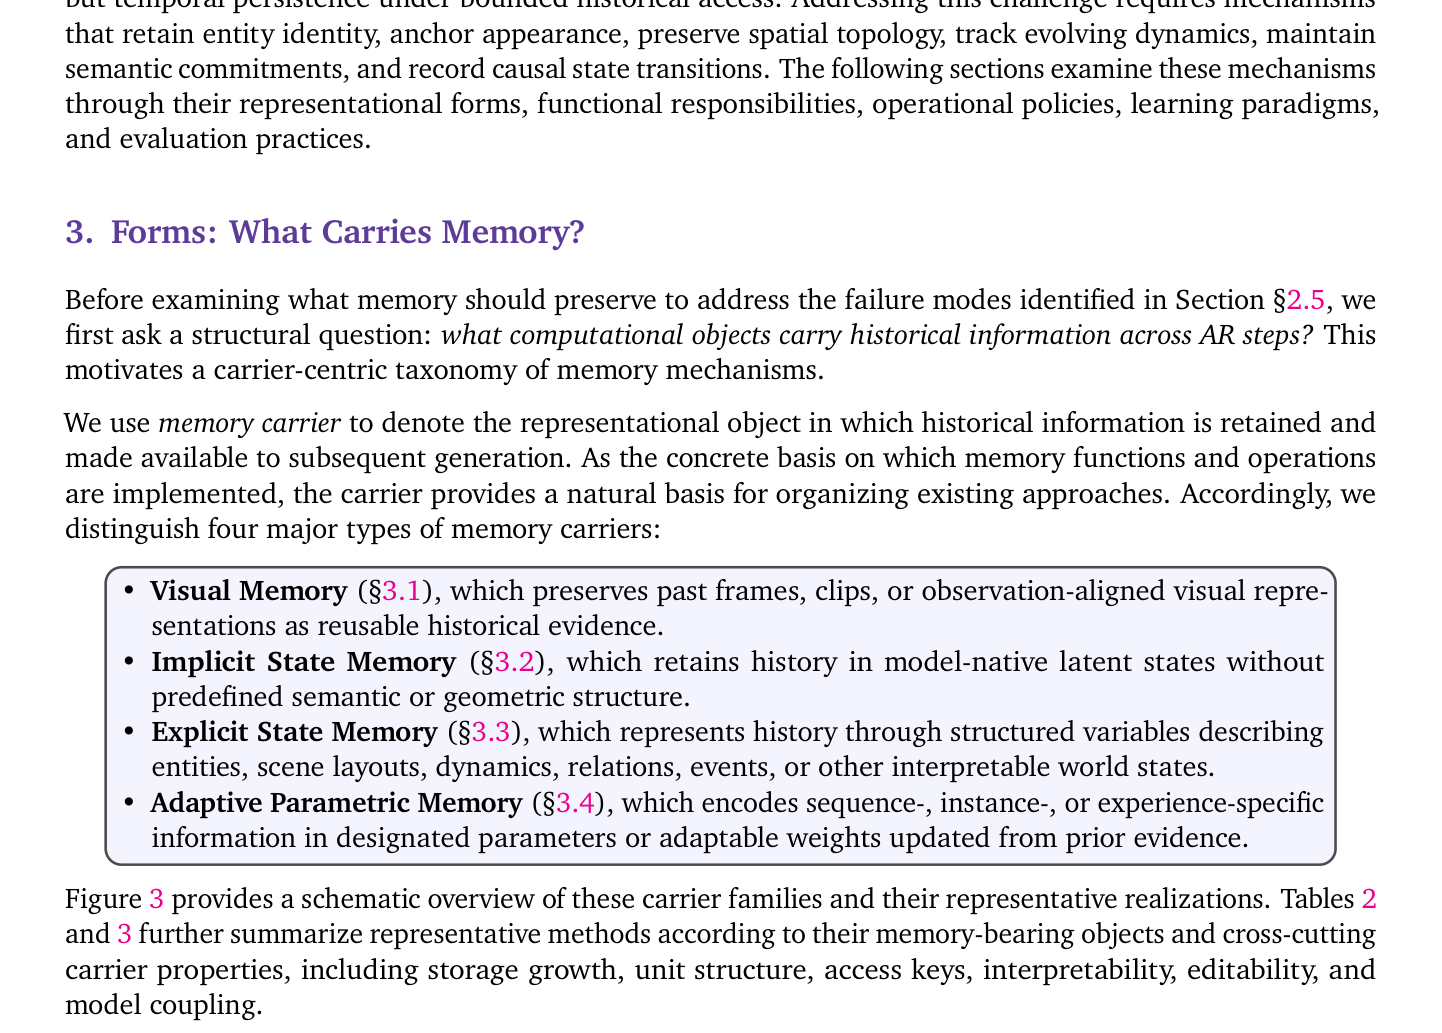
港科大等多机构 25 位作者的综述把 AR 视频生成中的记忆定义为跨外层 rollout 仍可影响未来的持久历史信息,并从 Forms、Functions、Operations、Learning、Evaluation 五条轴梳理文献。
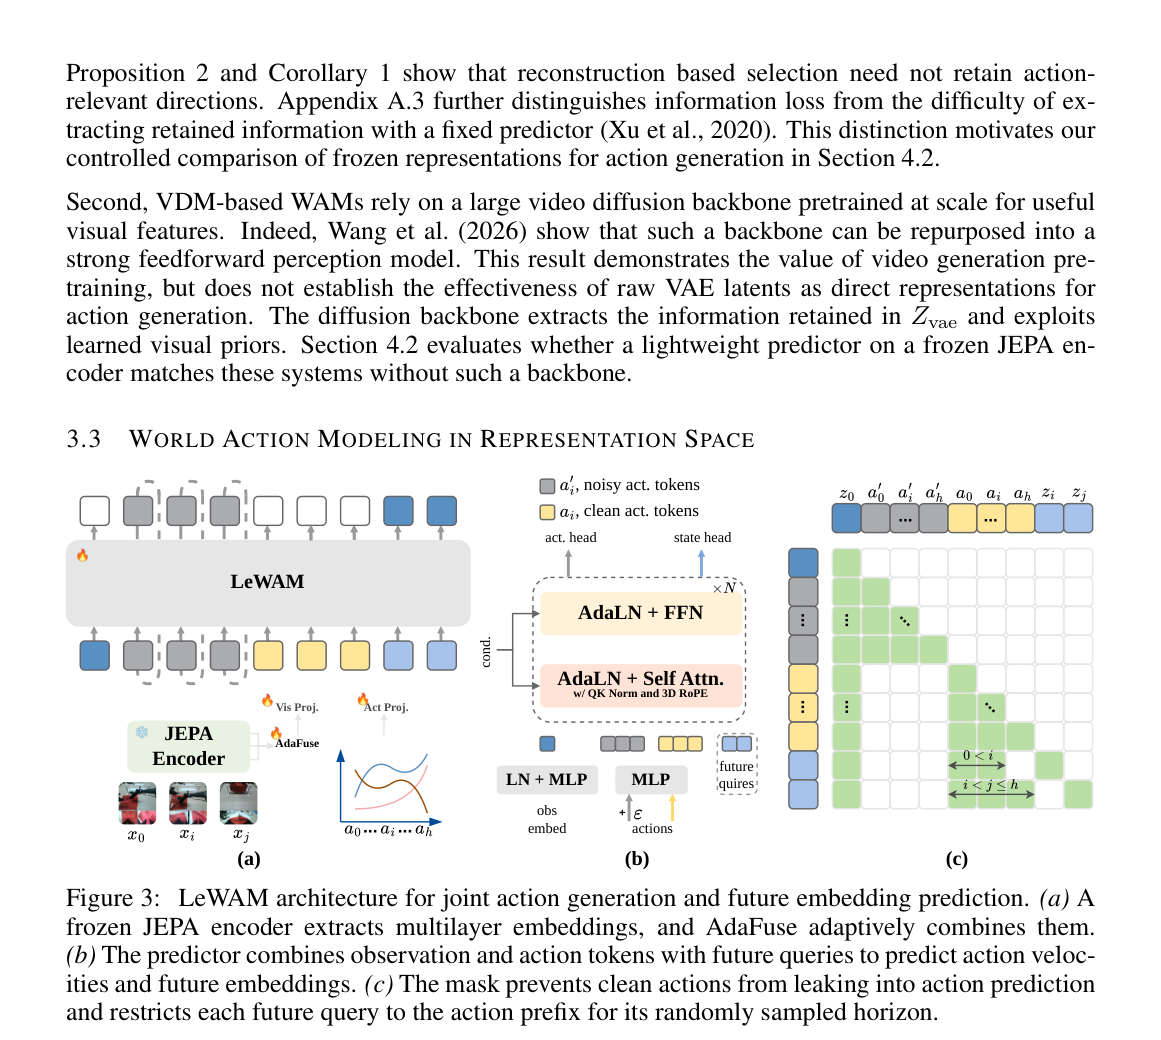
浙大、西湖与百度提出 LeWAM:用冻结 I-JEPA 嵌入同时支撑动作生成与未来嵌入预测,再以 DemoDPO 做离线偏好精炼,0.4B 可训练参数在 RoboTwin 2.0 上平均成功率 92.28%。