当深度有害时:用于无深度 RGB-D 显著性目标检测的可靠性感知几何蒸馏
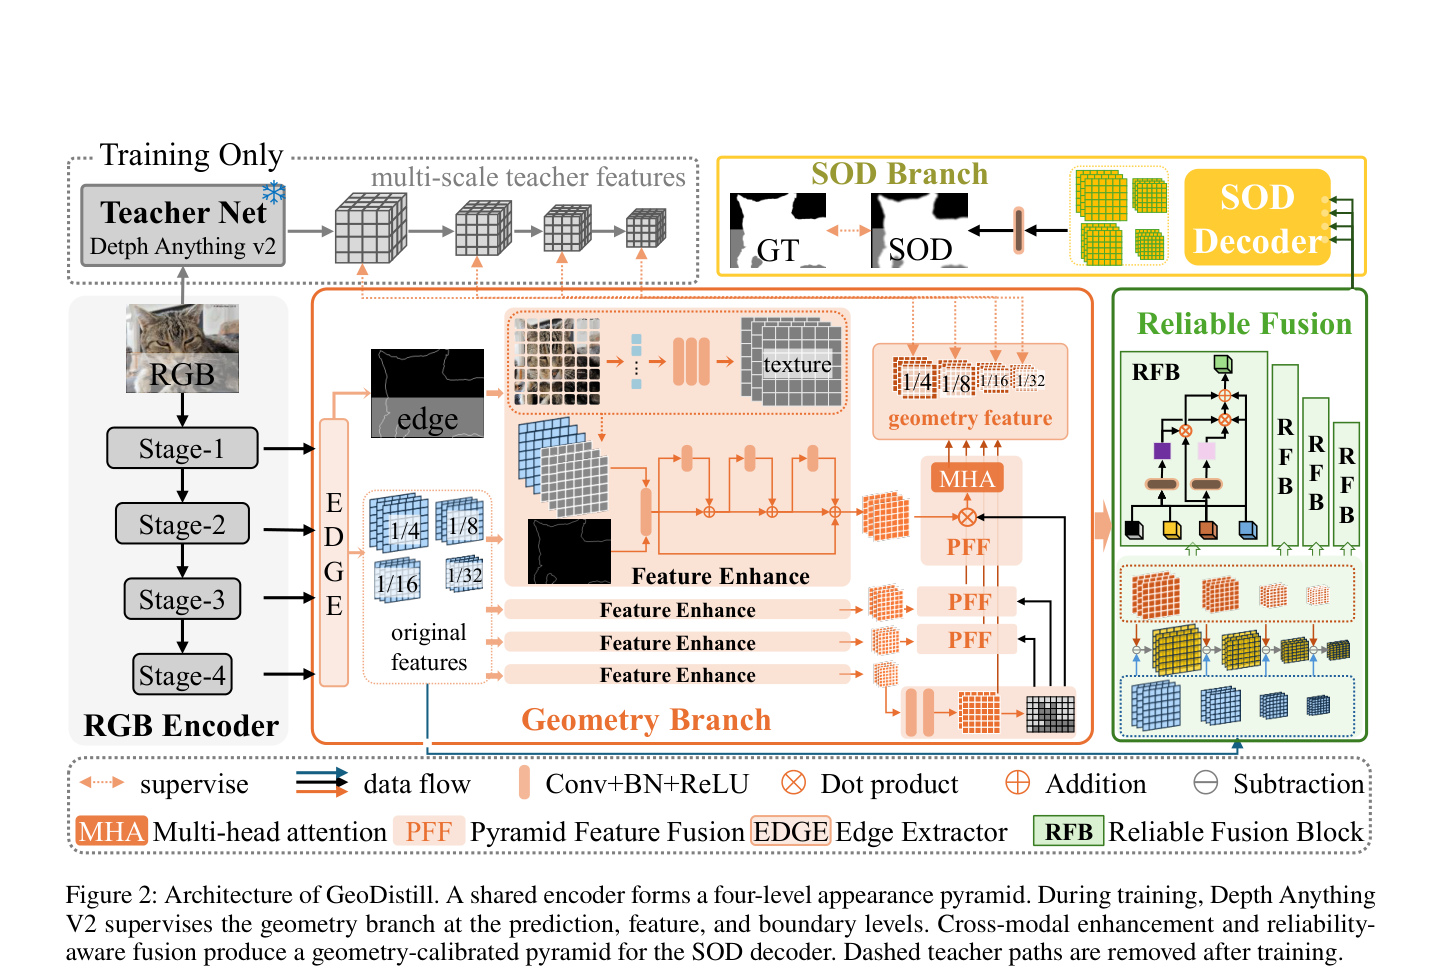
GeoDistill 提出一种深度无关的 RGB-D 显著性目标检测框架,通过从冻结的 Depth Anything V2 教师模型蒸馏几何信息,并在推理时移除教师,利用可靠性感知融合机制解决传感器深度噪声导致的性能下降问题。
GeoDistill 提出一种深度无关的 RGB-D 显著性目标检测框架,通过从冻结的 Depth Anything V2 教师模型蒸馏几何信息,并在推理时移除教师,利用可靠性感知融合机制解决传感器深度噪声导致的性能下降问题。
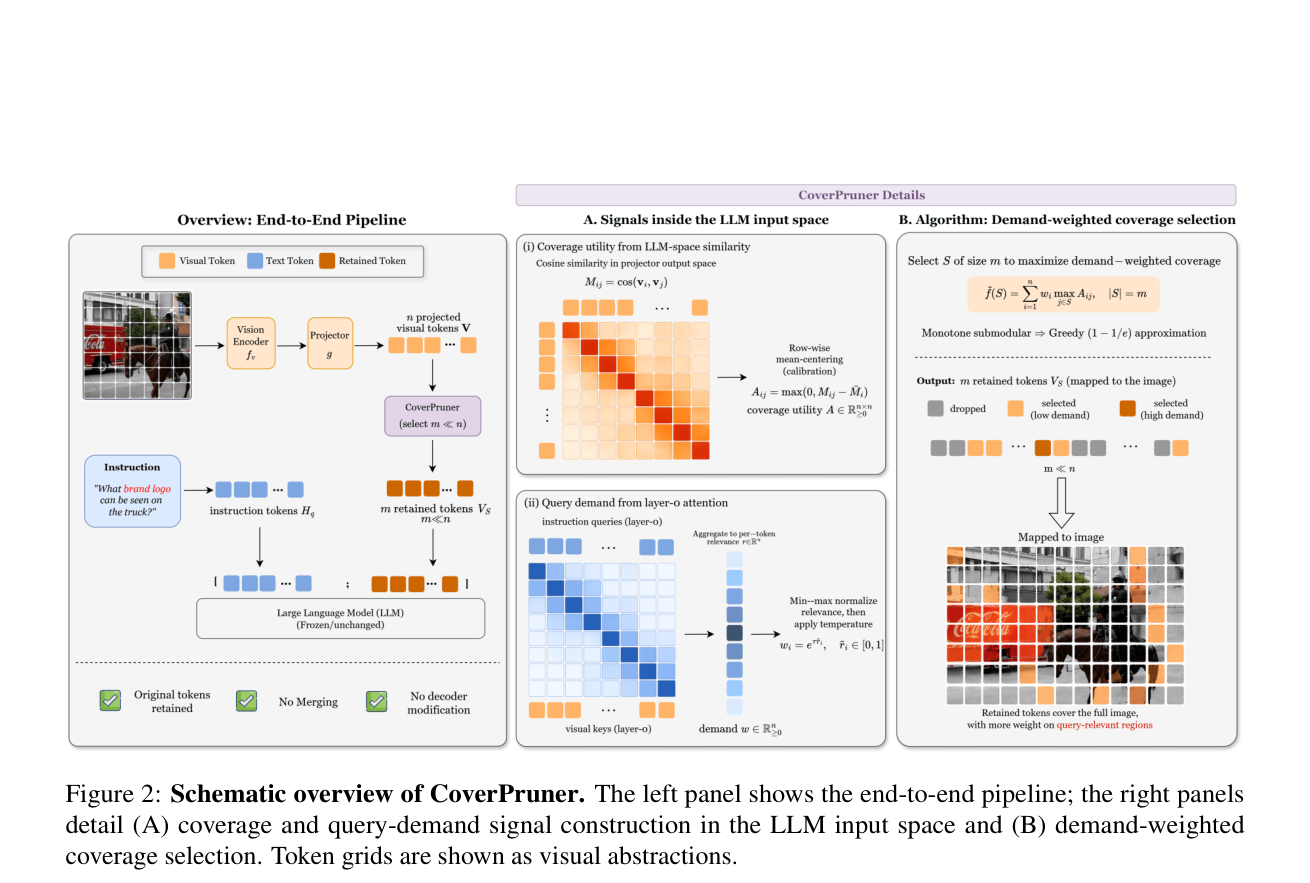
本文提出CoverPruner,一种无需训练的视觉Token剪枝方法,通过最大化目标VLM投影空间中的表示覆盖(Representational Coverage Maximization, RCM)并引入指令条件需求权重,在激进压缩率下显著优于现有剪枝基线。
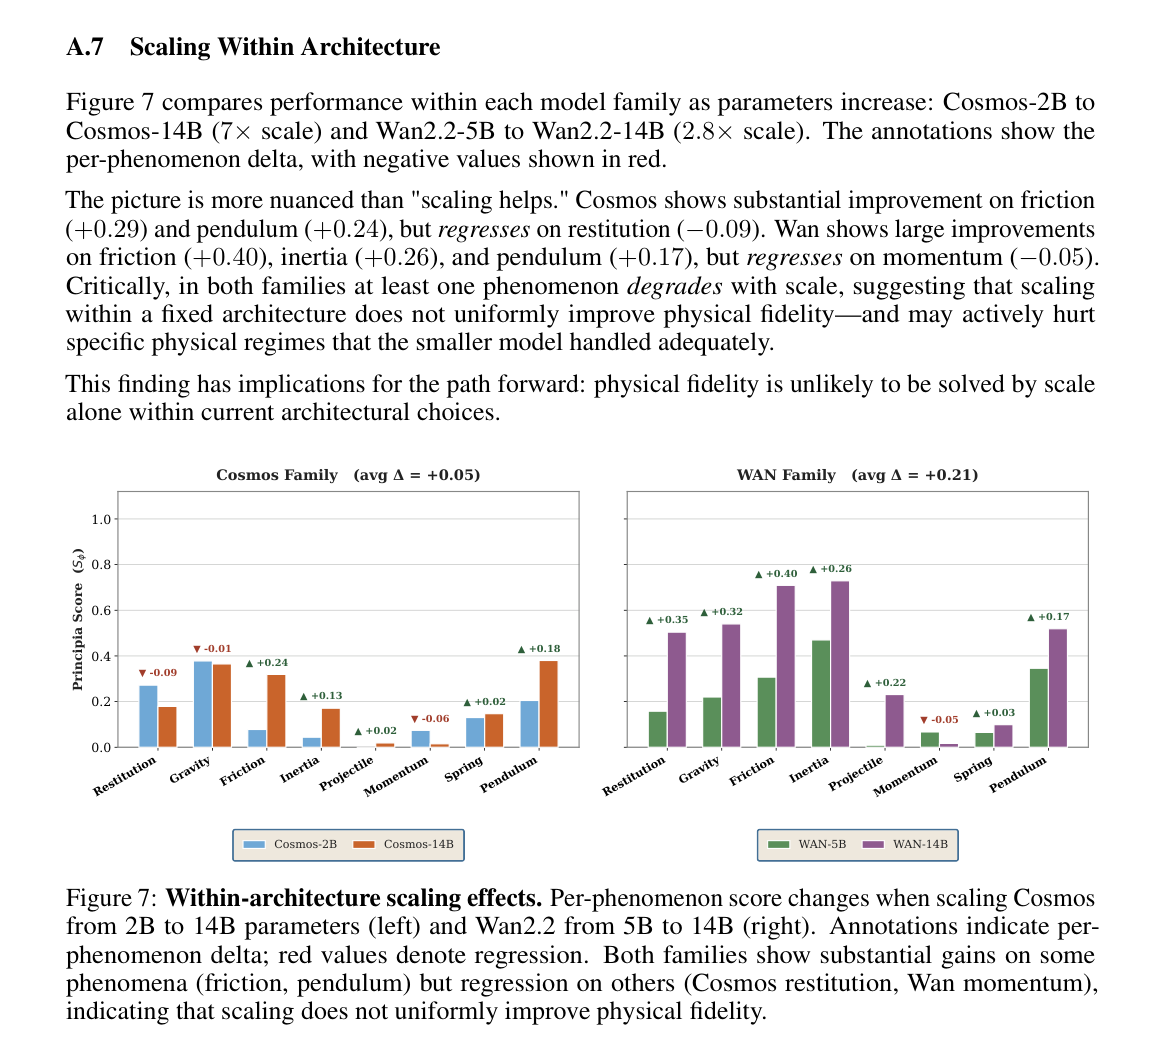
本文提出 Principia 基准,通过评估成对物体在图像空间中的关系不变量(无需相机标定),揭示当前视频生成模型和视觉语言模型在视觉质量高企的同时,物理一致性极低且随规模扩大并未显著改善。
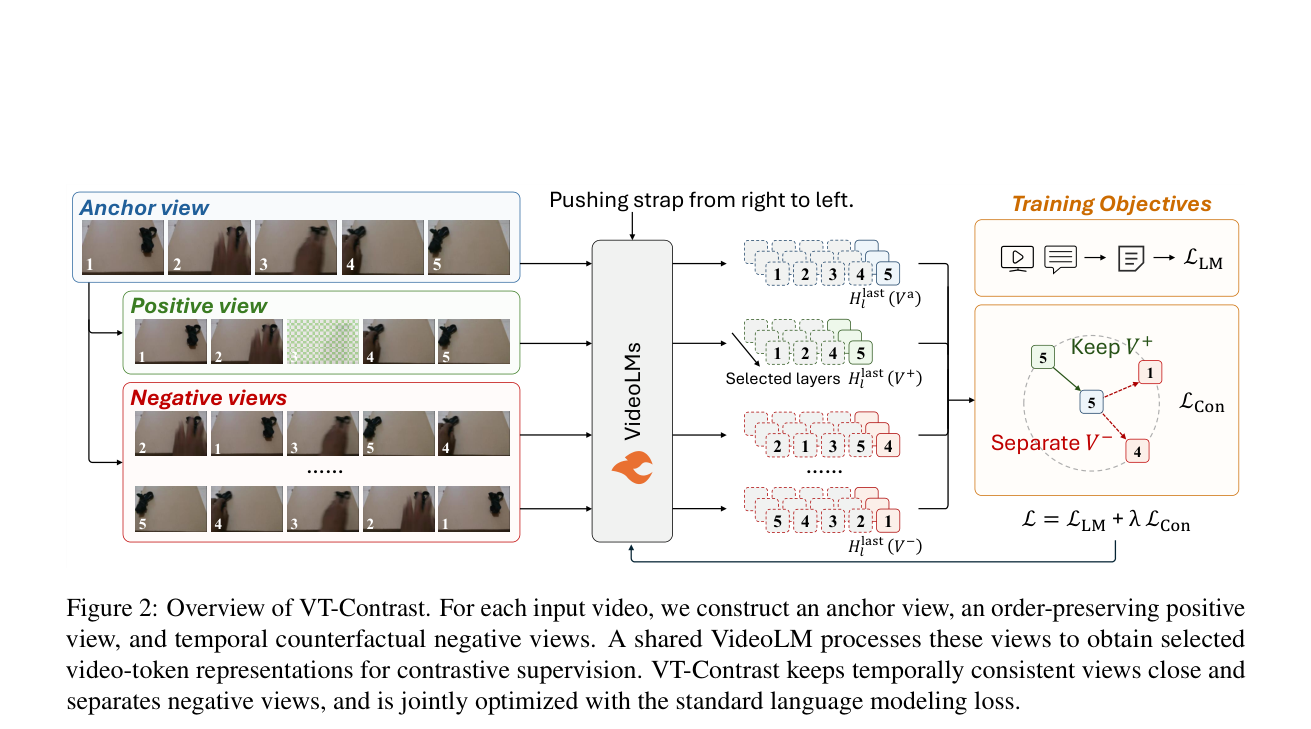
本文提出 VT-Contrast,一种在 VideoLM 训练中对视频 token 表示施加时间反事实对比监督的方法,通过区分保持时间顺序的正样本与打乱顺序的负样本,增强模型对事件动态和时间顺序的感知能力。
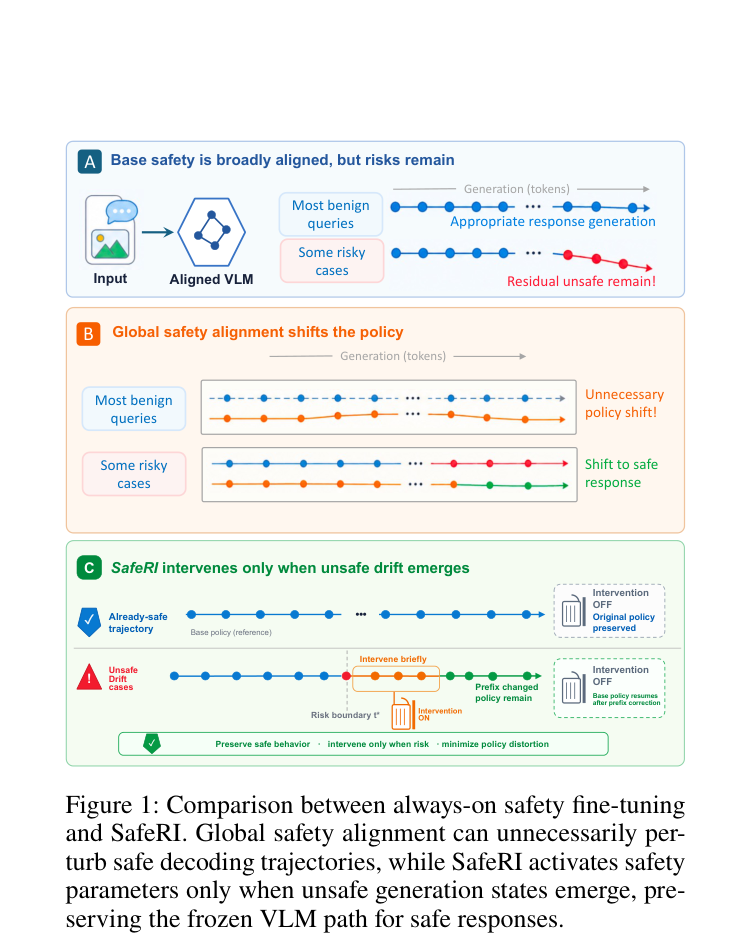
SafeRI 提出了一种流式风险识别与门控 LoRA 框架,仅在 VLM 生成轨迹出现不安全漂移时激活安全参数,从而在提升安全性的同时最小化对通用能力的干扰。
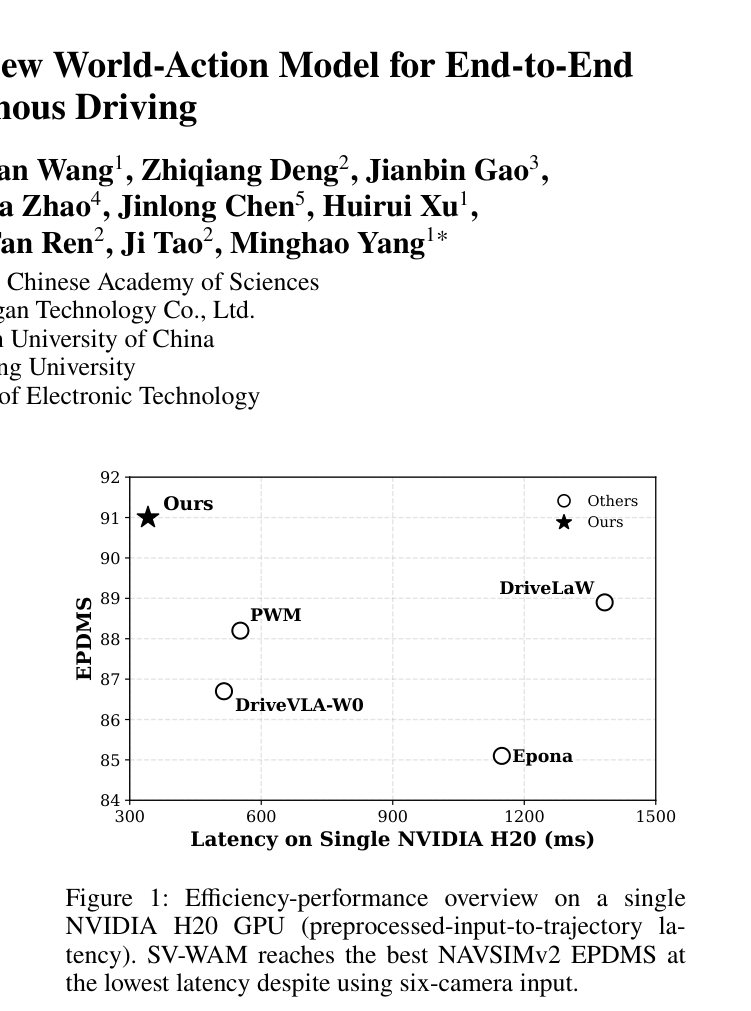
SV-WAM 提出了一种基于 action-centered causal mask 的环视世界-动作模型,通过训练时联合去噪未来视频与动作、推理时仅保留动作分支,实现了在保持六路相机全景感知优势的同时,显著降低推理延迟并提升 NAVSIMv2 规划性能。
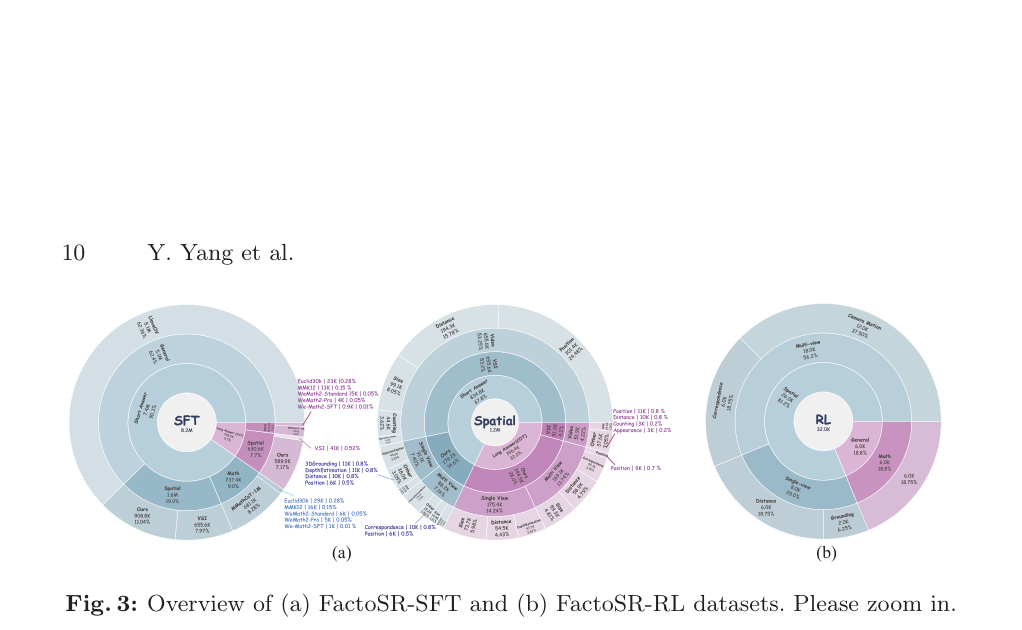
FactoSR提出了一种基于分解式强化学习(Factorized RL)的框架,通过解耦XY平面、Z深度和T时间维度的可验证奖励,显著提升了VLM在4D空间推理任务中的表现。
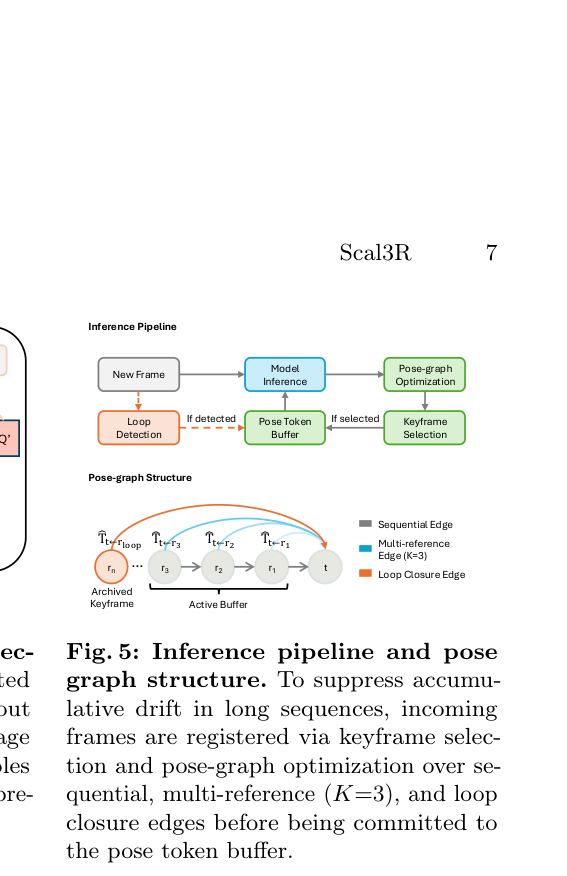
Scal3R通过冻结骨干网络并注入轻量级相对位姿查询token,结合在线位姿图优化,解决了长视频流中全局位姿回归导致的累积漂移问题,实现了公里级场景的稳定在线重建。
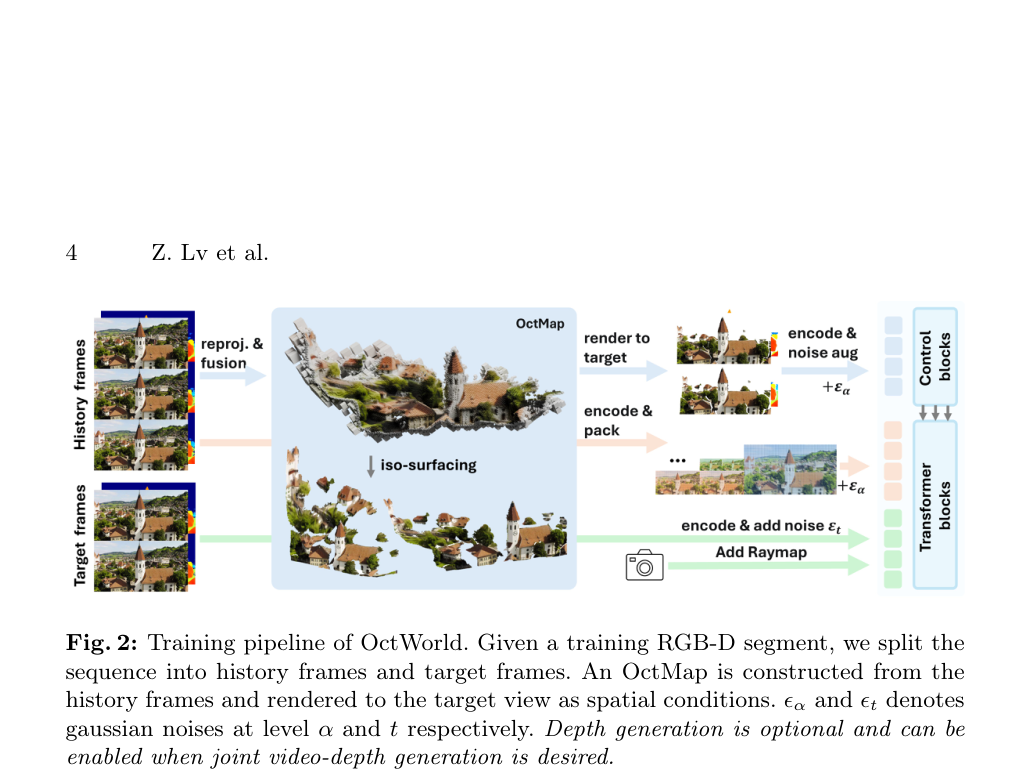
提出 OctWorld 框架,利用自适应八叉树 TSDF 记忆模块 OctMap 融合生成帧的深度信息,实现长程、空间一致且可探索的视频生成。
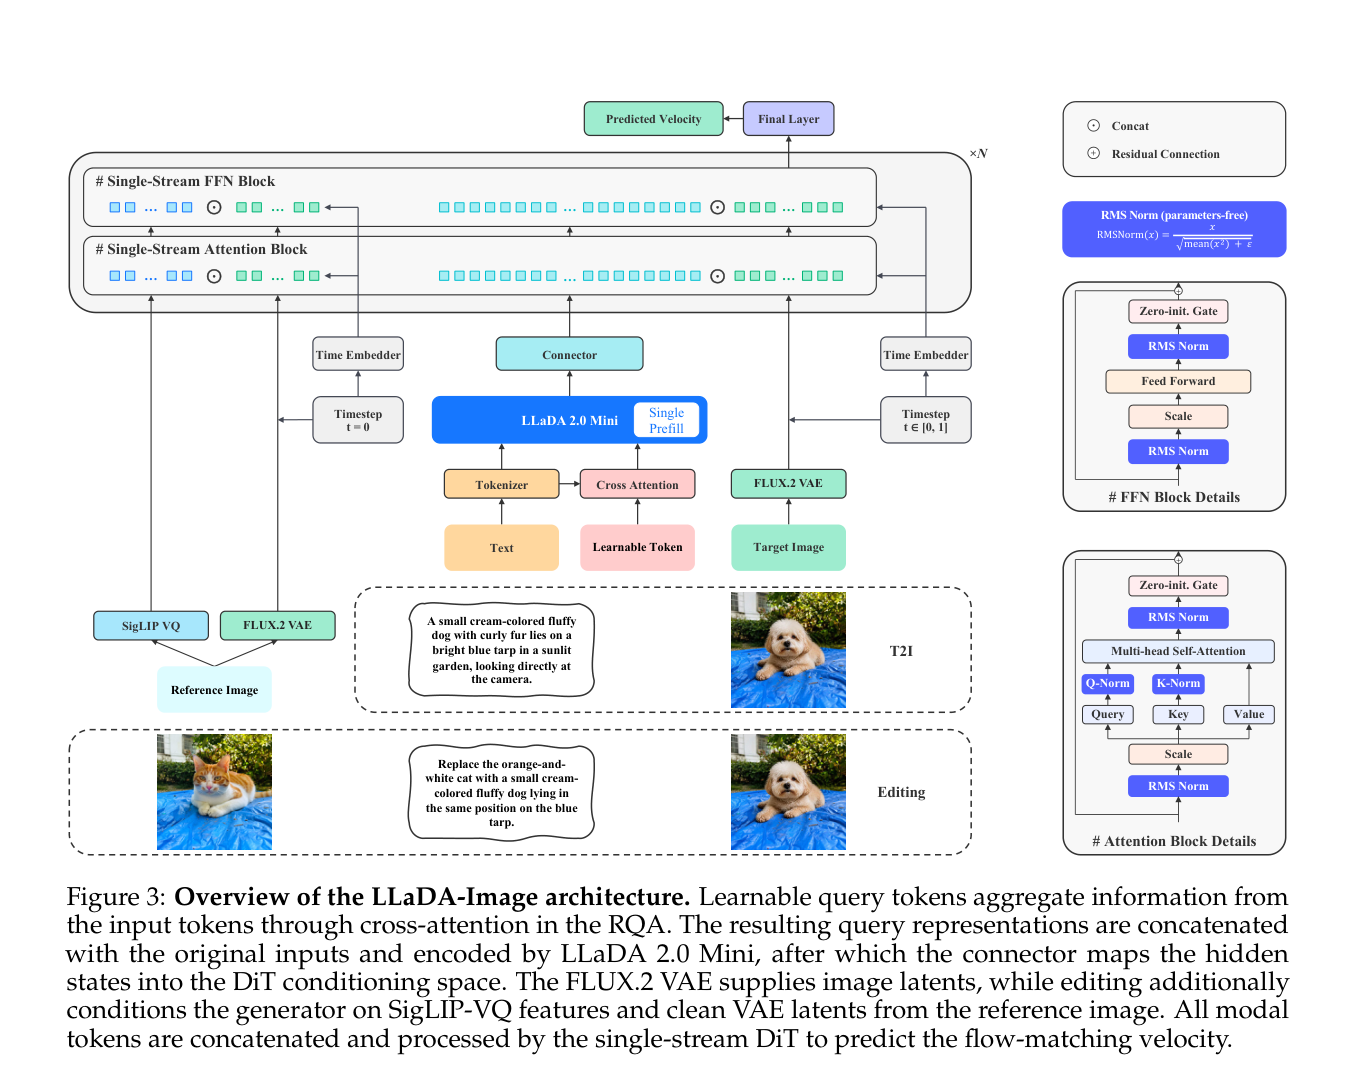
LLaDA-Image 提出了一种统一框架,通过解耦视觉先验学习与语言对齐,结合 dLLM 理解模块、单流 DiT 生成器及 TwinFlow 蒸馏技术,在保持高真实感的同时实现了高效的文生图与图像编辑能力。