FAVE:用局部高分辨率解决细粒度视觉理解难题
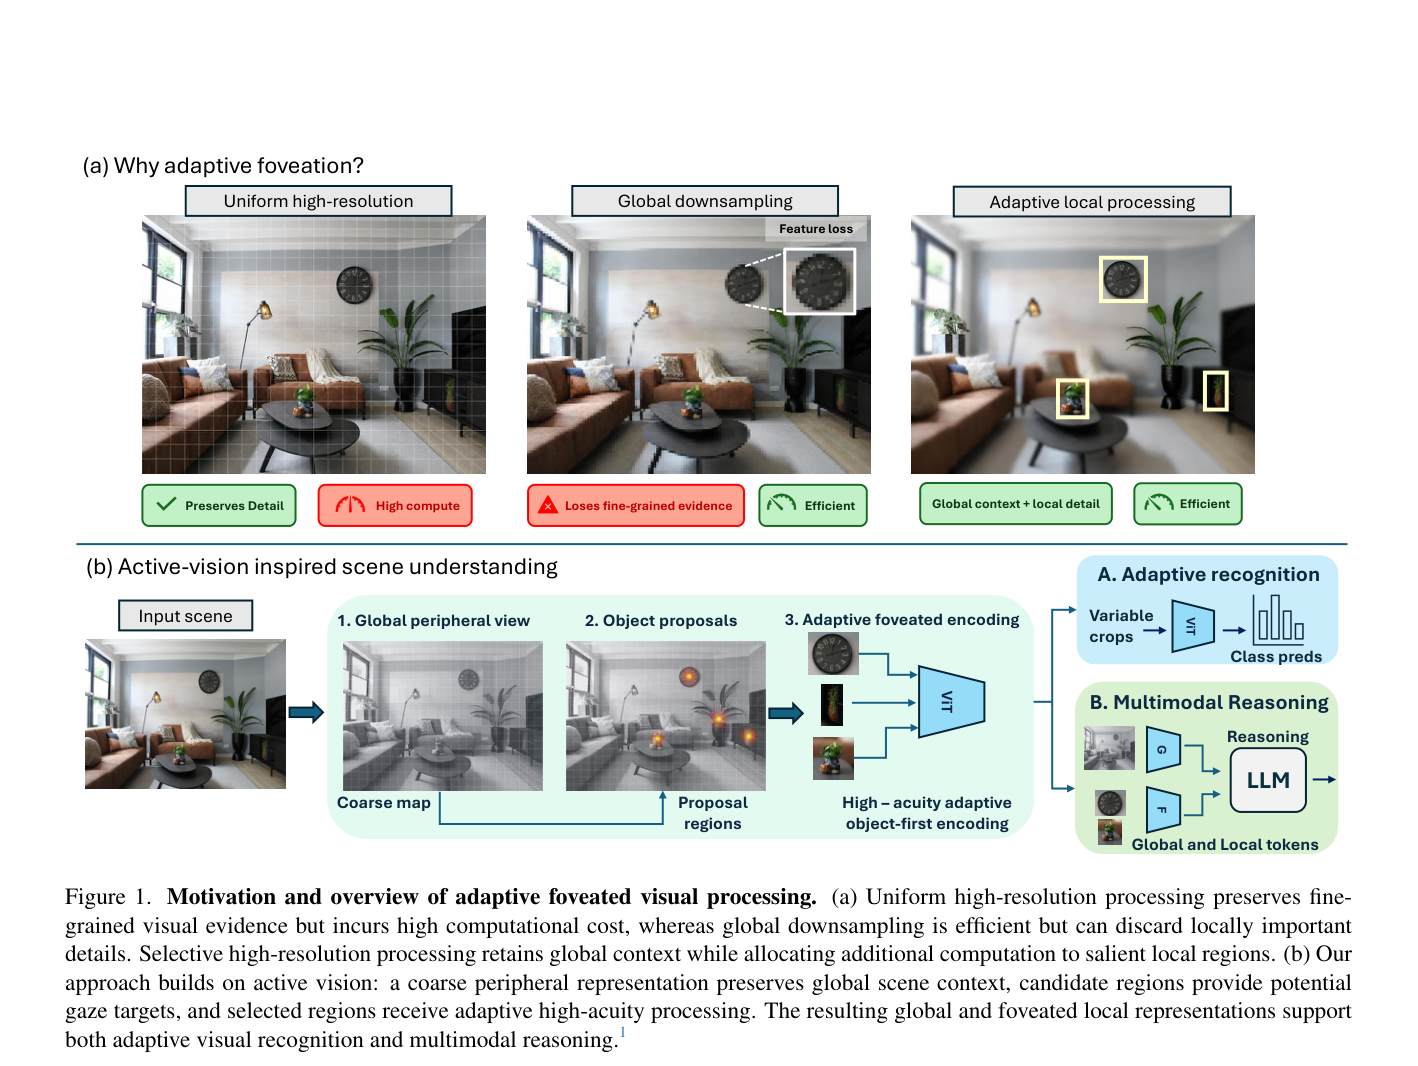
FAVE 提出了一种保留原始几何结构的变分辨率 ViT 编码器,通过对外部选定的局部区域进行高清晰度自适应编码,在保持全局上下文的同时显著提升了小物体、文本和属性识别的精度与效率。
FAVE 提出了一种保留原始几何结构的变分辨率 ViT 编码器,通过对外部选定的局部区域进行高清晰度自适应编码,在保持全局上下文的同时显著提升了小物体、文本和属性识别的精度与效率。
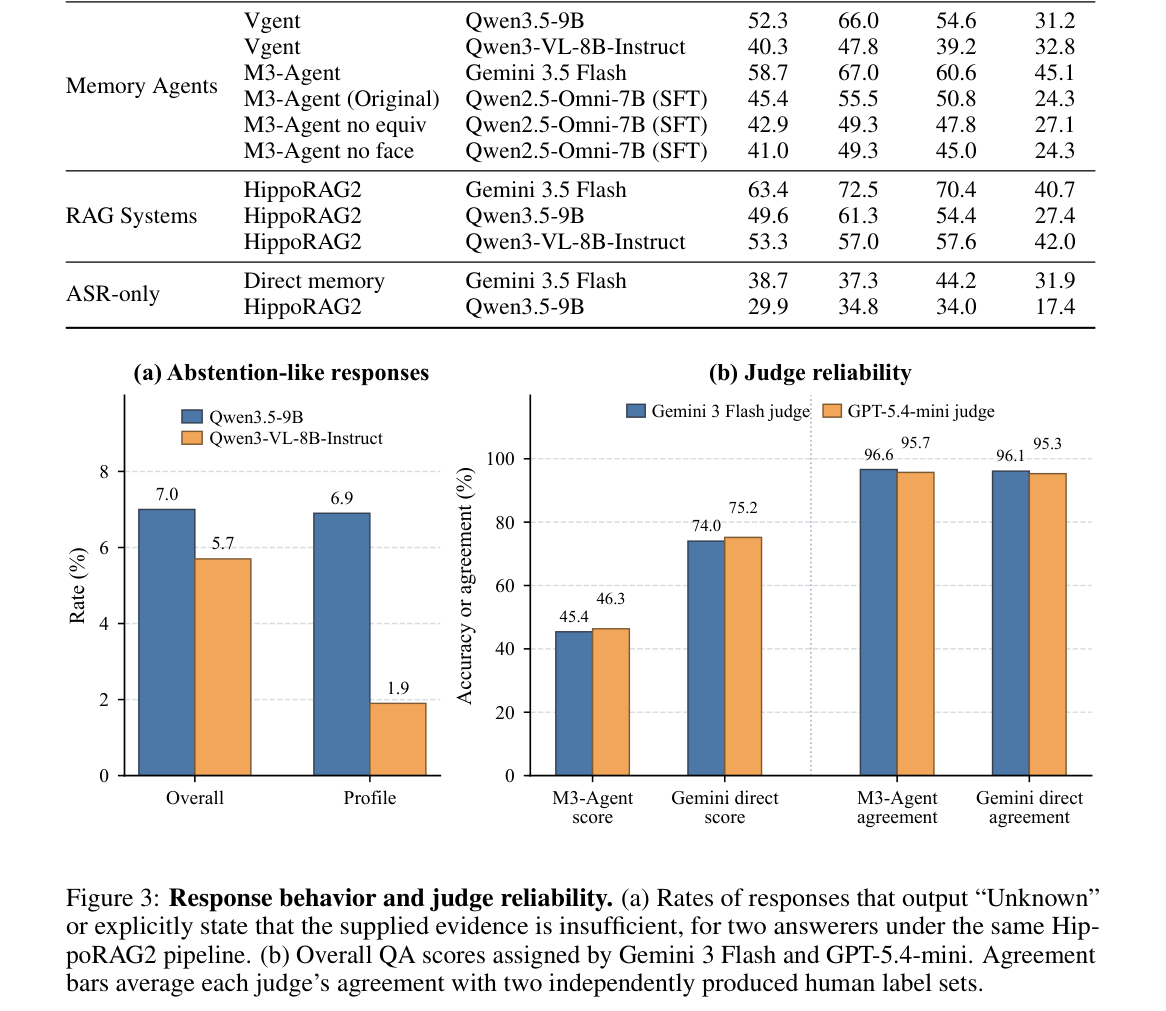
本文提出了ICM-Bench,一个专门评估多模态智能体在长视频记忆中维持重复人物身份并进行跨时间关系推理能力的基准,包含839个合成片段和1217个开放式问题。
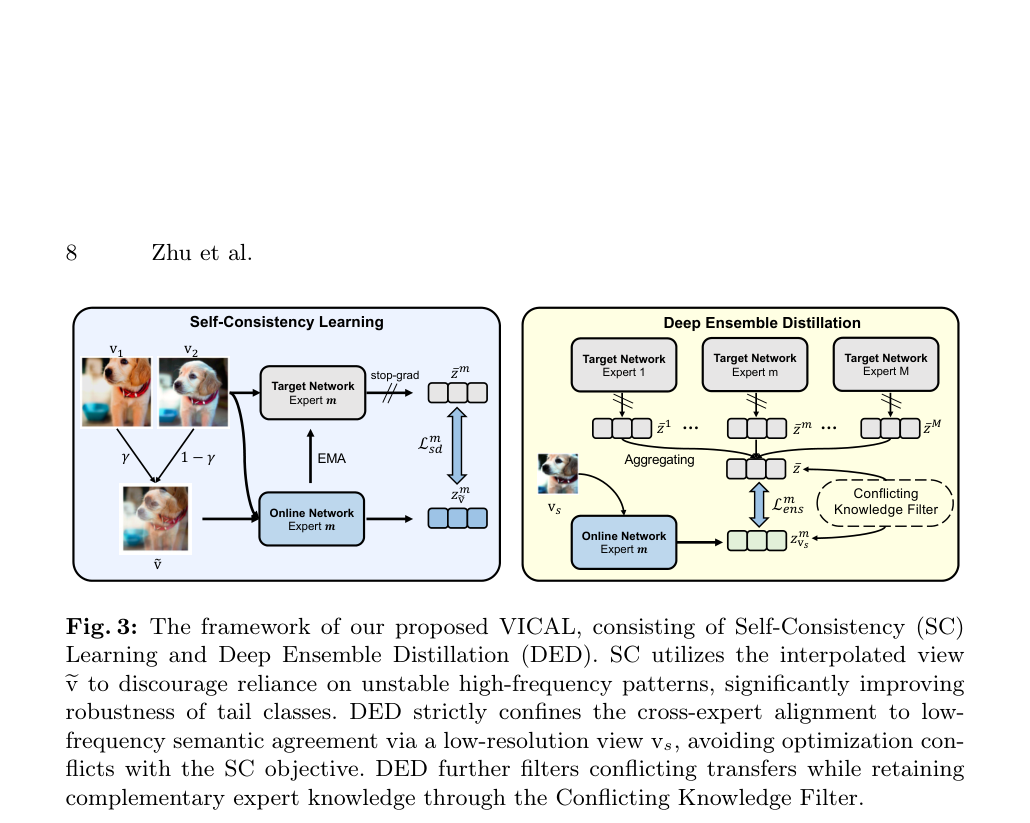
本文通过实证分析指出长尾学习中专家多样性与集成精度无正相关,提出VICAL框架,利用Self-Consistency Learning和Deep Ensemble Distillation在解耦的频率域中降低预测方差,从而提升长尾识别性能。
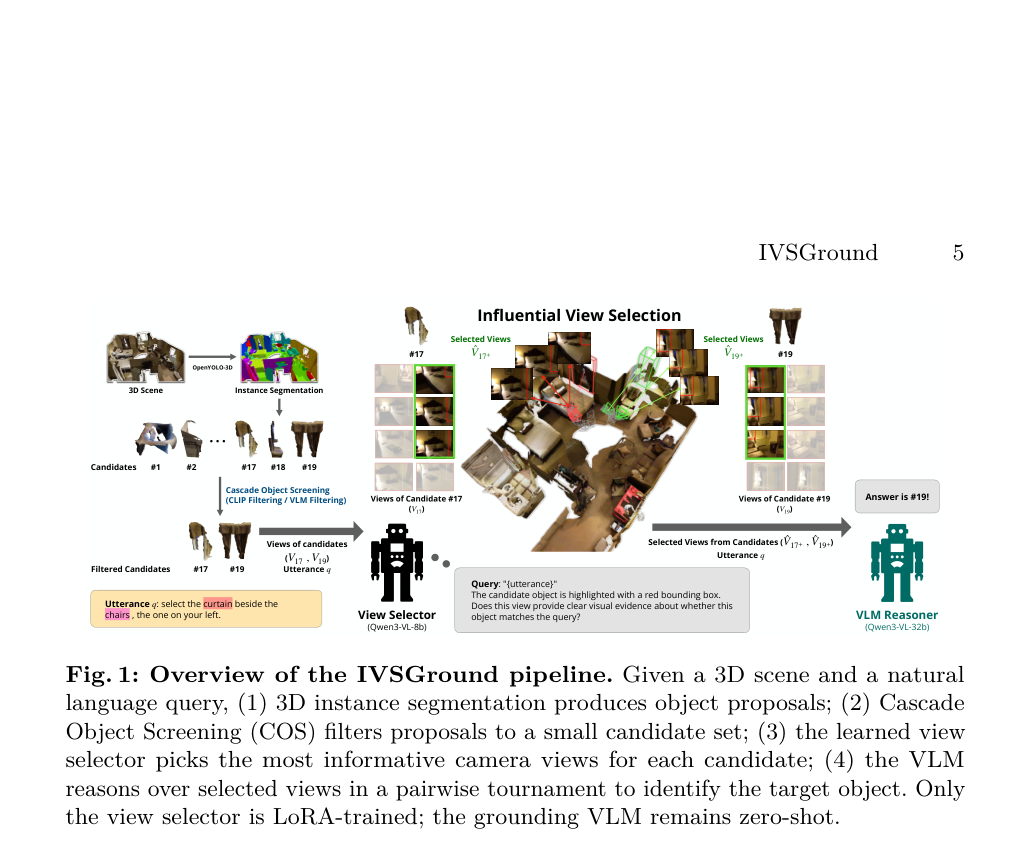
本文提出IVSGround框架,通过拒绝采样从VLM反馈中学习关键视角选择器,在保持推理VLM零样本冻结的前提下,显著提升了3D视觉定位的准确率。
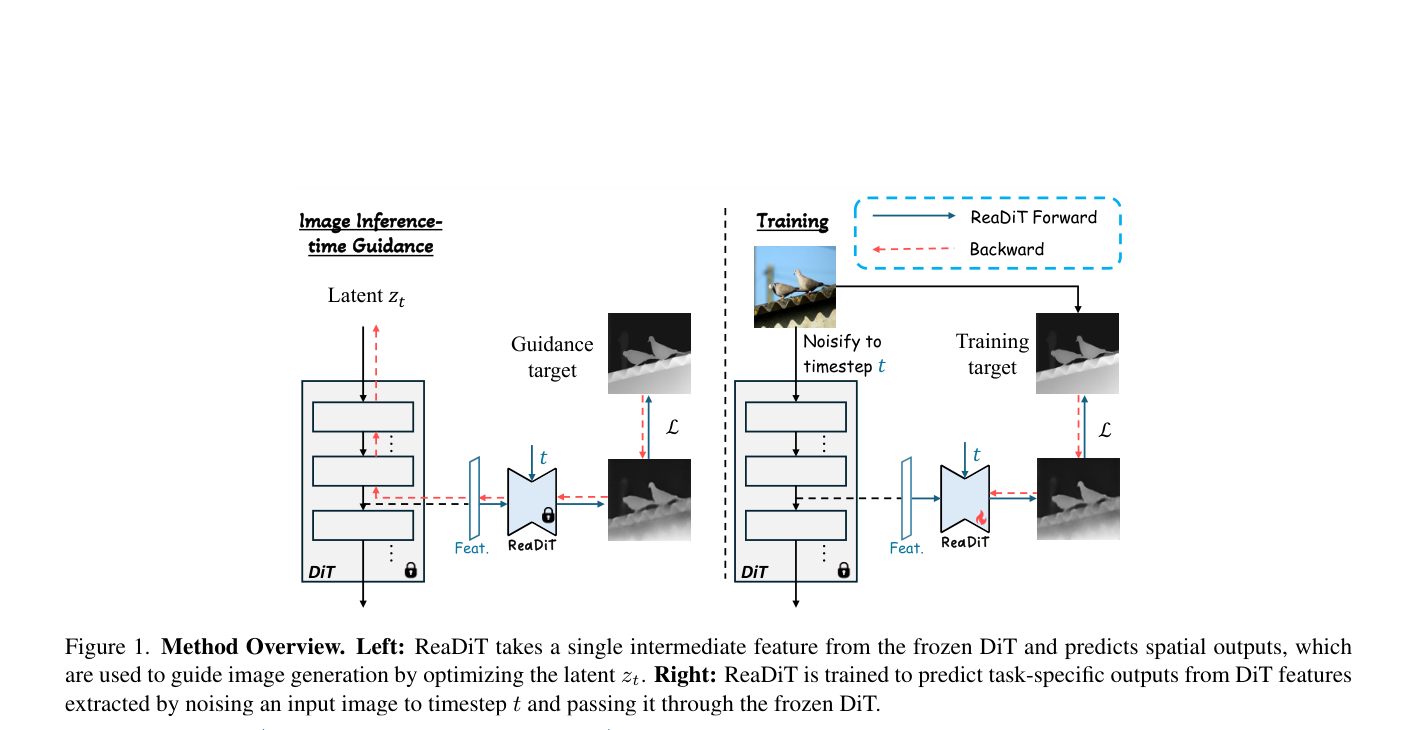
本文提出了 ReaDiT,一种轻量级框架,通过提取冻结 DiT 模型中单个 Transformer 块的特征来预测空间目标(如深度、姿态、边缘)或光流,并在推理时通过优化潜变量引导图像和视频生成,无需修改基础模型即可实现统一的空间与运动控制。
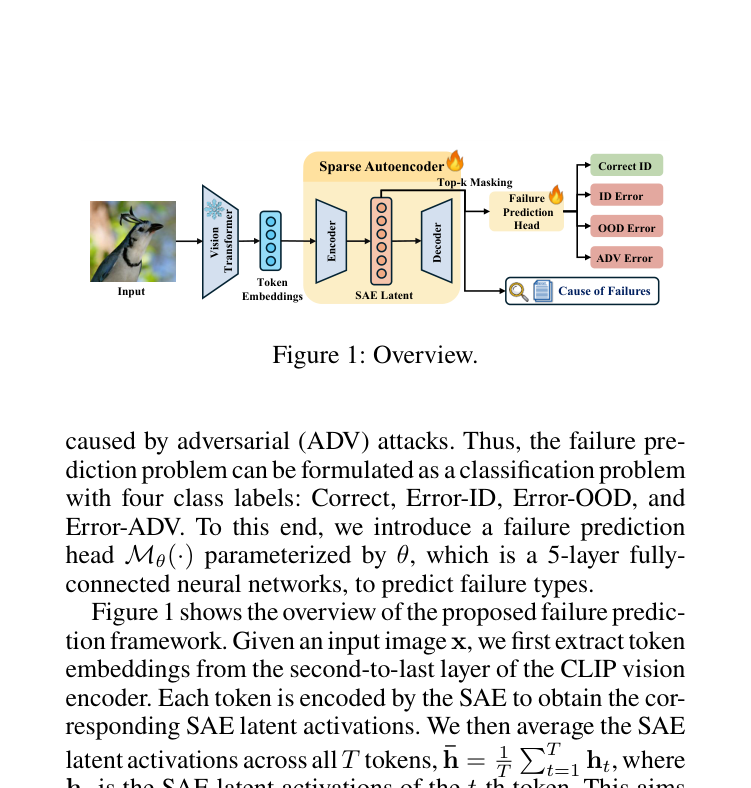
本文提出 FailSAE,一种基于稀疏自编码器(SAE)的三阶段故障感知训练框架,通过解耦 VLM 内部表示为稀疏概念方向,实现了比现有基线更准确且具备概念级可解释性的故障预测。
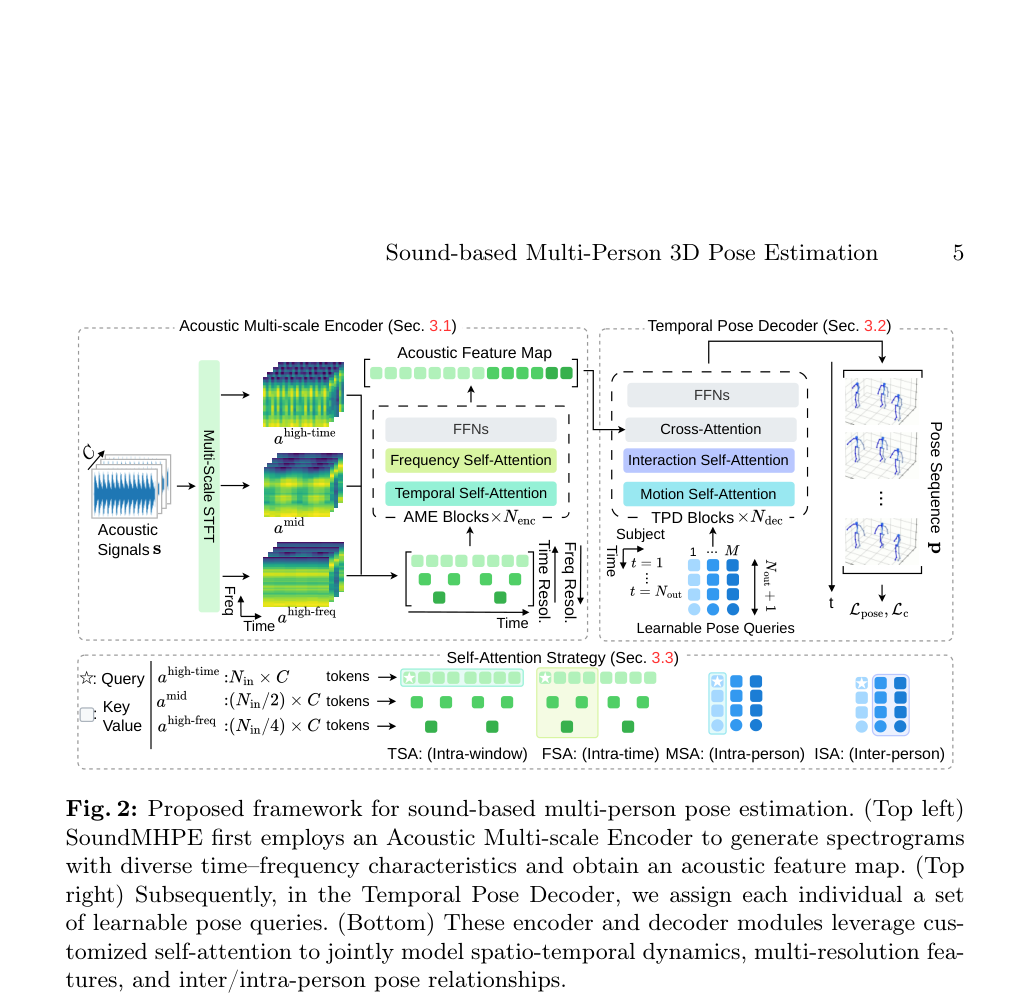
本文提出了SoundMHPE,首个仅利用主动声学信号进行多人3D姿态估计的框架,通过多尺度声学编码器和时序姿态解码器解决信号叠加与多体反射带来的歧义问题。
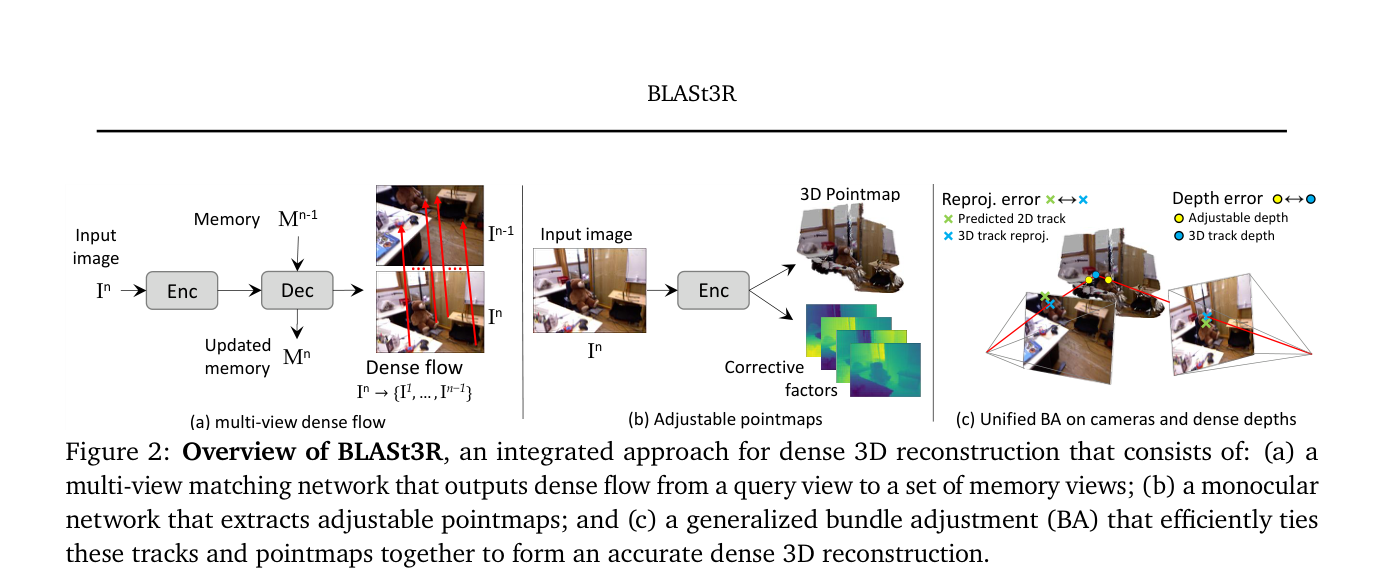
BLASt3R 提出了一种统一的混合 3D 重建框架,通过结合可扩展的多视图匹配网络、可调整的单目深度先验以及正则化束调整(BA),在离线 SfM 和在线 VSLAM 场景中均实现了优于现有方法的精度与速度权衡。
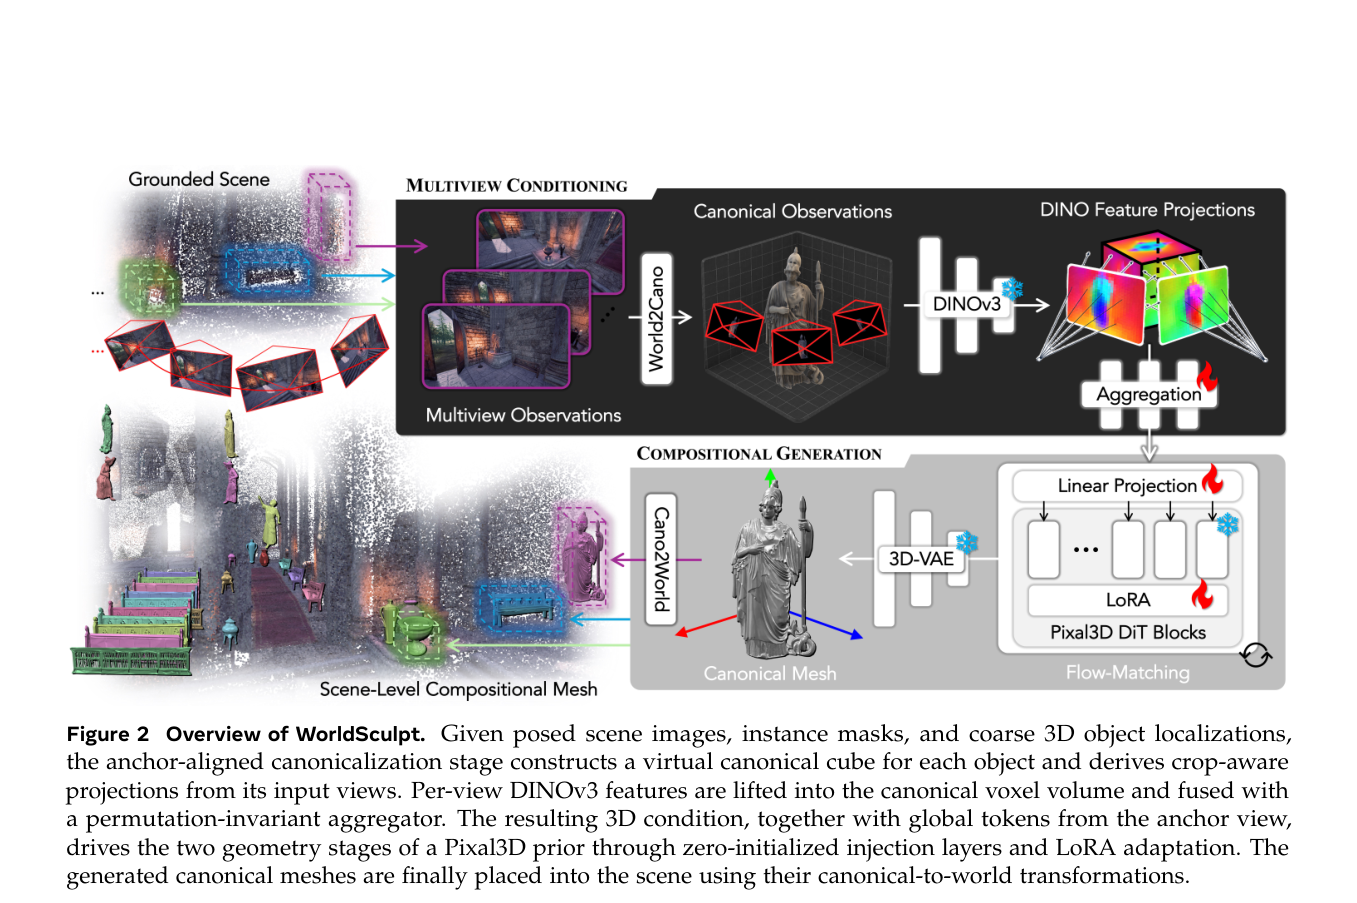
WorldSculpt 通过扩展 Pixal3D 生成先验以支持多视角条件输入,实现了从密集遮挡场景中生成数百个独立物体网格的组合式 3D 场景重建,并提出了包含精确逐物体真值的 UE-MeshyScene 基准数据集。