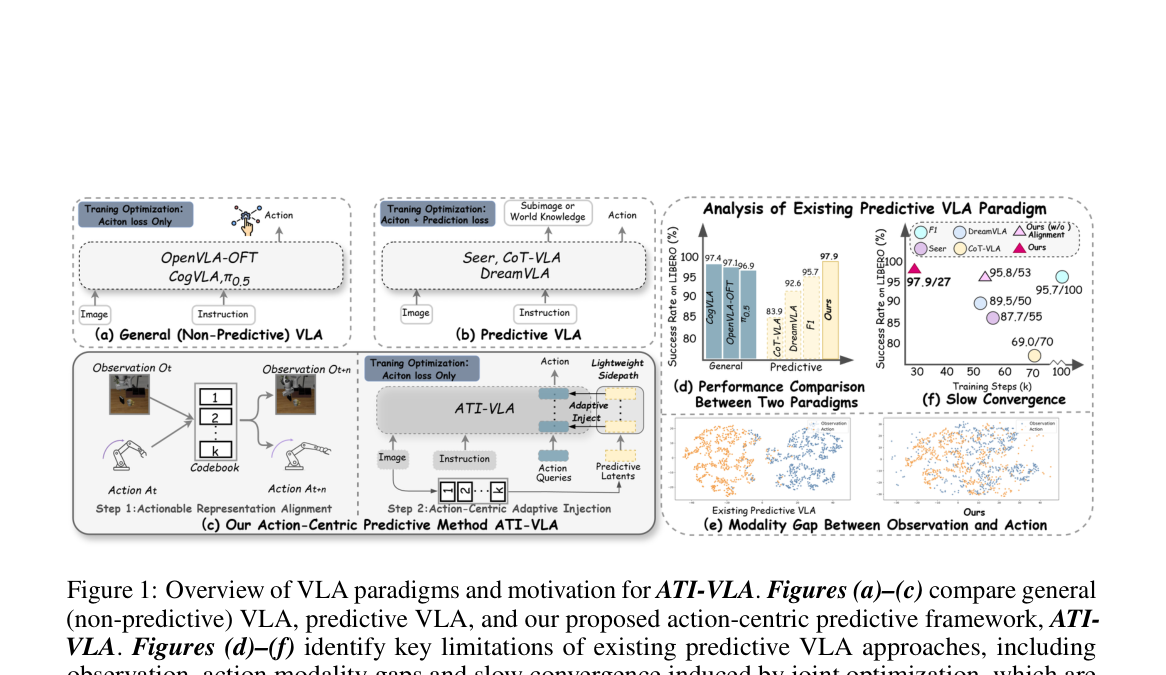
ATI-VLA:先做可行动对齐再自适应注入的动作中心预测式视觉语言动作模型 3 10 月, 2026 作者 PengChao ATI-VLA 先用共享码本把观测与动作对齐到可行动离散潜空间,再以轻量旁路把预测潜变量按层间隔注入动作解码,只优化动作损失。