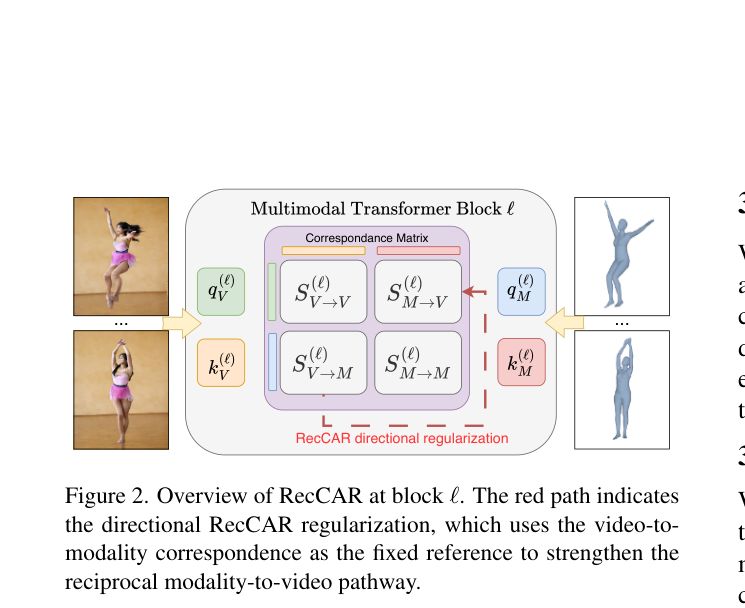
所有模态平等,但视频更平等:弥合联合视频生成中的跨注意力缺口 25 9 月, 2026 作者 PengChao 本文发现联合多模态扩散里视频到伴生模态的对应远强于反向路径,并提出 RecCAR,用停梯度 KL 把较弱的模态到视频对应拉向已建立的视频到模态对应,从而提升视频-动作与视频-音频一致性。