快速导读:本文发现联合多模态扩散里视频到伴生模态的对应远强于反向路径,并提出 RecCAR,用停梯度 KL 把较弱的模态到视频对应拉向已建立的视频到模态对应,从而提升视频-动作与视频-音频一致性。
联合多模态扩散声称视频与伴生模态(3D 人体动作、音频等)在同一去噪过程中互相影响,但作者发现:预训练后视频到伴生模态的对应往往已经很强,而伴生模态回写视频的对应明显更弱。架构上的双向连通并不等于功能上的双向信息流。
本文提出 RecCAR(Reciprocal Cross-modal Attention Regularization):把两方向写成关于同一批视频 token 的对应分布,冻结较强的视频到模态对应,用停梯度 KL 把较弱反向通路拉齐。方法只改训练期注意力对齐,推理不加模块;在 EchoMotion 与 LTX-2/JavisDiT++ 上分别改善人体解剖一致性与音视频同步。独立代码/项目页公开状态待核验。
英文题目:All modalities are equal, but video is more equal: Closing the Cross-Attention Gap in Joint Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.27901
原始论文:PDF / 论文页面
这篇论文解决什么问题?
级联管线先生成视频再预测音频或动作,难以在全程去噪中互纠错误;联合生成用双向跨注意力连接两条流,理论上任一模态都可约束另一模态。
标准生成目标并不规定两个方向应携带多少有效信息。模型可以主要依赖视频去塑造伴生模态,而反过来几乎不用伴生信号修正视频中的肢体错误或动作瞬间。
这一不对称在视频-动作上表现为 SMPL 姿态与画面解剖错位,在视频-音频上表现为波形峰与可见敲击/脚步不同步。若不显式约束互惠对应,联合生成的核心动机就会落空。
核心创新
- 指出联合多模态生成器虽架构双向,但信息流常呈视频主导的单向对应。
- 提出 RecCAR:以已建立的视频到模态对应为固定参考,用停梯度 KL 强化反向通路。
- 同一目标同时改进结构化动作与时序音频两类伴生模态,且普通同数据微调无法复现收益。
方法概览
1) 把 V→M 与 M→V 的跨注意力 logits 都重新归一化为关于视频 token 的对应分布,使两方向可比。2) 定义 reciprocal correspondence gap 为两分布的 KL 平均。3) RecCAR 对 V→M 做 stop-gradient,用 KL 把 M→V 拉向该固定参考,总损失为 Lgen+λ LRecCAR。4) 仅对注意力投影做 LoRA 微调,不改推理结构。5) 分别接到 EchoMotion(视频-动作)与 LTX-2/JavisDiT++(视频-音频)。
- 在多模态 Transformer 块中,保留模态内自注意力,并关注 V→M 与 M→V 两条跨模态路径。用 query/key 投影得到兼容分数后,对 V→M 取关于视频 token 的 softmax;对原生按模态归一的 M→V,则把同一 logits 在视频维上重归一化,使两方向回答同一问题:给定伴生 token j,它最对应哪些视频 token。
- 互惠对应缺口 Δcorr 对所选层、头与伴生 token 平均两分布的 KL。RecCAR 对 V→M 对应做 stop-gradient,得到定向缺口作为正则项,与原生成损失相加,λ 取 0.01。
- 参数高效适配:骨干冻结,仅对注意力投影加 rank-128 LoRA。视频-动作侧微调 EchoMotion 全部联合自注意力权重;视频-音频侧微调跨注意力权重。
- 视频-动作数据从约 18,000 候选对中用 CameraHMR 估计 SMPL,并以 MPJPE/N-MPJPE 低于 0.15 过滤,得到 4,292 训练对;音频侧随机采样约 4,300 条 VGGSound 片段。
逐图理解论文
失败直觉
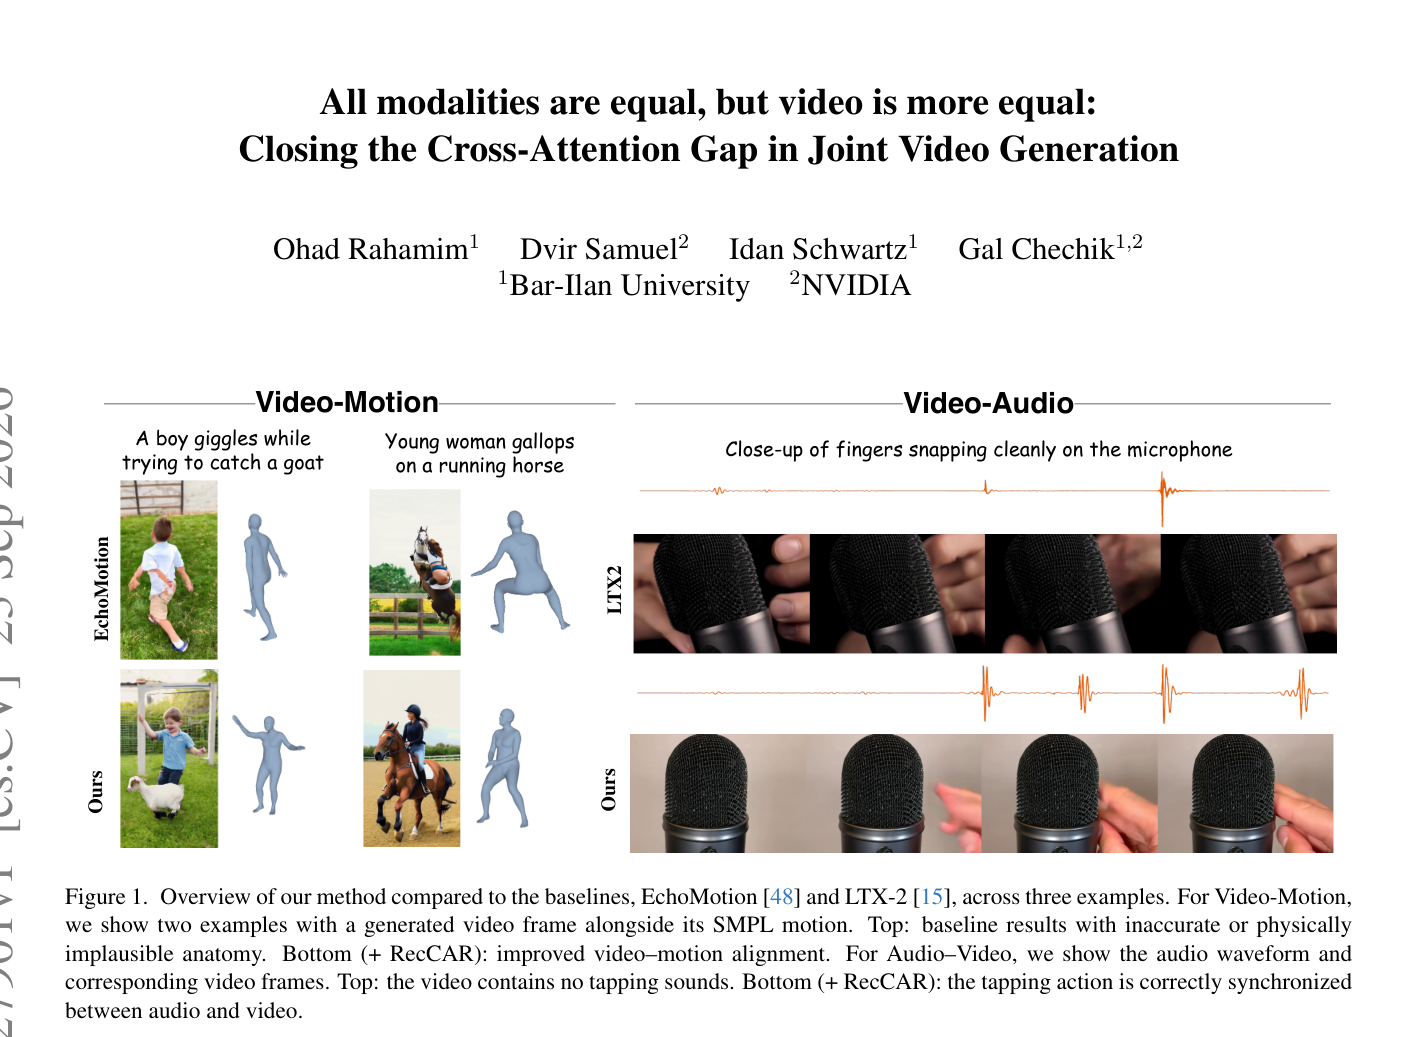
首页总览。左为 Video-Motion:EchoMotion 上追羊男孩与骑马女性出现解剖扭曲,+RecCAR 后画面与蓝色 SMPL 网格更一致;右为 Video-Audio:手指对麦克风打响指,LTX-2 波形峰与画面动作错位,+RecCAR 后峰与弹指瞬间对齐。
研究缺口
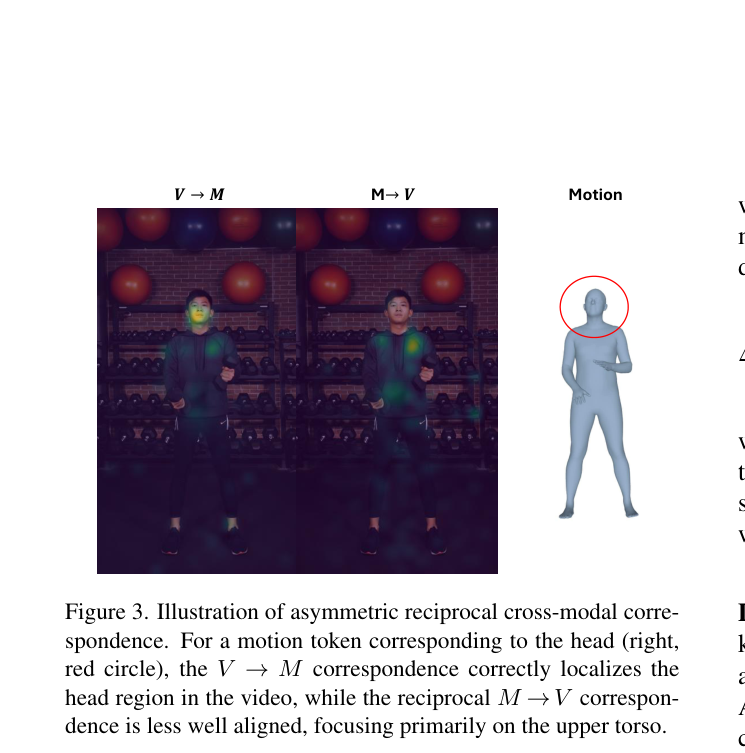
不对称示例。右侧运动网格红圈标出头部 token;左列 V→M 热力正确落在人脸,中列 M→V 热力偏到上胸肩,直观说明反向通路更弱。
方法贡献
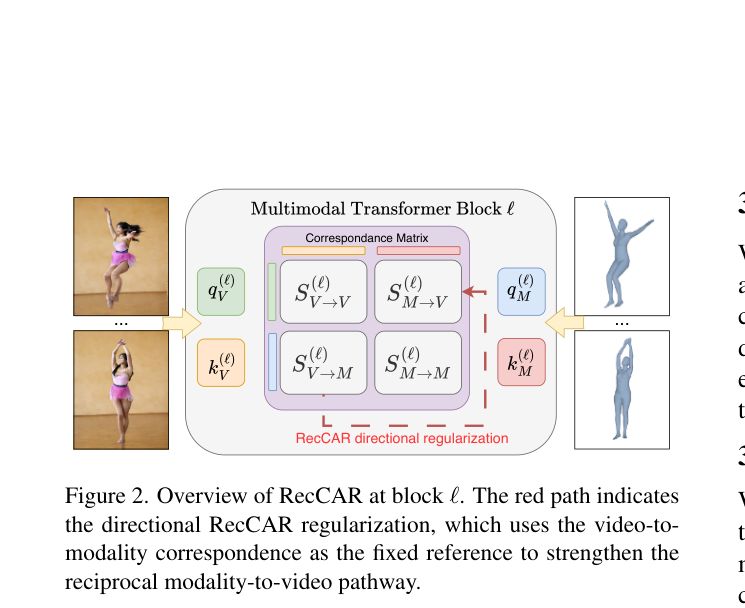
方法总览。左侧视频帧与右侧 SMPL 网格分别进入 q/k;中间 Correspondence Matrix 含 V↔V、M↔M、V→M、M→V;红色虚线从 V→M 绕到 M→V,表示以视频到模态对应为固定参考的 RecCAR 定向正则。
实验如何设计?
- 视频-动作:1,000 条不与训练重叠的 VidProM 提示,对比 EchoMotion、CoMoVi、FlowMo;VBench 报告 Human Anatomy、Motion Smoothness、Dynamic Degree、Aesthetic 等。
- 视频-音频:T2AV-Compass 500 提示与 AVGen-Bench 235 提示;同步看 AV Desync,语义看 CLAP/AV-CLIP 与文本对齐,并报告音频真实感与视频质量。
- 消融在同数据上比较原模型、标准微调与完整 RecCAR,隔离对齐损失贡献。
关键结果与论文证据
- Table 1:EchoMotion+RecCAR 的 Human Anatomy 从 0.69 升至 0.75,Dynamic Degree 保持 0.83,其他质量指标持平或略升(第 6 页)。
- Table 2:LTX-2+RecCAR 绝对 AV Desync 从 0.804 降到 0.752,为表中最优;音频 AAS/MTC 亦有提升(第 6 页)。
- Table 3:JavisDiT++ DeSync 0.518→0.438,LTX-2 0.424→0.406;CLAP/AV-CLIP 基本保持(第 7 页)。
- Table 4:同数据标准微调使 Human Anatomy 降到 0.66、N-MPJPE 升到 0.208;RecCAR 则 Human Anatomy 0.78、N-MPJPE 0.148(第 9 页)。
- 定性上,Figure 1/4 显示动作网格更贴合肢体朝向,Figure 6 显示马蹄着地与蹄声瞬态更对齐。
阅读时需要注意
- 依赖视频到模态方向已学到可靠对应;参考错误时正则可能固化偏差。
- 结果来自特定骨干与 LoRA 设置,跨更多联合架构的证据仍有限。
- 动作训练集经过误差阈值筛选,外推到高度失败的初始生成需谨慎。
- 预印本尚未同行评审;代码与项目页公开状态待核验。
关联工作
- 与仅把伴生模态当条件的级联方法不同,本文保留联合去噪,但补上互惠注意力监督。
- 相对 ITS、UniAVGen 等同步增强工作,RecCAR 不引入额外推理模块,而是复用模型内部已有对应作为自监督目标。
- 注意力优化脉络可追溯到 Prompt-to-Prompt 与相关性图优化;本文把思想扩展到联合生成的双向通路。