跳至内容

pchao.org

计算机视觉

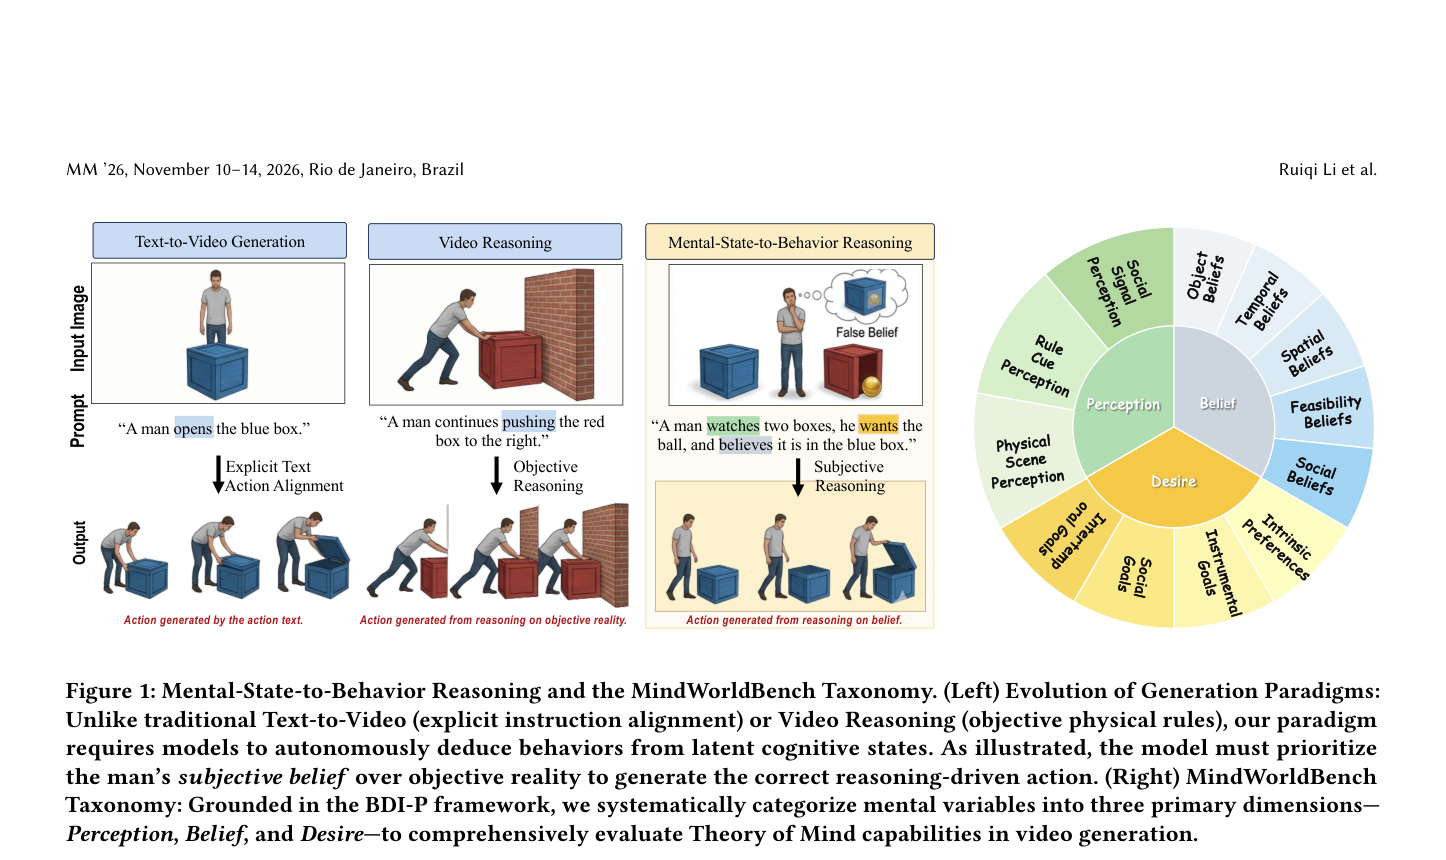
MindWorldBench:评测图生视频的心理状态到行为推理

2 10 月, 2026 作者 PengChao
显式动作的捷径

MindWorldBench 用零动作提示与反事实设计,检验图生视频模型能否从感知、信念与欲望推出正确行为,并暴露全知偏置。

分类 CVPR三分钟 标签 CVPR三分钟、 Mental-state-to-behavior reasoning、 MindWorldBench、 Zero-Action、 人工智能、 深度学习、 计算机视觉 发表评论

CASE:从给定证据到自主取证的纵向医疗推理

2 10 月, 2026 作者 PengChao
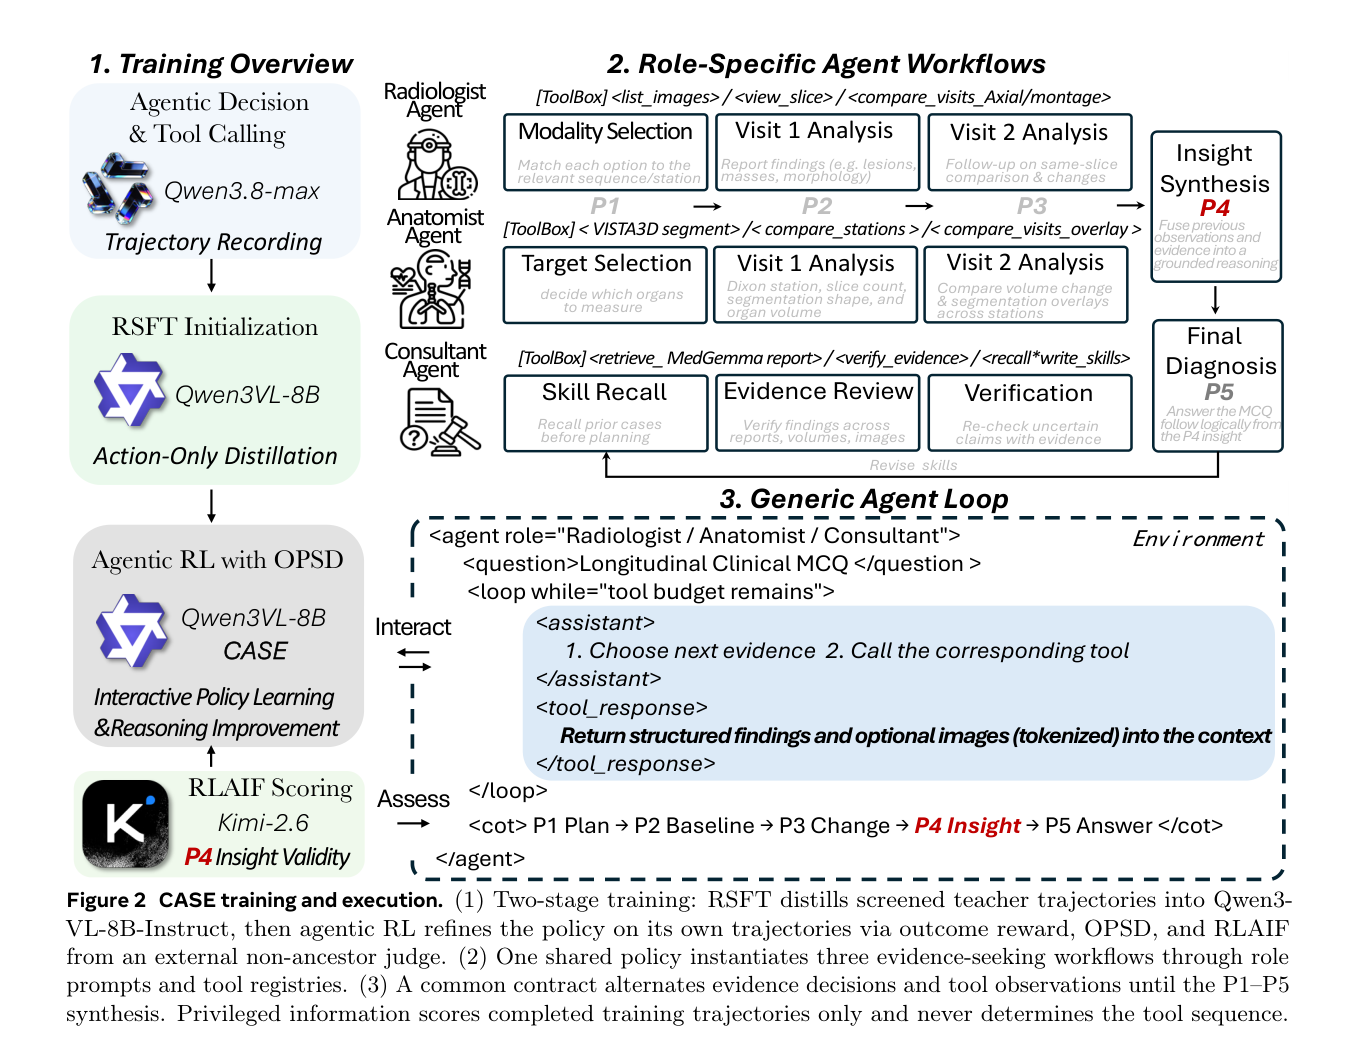
CASE 取证框架

CASE 把纵向医疗推理改写成患者环境中的自主取证,用 RSFT 加 agentic RL 训练紧凑视觉语言策略,并在 UK Biobank 基准上超过若干前沿模型。

分类 CVPR三分钟 标签 CASE、 CVPR三分钟、 Qwen3-VL-8B、 RSFT、 人工智能、 深度学习、 计算机视觉 发表评论

DeCoPrune:用去噪一致性做自回归视频扩散的高效 KV 缓存修剪

2 10 月, 2026 作者 PengChao
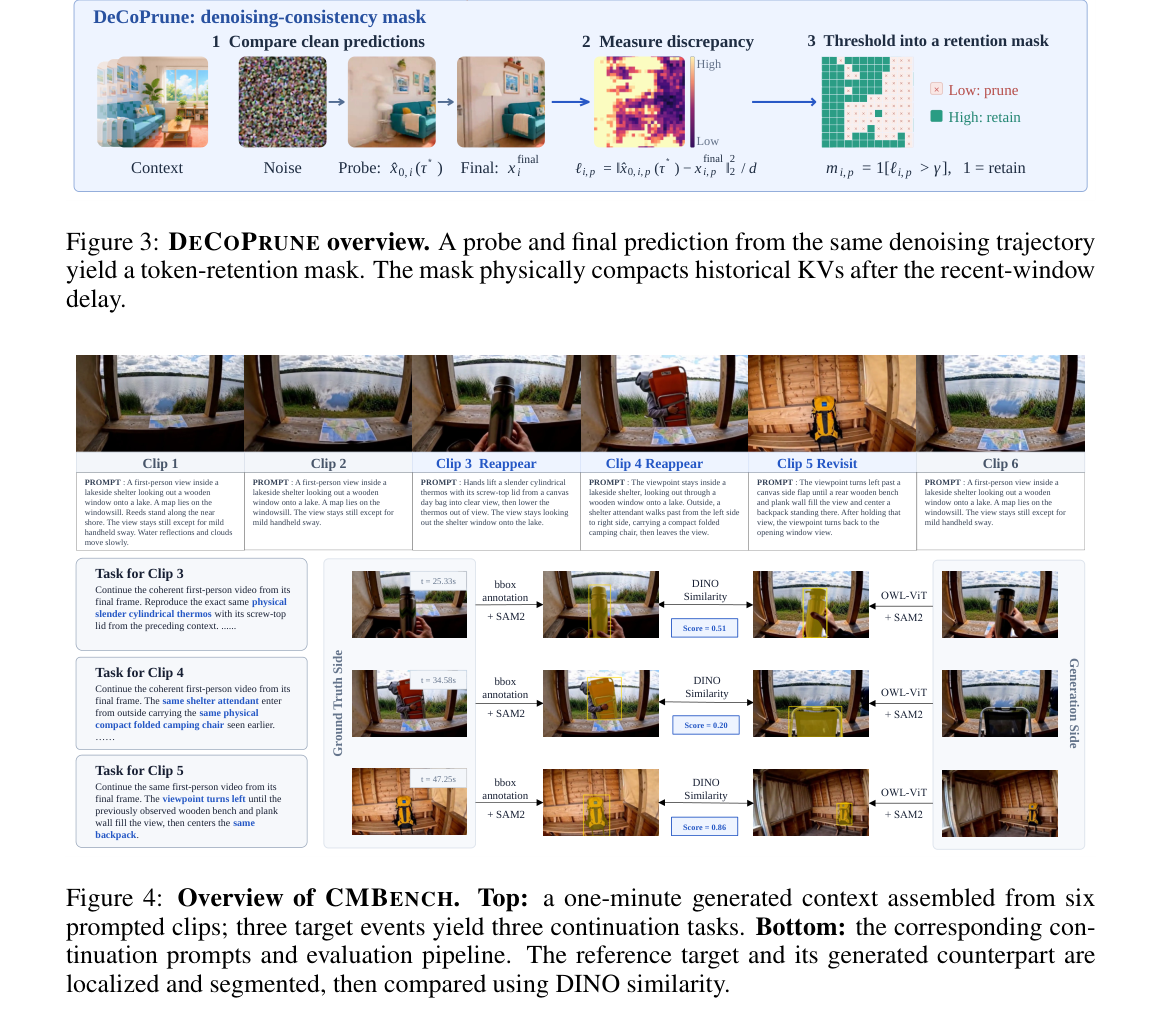
记忆评测

DeCoPrune 免训练,用中间干净预测与最终去噪结果的差异衡量 token 长期价值,在高修剪比下接近 FullKV 的上下文一致性并加速续写。

分类 CVPR三分钟 标签 CVPR三分钟、 DeCoPrune、 FullKV、 RoPE、 人工智能、 深度学习、 计算机视觉 发表评论

GRC-Pose:生成-重建对应的先验无关六维物体位姿跟踪

2 10 月, 2026 作者 PengChao
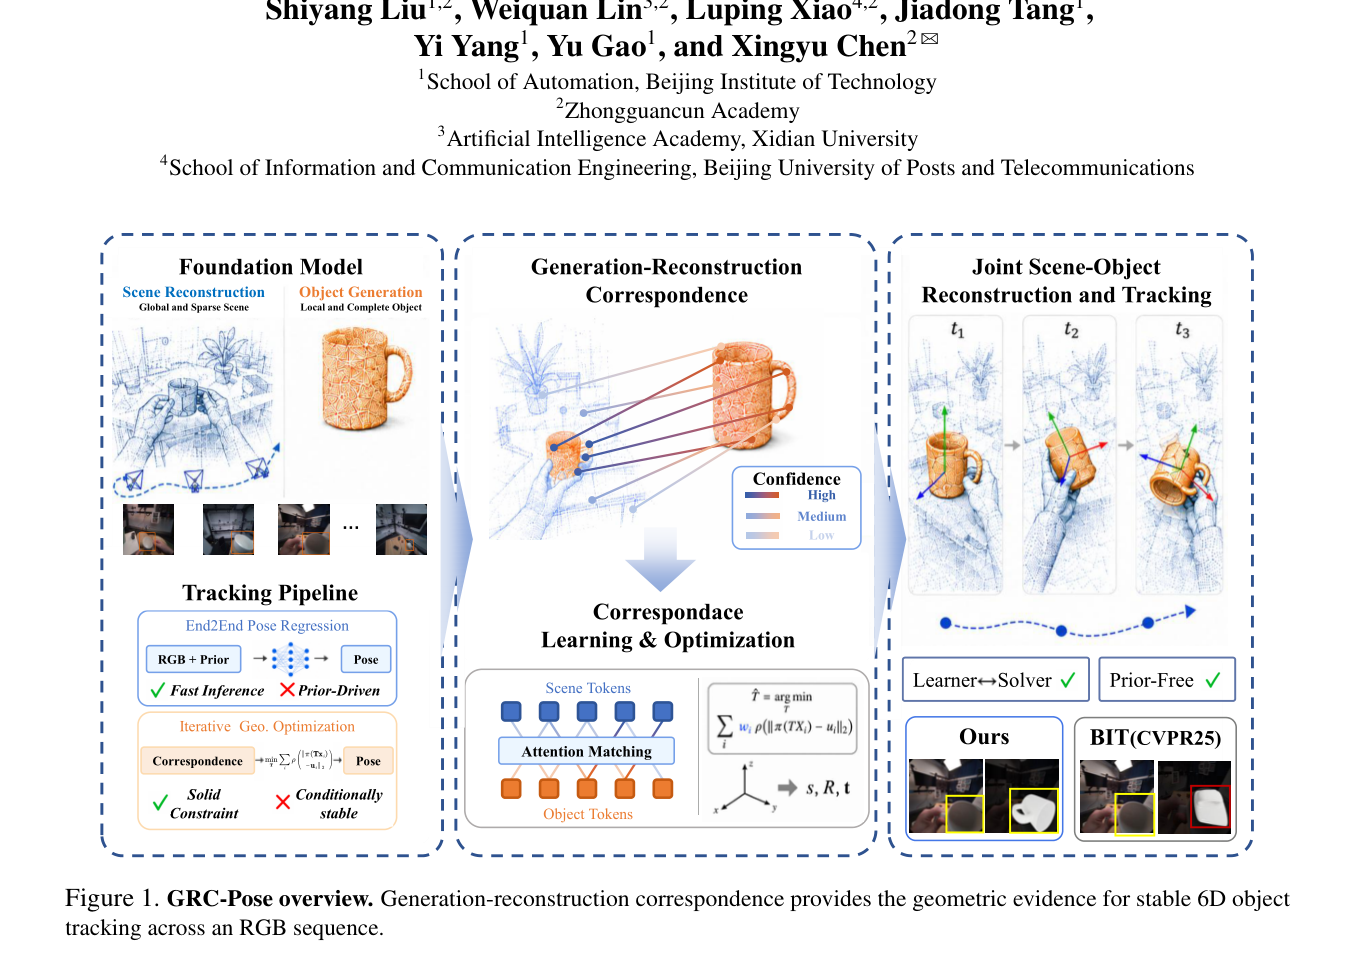
跨域错位

GRC-Pose 把无CAD先验的六维跟踪写成生成几何与场景重建的对应求解,用 GeoCorr-Matcher 与 FGH-Solver 在 HOT3D 上刷新 Average Recall 与运动保持。
分类 CVPR三分钟 标签 CVPR三分钟、 FGH-Solver、 GeoCorr-Matcher、 GRC-Pose、 人工智能、 深度学习、 计算机视觉 发表评论

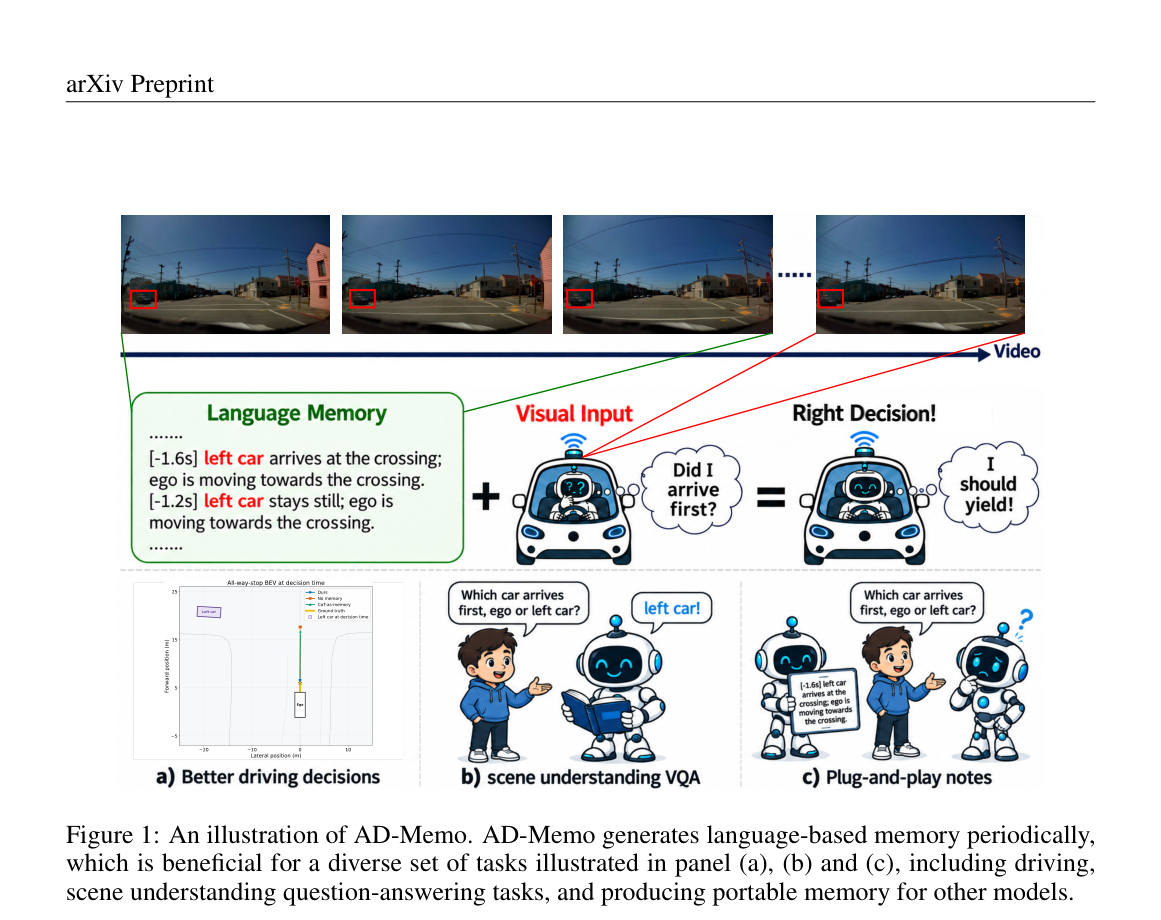
AD-Memo:带语言记忆的视觉语言动作驾驶智能体

2 10 月, 2026 作者 PengChao
语言记忆机制

AD-Memo 让驾驶 VLA 以思维链扩展写出可解释语言记忆,并用半闭环 RL 算法 Da Capo 改善记忆信用分配与驾驶轨迹。

分类 CVPR三分钟 标签 AD-Memo、 CVPR三分钟、 Physical-AV、 VLA、 人工智能、 深度学习、 计算机视觉 发表评论

StereoGaussians:从立体图像前馈预测三维高斯溅射

2 10 月, 2026 作者 PengChao
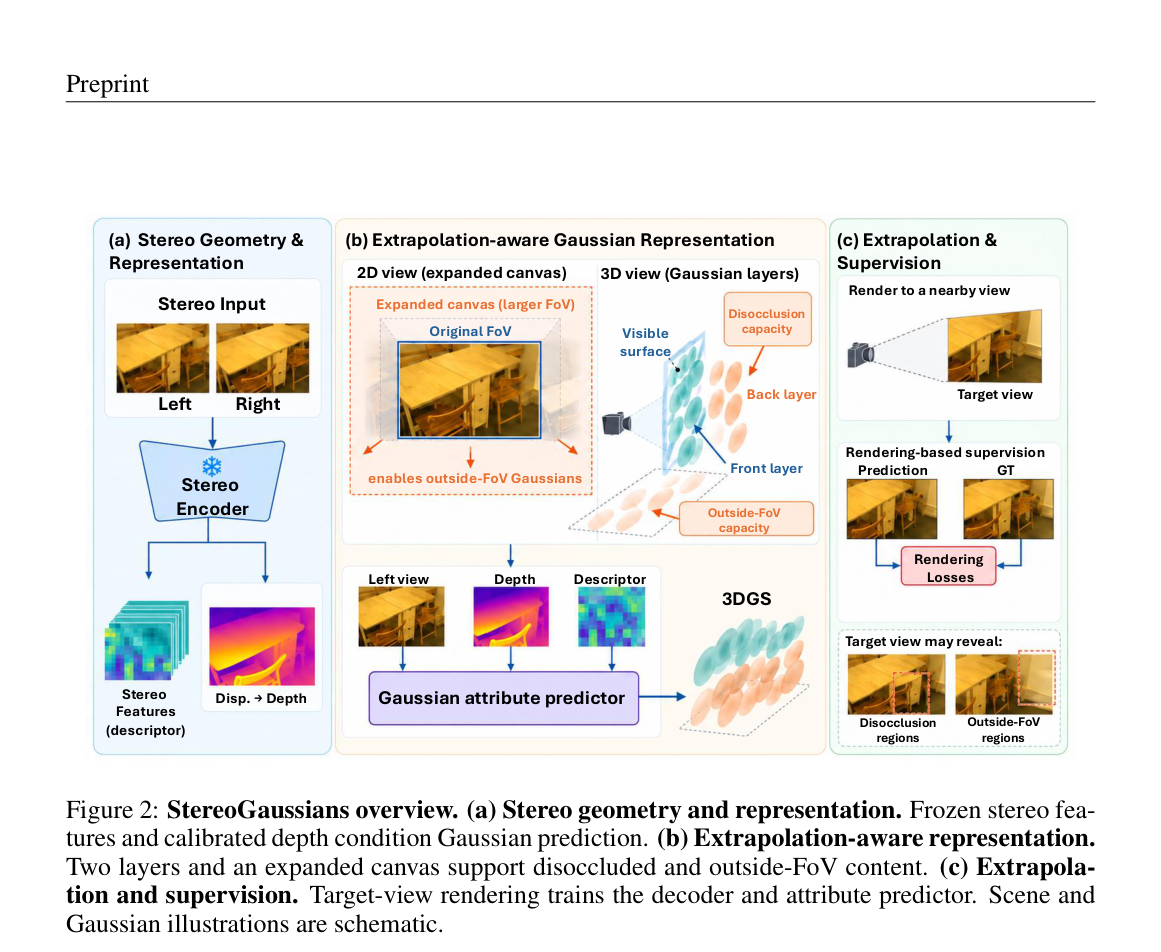
方法总览

StereoGaussians 从一对标定立体图前馈预测米制 3DGS,用冻结立体特征、双层高斯与扩展画布支撑邻近视角外推。

分类 CVPR三分钟 标签 3DGS / 3D Gaussian Splatting、 CVPR三分钟、 SceneSplat-Stereo、 StereoGaussians、 人工智能、 深度学习、 计算机视觉 发表评论

LongTake:学习在长程视频生成中持续保持动态

2 10 月, 2026 作者 PengChao
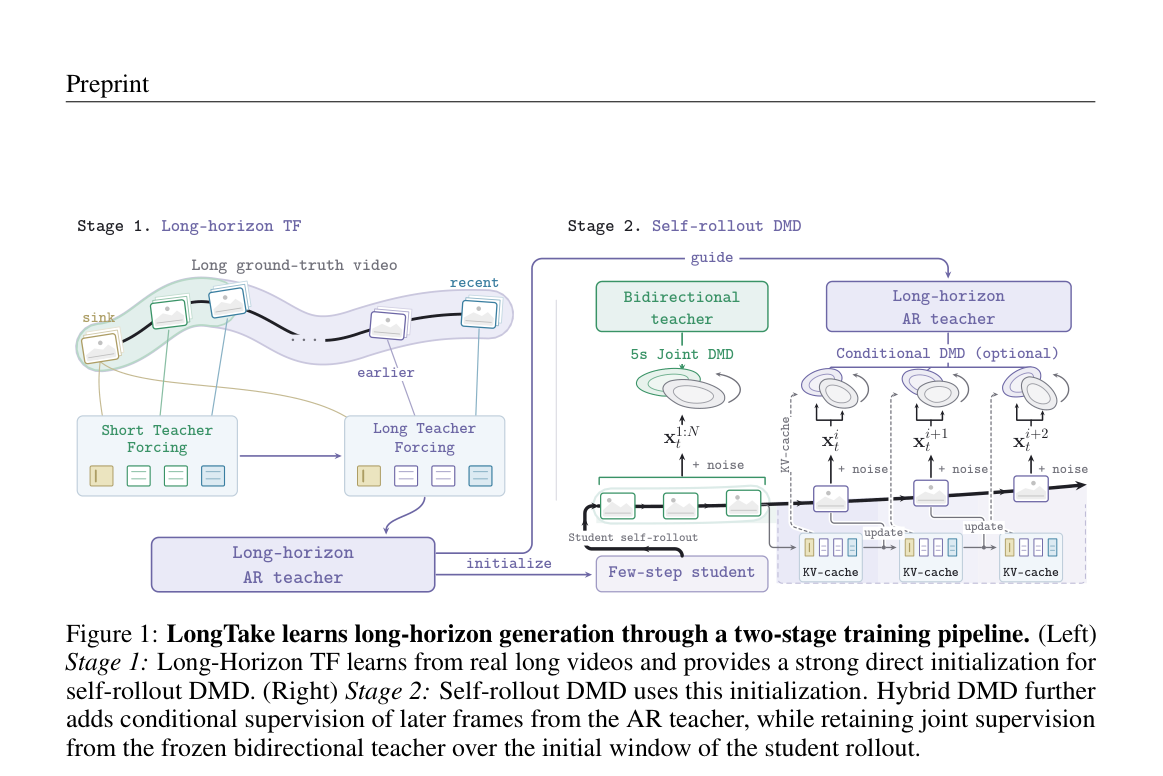
两阶段训练

LongTake 用真实长视频上的 Long-Horizon TF 直接初始化自 rollout DMD,并可选 Hybrid DMD 延长后期监督,以在长程生成中稳住动态与画质。
分类 CVPR三分钟 标签 CVPR三分钟、 KV-cache、 Long-Horizon、 LongTake、 人工智能、 深度学习、 计算机视觉 发表评论

Asking the World:智能体式世界建模与探测的通用物理推理

2 10 月, 2026 作者 PengChao
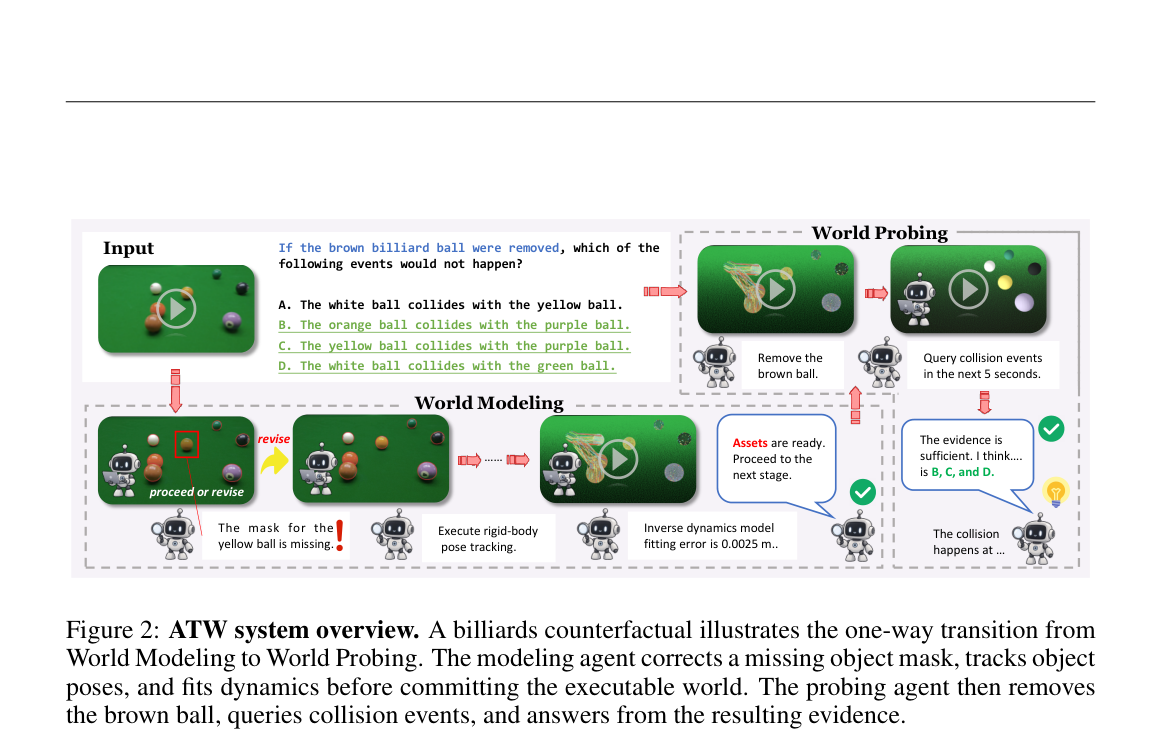
建模与探测

ATW 按场景与问题自适应地建模可执行世界,再用 PolyWorld 探测取证,从而做跨材料通用物理推理。

分类 CVPR三分钟 标签 ATW、 CVPR三分钟、 Gemini-3-Flash、 PolyWorld、 人工智能、 深度学习、 计算机视觉 发表评论

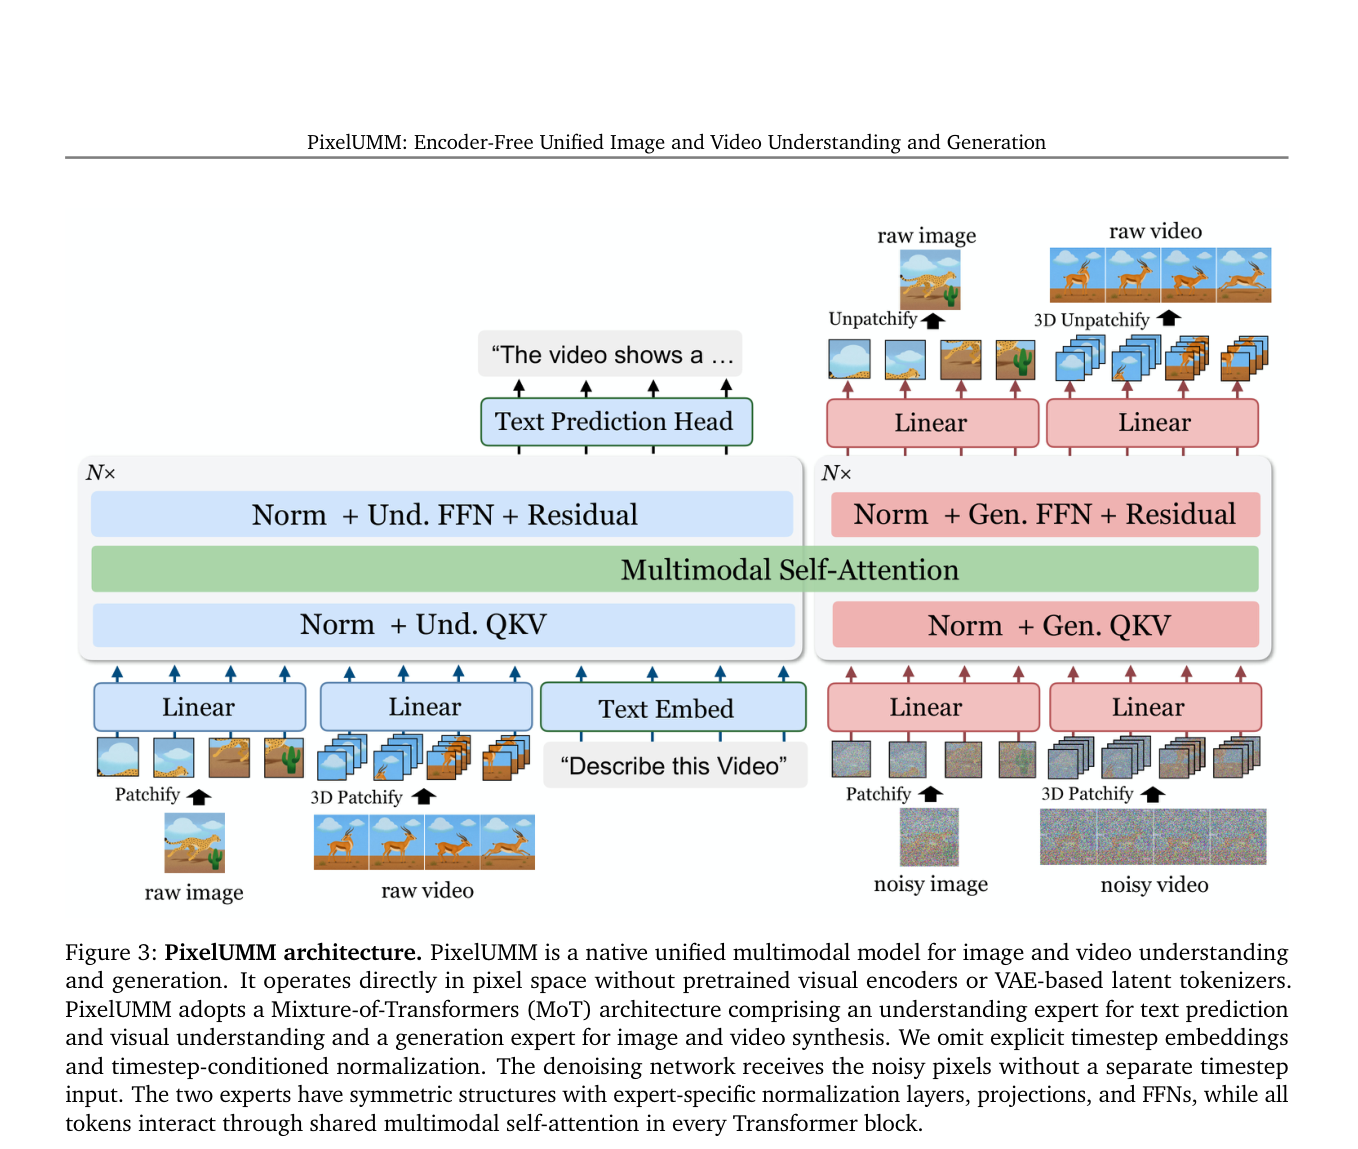
PixelUMM:无编码器的统一图像与视频理解生成

2 10 月, 2026 作者 PengChao
像素统一接口

PixelUMM 用单层线性投影把图像 patch 与视频 tubelet 直接送入 Mixture-of-Transformers,在像素空间联合做理解与流匹配生成。

分类 CVPR三分钟 标签 CVPR三分钟、 Encoder-free、 Mixture-of-Transformers、 PixelUMM、 人工智能、 深度学习、 计算机视觉 发表评论

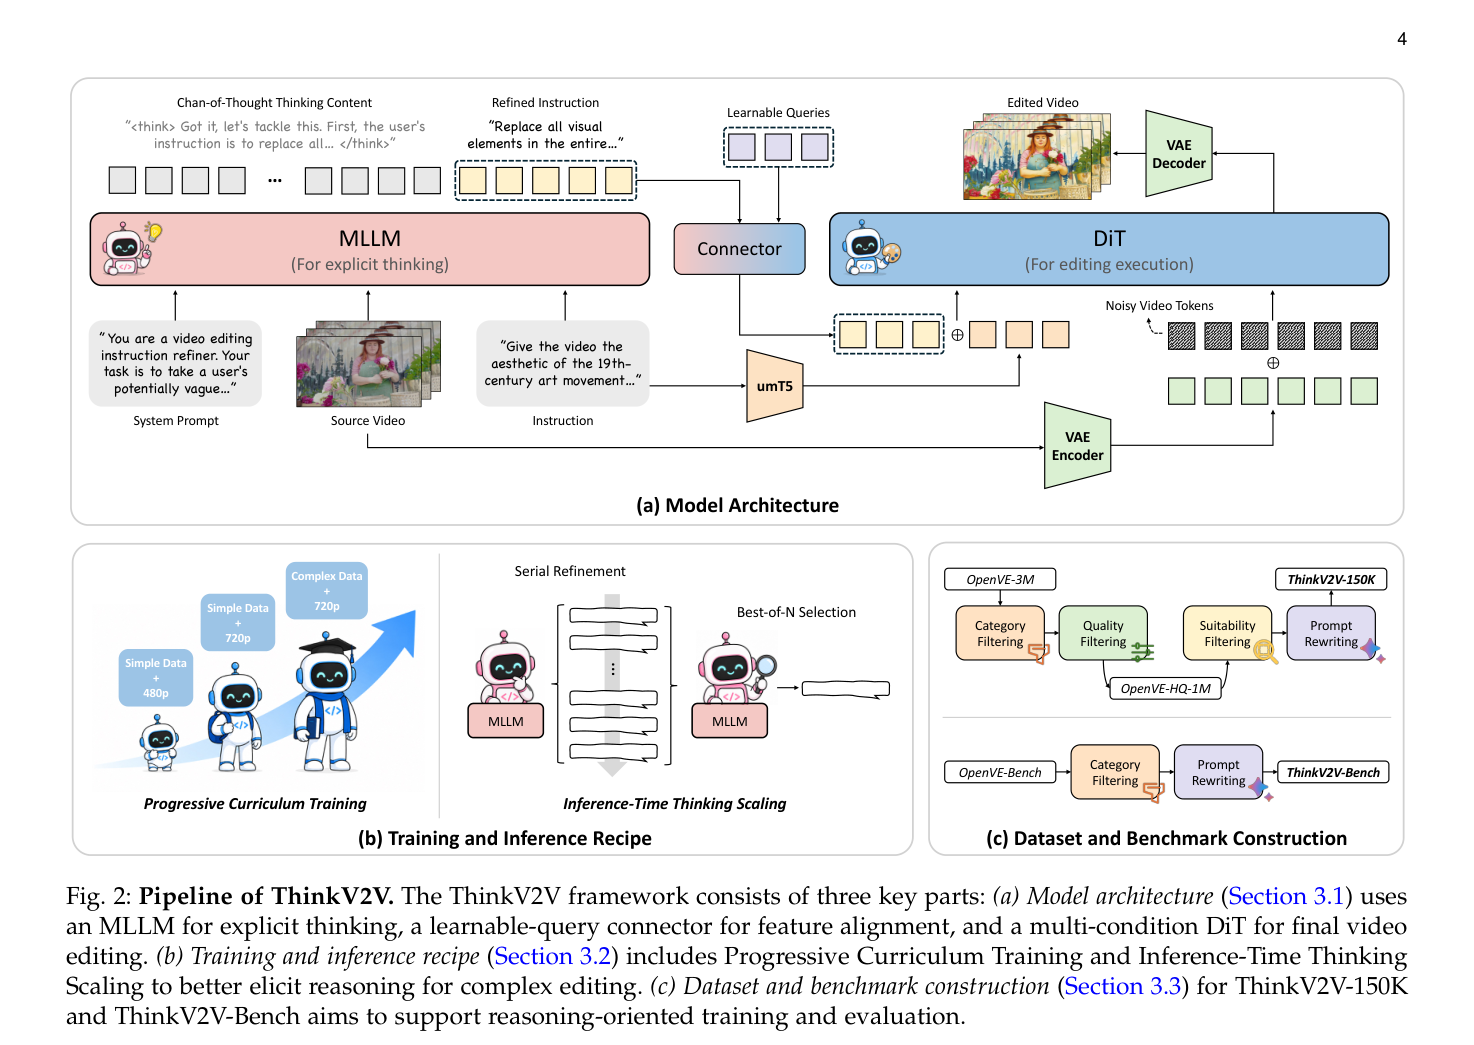
ThinkV2V:释放多模态大模型推理能力的指令引导视频编辑

2 10 月, 2026 作者 PengChao
先想后改架构

ThinkV2V 先让 MLLM 对源视频与隐式指令做显式思考,再经可学习查询连接器注入 DiT,配合渐进课程训练与推理时思考扩展,完成复杂指令视频编辑。

分类 CVPR三分钟 标签 CVPR三分钟、 MLLM、 Qwen3-VL-Thinking-8B、 ThinkV2V、 人工智能、 深度学习、 计算机视觉 发表评论
较早文章
较新文章
← 上一页 页面1 … 页面7 页面8 页面9 … 页面74 下一页 →
© 2026 pchao.org • Built with GeneratePress