SV-WAM:用于端到端自动驾驶的高效环视世界-动作模型
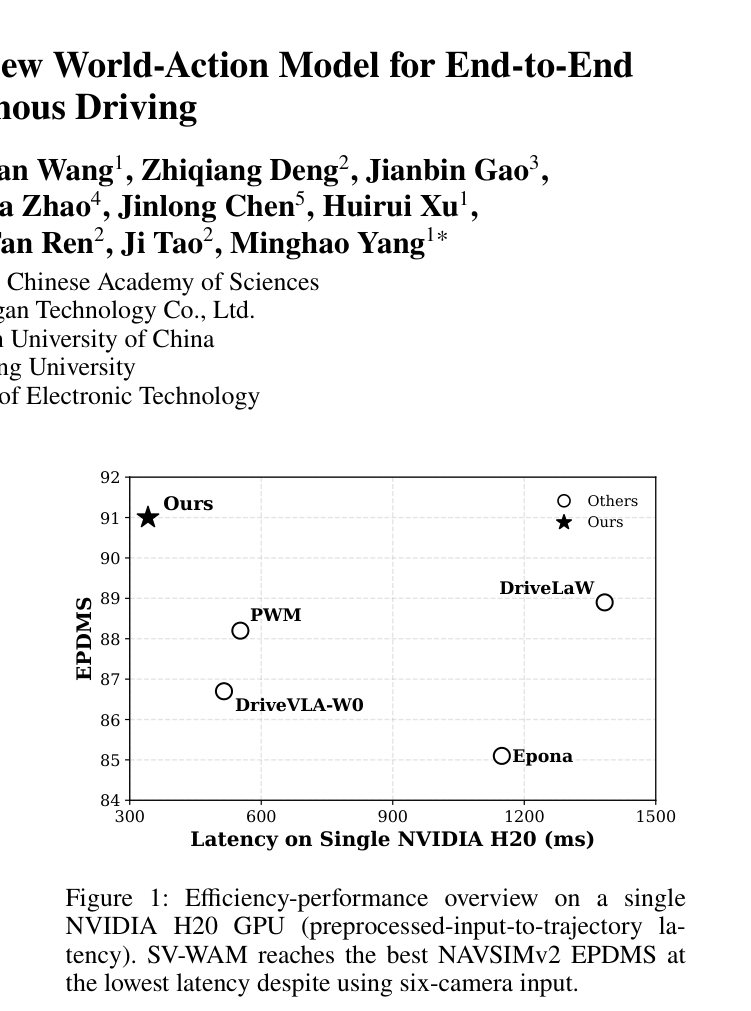
SV-WAM 提出了一种基于 action-centered causal mask 的环视世界-动作模型,通过训练时联合去噪未来视频与动作、推理时仅保留动作分支,实现了在保持六路相机全景感知优势的同时,显著降低推理延迟并提升 NAVSIMv2 规划性能。
SV-WAM 提出了一种基于 action-centered causal mask 的环视世界-动作模型,通过训练时联合去噪未来视频与动作、推理时仅保留动作分支,实现了在保持六路相机全景感知优势的同时,显著降低推理延迟并提升 NAVSIMv2 规划性能。