SV-WAM:用于端到端自动驾驶的高效环视世界-动作模型
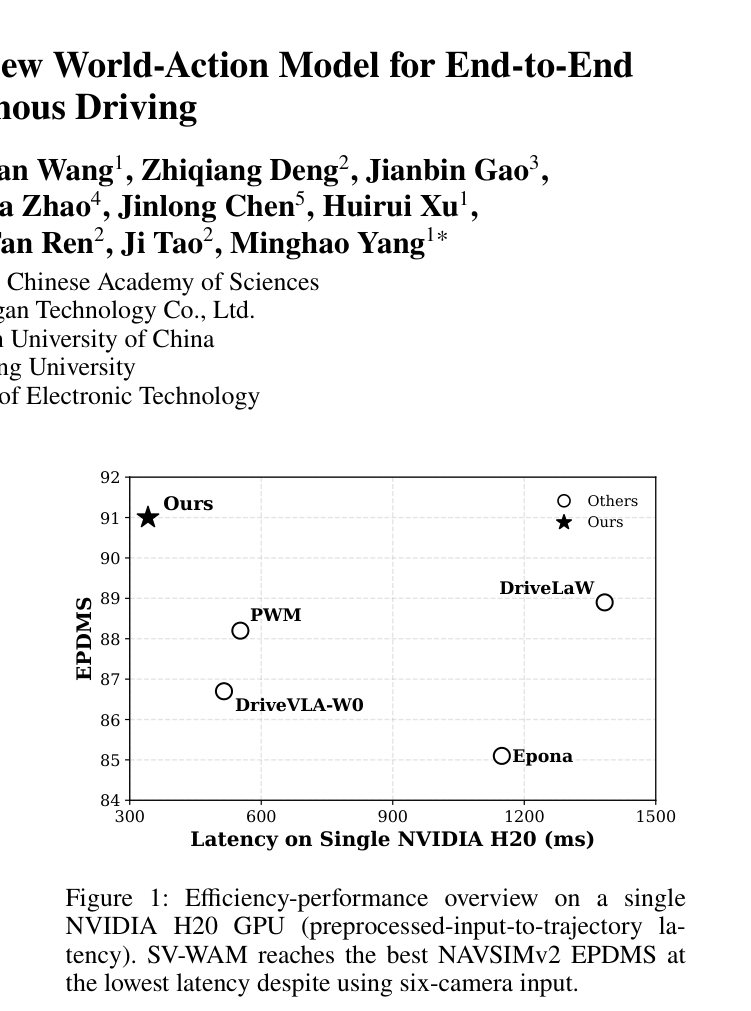
SV-WAM 提出了一种基于 action-centered causal mask 的环视世界-动作模型,通过训练时联合去噪未来视频与动作、推理时仅保留动作分支,实现了在保持六路相机全景感知优势的同时,显著降低推理延迟并提升 NAVSIMv2 规划性能。
SV-WAM 提出了一种基于 action-centered causal mask 的环视世界-动作模型,通过训练时联合去噪未来视频与动作、推理时仅保留动作分支,实现了在保持六路相机全景感知优势的同时,显著降低推理延迟并提升 NAVSIMv2 规划性能。
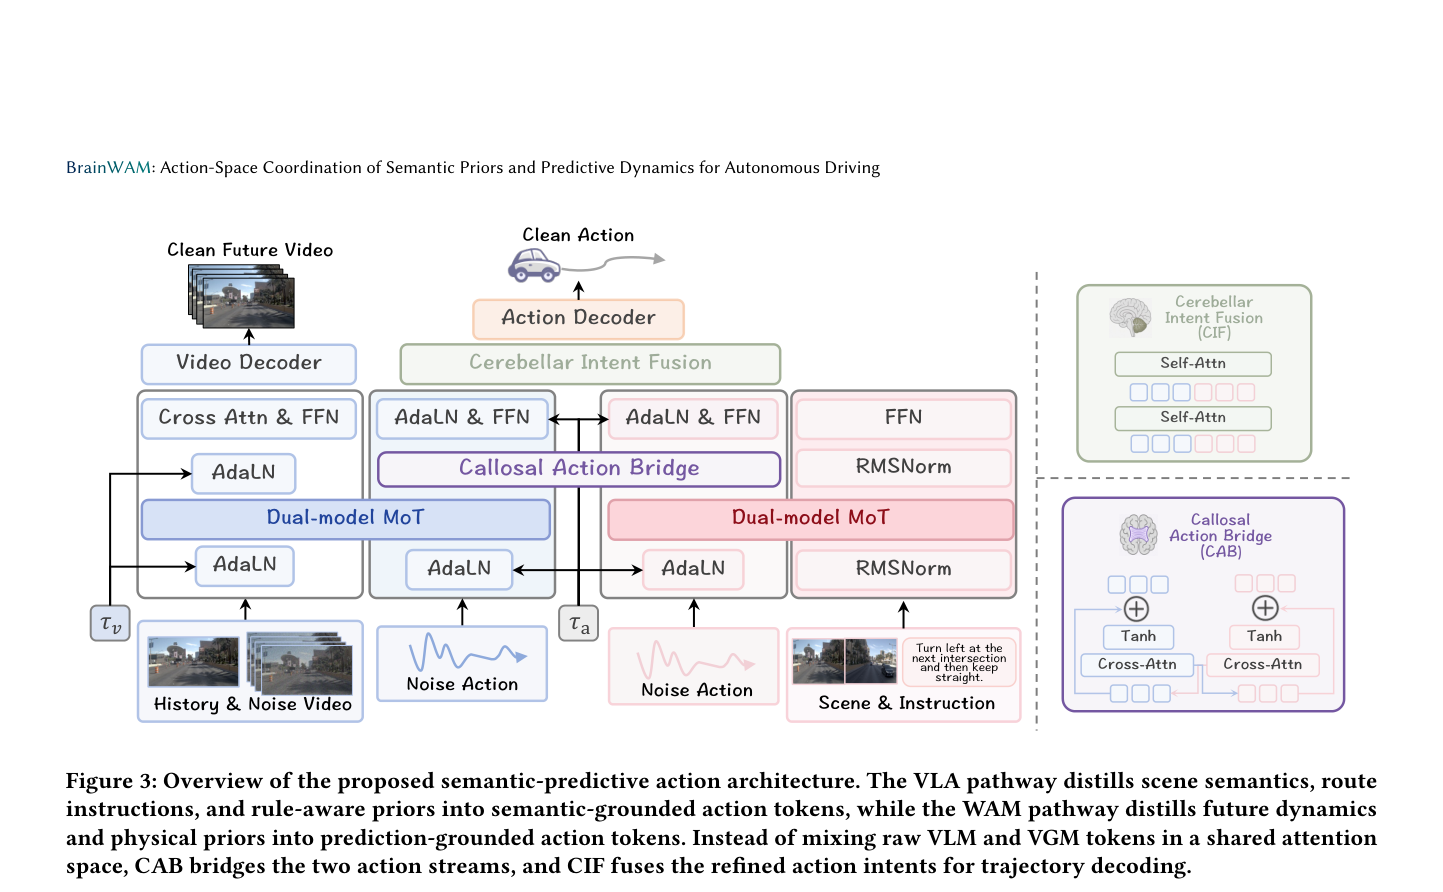
BrainWAM 提出一种受脑功能特化启发的动作空间协调框架,将 VLA 语义推理与 WAM 预测世界建模转化为两条独立动作通路,通过 CAB 和 CIF 在紧凑动作表示层面协调,避免原始 token 融合中的注意力分配失衡。
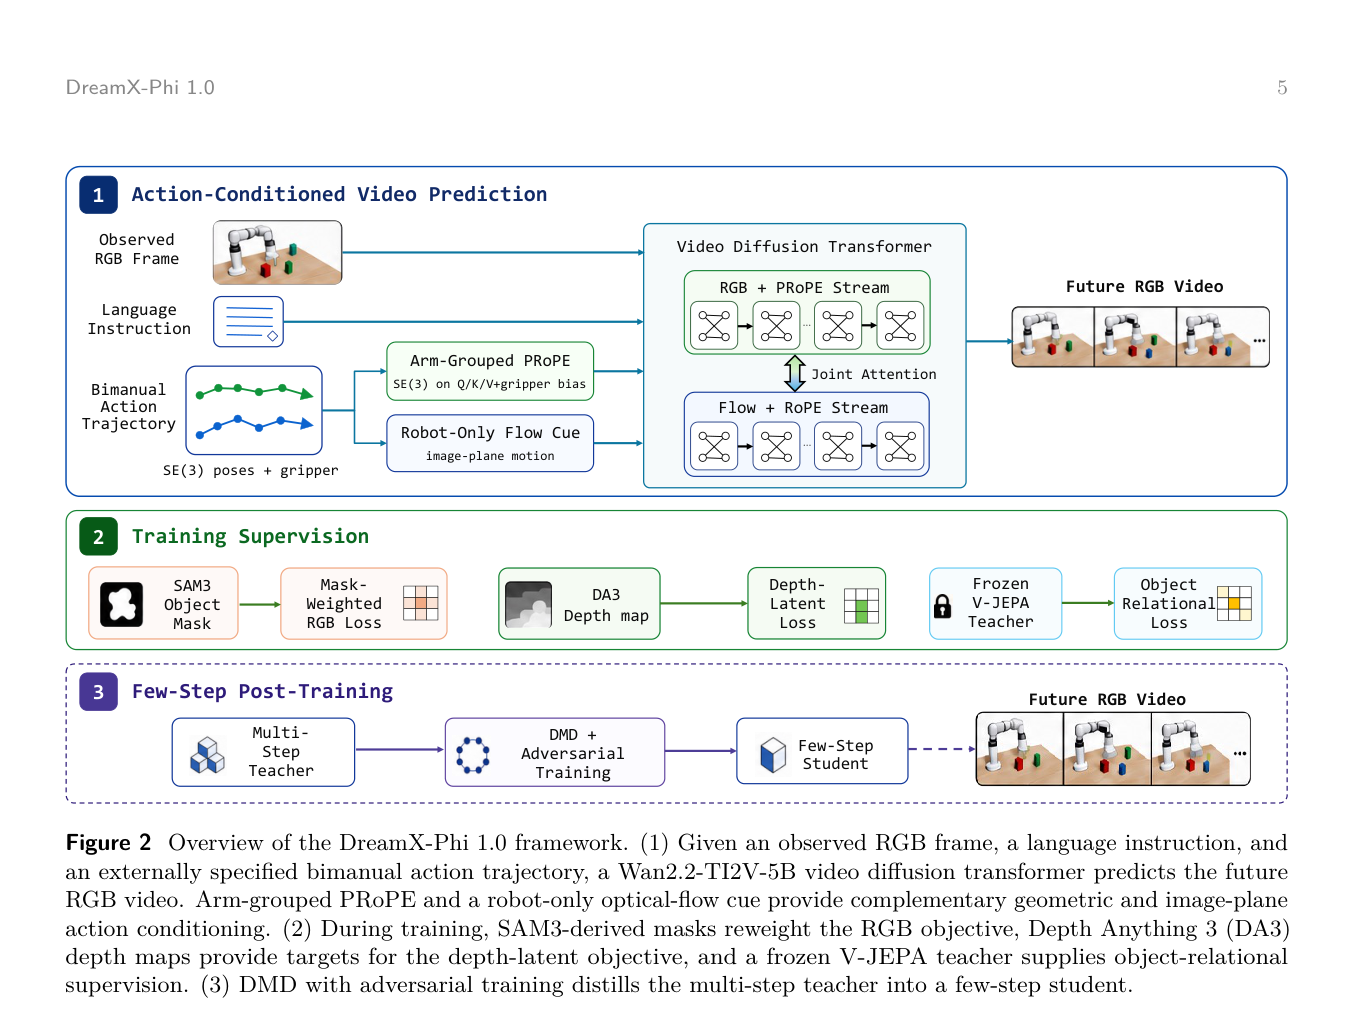
DreamX-Phi 1.0 是一个基于 Wan2.2-TI2V-5B 的动作条件视频世界模型,通过 PRoPE 几何注意力、深度监督和对象一致性约束,在给定单帧观测和双手动作轨迹时预测未来视频,并在 WorldArena 2.0 上取得 Track 1 第一、Track 2 并列第二。