权重中的“世界知识”:解读视觉Transformer的概念电路
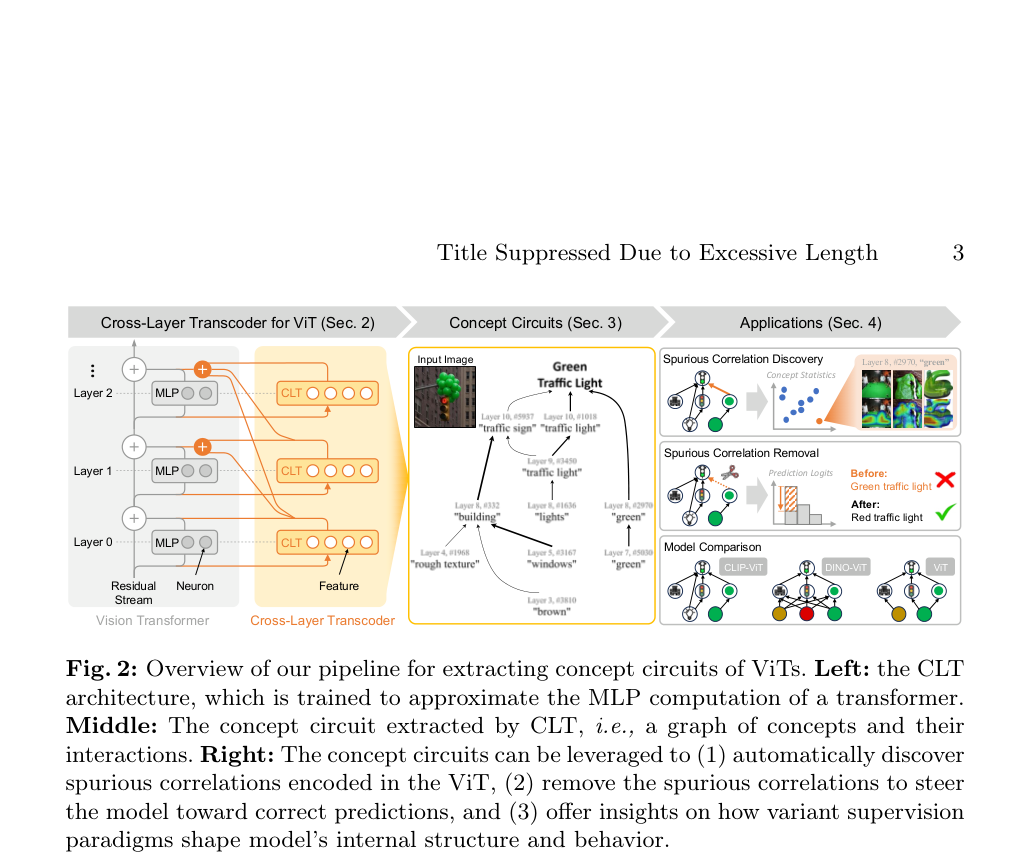
本文提出利用Cross-Layer Transcoders (CLTs)从Vision Transformers (ViTs)中提取全局和实例级概念电路,以揭示模型内部的世界知识、自动发现并移除虚假相关,以及比较不同监督范式下的模型结构差异。
本文提出利用Cross-Layer Transcoders (CLTs)从Vision Transformers (ViTs)中提取全局和实例级概念电路,以揭示模型内部的世界知识、自动发现并移除虚假相关,以及比较不同监督范式下的模型结构差异。
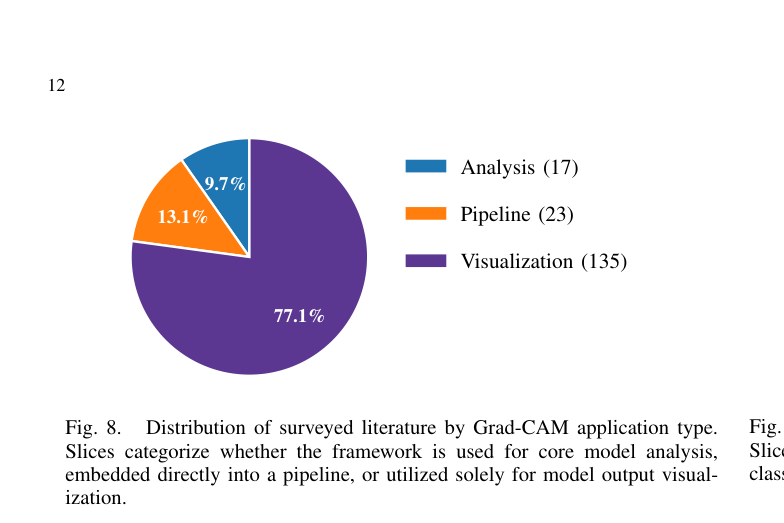
本文对175篇将Grad-CAM应用于ViT的论文进行系统审计,发现大多数研究未充分说明特征提取位置、梯度目标等关键适配选择,并提出统一分类法以明确方法模糊性。