快速导读:本文提出IVSGround框架,通过拒绝采样从VLM反馈中学习关键视角选择器,在保持推理VLM零样本冻结的前提下,显著提升了3D视觉定位的准确率。
3D视觉定位旨在根据自然语言描述在3D场景中定位物体。随着VLM的发展,基于VLM的零样本定位方法成为研究热点。然而,VLM的上下文窗口和计算预算有限,无法处理所有视角,因此视角选择成为关键设计决策。现有方法多采用基于可见性的启发式策略,未能显式考虑定位目标所需的判别性证据。
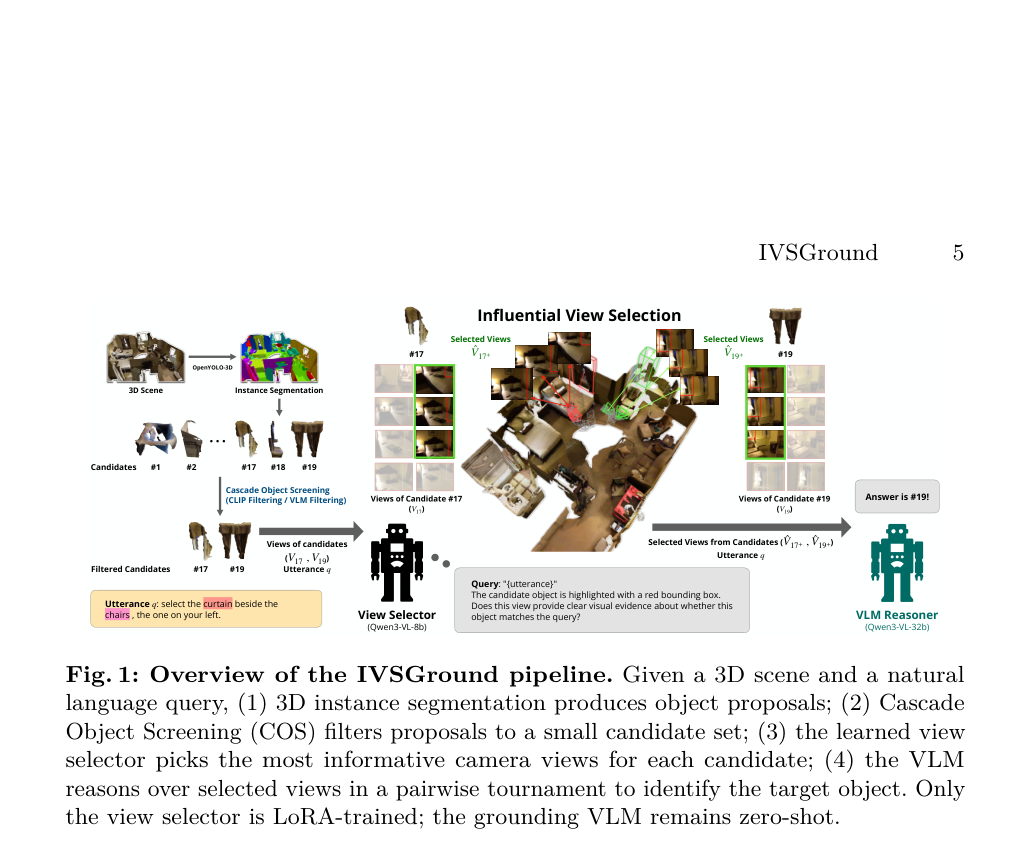
本文提出IVSGround框架,通过拒绝采样从VLM反馈中学习关键视角选择器。该框架包含级联物体筛选(COS)、关键视角选择(IVS)和VLM定位三个阶段。视角选择器基于Qwen3-VL-8B通过LoRA微调,而推理VLM(Qwen3-VL-32B)保持冻结。这种解耦设计使得仅微调轻量级选择器即可提升整体定位性能,同时保持推理模型的零样本特性。
英文题目:Where to Look Matters: Learning Influential Views for VLM-based 3D Visual Grounding
论文出处:arXiv 每日论文精选 · arXiv:2609.04741
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有基于VLM的3D视觉定位方法通常依赖启发式规则(如物体可见性)选择输入视角。这种策略忽略了视角对定位任务的相关性,导致提供的视觉证据可能缺乏判别力或包含冗余信息。例如,一个物体可能从多个角度可见,但只有特定角度才能揭示其与查询描述中提到的其他物体的空间关系。
VLM的上下文窗口和计算预算有限,无法处理所有视角。因此,视角选择成为关键设计决策。现有方法如SPAZER、VLM-Grounder和SeeGround均使用启发式策略,未能显式考虑定位目标所需的判别性证据。这导致定位精度受限,尤其是在复杂场景中。
本文的核心研究缺口在于:如何将视角选择形式化为定位任务的关键组件,并设计一种无需人工标注即可从VLM反馈中学习视角选择器的方法。
核心创新
- 提出关键视角选择(Influential View Selection, IVS)概念,将视角选择形式化为定位任务的关键组件,超越传统的可见性启发式。
- 设计基于拒绝采样的两阶段反馈收集机制,无需人工视角标注即可从VLM定位结果中生成训练信号。
- 实现轻量级视角选择器与冻结推理VLM的解耦,仅微调视角选择器即可提升整体定位性能,保持推理模型的零样本特性。
方法概览
IVSGround框架包含三个主要阶段:(1) 级联物体筛选(COS):利用CLIP文本嵌入和VLM视觉验证,从3D实例分割提案中筛选出少量候选物体;(2) 关键视角选择(IVS):训练一个轻量级视角选择器(基于Qwen3-VL-8B,LoRA微调),预测对定位最有判别力的视角子集;(3) VLM定位:冻结的推理VLM(Qwen3-VL-32B)基于选定的视角进行成对比较推理,通过锦标赛机制确定最终目标。视角选择器的训练信号通过两阶段拒绝采样从推理VLM的反馈中生成:首先评估单个视角的证据质量,然后进行成对比较以保留导致正确定位的视角子集。
- 级联物体筛选(COS):利用CLIP文本嵌入和VLM视觉验证,从3D实例分割提案中筛选出少量候选物体。
- 关键视角选择(IVS):训练一个轻量级视角选择器(基于Qwen3-VL-8B,LoRA微调),预测对定位最有判别力的视角子集。
- VLM定位:冻结的推理VLM(Qwen3-VL-32B)基于选定的视角进行成对比较推理,通过锦标赛机制确定最终目标。
- 两阶段拒绝采样:首先评估单个视角的证据质量,然后进行成对比较以保留导致正确定位的视角子集。
- 视角选择器的训练信号通过两阶段拒绝采样从推理VLM的反馈中生成,无需人工视角标注。
- 轻量级视角选择器与冻结推理VLM的解耦设计,仅微调视角选择器即可提升整体定位性能。
逐图理解论文
直觉与失败案例
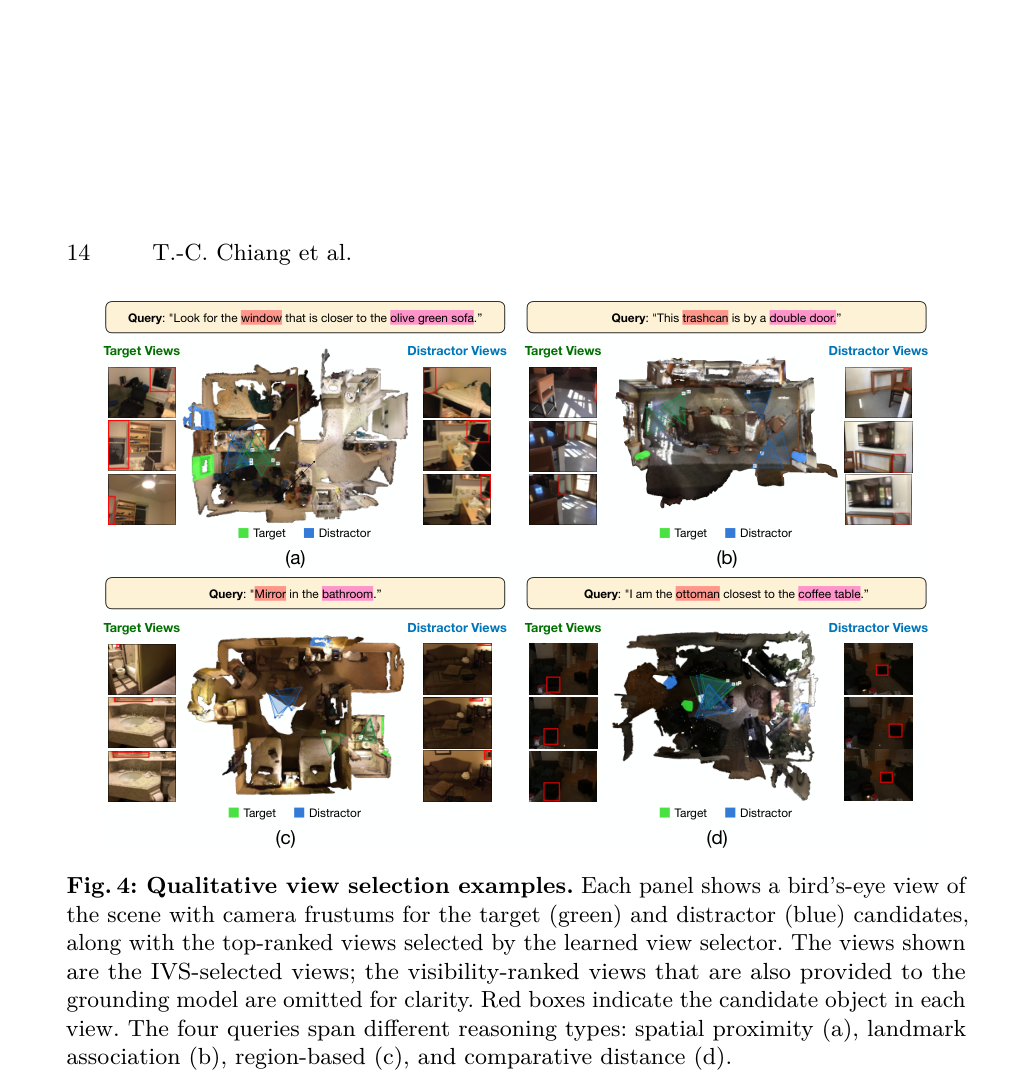
该图展示了定性视角选择示例。需要关注不同推理类型(空间邻近、地标关联、区域基于、比较距离)下视角选择器如何揭示判别性空间线索,这说明了IVS策略的有效性。
核心贡献
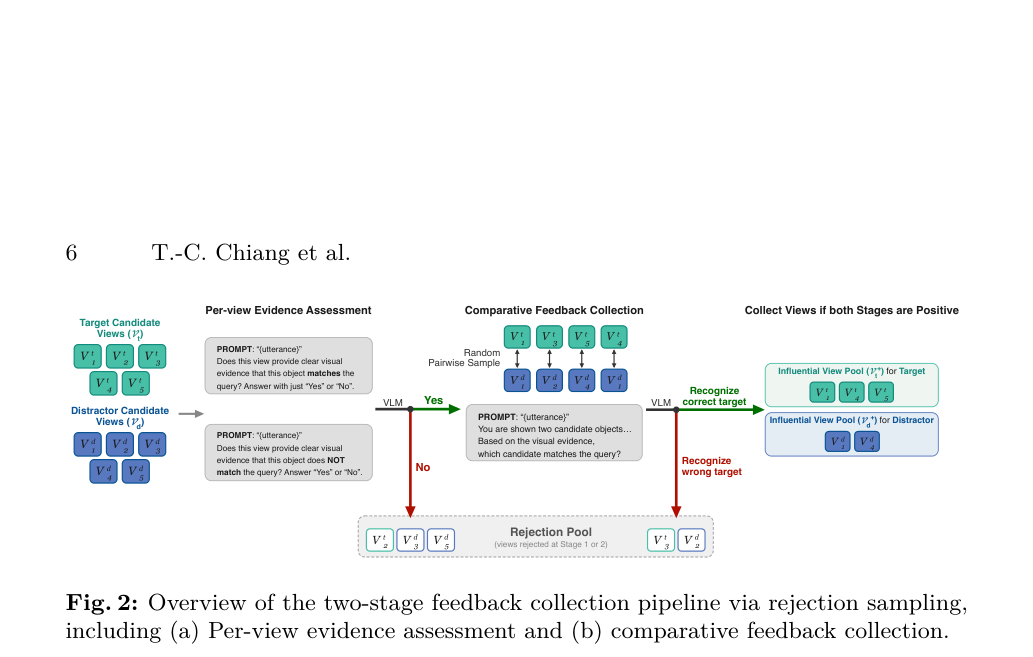
该图展示了两阶段反馈收集流程。需要关注单视角证据评估和成对比较反馈收集的具体步骤,这说明了如何通过拒绝采样从VLM定位结果中生成训练信号,无需人工视角标注。
最强结论
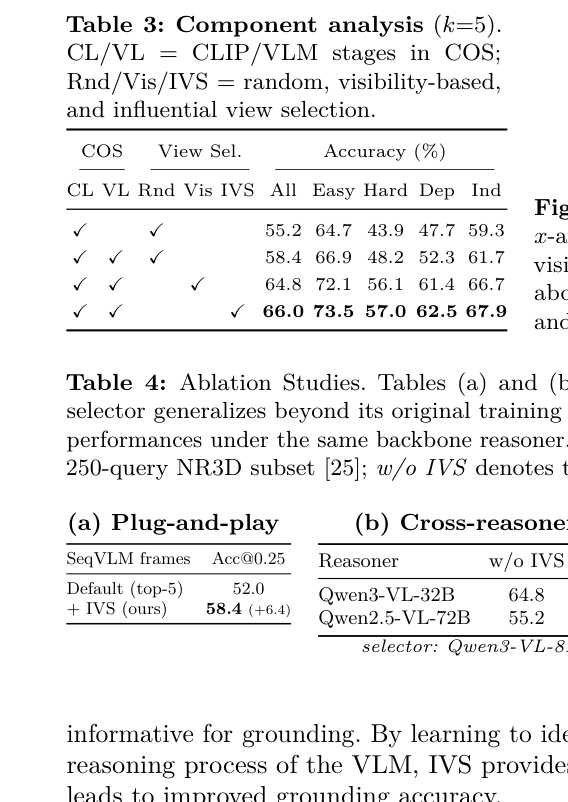
该表展示了组件分析结果。需要关注随机、可见性和IVS视角选择策略的对比,这说明了IVS策略相对于启发式策略的优势。
实验如何设计?
- 在ScanRefer和NR3D基准数据集上与现有零样本和有监督方法进行对比。
- 消融实验分析视角选择策略(随机、可见性、IVS)及级联物体筛选(COS)各组件的影响。
- 验证视角选择器的泛化能力,包括即插即用(Plug-and-play)到SeqVLM、跨推理器迁移(Cross-reasoner transfer)以及相同骨干网络下的对比。
- 分析IVS视角与启发式视角混合比例对性能的影响。
关键结果与论文证据
- 在ScanRefer (VLM-Grounder subset)上,IVSGround的Overall Acc@0.25达到58.0%,优于SPAZER的57.2%和CSVG的49.6%(Page 11)。
- 在NR3D (Full set)上,IVSGround的Overall Accuracy达到62.1%,优于VLM-Grounder的48.0%和SeeGround的46.1%(Page 12)。
- 消融实验显示,IVS视角选择策略在NR3D subset上达到66.0%,优于可见性策略的64.8%(Page 13)。
- IVS-Heuristic Mix实验表明,2个IVS视角与3个启发式视角的混合达到68.8%的准确率,优于纯启发式(64.8%)和纯IVS(63.6%)(Page 13)。
- 即插即用实验显示,将IVS视角选择器应用于SeqVLM,准确率从52.0%提升至58.4%(Page 13)。
- 相同骨干网络对比实验表明,IVSGround在Qwen2.5-VL-72B上达到57.6%,优于SPAZER的56.0%和SeeGround的54.0%(Page 13)。
阅读时需要注意
- 视角选择器的训练依赖于推理VLM的反馈质量,如果推理VLM本身存在偏差,可能影响训练信号的有效性。
- 虽然视角选择器轻量级,但训练过程需要大量的VLM推理调用以生成反馈数据,计算成本较高。
- 实验主要在ScanRefer和NR3D上进行,未在其他3D定位基准或更复杂的动态场景中验证。
关联工作
- SPAZER:对比方法,强调视角选择的重要性,但仅对渲染的3D视角进行选择,未显式选择2D相机视角(Page 3)。
- VLM-Grounder:对比方法,使用图像序列进行定位,依赖启发式视角选择(Page 3)。
- SeeGround:对比方法,渲染查询引导的视角,结合3D空间描述进行定位(Page 3)。
- SeqVLM:对比方法,构建基于投影面积排序的多视角序列,本文验证了IVS视角即插即用替换其视角选择的增益(Page 4)。
- Frame-Voyager:相关工作,在视频领域学习查询感知的帧选择器,本文将其思想迁移至3D视觉定位的视角选择(Page 4)。