快速导读:RYOPO 用查询式 RGB-D 集合预测把检测、分割与 9-DoF 位姿联在同一前向中,共享编码并做物体中心精炼,在 NOCS 上超过已发表联合方法,并以 31.8 FPS 接近两阶段全物体成绩。
类别级物体位姿要给已知类别里没见过的实例预测旋转、平移和米制尺寸,测试时没有该实例 CAD。很多准确的 RGB-D 方法先跑外部分割,再按物体裁剪、编码、回归位姿。阶段一多,延迟就随物体数涨,闭环视觉伺服和操作节拍都会被拖住。RYOPO(Real-Time YOPO,arXiv:2610.03013,PIT IN Co.)把检测、分割和 9-DoF 位姿写进同一个查询式集合预测器,共享整图 RGB 与场景编码,不再为每个物体单独跑裁剪编码器。
方法叠在 DETR 风格的 EdgeCrafter 上:查询条件几何把深度点绑到物体查询,几何反馈把物体观测和一次每图的稀疏三维场景库写回查询,物体中心精炼再维护显式位姿状态做残差修正。NOCS 上相对已发表 RGB-D 联合方法提升明显;REAL275 与 HouseCat6D 的全物体评测里与两阶段方法接近,同时在 RTX A6000 上全帧 31.8 FPS。项目页 https://yopo-series.github.io/RYOPO-project-page/ 。预印本,未同行评审。
英文题目:RYOPO: Bringing End-to-End Category-Level Object Pose Estimation into Real Time
论文出处:arXiv 每日论文精选 · arXiv:2610.03013
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Fig. 1 把张力画成精度–延迟平面。纵轴是 REAL275 全物体 10°5cm AP,横轴是 RTX A6000 上位姿输出时延。绿色菱形 RYOPO 落在约 30 FPS 虚线左侧、约 73.6 AP;CleanPose、AG-Pose 等两阶段点挤在 90–140 ms,精度接近或略低,但都过不了实时线。两阶段慢,是因为 Mask R-CNN 先切实例,位姿网络再对每个作物做点云与图像编码,物体一多就要重复。
联合方法并非空白。CenterSnap 与 ShAPO 在 RGB-D 上同时做位姿和形状,但用 CAD 衍生表示,ShAPO 还有极慢的测试时优化。YOPO 证明查询式集合预测可以不做显式形状监督,可它是 RGB,并行位姿头也不指定每个物体的实测三维该如何改当前位姿。直接把深度早融合进查询解码,深度进了共享特征,却仍没有“按当前位姿去读几何、再残差修正”这条环。RYOPO 要解决的就是:把几何精度写进端到端前向,同时把计算留在共享全帧路径里。
核心创新
- 端到端可训练的查询式 RGB-D 集合预测器,联合检测、分割与 9-DoF 位姿,不用显式 CAD 形状先验,也不用外部分割器。
- 查询条件几何把观测三维点绑到 DETR 风格查询,再与共享场景上下文一起反馈到下一层解码。
- 物体中心精炼维护显式位姿状态,用位姿条件交叉注意预测残差修正,而不是像 YOPO 那样只在图像查询上挂并行位姿头。
方法概览
RYOPO(Real-Time YOPO)建立在 DETR 风格 EdgeCrafter 上,保留共享 RGB 骨干、图像编码器与物体查询解码器,并加上粗位姿头。输入是对齐的 RGB、深度与内参。查询条件几何(A)用当前框与掩膜在图像上采 8×8 格点,按掩膜置信度与局部深度一致性池化出点描述子。几何反馈(B)用这些描述子做物体交叉注意,并用一次每图的稀疏三维卷积场景库做场景交叉注意,支持门在点有效性低时关掉物体反馈。集合解码之后,物体中心精炼(C)把最终查询与粗位姿编码成当前位姿状态,对固定点描述子做位姿条件交叉注意,并按式(5)用轴角复合旋转、尺寸缩放平移与对数尺寸残差迭代三次。训练用位姿感知一对一匈牙利匹配,辅以相机系关键点到规范坐标的辅助损失,无显式 CAD 形状先验,也无测试时梯度优化。
- 输入是 RGB 图像、对齐深度和相机内参。每个物体查询联合预测类别、框、掩膜和位姿 (R, t, s)。骨架的未填充块是 EdgeCrafter:共享 RGB 骨干、图像编码器、物体查询解码器,以及检测、掩膜与粗位姿头。深度用来锚定查询参考和粗平移。图2 的彩色块才是新增:(A) 查询条件几何、(B) 几何反馈、(C) 物体中心位姿精炼。图像与场景编码器每张图只跑一次。
- 模块 (A) 用当前框在归一化全图坐标上铺采样格,并按预测掩膜与有效深度做双线性采样。格点分成 8×8 单元,单元内用掩膜–深度乘积和相对深度指数核做两次加权,池化出相机系三维点、图像特征和支撑量。描述子拼接局部形状、米制偏移、XYZ、外观与视角,供 (B)(C) 使用。模块 (B) 有两支:场景上下文编码器把深度反投影体素化后做稀疏三维卷积,一次得到整图场景库;物体交叉注意把点描述子当作键值,并用点有效性的对数作 softmax 前偏置。支撑门在所有点都不可靠时关掉物体反馈,避免背景把查询带偏。
- 集合解码结束后点描述子固定,模块 (C) 迭代三次。当前位姿(第一层用粗预测,之后用上一层更新)编成 embedding,与查询相加后对点描述子做交叉注意,头输出有界的平移、对数尺寸和轴角增量。旋转用矩阵指数复合,平移按当前尺寸缩放,尺寸在对数域更新,从而保持合法旋转和正尺寸。这些是学习到的前向更新,没有测试时优化。训练用位姿感知匈牙利一对一匹配,监督检测/掩膜、粗位姿与精炼位姿,并用学习到的类别条件查询把观测点聚成相机系关键点、再预测规范坐标;这些查询是参数,不是 CAD 模板。
逐图理解论文
两阶段瓶颈
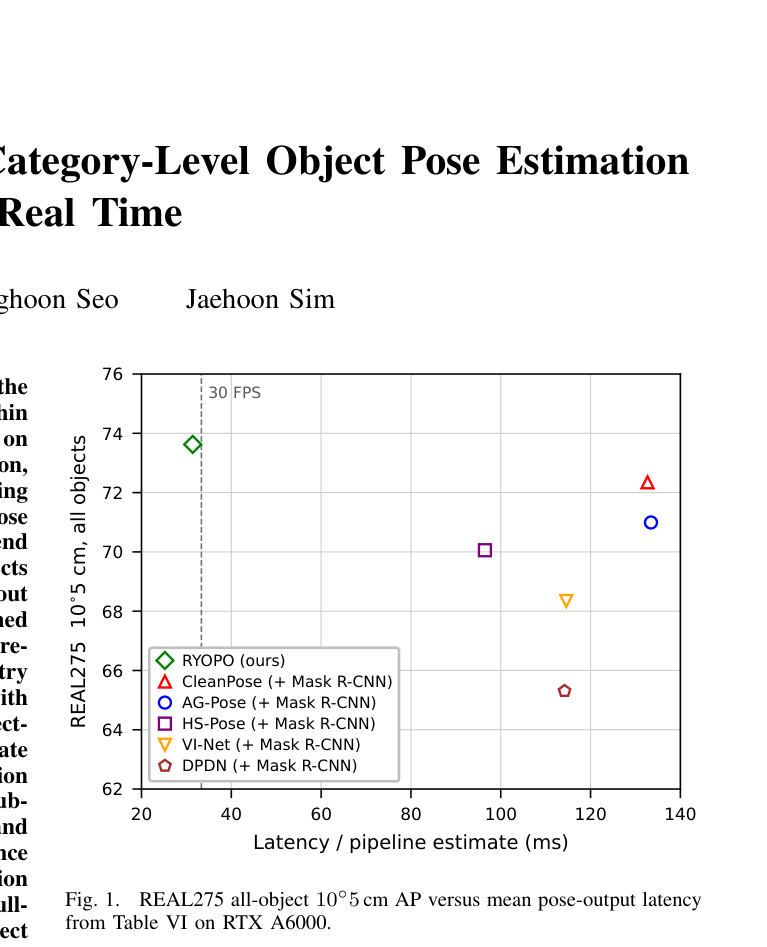
图1是 REAL275 全物体 10°5cm AP 对时延的散点,数据来自 Table VI、RTX A6000。纵轴约 62–76,横轴 20–140 ms,灰色虚线标 30 FPS。绿色菱形 RYOPO 在虚线左侧、约 73.6 AP;红色三角 CleanPose (+ Mask R-CNN) 与蓝色圆 AG-Pose 在约 130 ms、72 附近;紫色方 HS-Pose 约 96 ms、70;橙色三角 VI-Net 与红五边形 DPDN 更靠右下。裁切左侧带入标题残字 Category-Level Object Pose Estimation / Real Time 以及作者名,讲图时忽略。
共享查询骨架
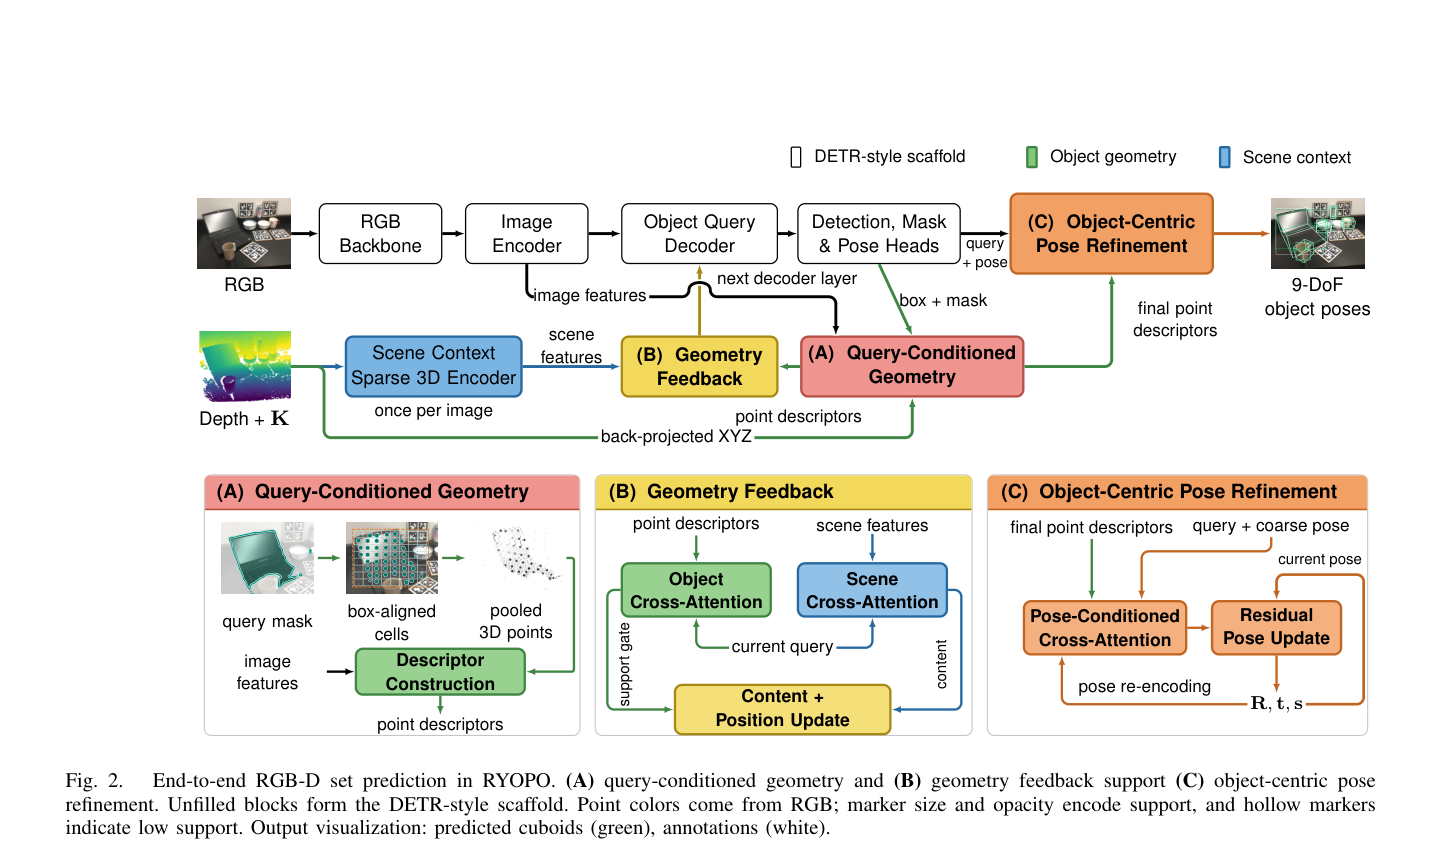
图2是端到端架构,宜作特色图。顶栏从 RGB 经 RGB Backbone、Image Encoder、Object Query Decoder 到 Detection/Mask/Pose Heads,再进橙色 (C) Object-Centric Pose Refinement,输出绿框 9-DoF。深度与内参走蓝色 Scene Context Sparse 3D Encoder,标注 once per image。红色 (A) Query-Conditioned Geometry 吃 back-projected XYZ 与 box+mask,黄色 (B) Geometry Feedback 把点描述子和场景特征送回下一层解码。底部分三块:(A) 由 query mask、box-aligned cells 池化 3D 点并做 Descriptor Construction;(B) Object / Scene Cross-Attention 经 support gate 做 Content + Position Update;(C) Pose-Conditioned Cross-Attention 与 Residual Pose Update 循环,输出 R, t, s。未填充块是 DETR 脚手架。右上可视化:预测立方体绿色,标注白色。
结论与局限
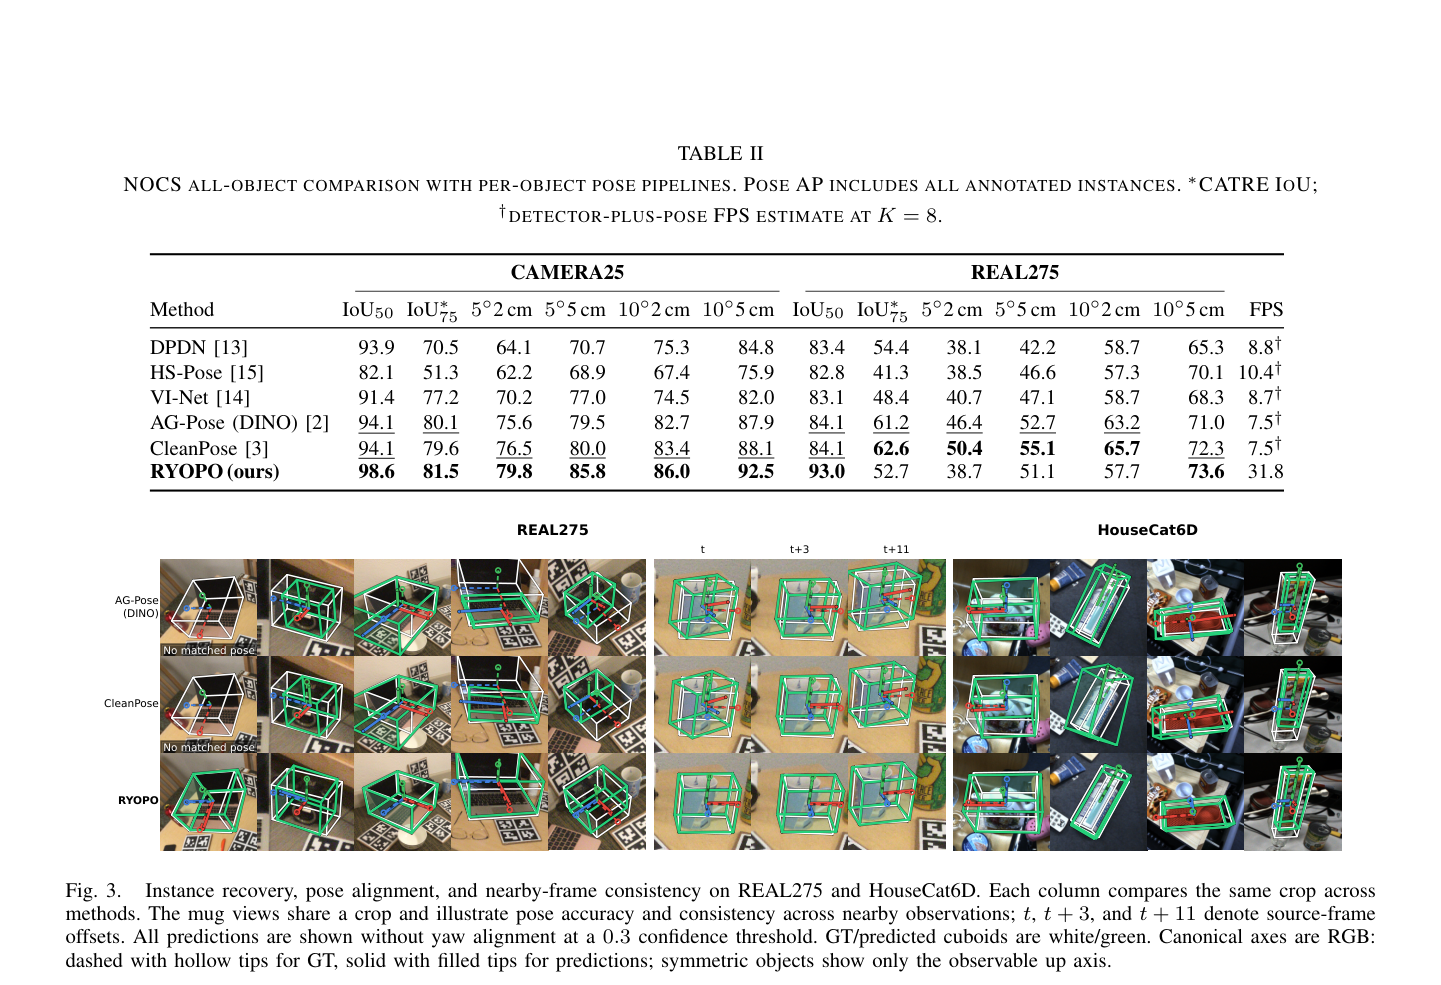
该 PNG 上半是 Table II 全物体数字,下半才是 Fig. 3。REAL275 左列笔记本:AG-Pose 与 CleanPose 写 No matched pose,RYOPO 给出绿立方体。中列马克杯在 t、t+3、t+11 同一裁剪上比朝向,前两行轴方向在邻帧间明显跳,RYOPO 更贴白色 GT。HouseCat6D 列比较瓶子 up 轴/尺度和管状物位置。绿为预测立方体,白为 GT;规范轴 RGB,GT 虚线空心尖、预测实线实心尖;对称物只画可观察 up 轴。阈值 0.3、无偏航对齐。讲定性时不要把 Table II 格子当成画面元素。
实验如何设计?
- 实现用预训练 RGB 骨干的 EdgeCrafter,输入 640×640,150 个查询,四层集合解码、三层位姿精炼,每查询 64 个点描述子,场景体素 5 mm。AdamW,有效 batch 72,混合精度。NOCS 12 个 epoch,每 epoch 把真实图与 38,900 张 CAMERA 图混在一起;HouseCat6D 18 个 epoch。主精度是三次独立训练、训练结束时评估的平均。
- 指标跟 CleanPose:分类别 AP。NOCS 报 CATRE IoU75 与 n°m cm;HouseCat6D 报独立 IoU25/IoU50。全物体协议关掉 0.1 IoU 预过滤,漏检和预处理丢掉的物体仍留在分母里。Table I 对 RYOPO 报 IoU 匹配位姿 AP,以对齐已发表联合结果的评测人口;Table II、III 则在同一注释帧上对所有标注计分。
- 两阶段对照用发布权重,NOCS 上仍吃基准提供的检测与掩膜;HouseCat6D 改成与 RYOPO 相同的检测掩膜,专门比位姿。时延在 RTX A6000、batch 1、50 次热身后,从已解码输入到主机侧位姿;两阶段总时延按 COCO 预训练 Mask R-CNN 加上 K=8 作物位姿网络估计。
关键结果与论文证据
- Table I 里,RYOPO 在 CAMERA25 上 IoU50 / 5°5cm / 10°5cm 为 98.6 / 85.7 / 92.5,REAL275 为 93.0 / 52.5 / 76.8,31.8 FPS,且不用 CAD/先验、也不做测试时优化。相对所列最强联合方法 ShAPO,两个基准的 5°5cm 分别高 19.1 与 3.7 点。这些联合对照包含 ShAPO 的测试时 refinement,但其形状与外观重建不计入本次位姿任务。
- Table II 全物体对照更接近部署口径。CAMERA25 上 RYOPO 在多数列出的 IoU 与位姿阈值领先,5°5cm 85.8、10°5cm 92.5。REAL275 上 10°5cm 73.6 略高于 CleanPose 的 72.3,但 5°5cm 51.1 低于 CleanPose 55.1 与 AG-Pose 52.7,5°2cm 38.7 更明显落后于 50.4 / 46.4。换句话说:全帧实时换来的是中等阈值上的竞争力,不是所有紧阈值都赢。同一 REAL275 预测若改回 IoU 匹配,RYOPO 5°5cm 只掉 1.4 点,两阶段却掉 8.5–12.3,说明漏检/拒识对两阶段分母影响更大。
- HouseCat6D 共享检测时,5°5cm 上 RYOPO 21.5,与 CleanPose 21.1 接近、高于 AG-Pose 17.7,但 IoU50(57.8 vs 66.2)和 10°5cm(43.2 vs 51.2)仍是两阶段更好。消融 Table IV 显示 (A)(B)(C) 要一起用:基础 RGB-D 预测器 5°5cm 只有 32.9,完整模型 51.1;只去精炼是 44.2,只去查询反馈是 37.6。场景 CNN 换成逐点 MLP 会把 5°5cm 打到 36.9,说明需要有空间结构的场景上下文。静态位姿条件与固定锚预测分别降到 48.4 与 44.5,说明关键是反复把后续预测耦合到演化中的位姿状态,而不是“有一个位姿输入”本身。
阅读时需要注意
- 作者在结论里写明:REAL275 上更紧的 2 cm 平移阈值仍是短板,HouseCat6D 的立方体对齐与 10°5cm 也不如 per-object 方法。
- Fig. 3 的马克杯跨帧更稳,但模型并不做跟踪;一致性是单帧重复性,不是时序模型。对称物体只画可观察的 up 轴,不能用来主张规范偏航也准。
- 两阶段 FPS 是估计值;RYOPO 部署相对训练精度最多改 0.14 AP。预印本,正文未给独立训练代码仓库。
关联工作
- YOPO 把集合预测引进 RGB 类别级位姿;RYOPO 保留查询脚手架,把实测几何和显式位姿状态接进去,目标换成实时 RGB-D。
- AG-Pose、CleanPose、DPDN、HS-Pose、VI-Net 代表“分割器加作物位姿网络”的精度路线。RYOPO 用全物体协议和同一延迟平面说明:这条路线可以很快,但紧阈值和部分 IoU 指标仍可能让步。
- CenterSnap/ShAPO/FSD 走联合检测但依赖 CAD 衍生形状或测试时优化。项目页 https://yopo-series.github.io/RYOPO-project-page/ 。