快速导读:OPENWAM 用共享因果机器人视频骨干和可配置 MoT 交互,在同一协议下比较世界-动作耦合,并让局部逆/前向动力学独立复用。
世界-动作模型要把未来观测预测和机器人控制放在同一套系统里,但现有工作往往同时更换视频骨干、交互结构、监督信号和推理流程,结果很难回答一个具体问题:视频和动作究竟应该联合生成、先视频后动作,还是先动作后视频。OPENWAM(arXiv:2610.07922,Stanford University)把这个问题做成可比较的开放框架:先从 Wan2.2-5B 做超过一万小时的无动作标签因果机器人视频预训练,再用 Mixture-of-Transformers 接入动作专家,在共享训练与评测协议下切换四种交互程序。项目页为 https://openwam.stanford.edu ,代码为 https://github.com/OpenWAM/OpenWAM 。预印本尚未同行评审。
同一套因果骨干上,VTA 把 LIBERO-Long 成功率从原始 Wan2.2 初始化的 68.4% 提到 97.8%;四种交互都能在四套 LIBERO 上拿到高成功率。框架还把局部逆/前向动力学写成可替换接口:视觉预测器适配新任务后,冻结的局部 IDM 在反事实监督下四任务均成功率 84.0%,显著高于只看演示的局部模型。正文提醒另有同名 concurrent OpenWAM,问题设定不同。
英文题目:OPENWAM: An Open Framework for Composable World-Action Models
论文出处:arXiv 每日论文精选 · arXiv:2610.07922
原始论文:PDF / 论文页面
这篇论文解决什么问题?
WAM 的第一条挑战是交互方式本身是一组选择,而不是单一结构。视频和动作可以同时去噪、顺序生成,或切断未来跨模态注意力。如果每次换交互都连骨干和数据一起换,就无法把性能差归因于交互。第二条挑战是成功演示只覆盖示范策略选中的动作–结果关系。失败、探索和从同一初态分支出去的反事实转移,本来都能提供局部动力学监督,却很少被用来检验:当视觉预测器换到新任务时,动作接地组件还能不能复用。
作者因此拆出两种组合。架构层面,固定因果视频骨干和目标族,只改未来观测流与动作流如何通信。组件层面,用显式的未来观测轨迹和动作轨迹接口连接独立训练的预测器。后者引出局部上下文动力学:它不消费任务语言和非局部历史,只把当前观测、本体感觉与所供转移联系起来。
核心创新
- 在共享因果机器人视频骨干与评测协议下,用可配置 MoT 比较联合、顺序与解耦的视频–动作交互。
- 把局部上下文逆/前向动力学写成显式轨迹接口,并独立训练。
- 用反事实局部转移扩大动力学覆盖,检验视觉任务适配后动作组件能否复用。
方法概览
从 Wan2.2-5B 出发,在超过 10,000 小时无动作标签的机器人与交互视频上做块因果预训练,再通过 Mixture-of-Transformers 接入动作专家:视频专家约 5B、动作专家约 2B,在打包的视频与动作 token 上做联合注意力,任务文本另走交叉注意力。同一骨干支持四种交互程序——Joint、VTA、ATV、Decoupled——只改生成顺序和未来跨模态注意力,共用流匹配目标。视频按四帧潜变量块、对应 16 步动作块。另外独立训练局部上下文 IDM 与 FDM:前者由当前观测、本体感觉和未来视觉轨迹出动作,后者由动作出未来观测,两者都不看语言、过去动作或更早观测。仿真中从 LIBERO-Long 演示状态分支出替代动作,得到 LIBERO-Long-CF;混合监督按 η=0.6 取 60% 反事实、40% 任务局部转移。推理时任务视频预测器提出未来,冻结 LC-IDM 把 VAE 视频潜变量译成动作。
- 视觉骨干从 Wan2.2-5B 继续在异构机器人与交互视频上预训练,数据包括 UMI/MV-UMI、AgiBot World、RoboMIND、InternData-A1、RoboCOIN、FastUMI、Ego-Exo4D 与 Open X-Embodiment,此阶段没有动作标签。因为原视频模型不是时间因果的,预训练引入块因果:未来块可以看当前及更早观测和已生成块,不能看更晚块;块内仍联合处理。因果性与跨模态交互是分开的设计轴。
- 图2给出共享 MoT。视频专家约 5B、动作专家约 2B,各保留归一化、投影和前馈,在打包的视频与动作 token 上做一次联合注意力;任务文本经单独交叉注意力进入两路。带噪未来 token 从底部进入,更早块作为 History Context。四种程序只改注意力掩码与生成遍数,如图3:Joint 让未来视频和动作的带噪 token 双向注意;VTA 先预测未来视频(看不见未来动作),再以该轨迹条件生成动作;ATV 顺序相反;Decoupled 预测两模态但不做未来跨模态注意。训练用教师强制,推理时第二遍条件来自第一遍的生成轨迹。两路都用潜变量流匹配,视频与动作噪声位移不同。
- 局部 IDM 定义为 p(A+|O+,O0,q),局部 FDM 为 p(O+|A+,O0,q),都不看语言、过去动作或 t 之前的观测。为扩大转移覆盖,作者在仿真里恢复 LIBERO-Long 演示中的状态,执行替代未来动作,得到共享初态、不同后果的 LIBERO-Long-CF。混合监督 Ddyn=(1−η)Dtask+ηDcf,实验 η=0.6。组合推理时,任务条件视频预测器采样未来,冻结 LC-IDM 只接收生成的 VAE 视频潜变量、当前观测和本体感觉,不传递 Transformer 隐状态。互补地,动作生成器可与 LC-FDM 组合以预测候选动作的视觉后果。
逐图理解论文
设计纠缠
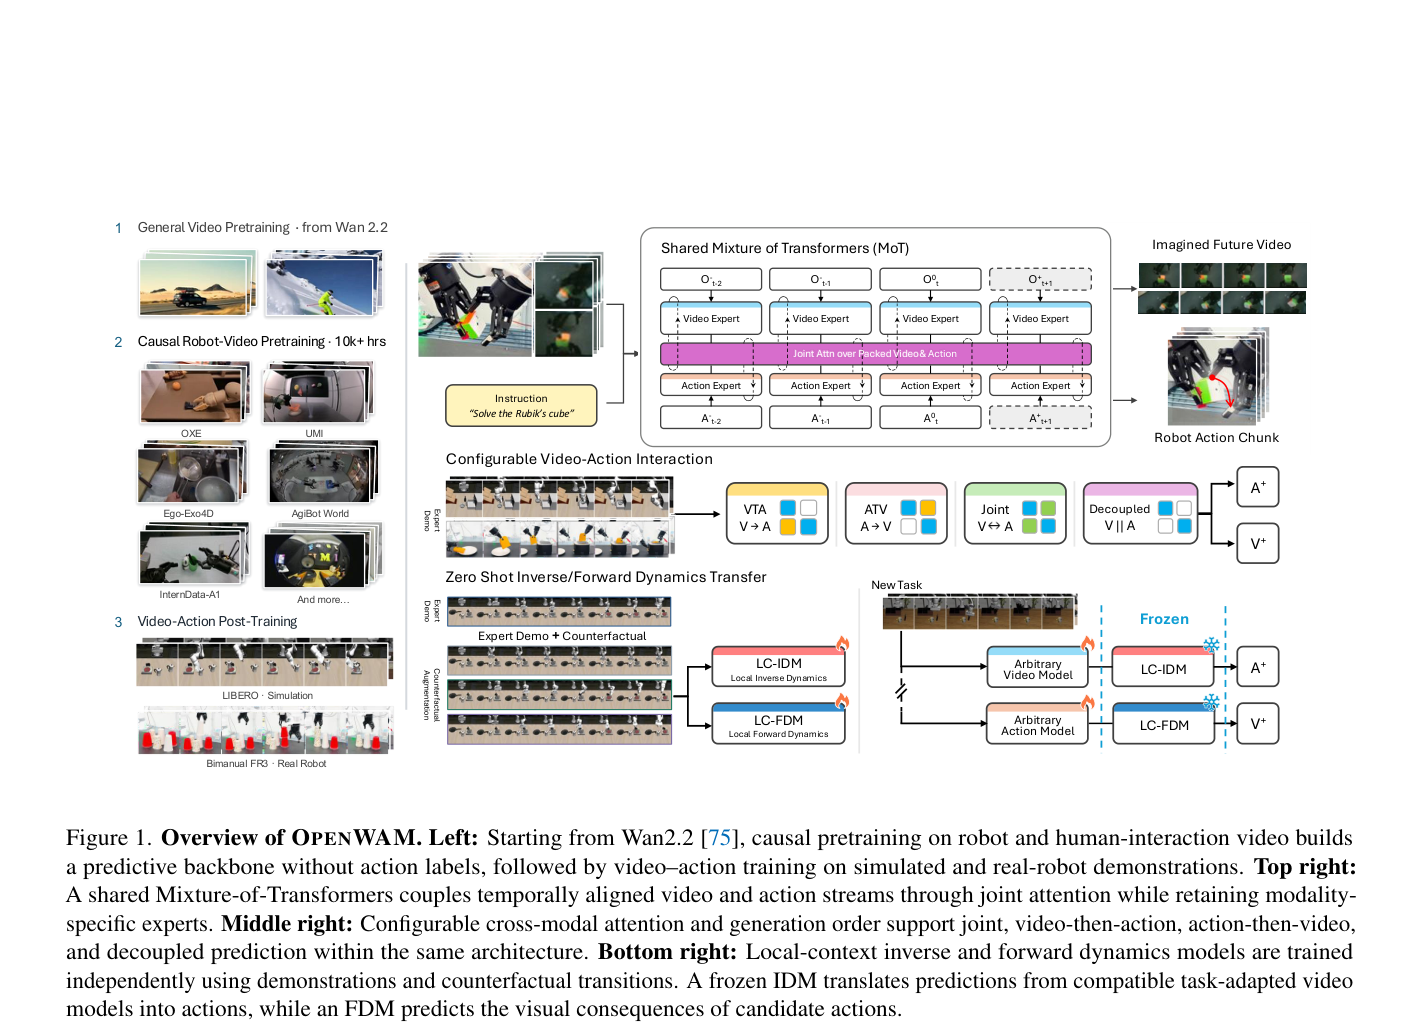
图1是框架总览,宜作特色图。左侧三步:1 General Video Pretraining from Wan 2.2;2 Causal Robot-Video Pretraining 10k+ hrs,数据块标 OXE、UMI、Ego-Exo4D、AgiBot World、InternData-A1;3 Video-Action Post-Training,含 LIBERO Simulation 与 Bimanual FR3。中上 Shared Mixture of Transformers:Video Expert 与 Action Expert 经紫色 Joint Attn over Packed Video & Action 对齐,指令示例 Solve the Rubik’s cube,右出 Imagined Future Video 与 Robot Action Chunk。中右 Configurable Video-Action Interaction 四色块:VTA V→A、ATV A→V、Joint V↔A、Decoupled V||A。下右 Zero Shot Inverse/Forward Dynamics Transfer:Expert Demo + Counterfactual 训练 LC-IDM 与 LC-FDM,新任务上 Arbitrary Video/Action Model 接冻结的局部动力学得到 A+ 或 V+。
共享 MoT
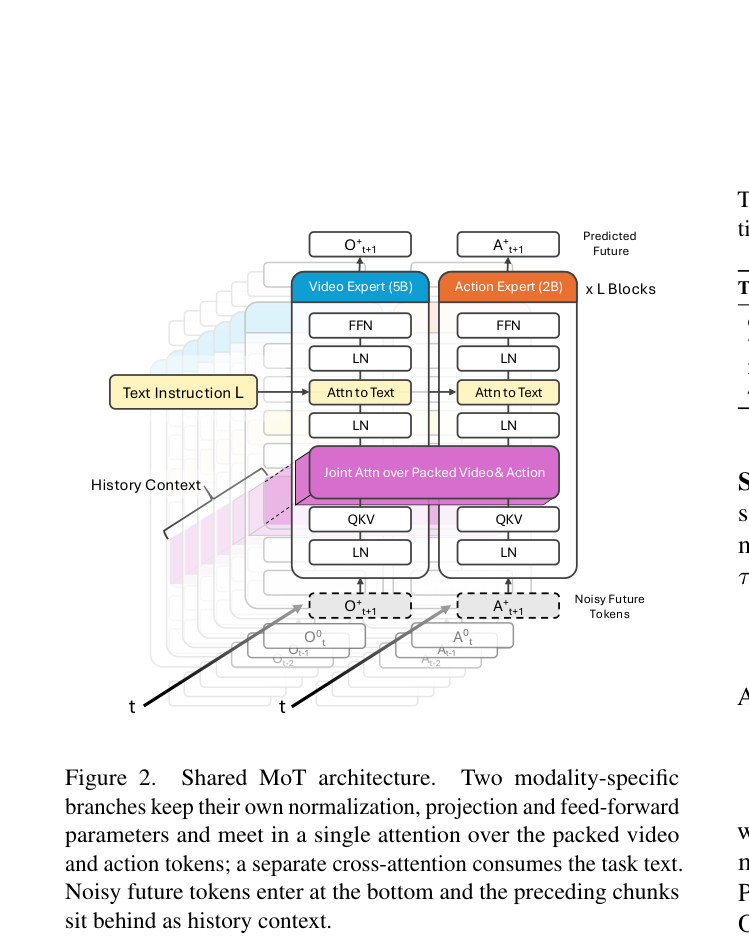
图2是共享 MoT 结构。左黄框 Text Instruction L 进入两路 Attn to Text。中间左右柱分别为蓝色 Video Expert (5B) 与橙色 Action Expert (2B),各含 LN、QKV、FFN,重复 x L Blocks。紫色横条 Joint Attn over Packed Video & Action 是唯一跨模态会合。底部虚线 O⁺_{t+1} 与 A⁺_{t+1} 为 Noisy Future Tokens,更早的 O⁰_t、O_{t-1} 与对应动作块沿时间轴 t 叠成 History Context。右侧页面残留 Table 1 文字,讲图时忽略。
可配置交互
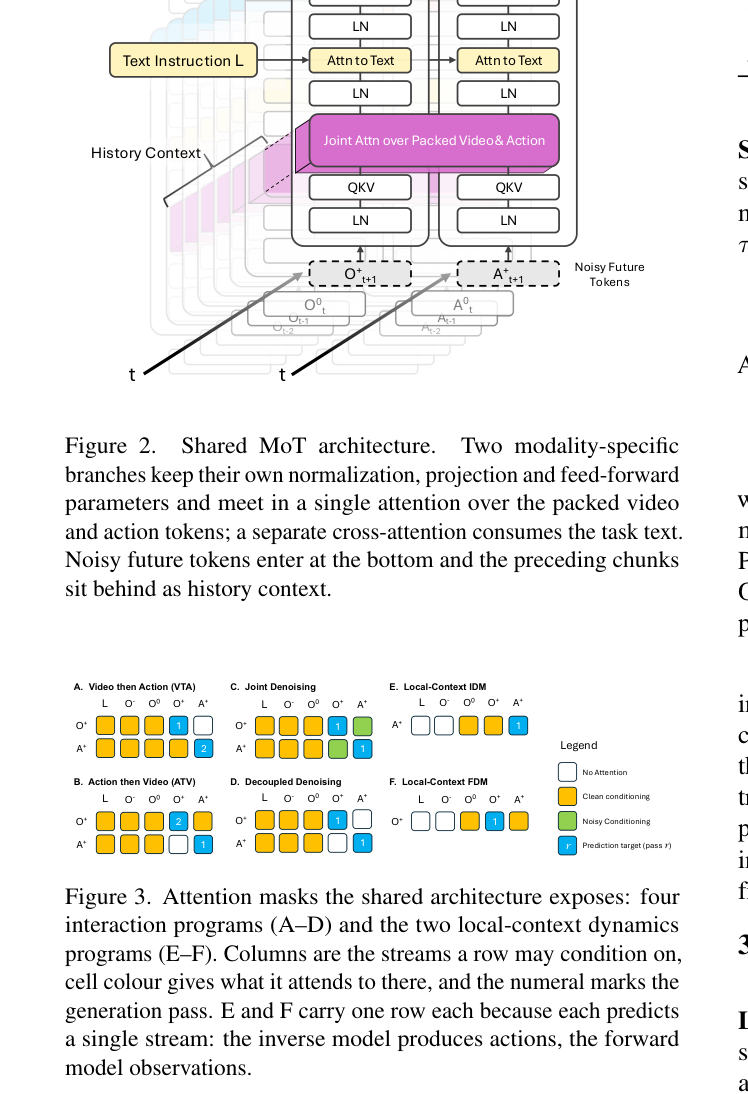
图3是四种交互与两种局部动力学的注意力掩码。文件上半仍露出图2 的 MoT,有效内容是下半六张色块图。列均为 L、O⁻、O⁰、O⁺、A⁺。A. VTA:O⁺ 第一遍预测,A⁺ 第二遍且可看 O⁺。B. ATV:A⁺ 第一遍,O⁺ 第二遍看 A⁺。C. Joint Denoising:O⁺ 与 A⁺ 都在第一遍,绿色表示对未来跨模态带噪条件。D. Decoupled:两路第一遍预测,未来跨模态为白格无注意。E. Local-Context IDM 只预测 A⁺,不看 L 与 O⁻。F. Local-Context FDM 只预测 O⁺。图例:白无注意、黄干净条件、绿带噪条件、蓝预测目标。
实验如何设计?
- 原生策略在 LIBERO-Object/Goal/Spatial/Long 上评 Joint、VTA、ATV、Decoupled,成功率对三个随机种子取平均。视频以四帧潜变量块预测 16 步动作块,动作含末端位置、轴角旋转和夹爪。训练两阶段:因果机器人视频预训练,再在目标套件上做视频–动作训练。骨干消融固定 VTA 结构、任务监督和下游配方,只换 Wan2.2-5B 与因果机器人视频初始化。
- 真实评测用两台 Franka Research 3、平行夹爪和三路 RGB(两腕一第三人称)。三个任务见表2/图4:Toast Bread 测可变形插入,Rubik’s Cube 测接触丰富的推转,Sort Cups 测可变排序。组件迁移用 LIBERO-Long 作源分布,四个 LIBERO-90 目标(任务 64/74/21/45)分别对应新技能组合、熟悉操作重定向、物体与抓取变化、额外场景布局偏移,且都在 Long 源任务集之外。前向动力学在十个 LIBERO 任务、160 个上下文、每上下文 16 条动作分支共 2,560 条反事实未来上评 RGB MSE 与 K=2/K=16 结果辨识。
关键结果与论文证据
- Table 3 上四种 OPENWAM 配置都强:VTA 均值 98.6,Decoupled 98.0,Joint 97.6,ATV 96.8,与 LingBot-VA 98.5、Motus 97.7 同一量级。作者据此认为共享基础能支撑多种生成顺序,而不是只认一种专用策略。固定 VTA 时,原始 Wan2.2-5B 在 LIBERO-Long 为 68.4%,因果机器人视频预训练后到 97.8%(+29.4 点);该对比是预训练与因果适配的合效果,不能拆开归因。真实双臂上 VTA 均值 92.1,Joint 91.9。
- Table 5 显示监督覆盖与条件范围强交互。任务微调 VTA 作参考均成功率 93.0%。把源训练 IDM 冻结、只换目标视频预测器时:局部仅演示 21.5%,全上下文仅演示 44.5%,全上下文混合只到 47.0%;局部仅反事实 84.5%,局部混合 84.0%。全上下文 IDM 在任务 21 与 45 上接近 0%,局部反事实/混合在四个目标上都有效。Table 6 上,局部混合 IDM 在源任务仍有 94.4%,说明扩大转移覆盖并不以牺牲源任务为代价;局部仅演示源任务只有 25.8%,说明没有语言和非局部历史时,演示覆盖不够。
- Table 7 中,仅反事实相对仅演示把 RGB MSE 从 14.35 降到 9.40(×10⁻³,降 34.5%),K=2 辨识 68.3%→93.6%,K=16 从 21.1% 到 71.3%。混合监督接近(9.62、91.8%、67.7%)。更宽的局部转移既改善像素预测,也让模型分得清同一状态下不同动作导致的未来。
阅读时需要注意
- 讨论写明:可组合性主要在仿真成立,真实机器人上还需要更数据高效的物理动力学监督。目标任务实验会适配视频预测器,因此不是完整 WAM 的零样本迁移。附录 E 显示策略、IDM、FDM 可联合训练,但尚未证明单一多目标检查点能在所有模式追上最强专用变体。FDM 研究偏局部短时程。
- LIBERO 表中其他方法是引用数字。图3 文件顶部残留图2 结构,注意力掩码以 A–F 色块为准。预印本未同行评审。
关联工作
- 视觉预见加模型预测控制是早期把预测接到操作上的路线;后来的动作条件世界模型把预测用于仿真、候选评估和自验证规划。联合生成、视频优先因果、以及分路交叉连接是近年 WAM 的三条结构。UniPi 把视频规划与逆动力学分开,Fail2Progress 针对失败收集数据;OPENWAM 问的是转移覆盖和条件范围如何影响视觉适配之后的组件复用。
- UWM/UVA 在一个系统里暴露多种预测与控制模式。本文把交互程序做成同一 MoT 上的注意力掩码,并把 IDM/FDM 留在显式轨迹接口上,以便冻结复用。并发的同名 OpenWAM 做模块化预训练与设计研究,互补而不等同。