快速导读:VLA-ACL 在冻结视觉语言动作骨干上训练轻量 patch 打分器,让剪枝后的动作跟上全上下文教师,从而大幅丢掉视觉 token。
视觉语言动作模型每一步都要把多相机画面编成很长的视觉 token,再和语言、本体感觉一起送进大语言模型。算力和时延因此卡住实时控制。VLA-ACL(Action Consistency Learning,arXiv:2610.08133,ETH Zurich 与清华大学)不微调原策略,只训练一个轻量 patch 打分器:剪过的视觉上下文吐出的动作,要跟上同一冻结模型在全视觉上下文上的教师动作,并用示范动作做辅助。摘要写 Code available;仓库 https://github.com/du-owen/VLA-ACL 可以打开,但公开页面未见完整实现说明,下文不当成已可复现的代码发布。
推理时每视图只保留分数最高的 K 个 token,被丢掉的 token 永不进入语言骨干。LIBERO 上 K=32 可剪掉约 87.5% 视觉 token、把语言模型计算降到约 25%,平均成功率相对 OpenVLA-OFT 只少 1.4 个百分点;K=64 时平均成功率反而到 97.0%。实体四任务上平均 72.5% 对 73.75%,时延约 1.5 倍提升。预印本尚未同行评审。
英文题目:VLA-ACL: Action-Consistent Visual Token Pruning for Efficient Vision-Language-Action Models
论文出处:arXiv 每日论文精选 · arXiv:2610.08133
原始论文:PDF / 论文页面
这篇论文解决什么问题?
OpenVLA 和 π 系列已经能把预训练视觉语言表示接到机器人动作。OpenVLA-OFT 进一步用并行解码一次吐出一串动作,但观察里的视觉 patch 仍占输入序列的大部分。每步都过一遍大语言模型,控制频率上不去。
加速路线里,视觉 token 剪枝最直接,因为视觉冗余高,中等比例随机丢 token 策略也能忍。现有做法分成两路。训练免费方法冻住 VLA,用注意力大小、特征变化或末端速度等启发式挑选,常常还要按层或按时刻改保留率,并读取内部注意力;这与 FlashAttention、编译图推理冲突,高剪枝率下也容易垮。训练式方法如 LightVLA、Grid-S 把选择器和骨干一起更新,效果好,但多卡微调贵,得到的检查点还和特定剪枝机制绑在一起。作者把问题收成:能不能根据下游动作来学视觉选择,同时把原 VLA 完全冻住。
核心创新
- 用动作级一致性加示范辅助来监督视觉 token 选择,而不是注意力或运动启发式。
- 软 Top-K 加全黑图门控提供可微训练替代,缩小与推理硬剪枝的差距。
- 骨干完全冻结、选择发生在语言模型之前,可与 FlashAttention 等加速兼容,训练只需轻量打分器。
方法概览
冻结视觉编码器 E 与语言骨干。五层双向 Transformer 打分器 P 给各视觉嵌入打 logit。多视图时联合编码、按视图独立剪枝,每视图预算为 K。推理做硬 Top-K,保留原 RoPE 位置,丢弃 token 永不进入语言模型。训练用软 Top-K:Lap 累积分布把 logit 映射为和为 K 的分数 s,α 从 2.0 余弦退火到 0.1。门控为 Xi˜ = Xi si + bi √(1-si²),bi 是同一规范化下全黑图的编码器嵌入。软剪枝上下文与全上下文分别过冻结 LLM,得到 ã 与教师 a,损失 Lacl=λ||ã−a||1+μ||ã−agt||1,默认 λ=μ=0.5。只更新打分器,单卡数小时。LIBERO 每视图 256 token,K=32/64 对应剪枝约 87.5%/75%。
- 记冻结视觉编码器为 E。单视图图像得到 Ne×d 的嵌入 X;打分器 P 输出 logit 向量 l。多视图时 P 看拼接后的全部嵌入,但剪枝和门控按视图独立执行,每视图预算都是 K。LIBERO 用两个相机、每视图 256 个视觉 token;部分实体任务加静立相机变成三视图。
- 推理是硬 Top-K:按 logit 排序留下前 K 个嵌入,保留这些 token 在原序列中的 RoPE 下标,再和本体感觉 η、语言指令 π 一起进冻结 LLM 得到动作。被丢 token 不参与计算。K 是唯一控制保留量的超参,每个控制步都用同一 K,不需要时间控制器,也不在序列中途回退到全上下文。
- 硬 Top-K 对 logit 几乎处处梯度为零,所以训练改用软 Top-K。算子 SK 找阈值 θK,使选择质量之和等于 K,并用拉普拉斯累积分布把每个 logit 变成 [0,1] 分数。α 控制软硬程度,训练 5000 步里从 2.0 余弦退火到 0.1,逐渐逼近二进制 Top-K。门控不把 token 从序列里删掉,而是混合原嵌入与全黑图嵌入:Xi˜ = Xi si + bi √(1-si²)。si 接近 1 时保留原 patch,接近 0 时整块换成黑图嵌入,从而留在冻结骨干见过的嵌入分布里,而不是零向量或高斯噪声。
- 全上下文 X 和软剪枝 X˜ 分别过同一冻结 LLM,得到教师动作 a 与 ã。损失为 λ 倍的 ã 对 a 的 L1,加上 μ 倍的 ã 对示范 agt 的 L1,默认各 0.5。梯度穿过冻结 VLA 和可微门控,只更新打分器。打分器是五层双向 Transformer;AdamW、学习率 1×10⁻⁴、批大小 8。作者强调固定预算 K 直接对应推理剪枝率,不必再调 ℓ1 稀疏系数。
逐图理解论文
现有缺口
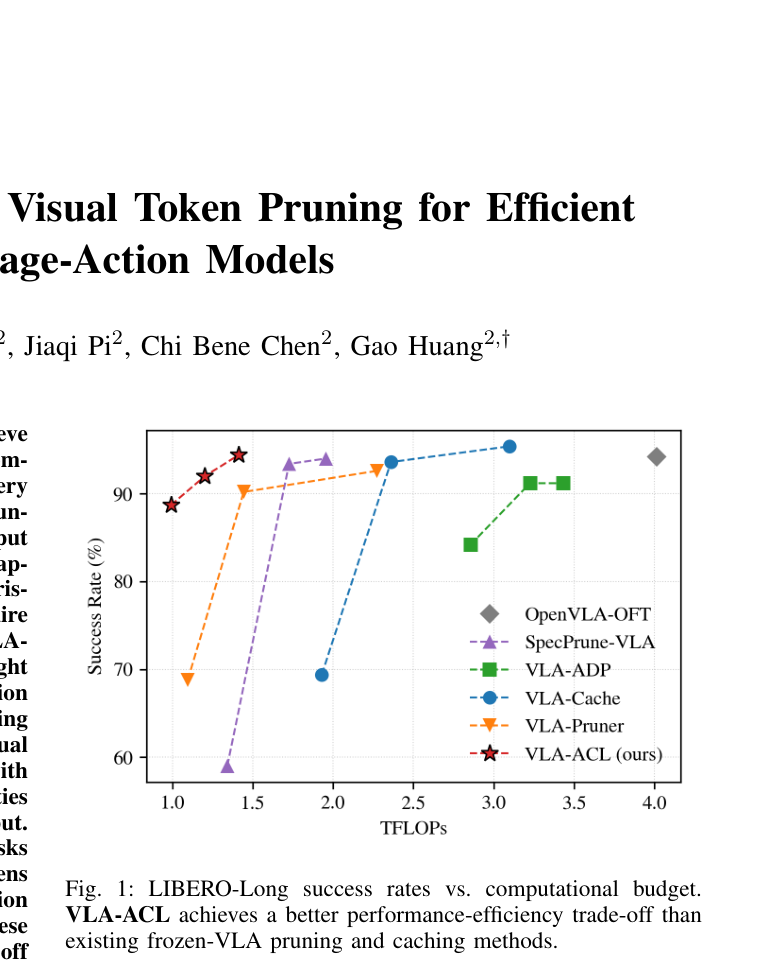
图1是 LIBERO-Long 成功率对 TFLOPs 的折衷曲线,裁切自首页右栏,左侧栏文和标题前半被切掉。横轴约 1.0–4.0 TFLOPs,纵轴约 58–96% Success Rate。红星 VLA-ACL (ours) 落在最左侧约 1.0–1.4 TFLOPs,成功率接近 90% 以上;橙三角 VLA-Pruner 从约 70% 爬到 90% 出头;紫三角 SpecPrune-VLA 在约 1.4 TFLOPs 附近有一处低于 60% 的点;蓝点 VLA-Cache 约 2.0–3.1 TFLOPs;绿方 VLA-ADP 约 2.8–3.5 TFLOPs;灰菱形 OpenVLA-OFT 约 4.0 TFLOPs。曲线只作趋势,精确数字以 Table I 为准。
动作一致性
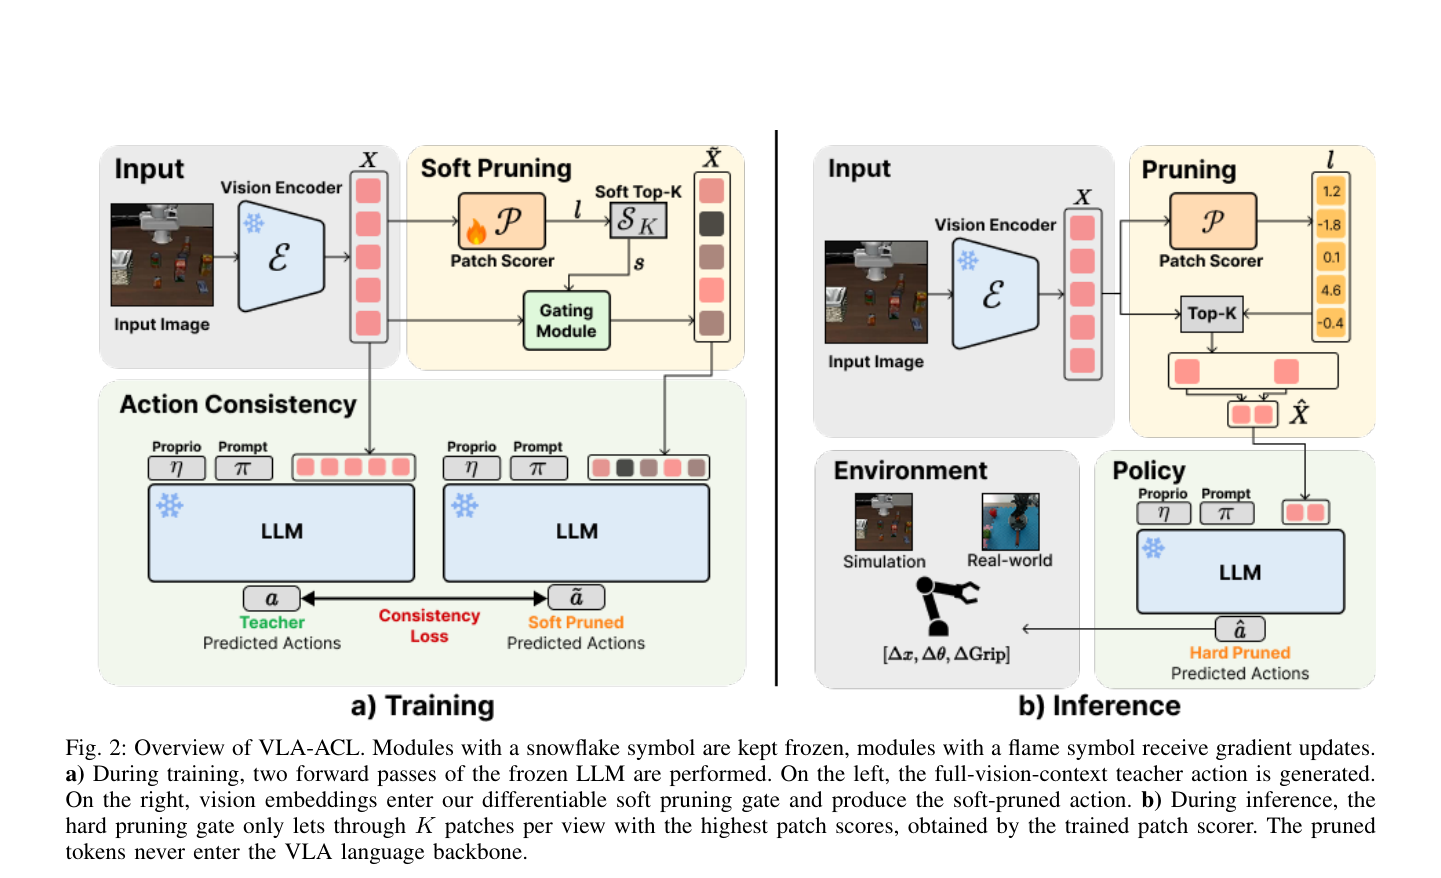
图2是方法总览,宜作特色图。左侧 a) Training:输入桌面操作图经冻结视觉编码器 E 得到粉红 patch 序列 X,进入带火焰的 Patch Scorer P,经 Soft Top-K 与 Gating Module 得到软剪枝序列 X̂。下方两个冻结 LLM 分别吃全上下文和软剪枝上下文,输出 Teacher Actions a 与 Soft Pruned ã,中间红字 Consistency Loss。右侧 b) Inference:同一打分器改硬 Top-K,示意图里 logit 为 1.2、−1.8、0.1、4.6、−0.4,只留下高分粉红块。Policy 侧冻结 LLM 输出 Hard Pruned â,动作为 [Δx, Δθ, ΔGrip];Environment 框画仿真与真实机器人。雪花表示冻结,火焰表示只更新打分器。
关键证据
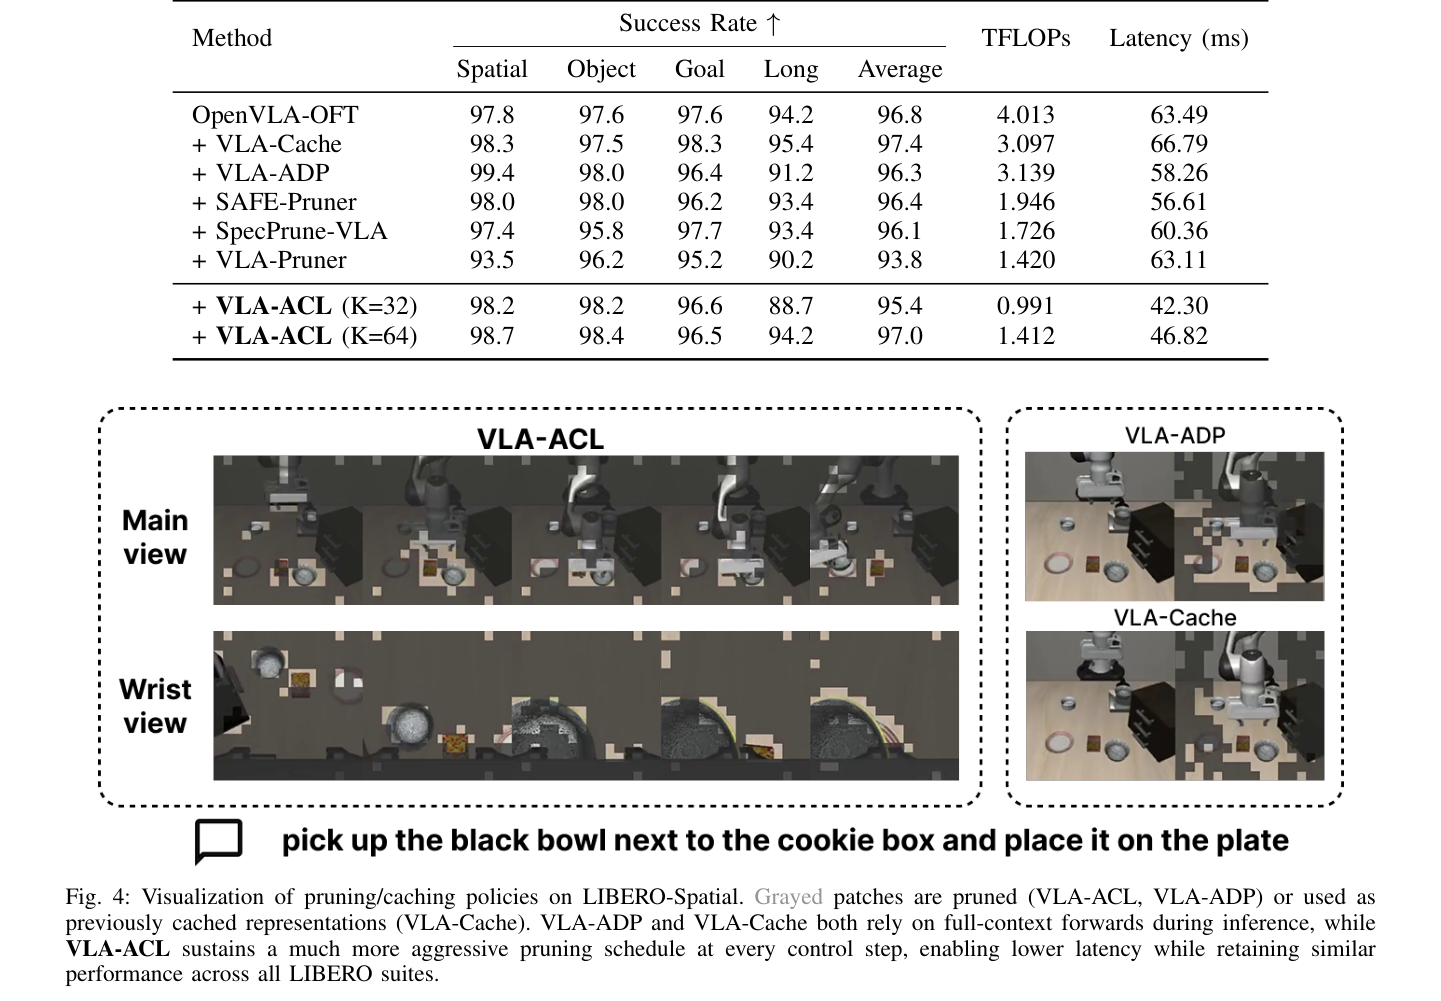
这张 PNG 上半是 Table I,下半才是 Fig. 4 可视化。表中 OpenVLA-OFT 平均 96.8% / 4.013 TFLOPs / 63.49 ms;VLA-ACL K=32 为 95.4% / 0.991 / 42.30,K=64 为 97.0% / 1.412 / 46.82。下半虚线框里,VLA-ACL 的 Main view 与 Wrist view 序列大量灰块表示被剪掉的 patch;右侧较小框是 VLA-ADP 与 VLA-Cache。底部指令为 pick up the black bowl next to the cookie box and place it on the plate。灰块在 VLA-ACL/VLA-ADP 表示剪枝,在 VLA-Cache 表示沿用缓存表征。VLA-ACL 从每步、含第一帧起都按固定 K 剪。
结论与局限
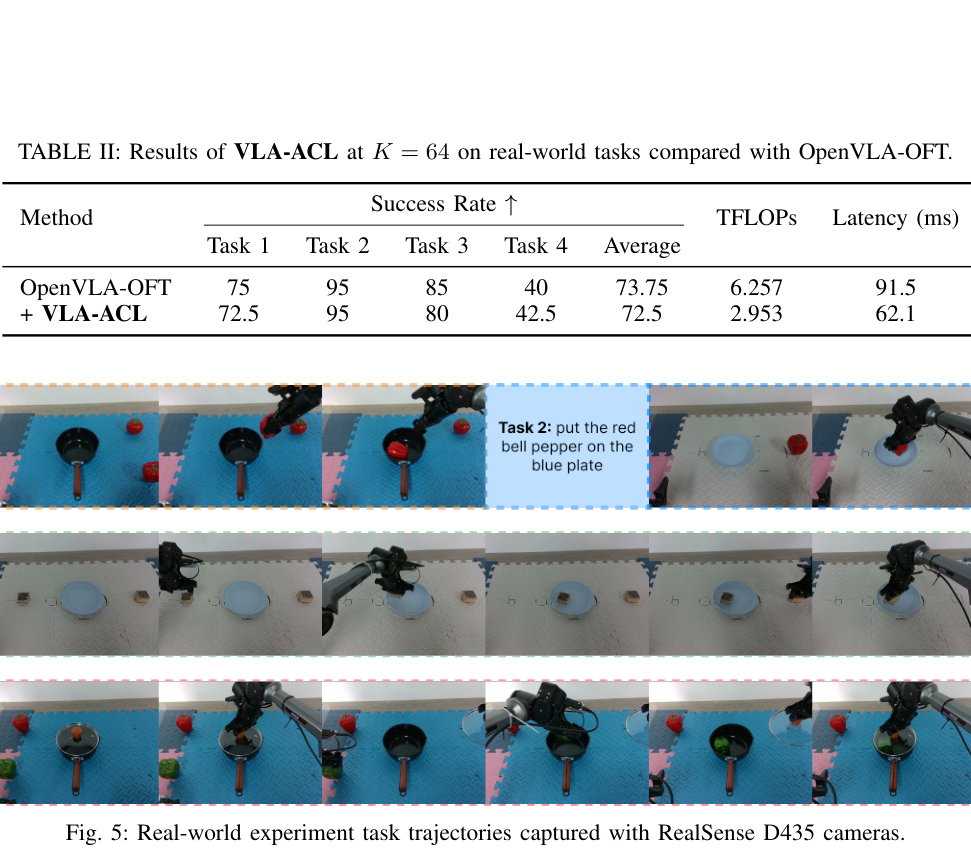
PNG 上半是 Table II:OpenVLA-OFT 四任务 75/95/85/40、平均 73.75%、6.257 TFLOPs、91.5 ms;+VLA-ACL 为 72.5/95/80/42.5、平均 72.5%、2.953 TFLOPs、62.1 ms。下半 Fig. 5 用 RealSense D435 拍实体轨迹。上排橙框含蓝底卡片 Task 2: put the red bell pepper on the blue plate,机械臂把红椒放入平底锅再放到白盘;中排青框是白盘与木块的抓放;下排红框是揭锅盖、夹绿椒、再盖回。说明实体评测覆盖抓放、空间和长程组合,而不是只看仿真表。
实验如何设计?
- 仿真评 LIBERO 的 Spatial、Object、Goal、Long。设定与 OpenVLA-OFT 一致,每步预测连续 8 个动作。VLA-ACL 成功率按三随机种子、每任务 50 次试验平均,每个套件 1500 条回合。对照限于冻结原 VLA 的剪枝或缓存方法;基线成功率引自原论文。TFLOPs 与时延按 VLA-Cache 的协议量语言模型,设备为单卡 NVIDIA A100。
- 实体平台是 ALOHA 风格双臂 AgileX PiPER-X,主相机加左右腕 RealSense D435。按 OpenVLA-OFT 实体协议,动作块长度 25,对应约一秒执行。四任务各 50–100 条专家示范。任务 1、4 测指令跟随与精细感知,任务 4 还有揭盖、夹菜、盖回等多子步;物体位置和对应指令分 4 种配置。任务 2、3 测空间与目标,用三视图和双臂,其余任务两视图、只用右臂。任务 1/4 每配置 10 次共 40 次,任务 2/3 各 20 次。评测取 K=64。
- 消融在 OpenVLA-OFT 上进行,覆盖损失里要不要教师/示范、注意力启发式加不加原序列 RoPE,以及黑图门控对噪声门控和纯乘法门控。附录把同一 λ、μ、α 日程和学习率打到 π0.5:因为该骨干用流匹配,一致性改在同一噪声水平上比较速度预测,并在四个套件上共用一个打分器。
关键结果与论文证据
- Table I:OpenVLA-OFT 平均 96.8%、4.013 TFLOPs、63.49 ms。VLA-ACL 在 K=32 时平均 95.4%、0.991 TFLOPs、42.30 ms,计算约降 75%、速度约 1.5 倍,平均成功率少 1.4 个百分点,缺口主要在 Long 的 88.7% 对 94.2%。K=64 时平均 97.0%、1.412 TFLOPs、46.82 ms,Long 回到 94.2%,平均甚至略超全上下文 0.2 个百分点。同表里 VLA-Cache 平均 97.4% 但 3.097 TFLOPs、时延 66.79 ms,比未加速骨干还慢;作者将其归咎于动态缓存与融合注意力不兼容。VLA-ACL 的 Pareto 位置也画在图1:红星落在约 1.0–1.4 TFLOPs、成功率接近 90% 以上的左上侧。
- 图4把 Table I 和 LIBERO-Spatial 可视化裁在同一张 PNG 里。任务是 pick up the black bowl next to the cookie box and place it on the plate。VLA-ACL 在主视图和腕部视图上每步都灰掉大量 patch;对照的 VLA-ADP、VLA-Cache 仍依赖推理期全上下文前向。作者据此强调:自己的策略从第一帧起就按固定 K 剪,所以时延更稳。
- Table II 与图5给出实体结果。OpenVLA-OFT 四任务 75 / 95 / 85 / 40,平均 73.75%,6.257 TFLOPs,91.5 ms;VLA-ACL 为 72.5 / 95 / 80 / 42.5,平均 72.5%,2.953 TFLOPs,62.1 ms。简单抓放接近饱和,精细感知和长程组合仍难。图5高亮 Task 2:把红甜椒放到蓝盘子上,并给出揭盖炒菜类轨迹。附录 Table V 上,π0.5 加 VLA-ACL(K=64)平均 96.1%、0.701 TFLOPs、预填充 11.6 ms,相对未剪枝 96.9% / 2.115 TFLOPs / 25.9 ms;相对 SAFE-Pruner 的 95.5% / 1.482 TFLOPs,成功率略高、计算不到一半。
- 消融方面,Table III 显示教师加示范最好:K=64 为 97.0%,只教师 96.4%,只示范 95.9%。图6还显示剪枝动作有时比教师更靠近示范。Table IV 在同等 K 下,纯文本-视觉注意力在 Long 上可掉到约 3.2%;加上原序列 RoPE 后平均回到 89.5%(K=32)和 95.5%(K=64),仍低于 VLA-ACL 的 95.4% 与 97.0%。图7显示黑图门控的软硬动作 L1 低于噪声门控和纯乘法门控,说明训练替代更接近推理硬剪枝。
阅读时需要注意
- 极端预算 K=32 明显伤害长程套件,说明动作一致性不能无限补偿丢失的视觉上下文。实体侧任务 1、4 的失败模式与全上下文骨干相似,剪枝不是感知或长程规划的补丁。
- 打分器学的是冻结教师的动作归因。若教师本身偏,示范项可以拉一把,但无法改骨干。π0.5 实验虽然说明超参可迁移,仍是同一套 LIBERO 与同一套训练预算。
- 效率只报告语言模型 TFLOPs 与时延,测在 A100 上;缓存类基线的时延因其实现不可公开而无法在 π0.5 上复测。仓库页面目前不能当作完整开源复现包。预印本未同行评审。
关联工作
- 训练免费 VLA 加速大量借用视觉语言模型剪枝,例如 FastV 的层间注意力。VLA-ADP、SAFE-Pruner、SpecPrune-VLA、VLA-Pruner 再叠时间变化、语义-动作差距或投机式剪枝,但间接分数不等于去掉 token 之后动作会怎样。VLA-Cache 用缓存换计算,却要改内部激活,和融合核冲突。
- LightVLA 用 Gumbel-softmax 训整栈,Grid-S 用可微网格采样端到端微调,都能在高剪枝率下保住成功率,代价是骨干更新和检查点绑定。VLA-ACL 站在中间:骨干冻结、只训小打分器,同时用动作误差直接当选择信号。
- LIBERO 提供空间、物体、目标和长程四套压力测试;实体协议跟 OpenVLA-OFT,平台是 AgileX PiPER-X。π0.5 附录则说明同一套动作一致性目标可以接到流匹配动作头,而不只回归式 OFT。