快速导读:提出首个直接在动态点云上工作的基础4D视觉编码器CL4D,通过对比学习对齐4D序列与自然语言,并构建首个4D视觉-语言模型4DVLM。
CL4D论文的核心主张是:动态3D场景的理解不应绕道2D视频或静态3D点云,而应直接在四维点云序列上建立视觉与语言的对应关系。作者提出两阶段框架:第一阶段用对比学习预训练一个4D视觉编码器,将动态点云序列与自然语言描述对齐到共享嵌入空间;第二阶段将该编码器接入LLaVA架构,训练一个能对动态点云进行视觉问答的4D视觉-语言模型4DVLM。
这一工作的意义在于填补了对比预训练范式在动态3D场景中的空白。CLIP开创了图像-文本对比学习,后续工作扩展到静态3D点云和2D视频,但动态点云序列——即同时包含空间结构与运动演化的四维数据——一直没有对应的基础编码器。CL4D试图证明,直接建模4D点云比渲染成视频再处理更有效。
英文题目:CL4D: Contrastive Language–4D Pretraining for Vision-Language Reasoning in Dynamic Scenes
论文出处:arXiv 每日论文精选 · arXiv:2608.18734
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视觉编码器存在一个结构性盲区。2D图像编码器只能捕获单帧外观,静态3D点云编码器只能捕获空间几何,2D视频编码器虽然能捕获运动但缺乏真正的几何深度推理能力。对于'一个人从椅子上站起来然后走向桌子'这样的动态场景,这三类编码器都无法同时回答'空间结构是什么'和'运动如何演化'这两个问题。
更具体地说,现有的4D编码器,如Motion PointNet和P4Transformer,都是为动作识别设计的,它们依赖固定的动作类别标签进行监督训练。这种闭集分类目标意味着模型只能输出预定义的动作标签,无法进行开放词汇的检索或推理。当用户问'这个人在做什么,他下一步可能去哪里'时,这些模型无法给出自然语言回答。
对比预训练在2D、3D和视频领域已被证明是对齐视觉与语言的主流范式,但尚未扩展到动态3D场景。这一空白不仅是技术上的缺失,也反映了数据层面的瓶颈:缺乏大规模、多样化的动态点云-文本配对数据集。CL4D的工作同时面对这两个问题:方法范式的缺失和训练数据的缺失。
核心创新
- 首个直接在动态点云上工作的基础4D视觉编码器CL4D,采用对比学习对齐4D序列与自然语言
- 首个不依赖2D图像/视频/静态3D点云的4D视觉-语言模型4DVLM
- 构建DynAction4D基准数据集,含HumanOnly、ObjInteractions、Cluttered和4D-VQA四个子集
- CL4D-mini参数高效变体,以约60% GFLOPs降低实现接近CL4D的性能
方法概览
两阶段训练:第一阶段CL4D用PointNet编码逐帧点云,经空间编码器Vs和以ViT初始化的时间编码器Vt得到4D视觉嵌入,与DistilBERT文本嵌入通过InfoNCE对比损失对齐;第二阶段4DVLM将冻结的CL4D嵌入线性投影到LLaVA-v1.5-7b语言空间进行VQA训练。
- CL4D的视觉编码器采用两阶段结构:先用PointNet对每一帧点云提取逐帧特征,再通过空间编码器Vs和时间编码器Vt联合建模时空信息。时间编码器以ViT初始化,输出4D视觉嵌入。文本侧使用DistilBERT提取文本嵌入,两者通过InfoNCE对比损失对齐。
- 4DVLM阶段将冻结的CL4D编码器输出通过一个线性投影层映射到LLaVA-v1.5-7b的语言空间,仅训练投影层,语言模型和4D编码器均保持冻结。这种设计保持了预训练表征的稳定性,同时以较低成本实现视觉问答能力。
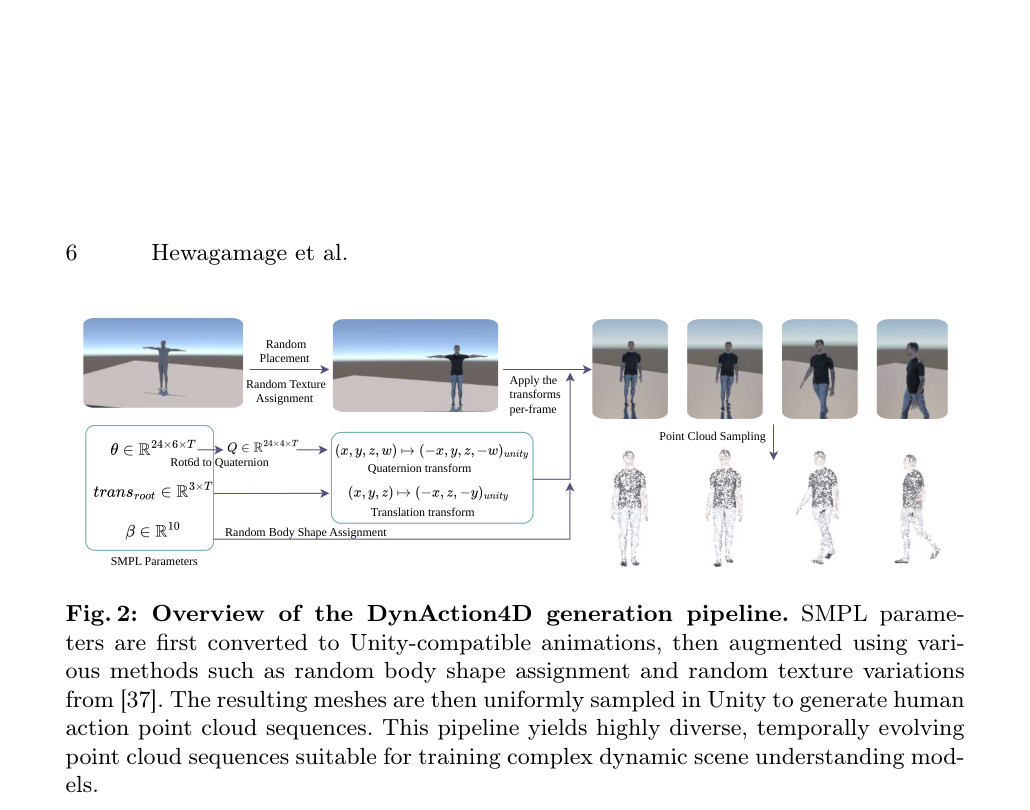
- DynAction4D数据集的生成管线从SMPL参数化人体模型出发,转换为Unity兼容的动画,通过随机体型分配和纹理变化增强多样性,然后在Unity中均匀采样生成人体动作点云序列。数据集包含三个子集:HumanOnly(纯人体动作)、ObjInteractions(人与物体交互)和Cluttered(杂乱环境中的动作),另有4D-VQA问答子集。
- CL4D-mini是一个参数高效变体,通过缩小ViT规模实现约60%的计算量降低,同时保持接近完整模型的性能。这一设计回应了实际部署中对计算效率的需求。
- 消融实验覆盖了多个关键设计选择:冻结文本编码器、使用随机初始化的ViT、打乱帧顺序、以及模拟LiDAR退化(部分点云和重建误差)。帧打乱实验直接验证了模型是否真正利用了时间信息。
逐图理解论文
失败案例与直觉
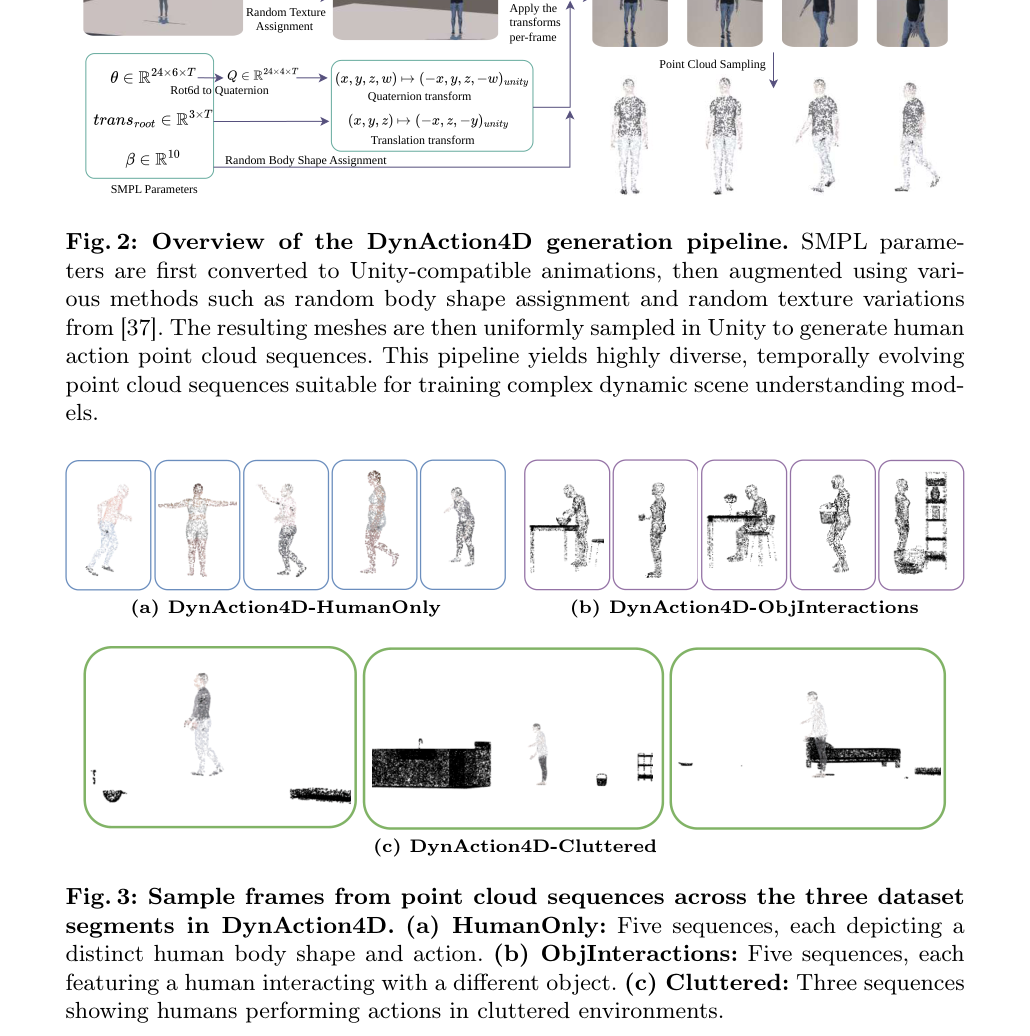
图3展示了三个数据集子集的样本帧:HumanOnly显示不同体型和动作的人体,ObjInteractions显示人与物体的交互,Cluttered显示杂乱环境中的动作。这张图直观呈现了数据集的场景覆盖范围。
研究空白
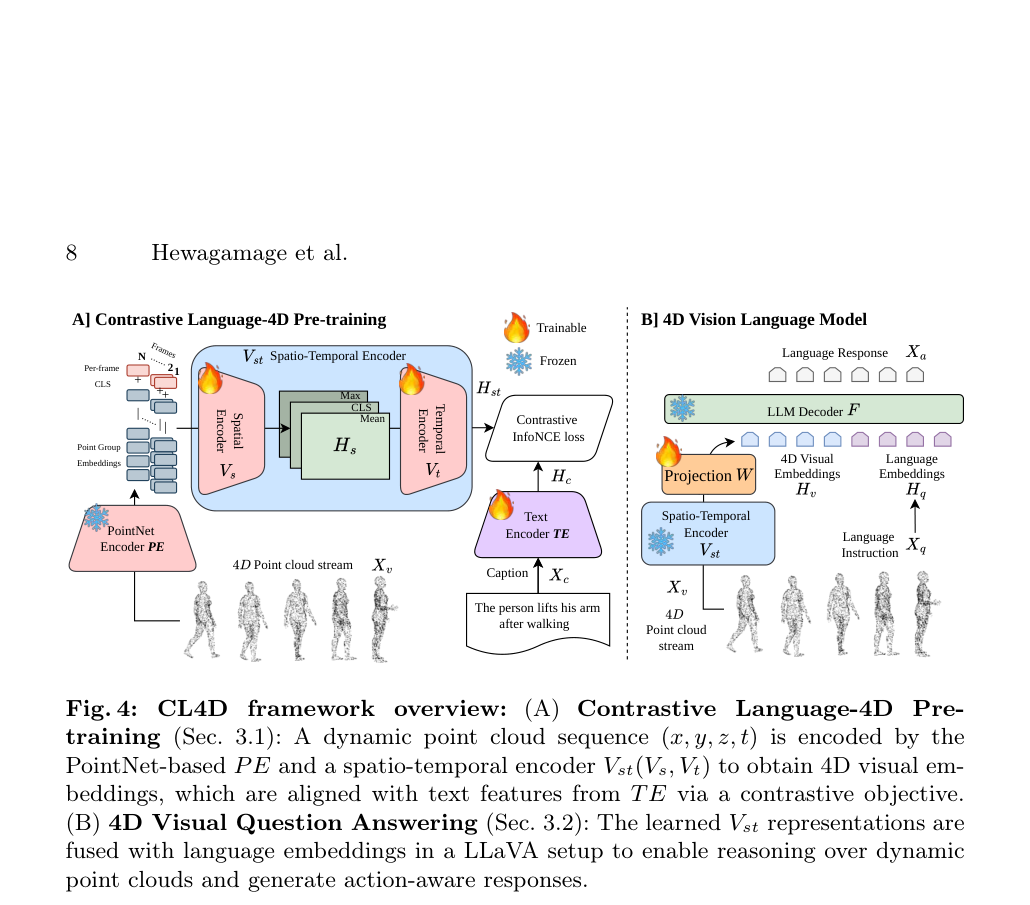
图4是CL4D框架的详细架构图:左侧显示PointNet编码器、时空编码器和文本编码器如何通过对比损失对齐;右侧显示4D视觉嵌入如何与语言嵌入融合进行VQA。这张图是理解方法细节的关键。
最强结论
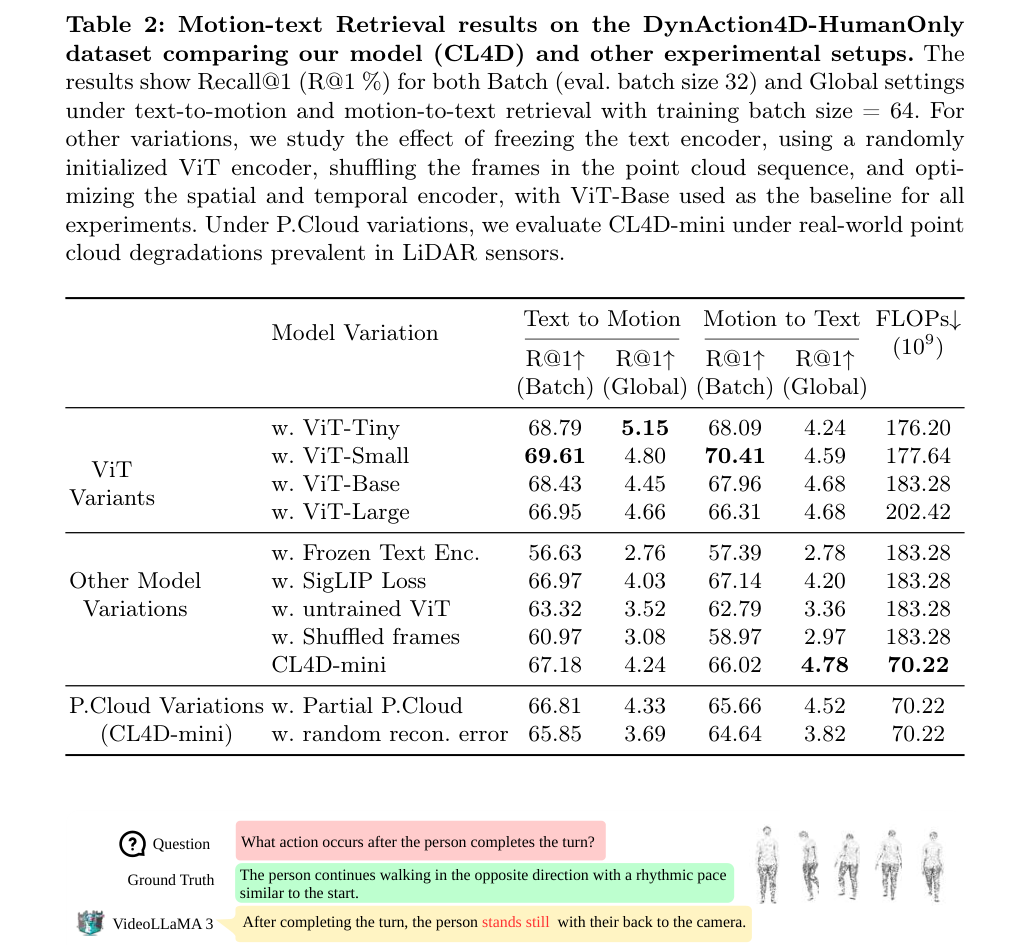
表2展示了消融实验结果,包括冻结文本编码器、随机初始化ViT、帧打乱和LiDAR退化等条件。帧打乱导致的显著性能下降是时间信息重要性的直接证据。
意义与局限
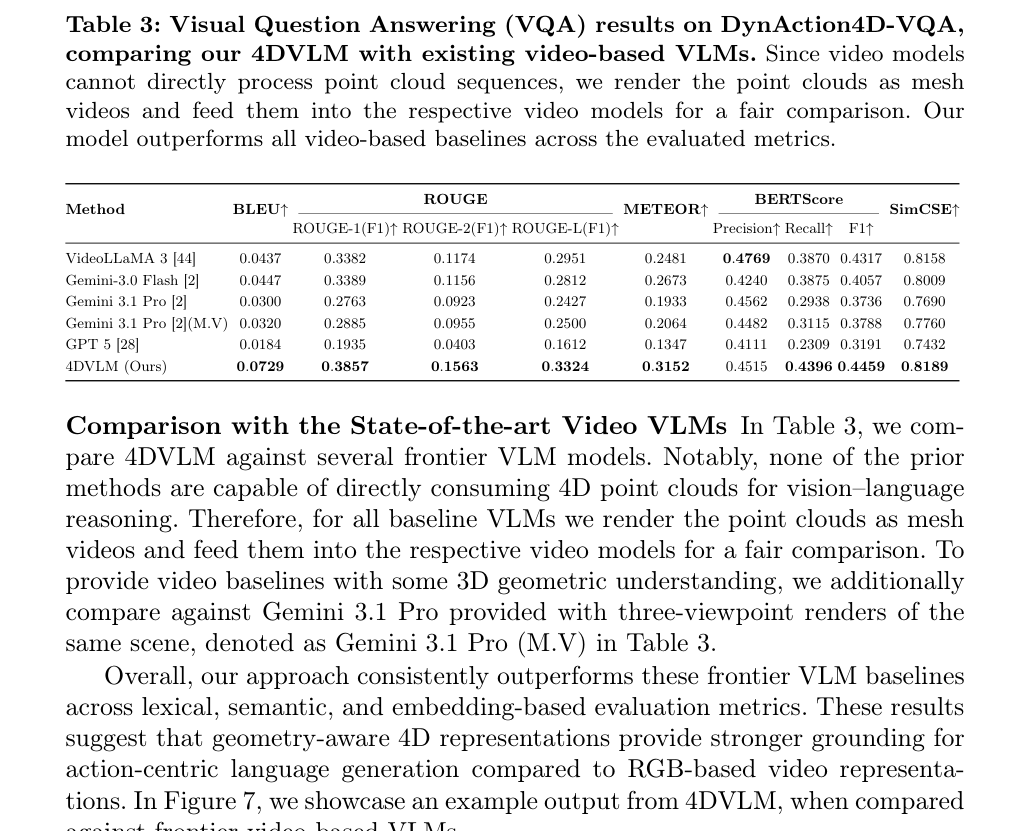
表3对比了4DVLM与视频VLM在VQA任务上的表现,4DVLM在所有指标上均优于视频基线。这张表支持了'直接处理点云优于渲染视频'的核心论点。
实验如何设计?
- 运动-文本双向检索在DynAction4D三个子集和RH20T数据集上评估,使用Batch和Global两种设置下的Recall@1指标。Batch设置在小批量内检索,Global设置在整个测试集上检索。
- 消融研究在DynAction4D-HumanOnly上进行,对比ViT变体(Tiny/Small/Base/Large)、冻结文本编码器、SigLIP损失、未训练ViT、帧打乱和LiDAR退化等条件。
- 训练批大小(16到72)和帧数(4到32)的敏感性分析用于确定最优训练配置。
- 4DVLM在DynAction4D-VQA上以BLEU、ROUGE、METEOR、BERTScore和SimCSE评估,对比视频VLM(VideoLLaMA 3、Gemini、GPT-5)和替代4D编码器(PST-Transformer等)。视频模型输入渲染后的网格视频,以保持公平比较。
关键结果与论文证据
- CL4D在DynAction4D-HumanOnly的文本到运动检索中Batch Recall@1达到70.32%,较P4Transformer提升16.75个百分点(第10页),证明对比预训练显著优于动作分类预训练。
- 在ObjInteractions和Cluttered子集上,CL4D分别达到49.40%和55.07%的Batch Recall@1,较Motion PointNet提升8.03和13.36个百分点(第10页),说明模型能处理物体交互和杂乱场景。
- CL4D-mini在RH20T上达到77.24%的文本到运动Batch Recall@1,较Motion PointNet提升9.03个百分点(第10页),证明参数高效变体在真实数据上同样有效。
- 帧打乱导致运动到文本Batch Recall@1下降11.44个百分点(从67.96%降至58.97%,第13页),直接证明模型确实捕获了时间顺序信息,而非仅依赖空间特征。
- CL4D-mini在部分点云和随机重建误差下,文本到运动Batch Recall@1仅分别下降0.37%和1.33%(第13页),表明模型对LiDAR传感器常见的点云退化具有鲁棒性。
- 4DVLM在DynAction4D-VQA上BLEU达到0.0729,较VideoLLaMA 3提升66.8%(第14页),SimCSE达到0.8189,超过所有视频VLM基线,证明直接处理点云优于渲染视频。
- 4DVLM较PST-Transformer编码器在BLEU上提升85.03%(第14页),说明CL4D的对比预训练表征在下游VQA任务中具有明显优势。
- CL4D-mini仅8.93M参数、70.22 GFLOPs,较ViT-Base降低约60%计算量(第23页),在效率与性能之间取得了良好平衡。
阅读时需要注意
- DynAction4D是Unity渲染的合成数据,与真实LiDAR点云分布存在差距,模型在真实传感器数据上的泛化能力尚未验证。
- 4DVLM仅训练投影层,语言模型和4D编码器均冻结,这可能限制模型在复杂多步推理任务上的能力。
- Cluttered子集仅使用61个家居物体,场景多样性有限,可能影响模型对更复杂环境的泛化。
- Global检索的Recall@1绝对值较低(最高8.07%),说明在大规模候选集上的精确检索仍具挑战。
- 论文声称超越GPT-5和Gemini,但基线模型输入为渲染视频而非原始点云,且仅在该合成VQA数据集上评估,这一比较的公平性和结论的普适性需要谨慎解读。
关联工作
- CLIP是对比式语言-图像预训练的奠基工作,CL4D将其范式扩展到4D点云,核心区别在于视觉输入从静态图像变为动态点云序列。
- Motion PointNet和P4Transformer是现有的4D动作识别编码器,它们使用分类目标训练,无法进行开放词汇推理,CL4D通过对比学习解决了这一局限。
- PointLLM是静态3D点云LLM的代表,CL4D将其思路扩展到动态4D场景,增加了时间维度的建模。
- Motion Patches将人体运动转为ViT兼容的patch进行语言对齐,但依赖骨架表示而非原始点云,CL4D直接在原始点云上工作,避免了骨架提取的信息损失。