快速导读:FactoSR提出了一种基于分解式强化学习(Factorized RL)的框架,通过解耦XY平面、Z深度和T时间维度的可验证奖励,显著提升了VLM在4D空间推理任务中的表现。
FactoSR针对视觉语言模型(VLM)在处理物理世界空间推理时存在的“维度不匹配”问题,提出了一种基于分解式强化学习(Factorized RL)的两阶段训练框架。该框架的核心思想是将复杂的4D空间推理任务解耦为XY平面、Z深度和T时间三个正交子目标,并通过可验证的奖励机制引导模型进行显式的4D推理。
与传统的SFT方法或直接优化4D目标不同,FactoSR在Stage 1通过SFT建立基础空间感知能力,在Stage 2利用GRPO算法引入Format、Accuracy、XY、Z和T五类奖励。这种分解策略不仅避免了直接优化4D目标的计算不可行性,还通过显式的几何对应、深度估计和时间一致性约束,显著提升了模型在动态场景中的推理一致性和泛化能力。
英文题目:Unfold The World: Factorize 4D Properties in Reinforcing Spatial Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2609.03729
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有VLM在处理物理世界空间推理时存在“维度不匹配”问题,即模型仅基于2D投影学习,缺乏对潜在3D几何结构和时间连续性的恢复能力,导致在动态场景中出现幻觉和推理不一致。传统的SFT方法或添加空间Token的方法难以构建连贯的潜在世界模型,且直接优化4D目标在计算和算法上不可行。
现有的RLVR方法多依赖单一视图或仅关注最终答案正确性,缺乏对几何对应、深度估计和时间一致性的显式约束。例如,VST采用渐进式训练但缺乏显式的4D分解奖励,SpaceR增强结构化空间推理但未显式处理时间维度,SpatialThinker将空间关系融入RL目标但主要基于单视图一致性。这些方法的局限性在于未能有效解耦4D空间推理的各个维度,导致模型在复杂动态场景中的表现受限。
FactoSR的创新之处在于提出分解式奖励框架,将4D空间推理分解为XY平面、Z深度和T时间三个正交子目标。这种分解策略不仅符合物理世界的结构特性,还通过可验证的奖励机制引导模型进行显式的4D推理,从而显著提升了模型在动态场景中的推理一致性和泛化能力。
核心创新
- 提出分解式奖励框架,将4D空间推理分解为XY平面、Z深度和T时间三个正交子目标。
- 设计基于重投影一致性和可见性掩码的XY奖励,避免外观启发式匹配。
- 引入基于Kendall-τ相关系数的Z奖励,优化相对深度顺序而非绝对深度值。
- 提出T奖励,通过前向和反向运动序列的逻辑可逆性强化时间因果理解。
方法概览
FactoSR采用两阶段训练框架:Stage 1通过SFT建立基础空间感知能力;Stage 2利用GRPO算法进行分解式强化学习,引入Format、Accuracy、XY(平面对应)、Z(深度顺序)和T(时间循环一致性)五类奖励,引导模型进行显式的4D推理。
- Stage 1:通过SFT在多样化的空间任务上建立基础空间感知能力,为后续的分解式强化学习奠定基础。
- Stage 2:利用GRPO算法进行分解式强化学习,引入Format、Accuracy、XY、Z和T五类奖励,引导模型进行显式的4D推理。
- XY奖励:基于重投影一致性和可见性掩码设计,避免外观启发式匹配,确保平面对应的准确性。
- Z奖励:基于Kendall-τ相关系数优化相对深度顺序而非绝对深度值,提升深度估计的鲁棒性。
- T奖励:通过前向和反向运动序列的逻辑可逆性强化时间因果理解,确保时间一致性。
- Format奖励:确保模型输出的格式符合预期,提升推理过程的规范性。
- Accuracy奖励:关注最终答案的正确性,确保推理结果的准确性。
逐图理解论文
失败案例
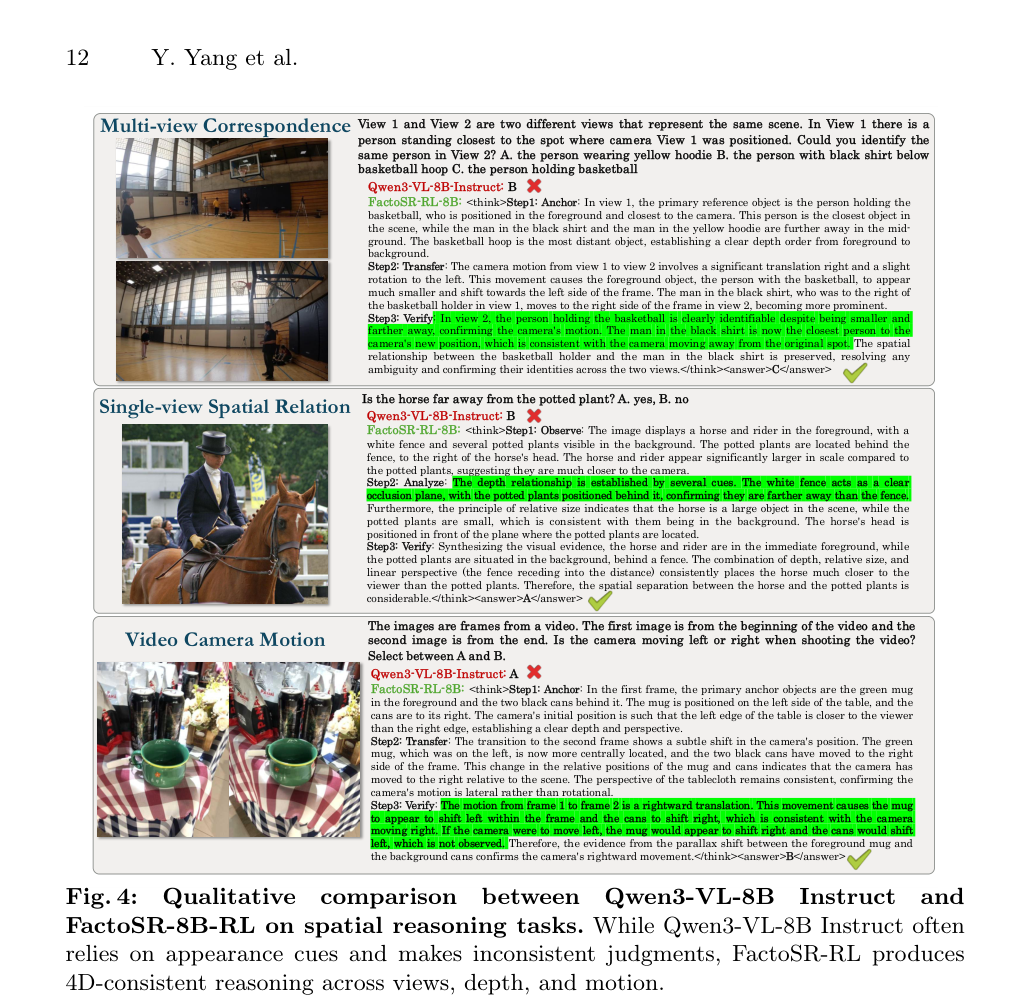
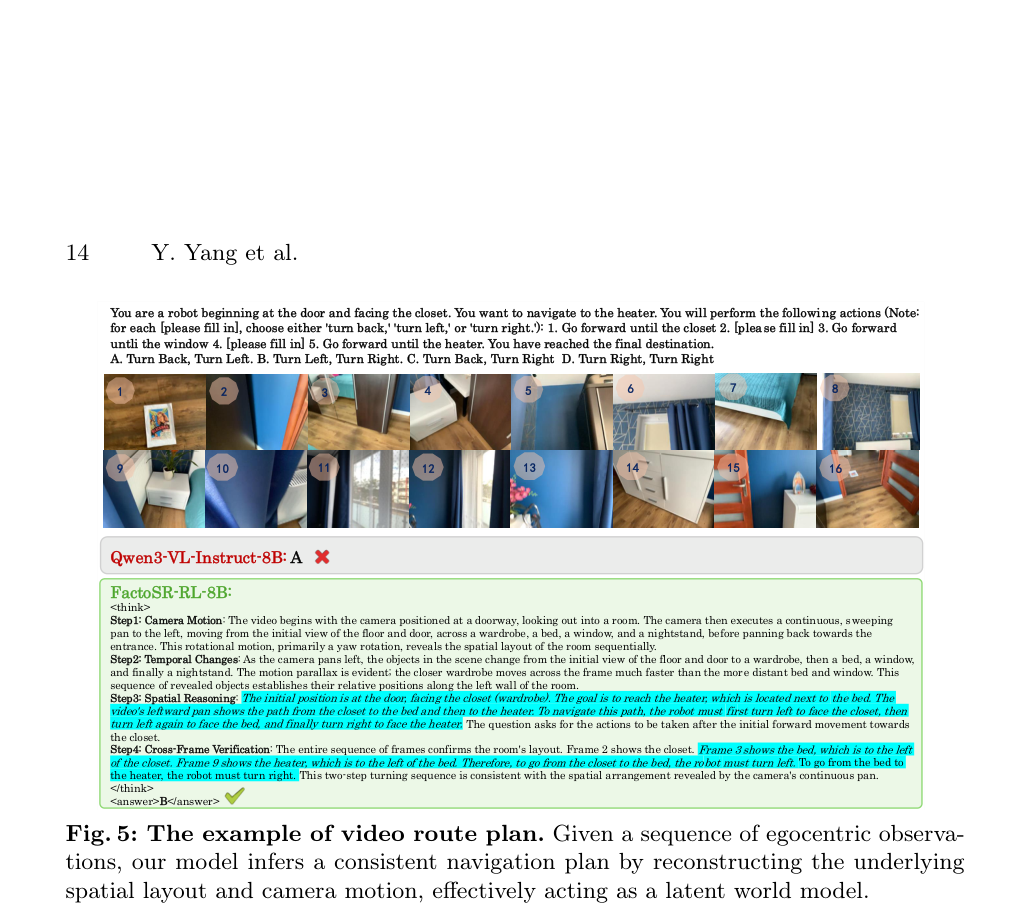
该图展示了Qwen3-VL-8B Instruct和FactoSR-8B-RL在空间推理任务上的定性比较。FactoSR-RL产生4D一致的推理,而基线模型往往依赖外观线索并做出不一致的判断。观察该图可以直观理解FactoSR在4D空间推理任务中的优势。
研究缺口
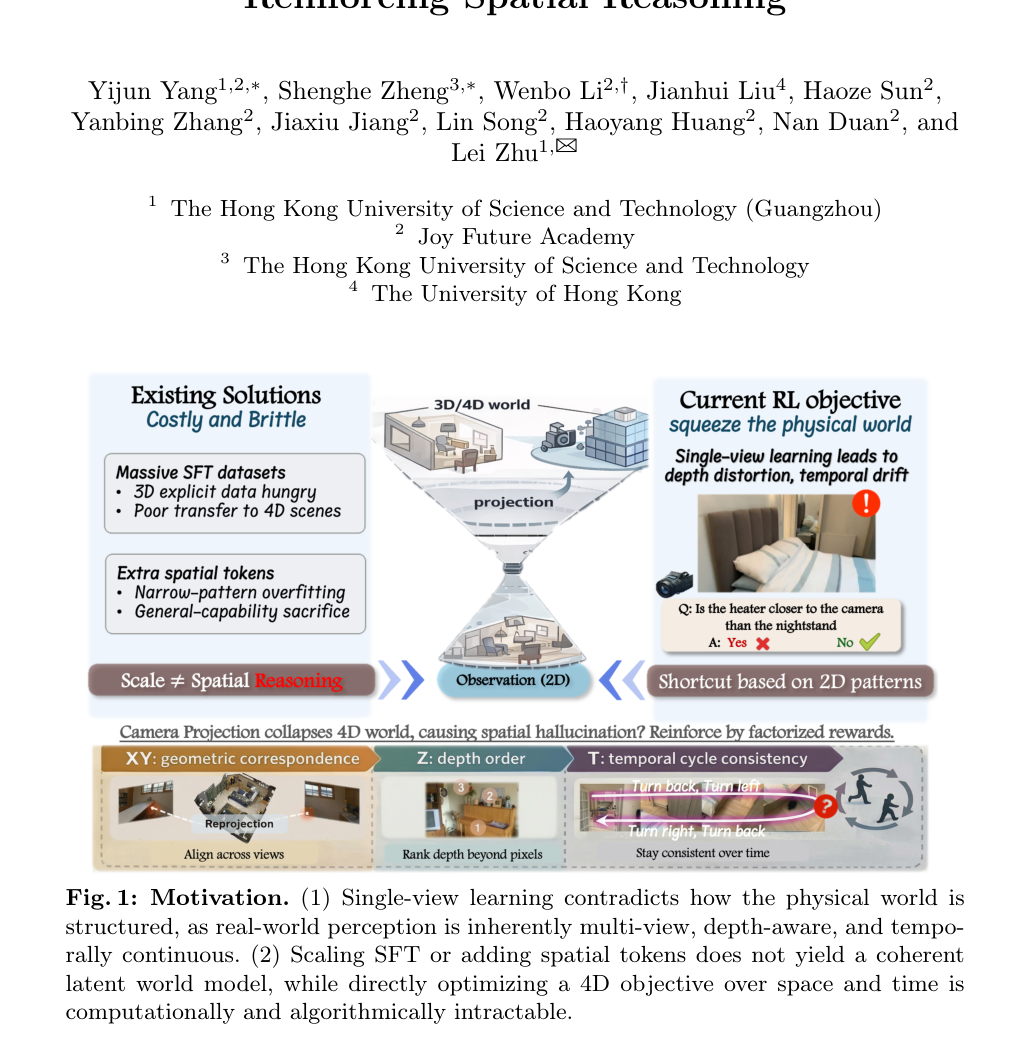
现有方法如VST和SpaceR缺乏对4D维度的显式分解,导致模型无法有效恢复潜在的3D几何结构和时间连续性。
核心贡献
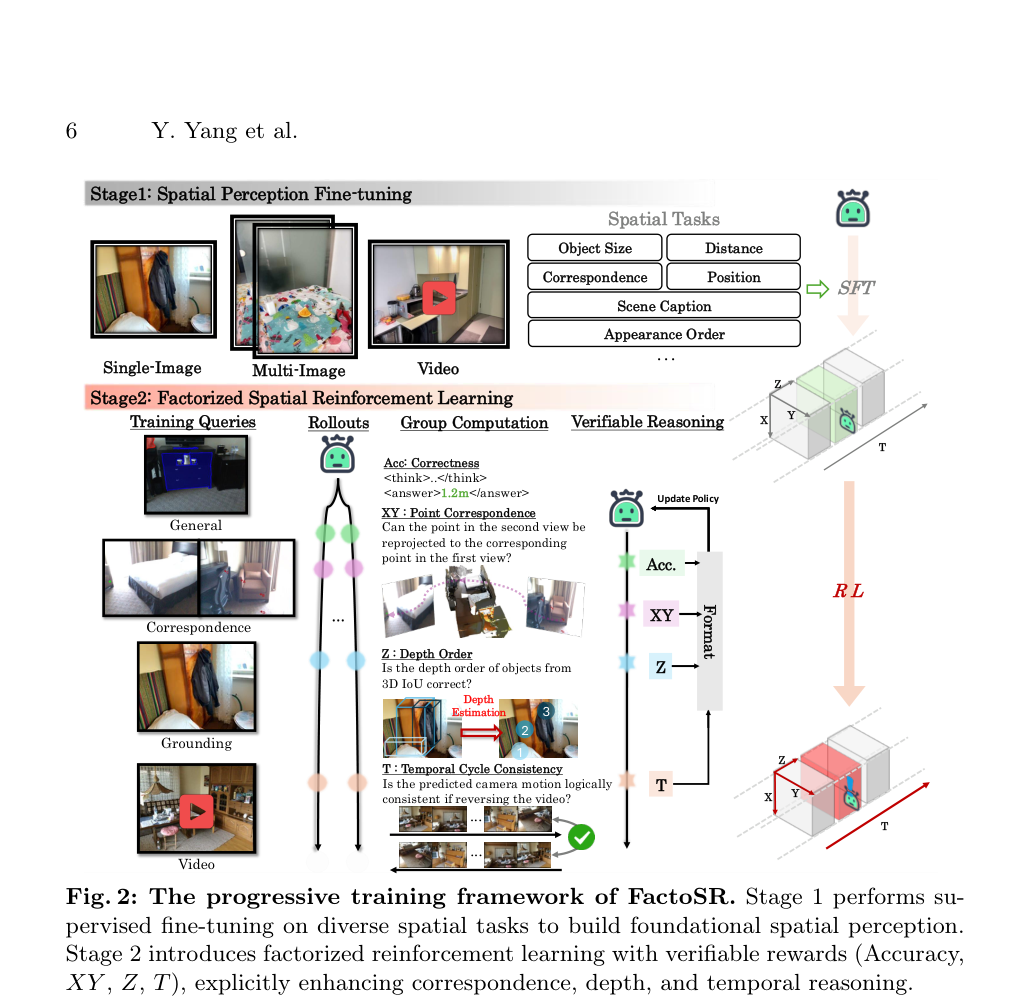
该图展示了FactoSR的渐进式训练框架。Stage 1通过SFT建立基础空间感知能力,Stage 2引入分解式强化学习,通过可验证的奖励机制显式增强对应、深度和时间推理。观察该图可以清晰理解FactoSR的两阶段训练策略及其核心创新点。
最强结论
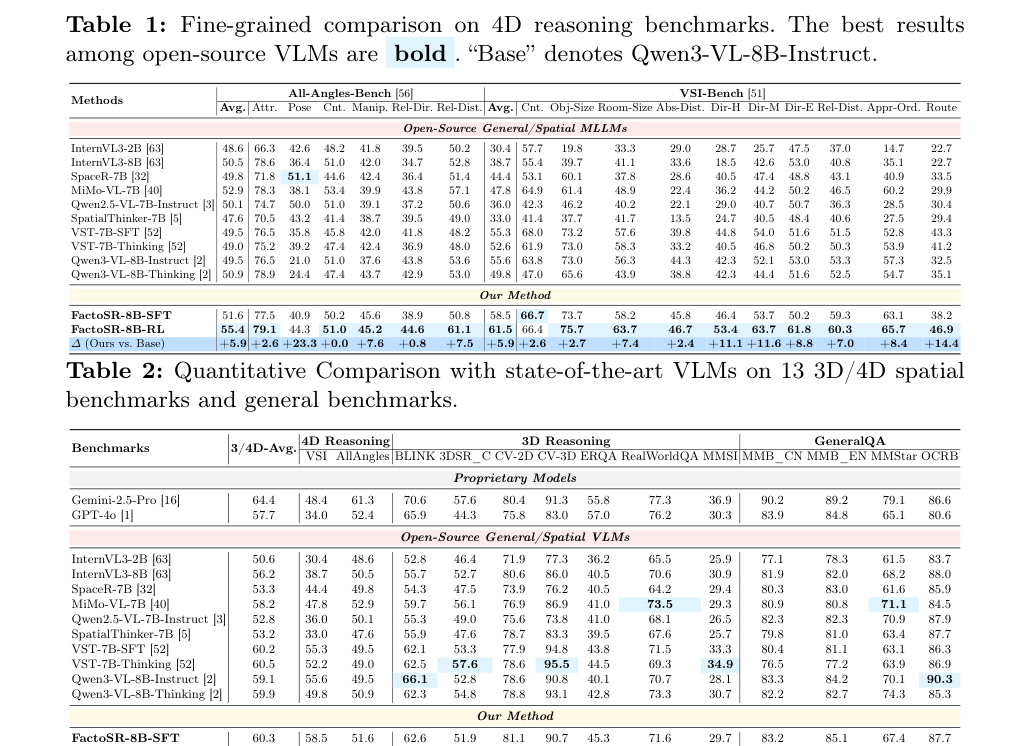
该表展示了FactoSR在4D推理基准上的细粒度比较结果。FactoSR-8B-RL在VSI-Bench和All-Angles-Bench上均显著优于基线模型,验证了分解式奖励框架的有效性。观察该表可以直观了解FactoSR在4D空间推理任务中的性能优势。
意义与局限
FactoSR通过分解式奖励显著提升了VLM的4D空间推理能力,但依赖高质量3D标注数据,限制了其在无标注场景中的应用。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 在All-Angles-Bench和VSI-Bench等4D推理基准上进行细粒度比较,评估模型在4D空间推理任务中的表现。
- 在BLINK, 3DSRBench, CVBench等13个3D/4D及通用基准上进行综合评估,验证模型的泛化能力。
- 消融实验验证Z奖励和深度监督的有效性,分析各奖励机制对模型性能的贡献。
- 对比基线包括VST、SpaceR和SpatialThinker,评估FactoSR在4D空间推理任务中的优势。
关键结果与论文证据
- FactoSR-8B-RL在VSI-Bench上达到61.5%,比基线提升5.9%(Page 11)。
- FactoSR-8B-RL在All-Angles-Bench上达到55.4%,比基线提升4.5%(Page 11)。
- FactoSR-8B-RL在13个3D/4D空间基准上的平均准确率为62.0%,比基线提升2.9%(Page 11)。
- 消融实验表明,Z奖励和深度监督对模型性能的提升显著,验证了分解式奖励框架的有效性(Page 13)。
- 定性分析显示,FactoSR-RL在空间推理任务中产生4D一致的推理,而基线模型往往依赖外观线索并做出不一致的判断(Page 12)。
阅读时需要注意
- 依赖高质量的深度图和相机位姿数据来计算XY和Z奖励,限制了在缺乏3D标注数据场景中的应用。
- RL阶段的数据集较小(32K样本),可能影响模型在更广泛空间任务上的泛化能力。
- 论文声称的SOTA性能主要基于开源模型对比,与Gemini-2.5-Pro等专有模型仍有差距。
- 分解式奖励的设计需要精确的几何计算,实现复杂度较高。
关联工作
- VST (Visual Spatial Tuning):对比基线,VST采用渐进式训练但缺乏显式的4D分解奖励(Page 4)。
- SpaceR:对比基线,SpaceR增强结构化空间推理但未显式处理时间维度(Page 4)。
- SpatialThinker:对比基线,SpatialThinker将空间关系融入RL目标,但主要基于单视图一致性(Page 4)。