快速导读:Scal3R通过冻结骨干网络并注入轻量级相对位姿查询token,结合在线位姿图优化,解决了长视频流中全局位姿回归导致的累积漂移问题,实现了公里级场景的稳定在线重建。
长视频在线3D重建面临的核心挑战是全局位姿回归在超出训练分布时的累积漂移。现有前馈模型如CUT3R和STream3R依赖固定首帧锚点,导致长序列中几何崩溃。Scal3R提出了一种全新的范式,将问题重构为多参考相对位姿查询,从而在保持局部几何精度的同时,通过后端优化实现全局一致性。
本文的核心贡献在于证明了骨干网络的局部几何表征在长序列中依然可靠,失效的仅是全局位姿回归头。基于这一洞察,Scal3R通过冻结骨干网络并注入轻量级可学习token,结合在线位姿图优化(PGO)和回环检测,以极低的参数开销实现了显著的性能提升。
英文题目:Scal3R: Learning Efficient Multi-Relative Pose Query for Scalable Online 3D Reconstruction
论文出处:arXiv 每日论文精选 · arXiv:2609.04201
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在长视频流中,相机运动轨迹往往远超训练数据的分布范围。现有前馈式在线3D重建模型(如CUT3R, STream3R)通常回归相对于固定首帧的绝对全局位姿。这种设计在短序列中表现良好,但在长序列中,由于需要外推至远超训练分布的全局坐标,模型会遭受严重的累积漂移和几何崩溃。
研究发现,尽管全局位姿误差发散,但逐帧深度(局部几何)保持稳定。这表明骨干网络的局部几何表征完好,仅全局位姿回归头失效。这一关键发现为Scal3R的设计提供了理论基础:即利用骨干网络可靠的局部几何能力,通过相对位姿查询替代不稳定的全局位姿回归。
此外,无界视频流中的相机运动多变,全局坐标系必然遭遇分布外轨迹。传统的SLAM系统虽然能处理长序列,但通常依赖复杂的特征匹配和手工设计的优化策略,且对相机内参有严格要求。Scal3R旨在结合前馈模型的端到端优势与SLAM的全局一致性,提供一种更轻量、更鲁棒的解决方案。
核心创新
- 提出多参考相对位姿查询机制,替代不稳定的全局位姿回归,利用骨干网络可靠的局部几何能力。
- 设计非对称注意力注入(Asymmetric Attention Injection),确保位姿查询不干扰图像特征空间,保持点云重建质量。
- 集成在线位姿图优化(PGO)与回环检测,通过增量式优化和回环约束抑制长程漂移,实现全局一致性。
- 极致的参数效率与训练效率:仅需约1%的新增参数,在单GPU上8小时内完成微调。
方法概览
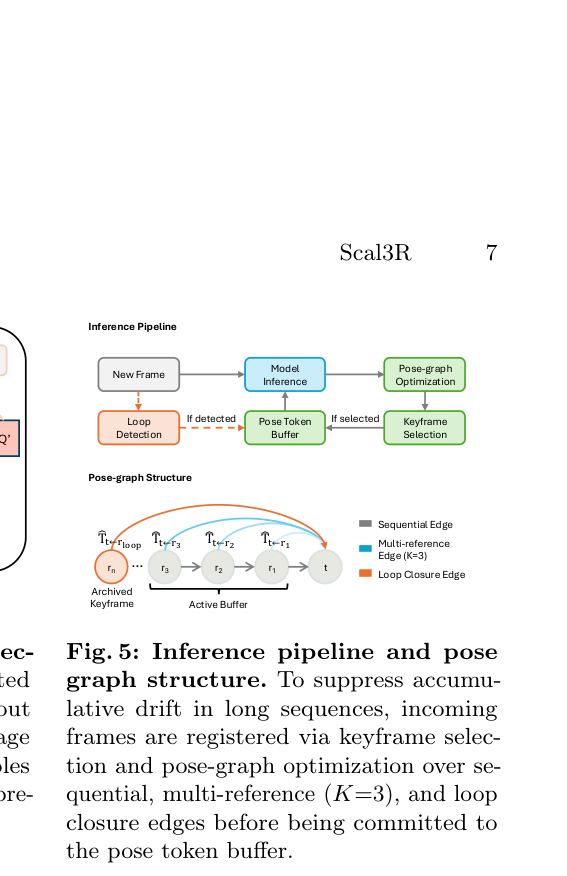
Scal3R将在线重建重构为多参考相对位姿查询问题。在完全冻结的骨干网络(CUT3R或STream3R)中,通过非对称注意力注入(Asymmetric Attention Injection)引入轻量级可学习token(约占参数1%),这些token仅作为查询(Query)提取几何特征,不改变图像token的键值(Key/Value),从而保留预训练表征。后端采用在线位姿图优化(PGO),结合关键帧选择、多参考相对约束聚合及回环检测,生成全局一致轨迹。
- 多参考相对位姿查询机制:Scal3R将在线重建重构为多参考相对位姿查询问题。在完全冻结的骨干网络中,通过非对称注意力注入引入轻量级可学习token,这些token仅作为查询提取几何特征,不改变图像token的键值,从而保留预训练表征。
- 非对称注意力注入(Asymmetric Attention Injection):该机制确保位姿查询不干扰图像特征空间,保持点云重建质量。相对位姿token仅作为额外的查询(Q'),而不修改图像token的键和值(K/V),从而在引入位姿条件的同时,保留了预训练的图像表征。
- 在线位姿图优化(PGO):后端采用在线位姿图优化,结合关键帧选择、多参考相对约束聚合及回环检测,生成全局一致轨迹。PGO通过增量式优化和回环约束抑制长程漂移,确保轨迹的全局一致性。
- 关键帧选择与回环检测:关键帧选择用于减少冗余计算,回环检测则用于识别重复访问的区域,从而引入全局约束。这些组件共同作用,使得Scal3R能够在长序列中保持稳定的重建质量。
- 参数效率与训练效率:Scal3R仅需约1%的新增参数,在单GPU上8小时内完成微调。这种极致的参数效率使得Scal3R能够轻松适配不同的骨干网络,如CUT3R和STream3R,而无需重新训练整个模型。
逐图理解论文
失败案例与直觉
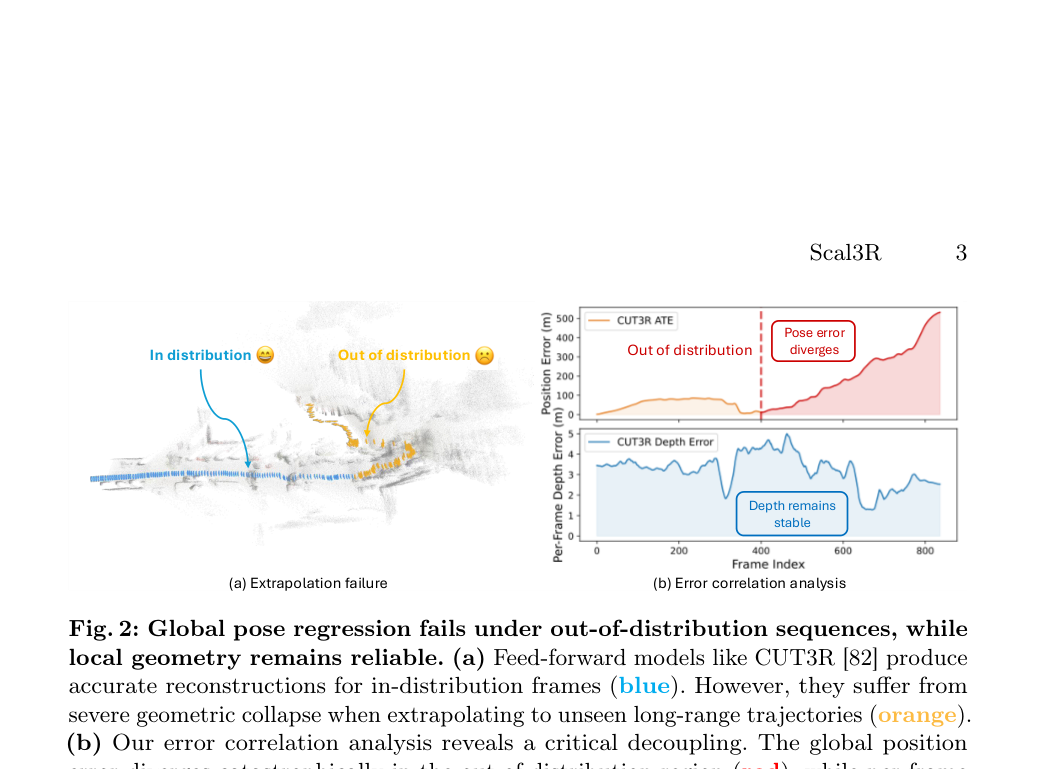
该图揭示了全局位姿回归在分布外序列上的失败,而局部几何依然可靠。图(a)显示,像CUT3R这样的前馈模型在分布内帧上产生精确的重建(蓝色),但在外推到未见过的长程轨迹时(橙色)遭受严重的几何崩溃。图(b)的错误相关性分析揭示了一个关键解耦:全局位置误差发散,但局部几何误差保持稳定,证明了骨干网络的局部几何表征完好,仅全局位姿回归头失效。
核心区分与研究缺口
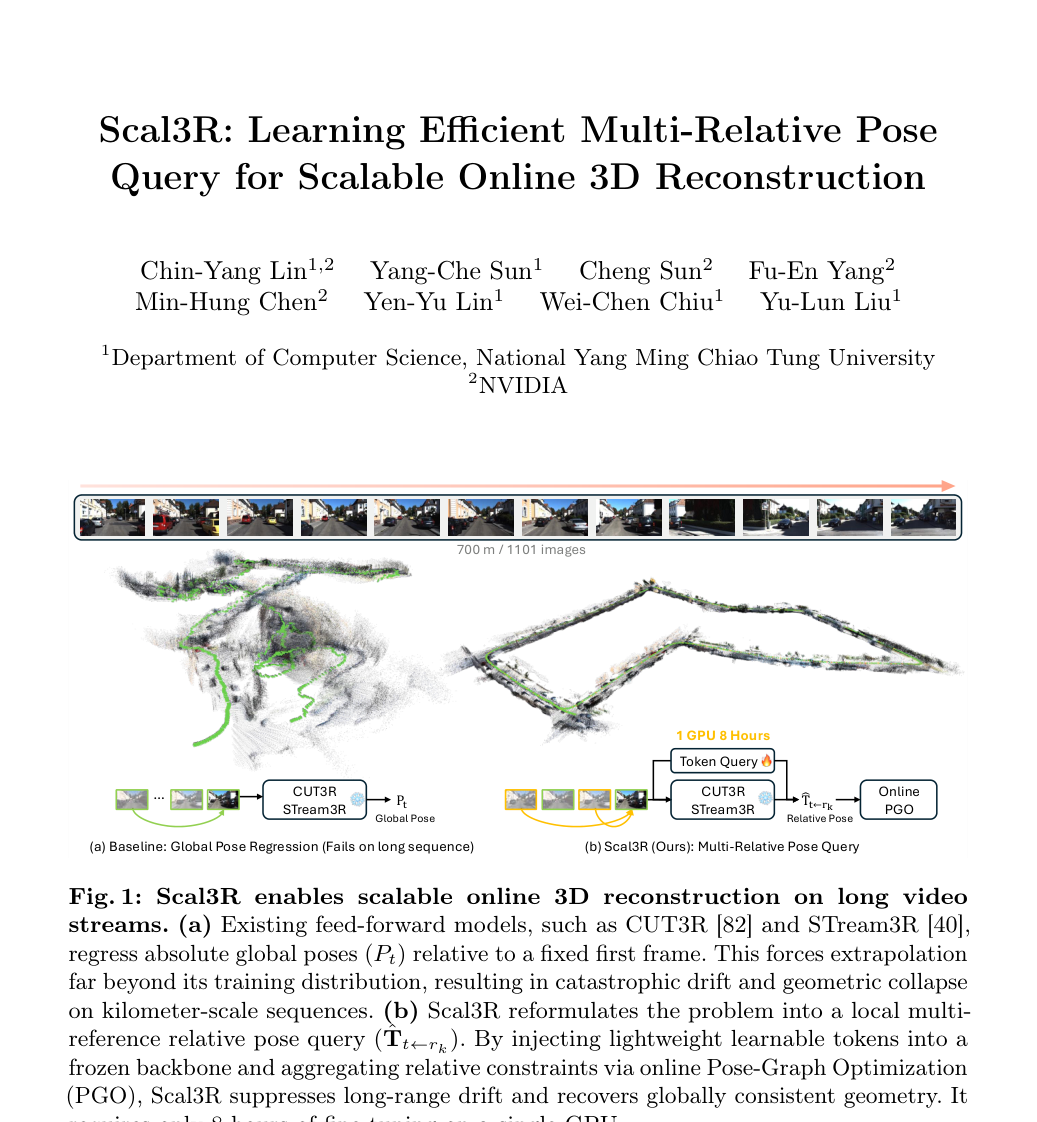
该图展示了Scal3R在长视频流上实现可扩展在线3D重建的能力。图(a)显示了现有前馈模型(如CUT3R和STream3R)在回归绝对全局位姿时,由于超出训练分布而导致的灾难性漂移和几何崩溃。图(b)则展示了Scal3R通过将问题重构为局部多参考相对位姿查询,并注入轻量级可学习token到冻结骨干网络中,结合在线位姿图优化(PGO),有效抑制了长程漂移并恢复了全局一致的几何结构。
Scal3R的贡献与机制
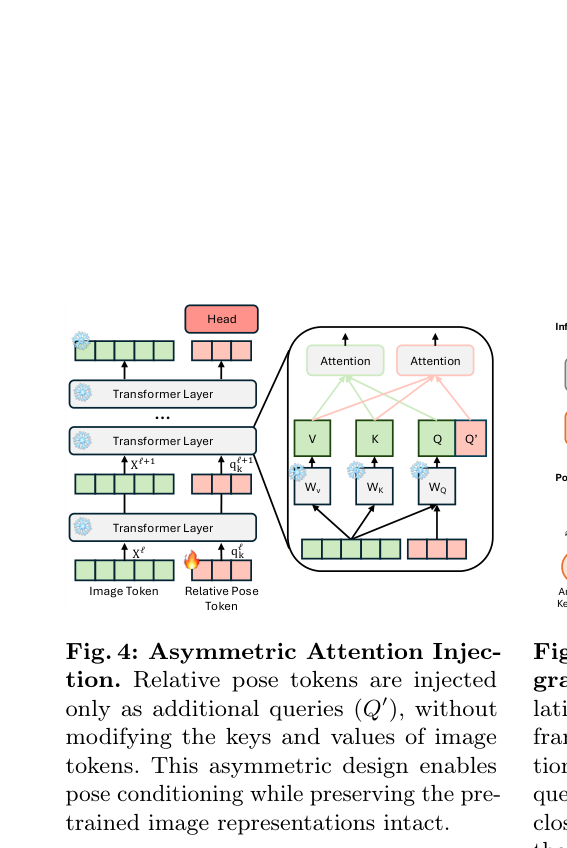
该图详细展示了非对称注意力注入(Asymmetric Attention Injection)机制。相对位姿token仅作为额外的查询(Q')注入,而不修改图像token的键和值(K/V)。这种非对称设计使得在引入位姿条件的同时,能够保持预训练的图像表征完整无损,从而确保点云重建质量不受影响。
最强结论
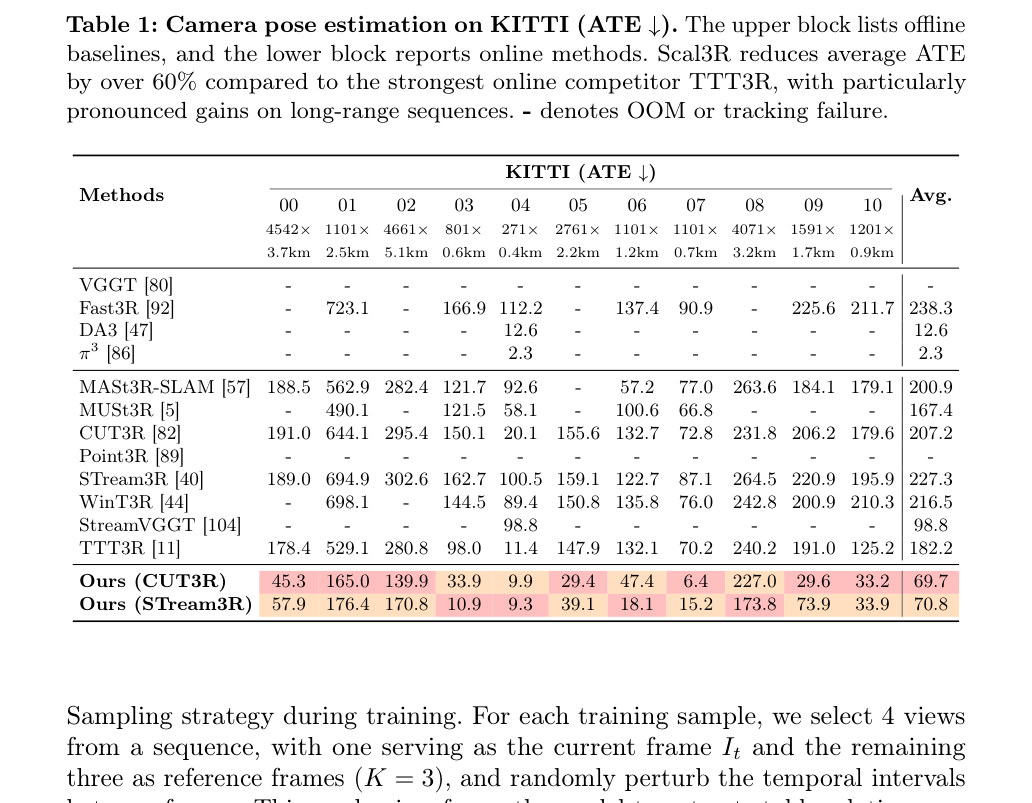
该表报告了KITTI数据集上的相机位姿估计结果(ATE ↓)。上半部分列出了离线基线,下半部分报告了在线方法。Scal3R与最强的在线竞争者TTT3R相比,平均ATE降低了60%以上,特别是在长程序列上增益尤为显著。'-'表示OOM或跟踪失败。
实验如何设计?
- 数据集:在KITTI、Virtual KITTI (vKITTI)、Sintel、TUM-Dynamic、ScanNet和7-Scenes数据集上评估相机位姿估计(ATE)和3D重建质量(Acc., Comp., NC)。
- 基线对比:与离线Transformer(VGGT, π3等)、在线流式模型(CUT3R, STream3R, TTT3R等)及SLAM系统进行对比。
- 消融实验:验证了训练策略(参考帧数量)、推理组件(关键帧选择、PGO、回环检测)及非对称注意力机制的有效性。
- 评估指标:使用绝对轨迹误差(ATE)评估相机位姿估计,使用准确性(Acc.)、完整性(Comp.)和法向一致性(NC)评估3D重建质量。
- Sim(3)对齐:评估时使用了Sim(3)对齐,这意味着结果依赖于全局尺度、旋转和平移的对齐,而非纯度量尺度下的绝对精度。
关键结果与论文证据
- 在KITTI数据集上,Scal3R的平均ATE降低了60%以上(69.7 vs TTT3R的182.2),特别是在长程序列上表现尤为突出(Page 10)。
- 在vKITTI数据集上,Scal3R的平均ATE为5.63 (CUT3R backbone),接近离线方法π3 (2.04)(Page 11)。
- 在TUM-Dynamic数据集上,Scal3R的ATE达到0.018 (STream3R backbone),在ScanNet数据集上ATE达到0.049(Page 11)。
- 在7-Scenes数据集上,Scal3R的法向一致性(NC)均值达到0.579 (STream3R backbone)(Page 12)。
- 回环检测使KITTI平均ATE降低48%(从143.45降至75.01),特别是在回环较多的序列上(如Seq. 00和05)(Page 14)。
- 推理速度:CUT3R backbone下14.4 FPS,STream3R backbone下7.95 FPS(Page 13)。
- 非对称注意力注入对于户外序列至关重要,可将ATE降低多达10倍(Page 30)。
- 与并发工作LongStream相比,Scal3R通过冻结骨干+轻量token达到可比性能且参数更少(Page 29)。
阅读时需要注意
- 性能受限于冻结骨干网络,在遮挡或无纹理区域表现可能下降。
- 基于外观的回环检测在极端视角或光照变化下可能失效。
- 关键帧选择和回环检测依赖手工设定的阈值,缺乏自适应机制。
- 评估时使用了Sim(3)对齐,结果依赖于全局尺度、旋转和平移的对齐,而非纯度量尺度下的绝对精度。
- 长序列中需要定期重置冻结解码器的流式状态以防止内存溢出,这可能引入额外的边界效应。
关联工作
- CUT3R:骨干网络之一,提供持久状态更新机制,Scal3R在其冻结版本上添加相对位姿查询(Page 1)。
- STream3R:骨干网络之一,基于因果Transformer,Scal3R同样在其冻结版本上进行适配(Page 1)。
- TTT3R:最强的在线竞争基线,通过测试时训练抑制漂移,Scal3R在KITTI上显著优于它(Page 10)。
- LongStream:并发工作,通过重训练大骨干网络实现长序列重建,Scal3R通过冻结骨干+轻量token达到可比性能且参数更少(Page 29)。
- iSAM2:用于在线位姿图优化的增量平滑与映射求解器(Page 8)。