快速导读:本文提出了SoundMHPE,首个仅利用主动声学信号进行多人3D姿态估计的框架,通过多尺度声学编码器和时序姿态解码器解决信号叠加与多体反射带来的歧义问题。
SoundMHPE 提出了一个基于主动声学信号的多人体3D姿态估计框架。与依赖 RGB 或 WiFi 信号的方法不同,它利用扬声器发射的 TSP 信号和麦克风接收的回波,通过 Encoder-Decoder 架构直接估计多个个体的姿态。
英文题目:Sound-based Multi-Person 3D Pose Estimation
论文出处:arXiv 每日论文精选 · arXiv:2609.04902
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有声学姿态估计方法大多局限于单人场景。在多人场景中,不同个体的运动引起的声学信号变化会发生叠加,且多体反射引入复杂的传播延迟,导致难以将特定的声学信号变化归因于特定个体的姿态。
核心创新
- 首个基于主动声学信号的多人3D姿态估计方法。
- 提出Acoustic Multi-scale Encoder (AME),利用多尺度STFT和定制化自注意力机制分离细微声学特征。
- 提出Temporal Pose Decoder (TPD),通过多查询机制和分解的自注意力(MSA/ISA)联合建模个体内时序动态和个体间声学交互。
- 构建了6小时的AMP数据集,包含432K帧同步的多人姿态和声学数据。
方法概览
SoundMHPE采用Encoder-Decoder架构。Acoustic Multi-scale Encoder (AME) 使用不同窗口大小(L, 2L, 4L)的STFT生成多尺度log-Mel频谱,通过Temporal Self-Attention (TSA) 和 Frequency Self-Attention (FSA) 提取时频特征。Temporal Pose Decoder (TPD) 为每个个体分配多组可学习pose queries,利用Motion Self-Attention (MSA) 建模个体内时序动态,Interaction Self-Attention (ISA) 建模个体间交互,并通过Cross-Attention从声学特征图中提取姿态信息。
- Acoustic Multi-scale Encoder (AME) 使用不同窗口大小(L, 2L, 4L)的 STFT 生成多尺度 log-Mel 频谱,通过 Temporal Self-Attention (TSA) 和 Frequency Self-Attention (FSA) 提取时频特征。
- Temporal Pose Decoder (TPD) 为每个个体分配多组可学习 pose queries,利用 Motion Self-Attention (MSA) 建模个体内时序动态,Interaction Self-Attention (ISA) 建模个体间交互。
- 通过 Cross-Attention 从声学特征图中提取姿态信息,多查询机制使模型能关注不同帧的声学特征以估计各帧姿态。
- 构建了 AMP 数据集,包含 6 小时同步的多人姿态和声学数据,涵盖单人、双人和三人场景。
逐图理解论文
直觉与失败案例
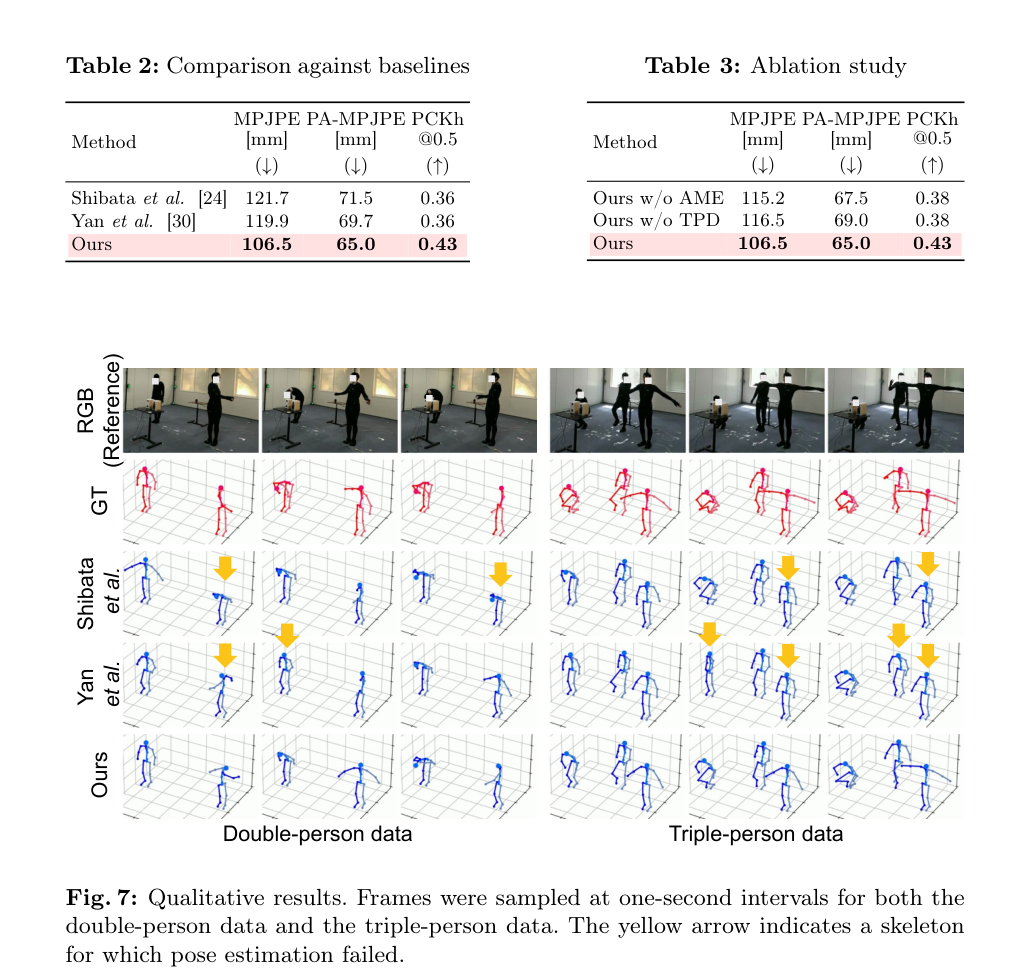
该图展示了定性结果,包括双人和三人场景下的姿态估计。黄色箭头指示了姿态估计失败的骨架,帮助理解模型在复杂场景下的表现。
研究缺口
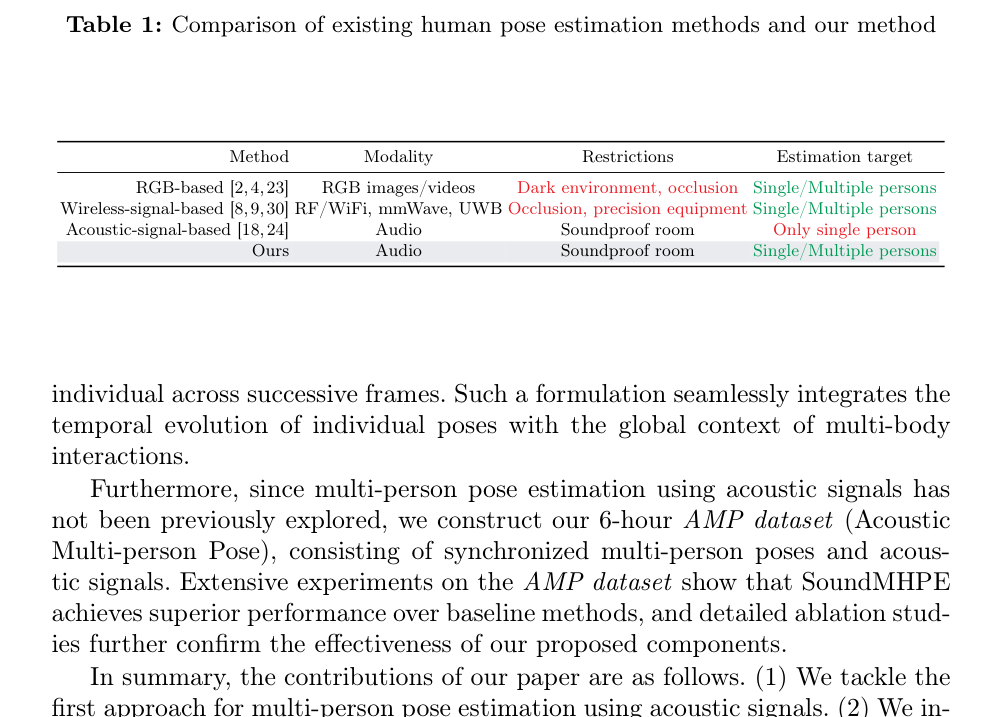
现有声学姿态估计方法仅限于单人场景,缺乏处理多人信号叠加与反射歧义的能力。RGB 方法受遮挡和低光影响,无线信号受水和金属遮挡影响,而主动声学传感虽不受光照影响,但此前缺乏多人估计的研究和数据集。
核心贡献
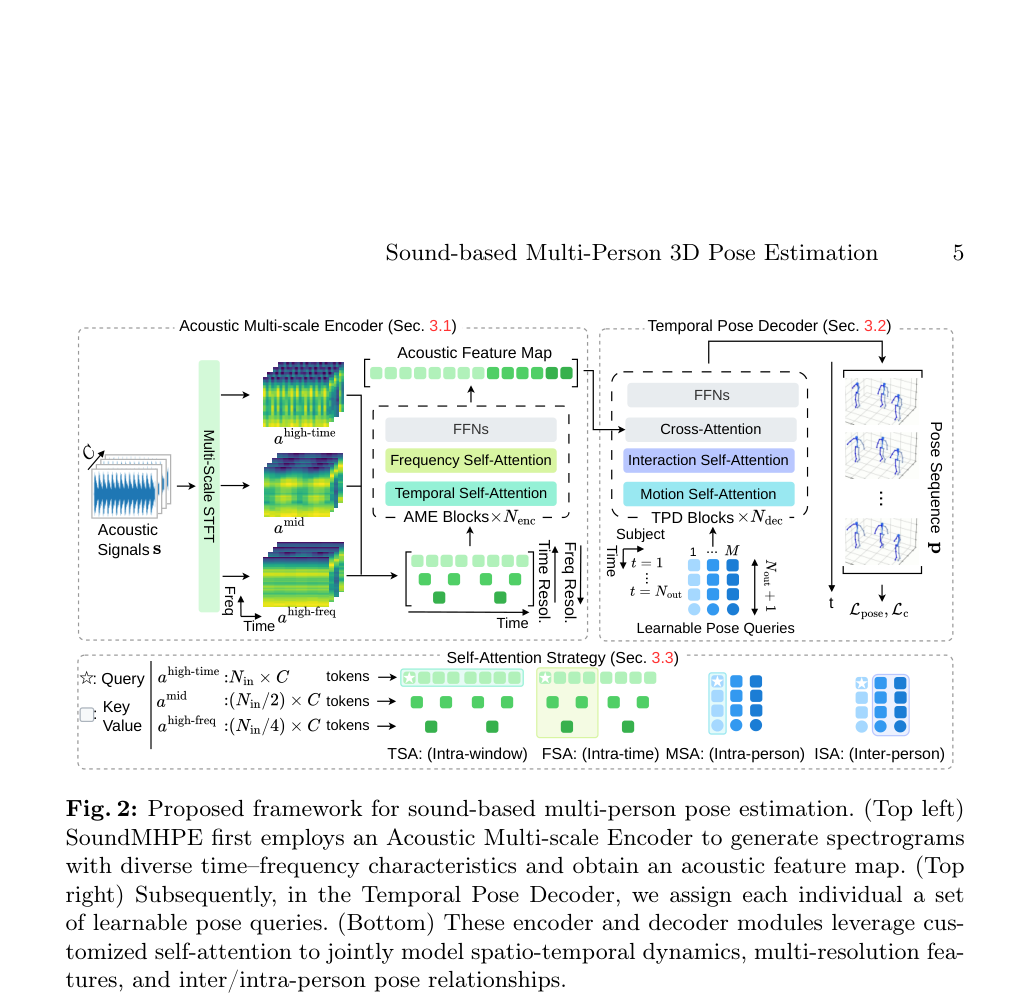
该图详细展示了 SoundMHPE 的框架,包括 Acoustic Multi-scale Encoder 和 Temporal Pose Decoder 的结构,以及它们如何通过定制自注意力机制联合建模时空动态和多分辨率特征。
最强结论
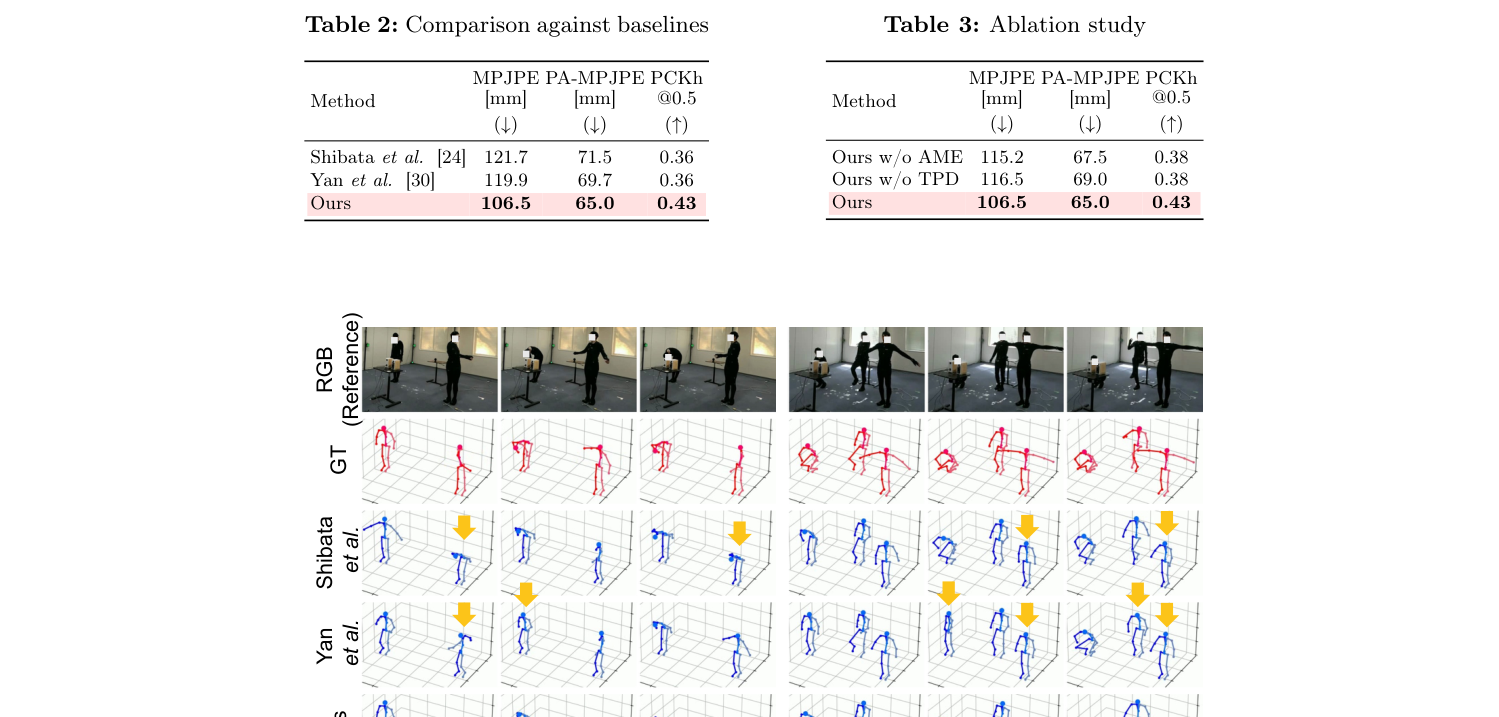
该表展示了 SoundMHPE 与基线模型在 AMP 数据集上的定量对比,验证了其在多人场景下的优越性。
Fig
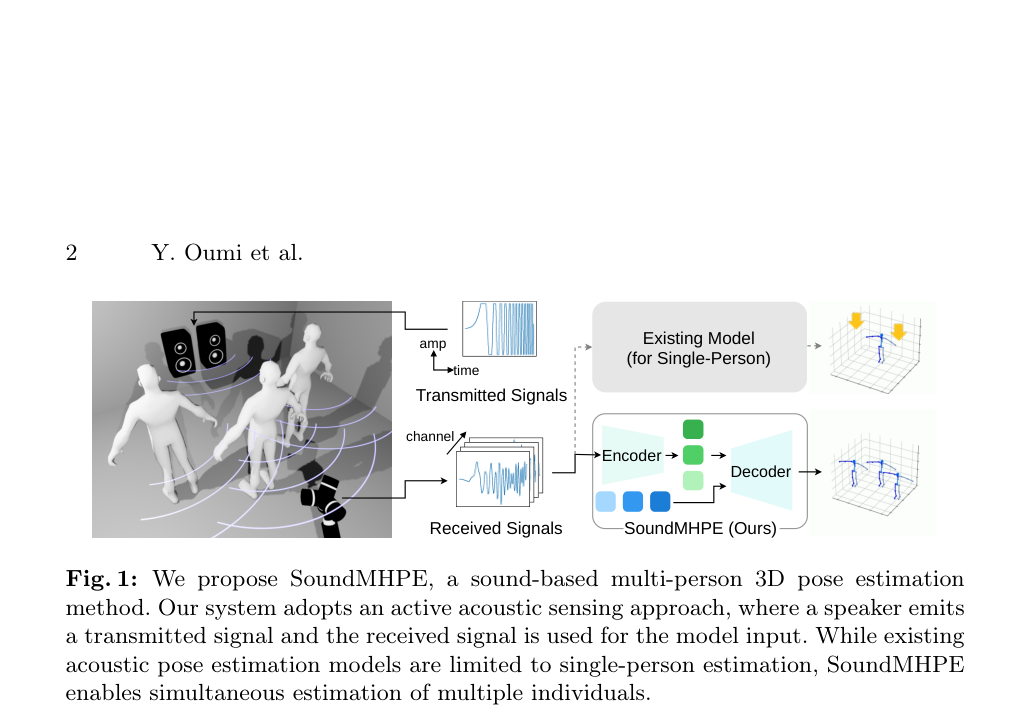
该图展示了 SoundMHPE 的整体系统架构,包括主动声学传感的发射与接收过程,以及多人姿态估计的输出。它直观地说明了该方法与单人声学姿态估计的区别。
实验如何设计?
- 在自建的 AMP 数据集上与基线模型(Adapted Shibata et al., Repurposed Yan et al.)进行对比。
- 消融实验验证 AME 和 TPD 的有效性,分析单人与三人场景下的性能差异。
- 在未见过的声学反射环境(添加隔板)中测试泛化能力,并在 Person-in-WiFi 3D (PiW) 数据集上进行跨模态评估。
关键结果与论文证据
- SoundMHPE 在 AMP 数据集上显著优于基线模型,MPJPE 达到 106.5 mm,而基线模型约为 120 mm(Page 11)。
- 消融实验表明,移除 AME 或 TPD 都会导致性能下降,验证了两个模块的必要性(Page 11)。
- 单人与三人场景下,SoundMHPE 的 MPJPE 分别为 95.0 mm 和 111.2 mm,表明其能处理多人场景(Page 13)。
- 多尺度 STFT 窗口选择(L, 2L, 4L)比单一窗口(L/4, L/2, L)性能更优,MPJPE 分别为 106.5 mm 和 118.5 mm(Page 14)。
- 在 PiW 数据集上,SoundMHPE 的 MPJPE 为 122.6 mm,优于 PiW 单人(127.4 mm)和多人(161.0 mm)基线(Page 15)。
阅读时需要注意
- 实验主要在受控的室内环境(消音室/低背景噪声)中进行,实际部署面临挑战。
- 数据集规模相对较小(6小时,15名参与者),缺乏大规模多样化数据验证。
- 在未见过的强反射环境中,虽然能估计粗略姿态,但精度可能下降。
关联工作
- Shibata et al. [24] 是 prior acoustic single-person pose estimation,用作基线。
- Yan et al. [30] 是 WiFi-based multi-person pose estimation,用作基线和跨模态基准。
- DETR [3] / Snipper [35] 启发了 query-based decoder 设计和时空建模。