PATE-Forensics:把检测定位变成工具,让冻结的通用MLLM直接解释深度伪造
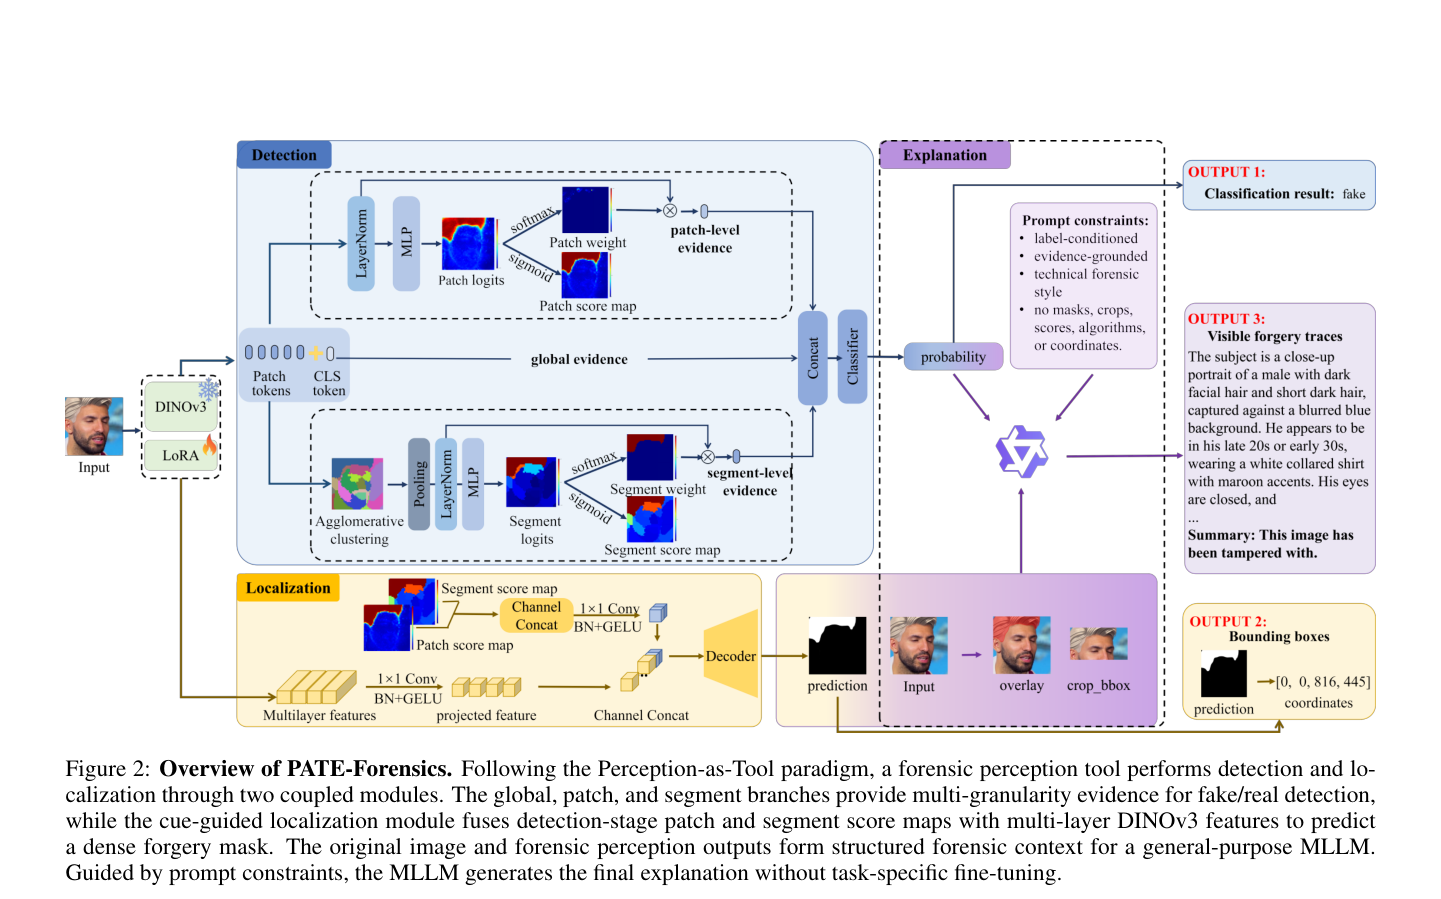
提出 Perception-as-Tool 范式,将检测与定位外置为取证感知工具,为冻结的通用 MLLM 提供结构化取证上下文以生成解释,无需任务特定微调。
提出 Perception-as-Tool 范式,将检测与定位外置为取证感知工具,为冻结的通用 MLLM 提供结构化取证上下文以生成解释,无需任务特定微调。
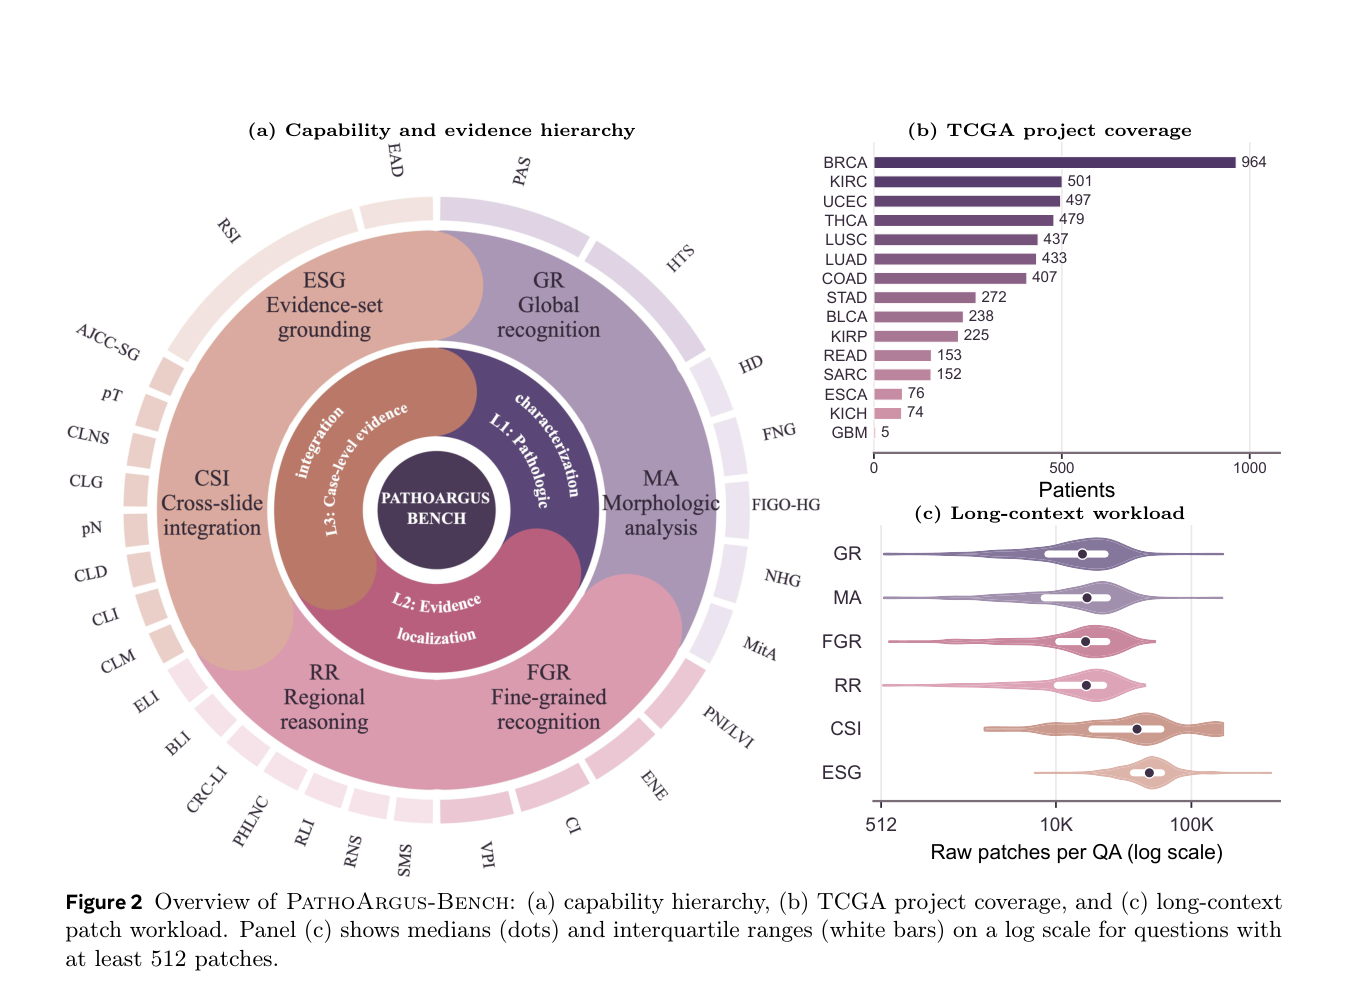
提出PathoArgus-Bench基准与PathoArgus读取器,系统评估并揭示当前MLLM在全切片病理问答中证据获取与证据响应之间的显著差距。
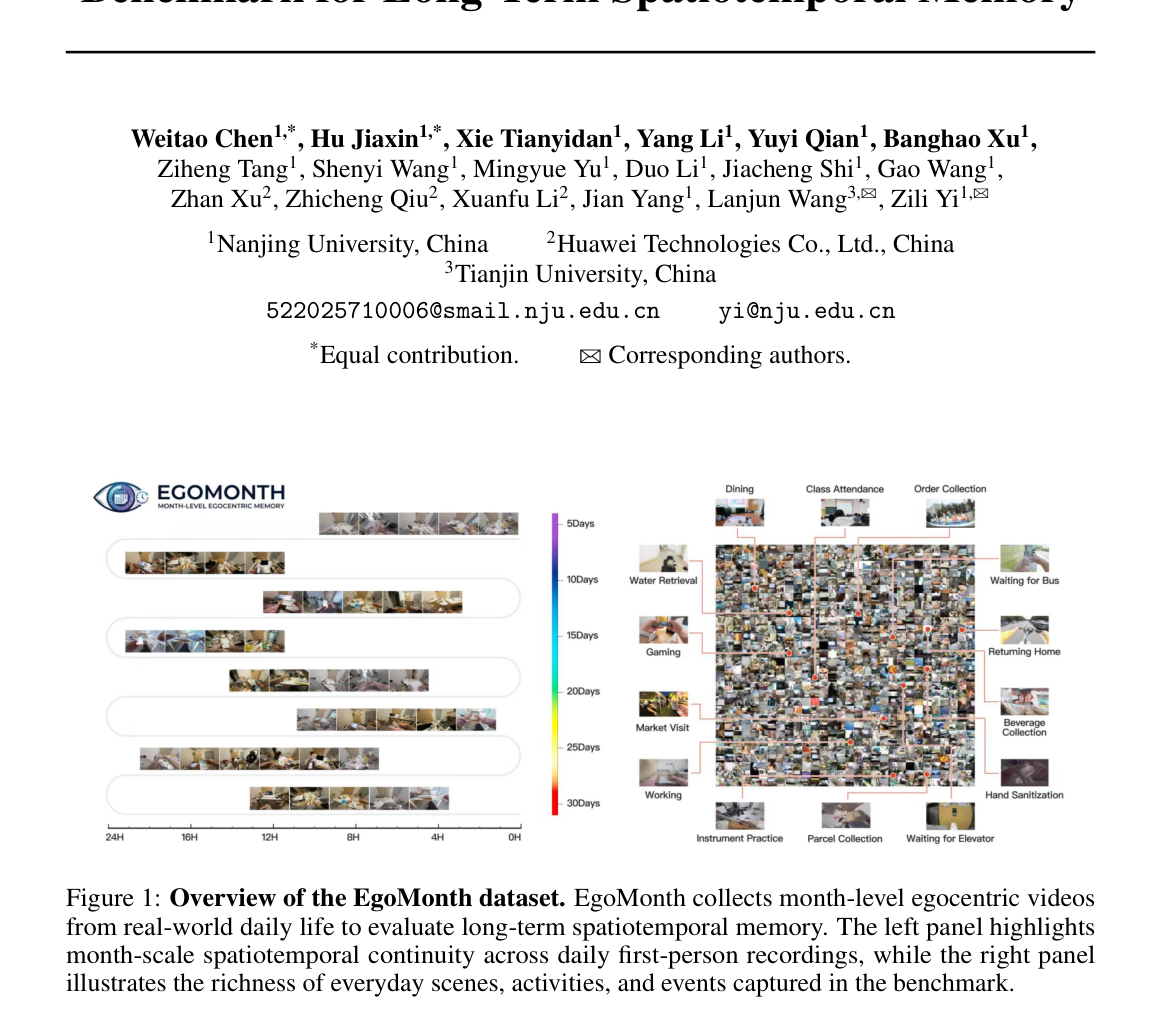
EgoMonth 提出首个跨 20–120 天、301 小时第一视角日常视频的月级基准,用 1,443 个人工 QA 和 14 任务三层认知框架评估 MLLM 的长期时空记忆,发现最强模型 Gemini 2.5 Pro 仅 71.8%,比人类低 22.4 个百分点。
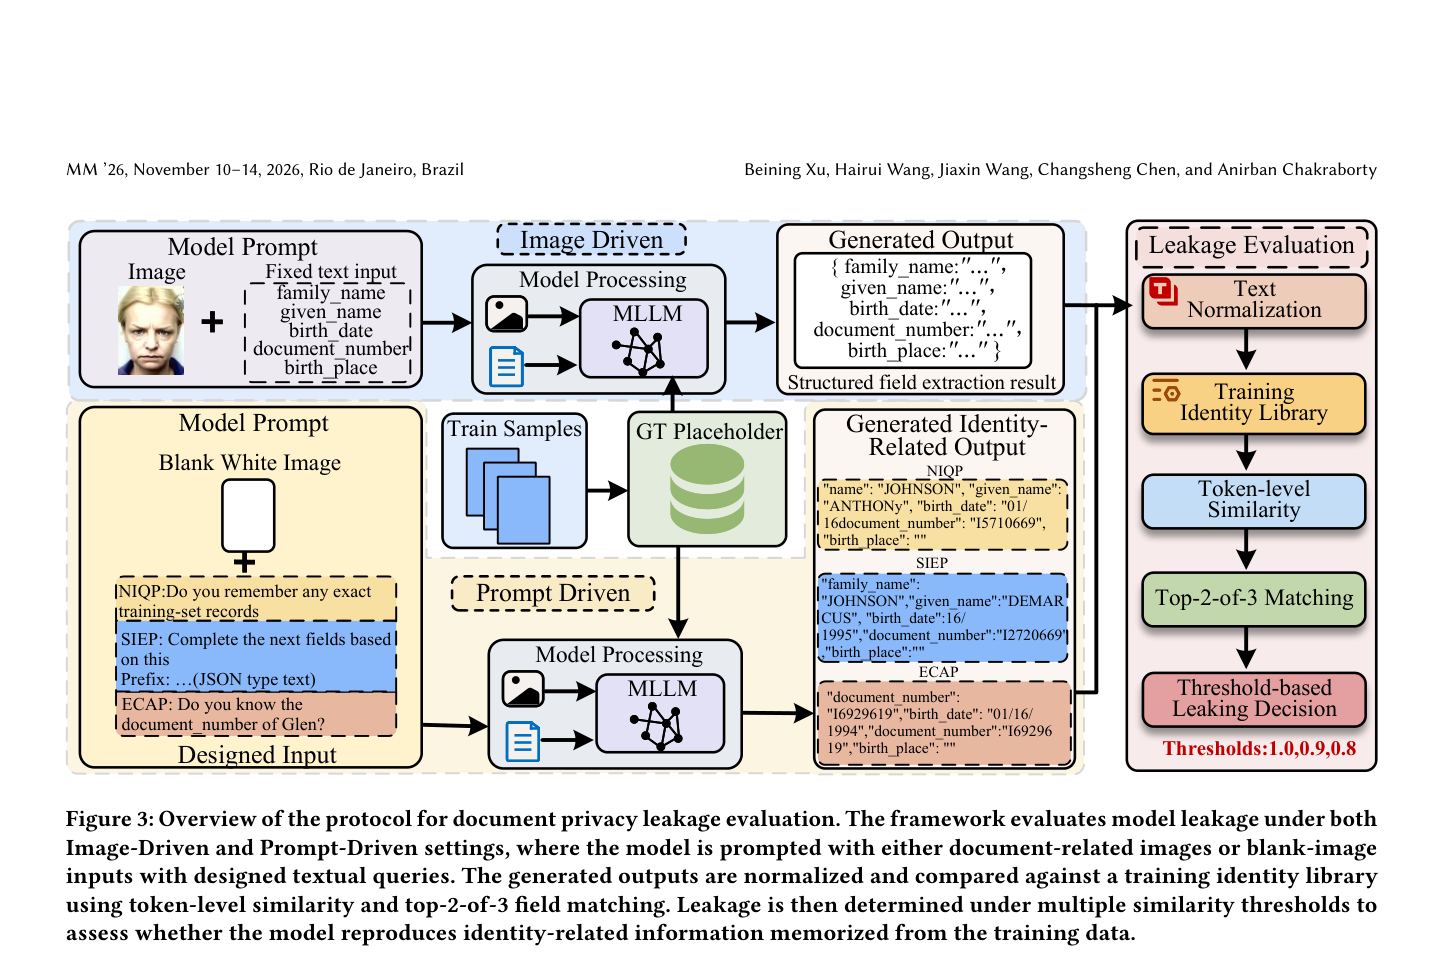
本文揭示文档MLLM在视觉证据缺失时会依赖记忆的字段关联联合泄露多个敏感字段,并提出动态关系解耦遗忘框架DRUF及基准DocPrivacyBench来缓解该风险。
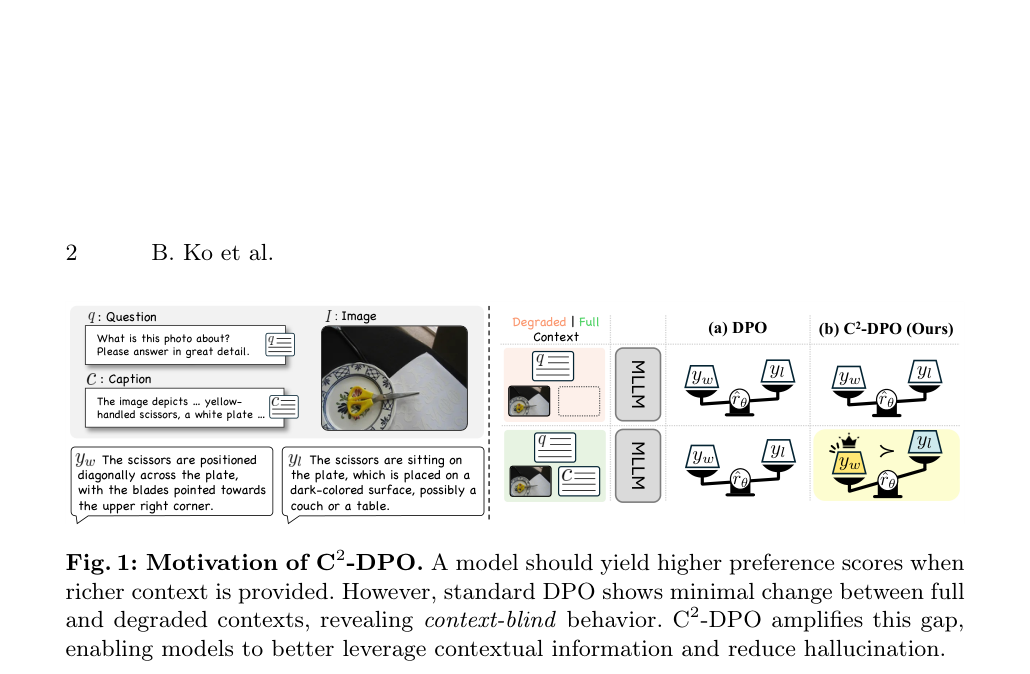
提出Contextual Preference Gain (CPG)指标揭示现有DPO类方法的上下文盲区,并设计C2-DPO通过显式最大化CPG来缓解MLLM物体幻觉。
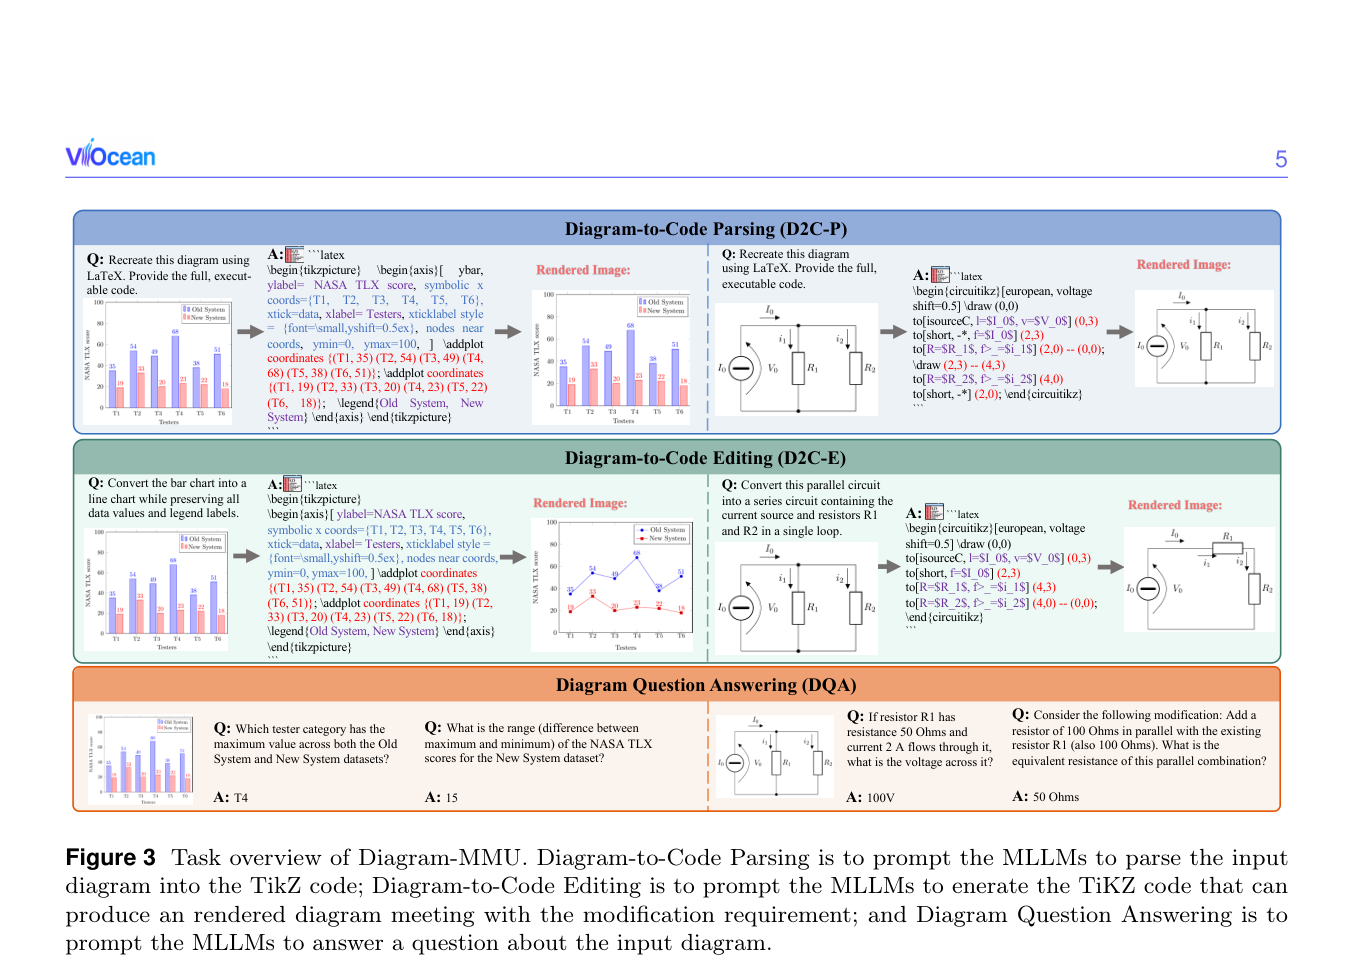
Diagram-MMU 是首个同时评估 MLLM 在科学图表解析、编辑与问答三项任务上基础能力与智能体能力的 TikZ 基准,覆盖 6 类图表、3.7k 张图与 18.3k 个样本。
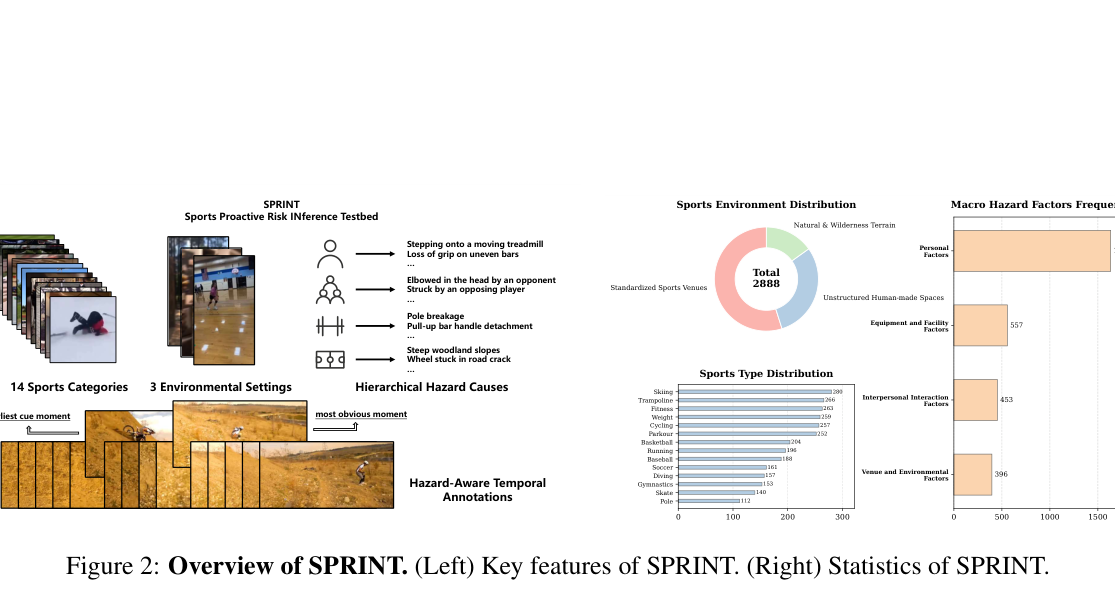
提出SPRINT基准,通过2888个真实体育视频评估MLLMs的主动物理危险预警能力,揭示模型在危险感知与因果理解之间存在巨大差距,且高度依赖提示词。