视觉语言模型思维链忠实性反事实测试
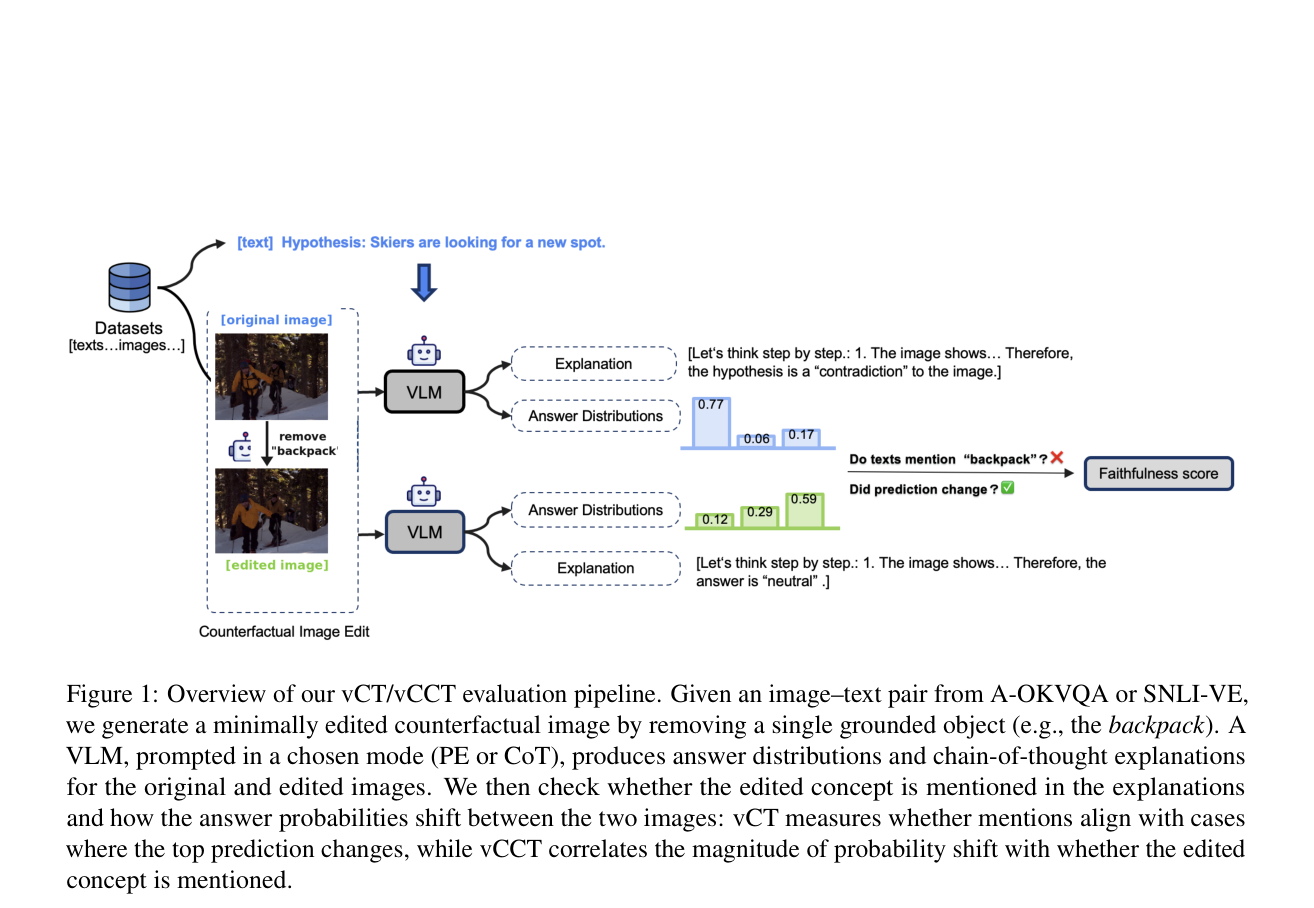
本文提出了vCT和vCCT两种反事实评估指标,通过移除图像中的特定对象来测试VLM的解释是否忠实于其预测变化,发现Predict-then-Explain (PE) 策略比Chain-of-Thought (CoT) 更忠实于视觉证据。
本文提出了vCT和vCCT两种反事实评估指标,通过移除图像中的特定对象来测试VLM的解释是否忠实于其预测变化,发现Predict-then-Explain (PE) 策略比Chain-of-Thought (CoT) 更忠实于视觉证据。
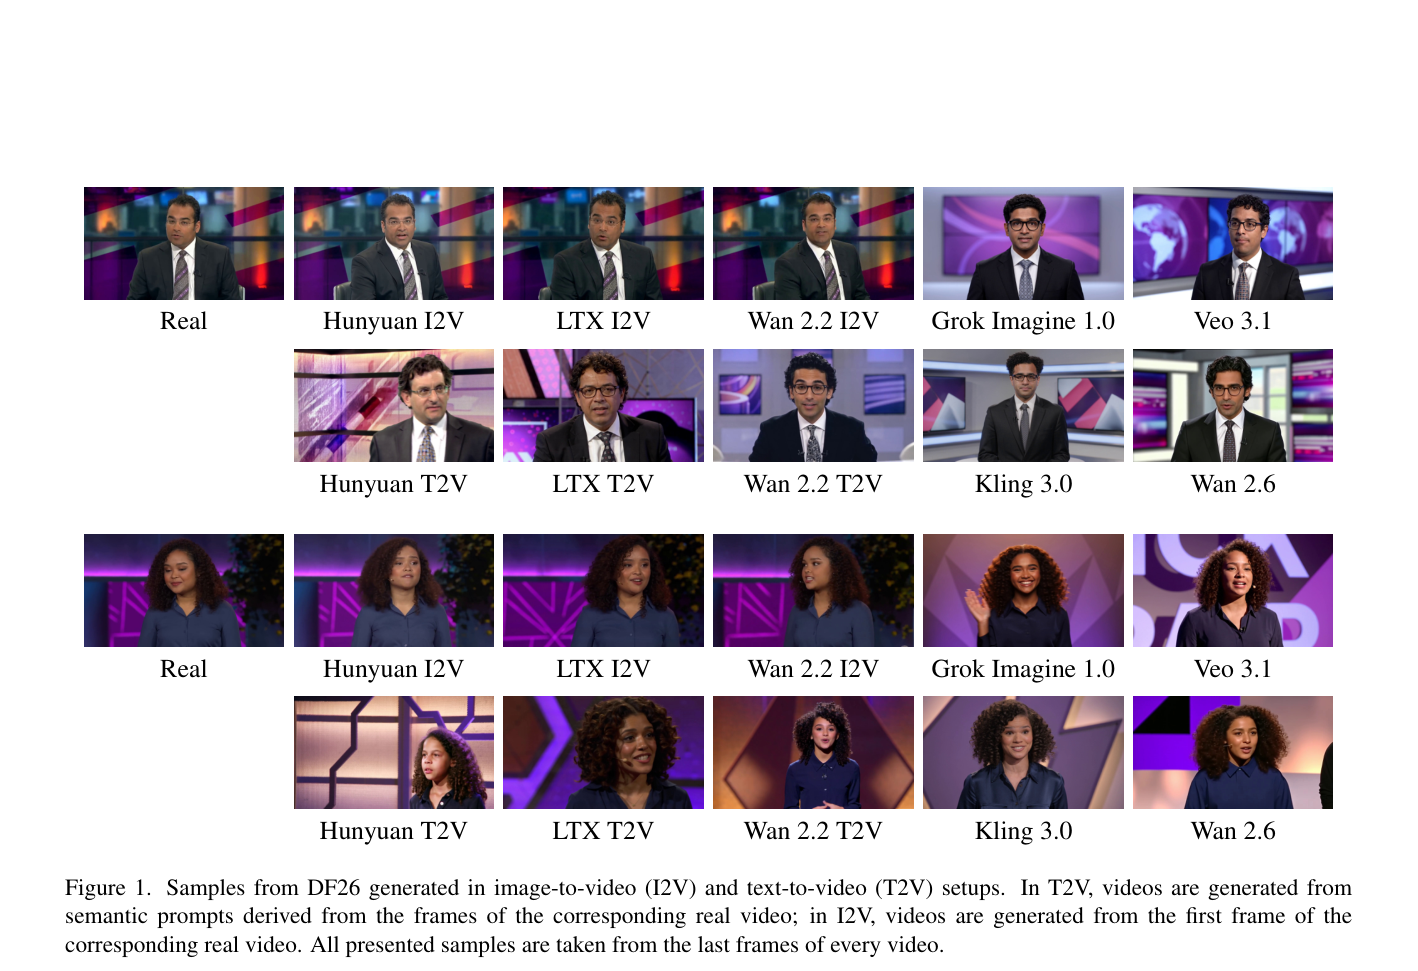
本文提出 DF26 基准,包含由最新 T2V/I2V 模型生成的单人公开演讲视频,显示当前 SOTA 检测器与人类在识别这些 AI 生成视频时性能接近随机猜测。
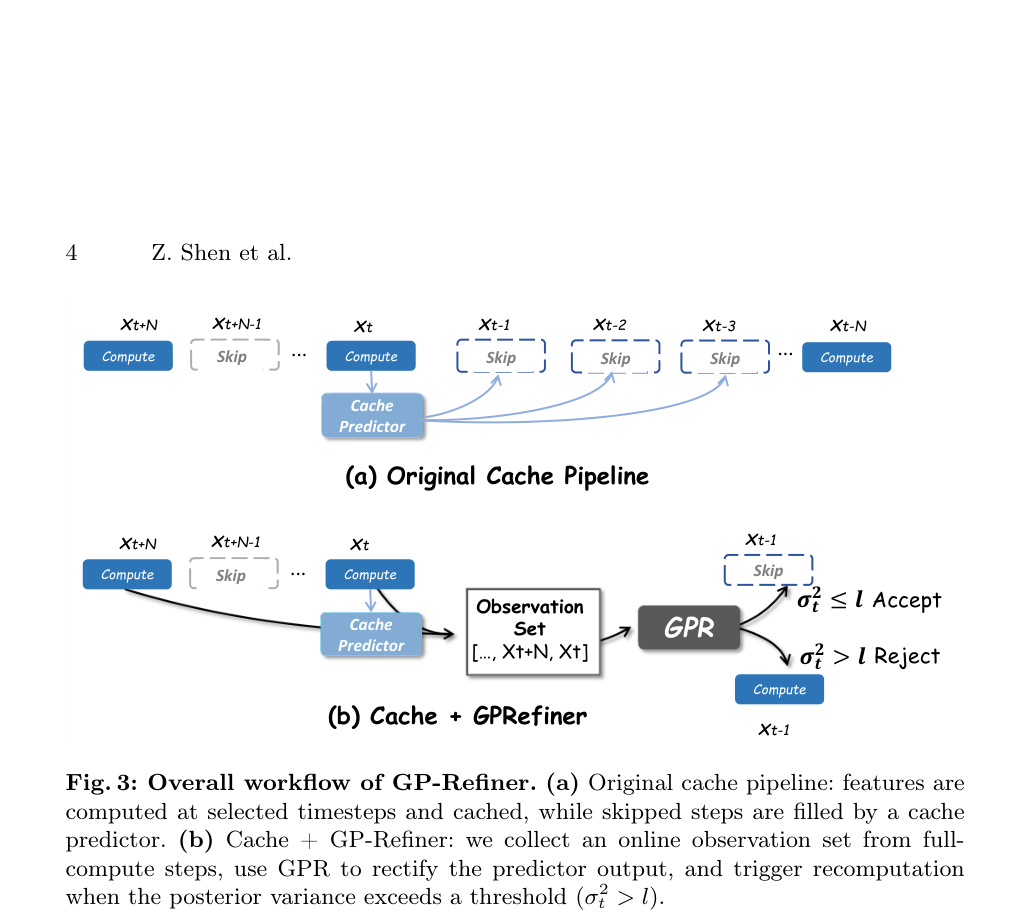
本文提出GP-Refiner,利用高斯过程回归(GPR)校正扩散模型特征缓存中的累积误差,并通过后验方差实现自适应重计算,在保持生成质量的同时显著提升推理速度。
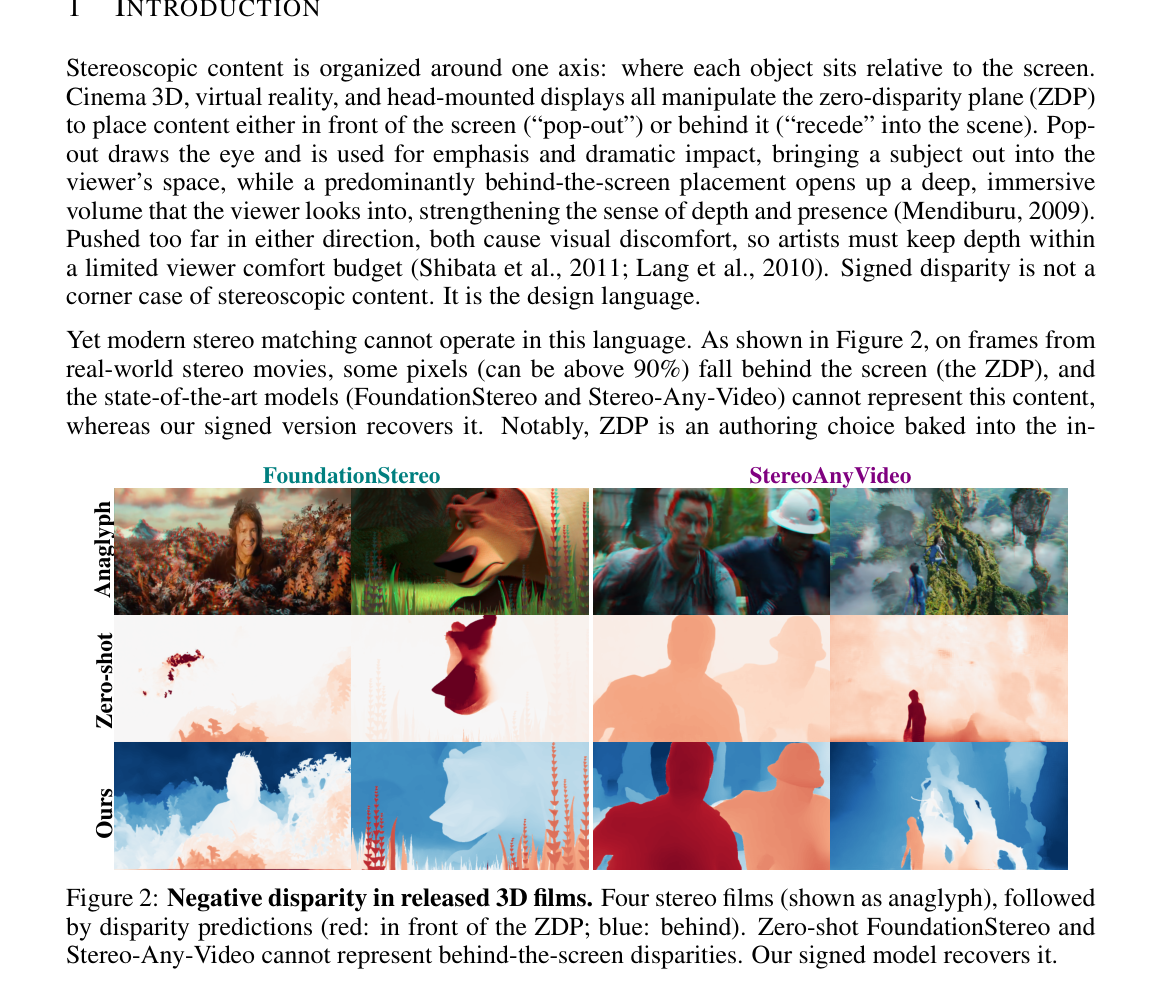
本文提出 ZDPShift 基准和轻量级修改方法,解决了现有立体匹配模型无法处理负视差(屏幕后内容)的问题,证明预训练特征已具备符号无关性,仅需调整输出约定即可恢复负视差估计能力。
本文提出Spectral Tension作为诊断视频生成中时间注意力失衡的指标,并设计Spectral Transport Homeostasis这一无训练查询温度调节器,通过选择性纠正碎片化传输和过度混合热点来提升视频的时间一致性和视觉质量。
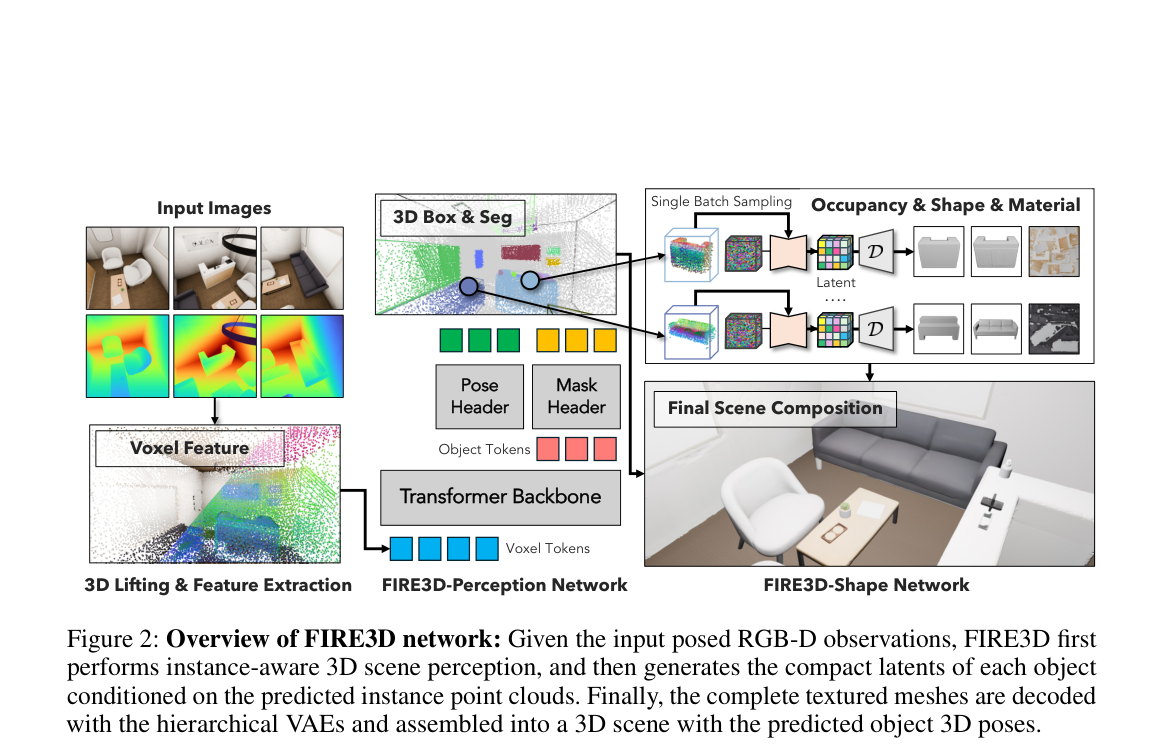
FIRE3D 提出了一种统一的前馈框架,能够从单张RGB图像或随意拍摄的RGB视频中,在60秒内重建出包含完整几何、纹理和6-DoF位姿的仿真就绪3D场景资产,无需测试时优化或额外标注。
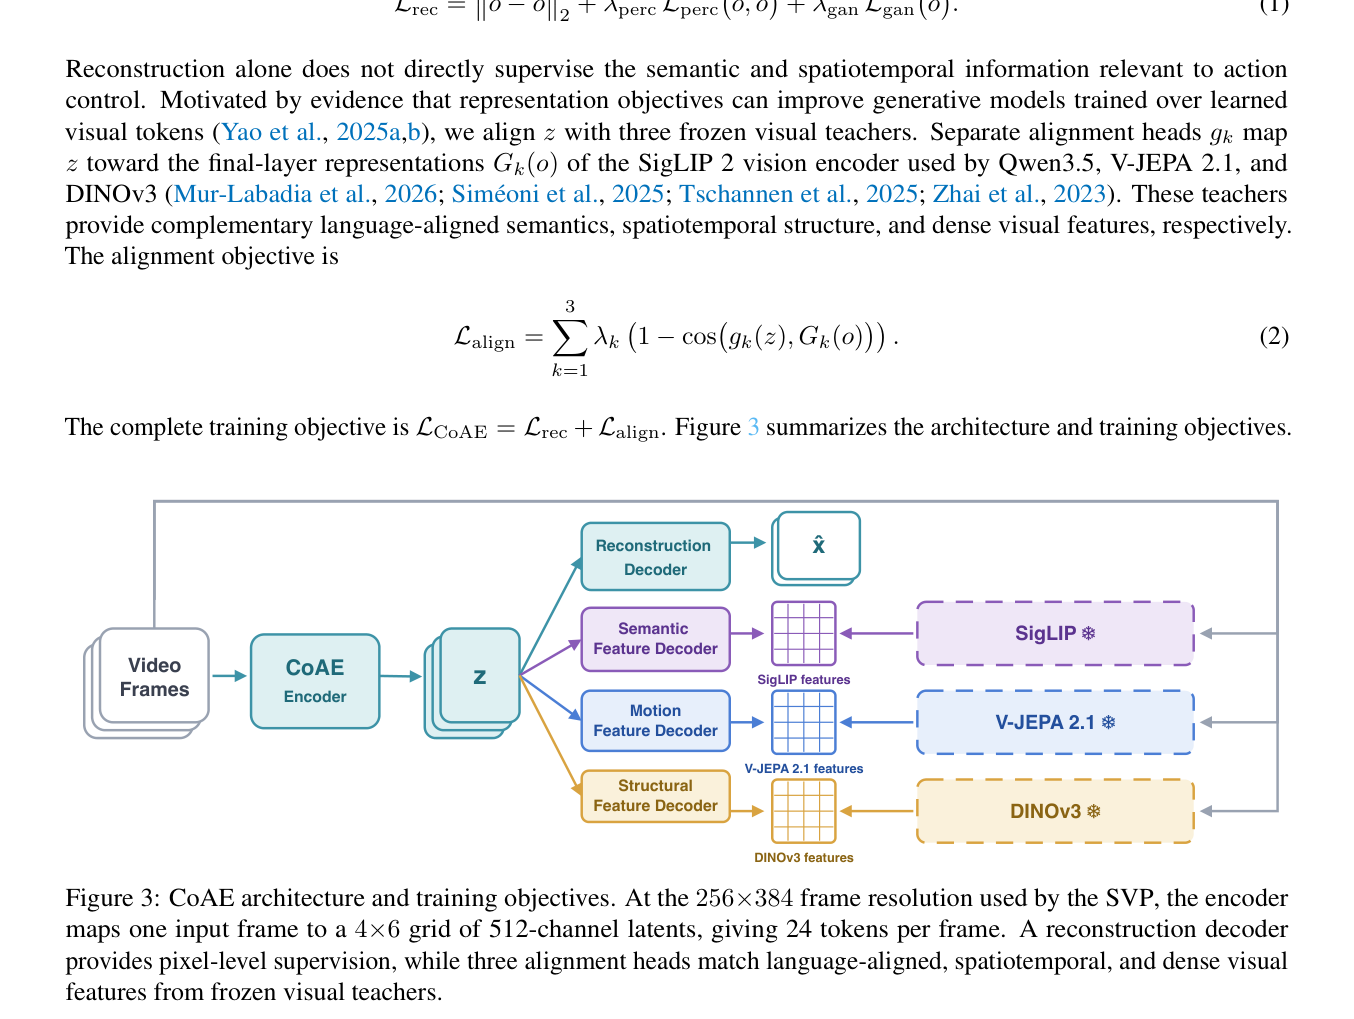
GE-Act 2.0 提出了一种从零开始在操作数据上预训练的 World-Action 模型,通过 Control-Oriented Autoencoder (CoAE)、Single-Step Visual Planner (SVP) 和 Knowledge-Aligned Selective Optimization (KASO) 实现了视觉规划与逆动力学模型的解耦预训练及高效协同训练,显著提升了零样本 OOD 操作成功率。
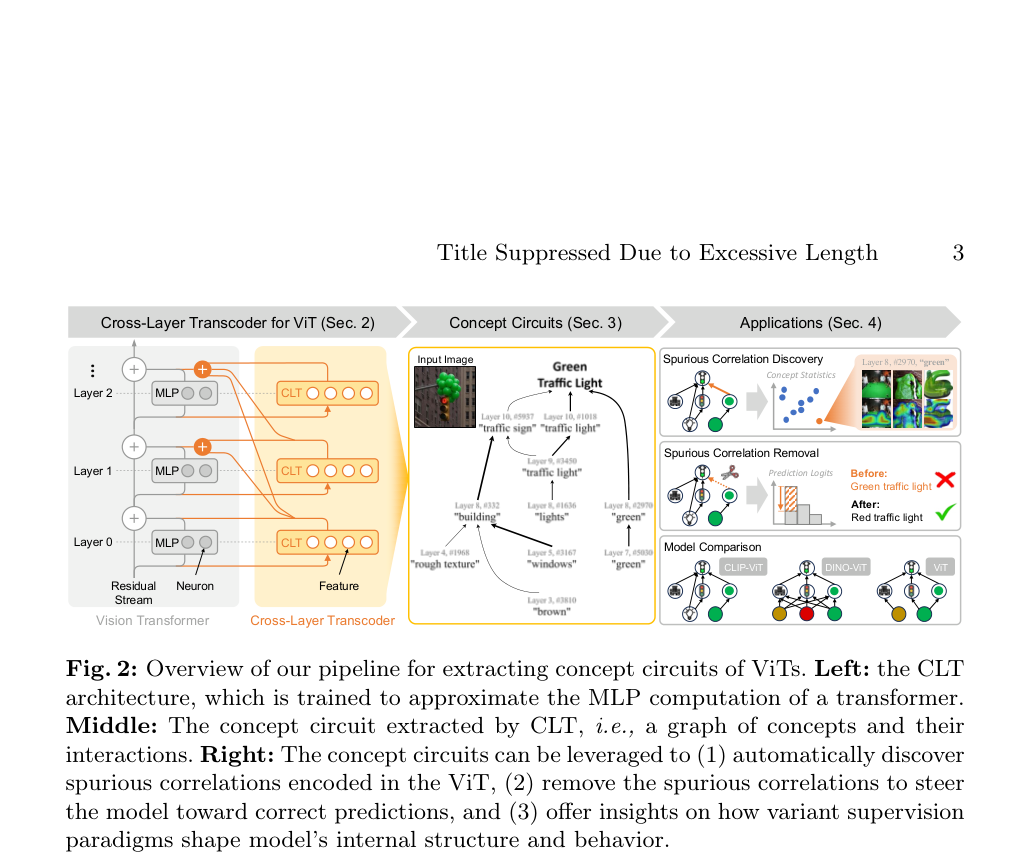
本文提出利用Cross-Layer Transcoders (CLTs)从Vision Transformers (ViTs)中提取全局和实例级概念电路,以揭示模型内部的世界知识、自动发现并移除虚假相关,以及比较不同监督范式下的模型结构差异。
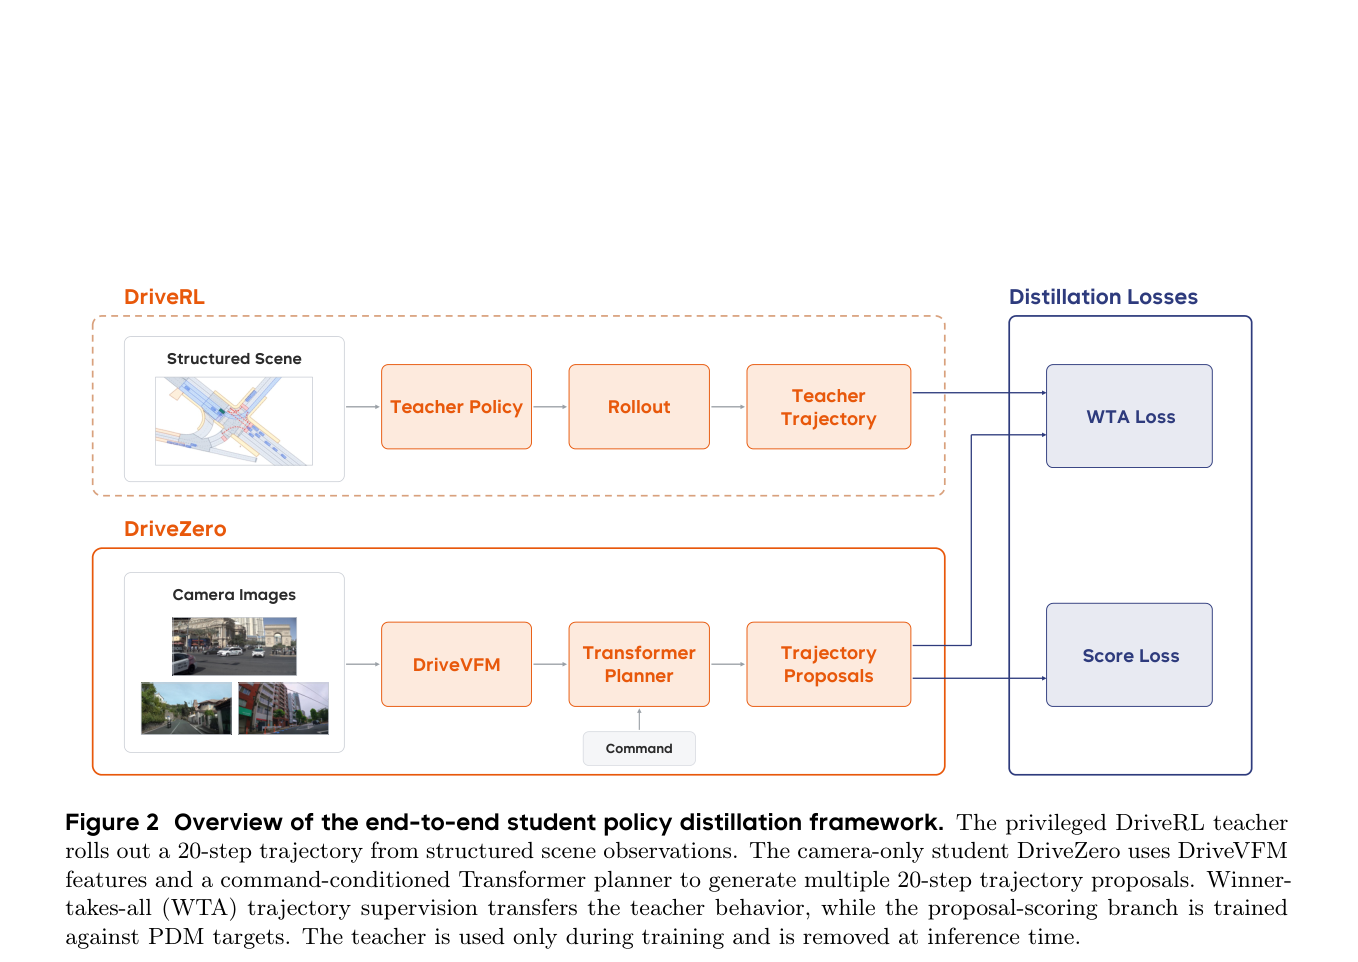
DriveZero 通过解耦预训练(DriveRL 强化学习动作模型 + DriveVFM 视觉基础模型感知骨干)并蒸馏为纯相机端到端策略,在 nuPlan、NAVSIM 和 HUGSIM 基准上实现了超越人类驾驶员及现有 SOTA 的性能,且无需人类轨迹监督。
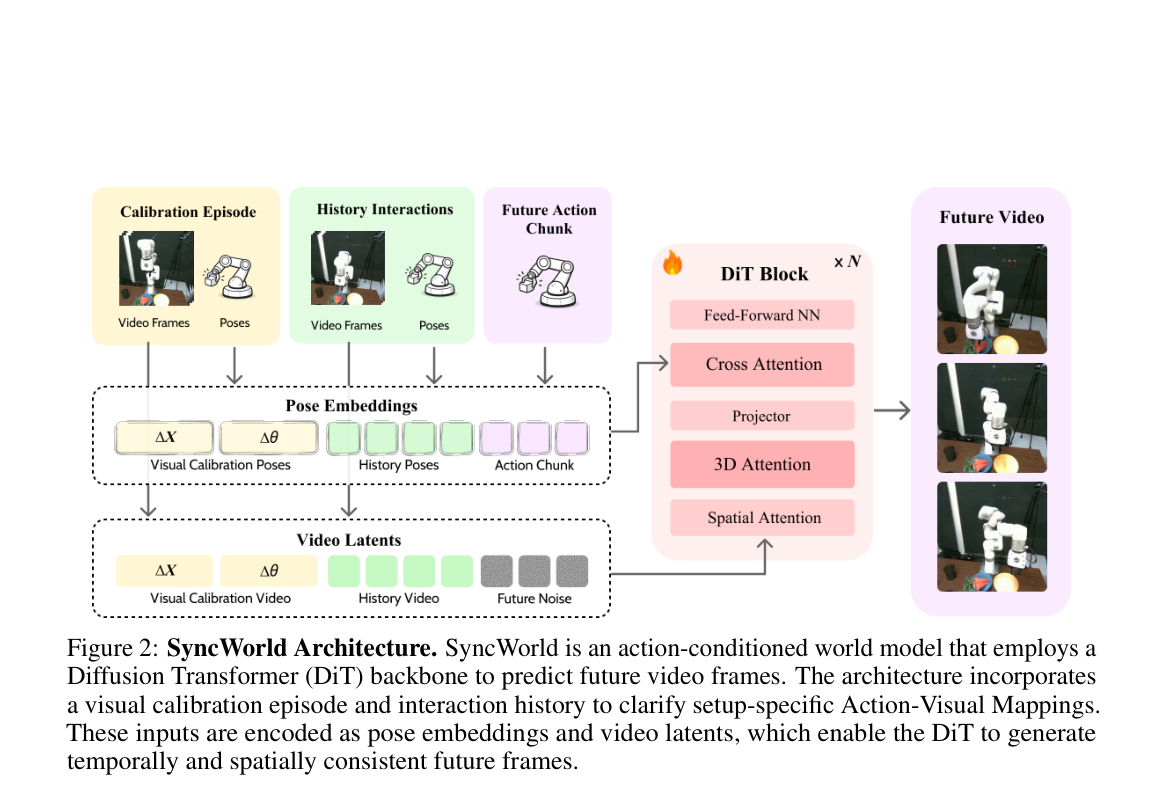
SyncWorld 是一种基于视觉校准的动作条件世界模型,通过上下文中的校准片段解决特定场景下的动作-视觉映射问题,实现跨未见相机视角和机器人本体的零样本模拟及测试时策略改进。