计算机视觉
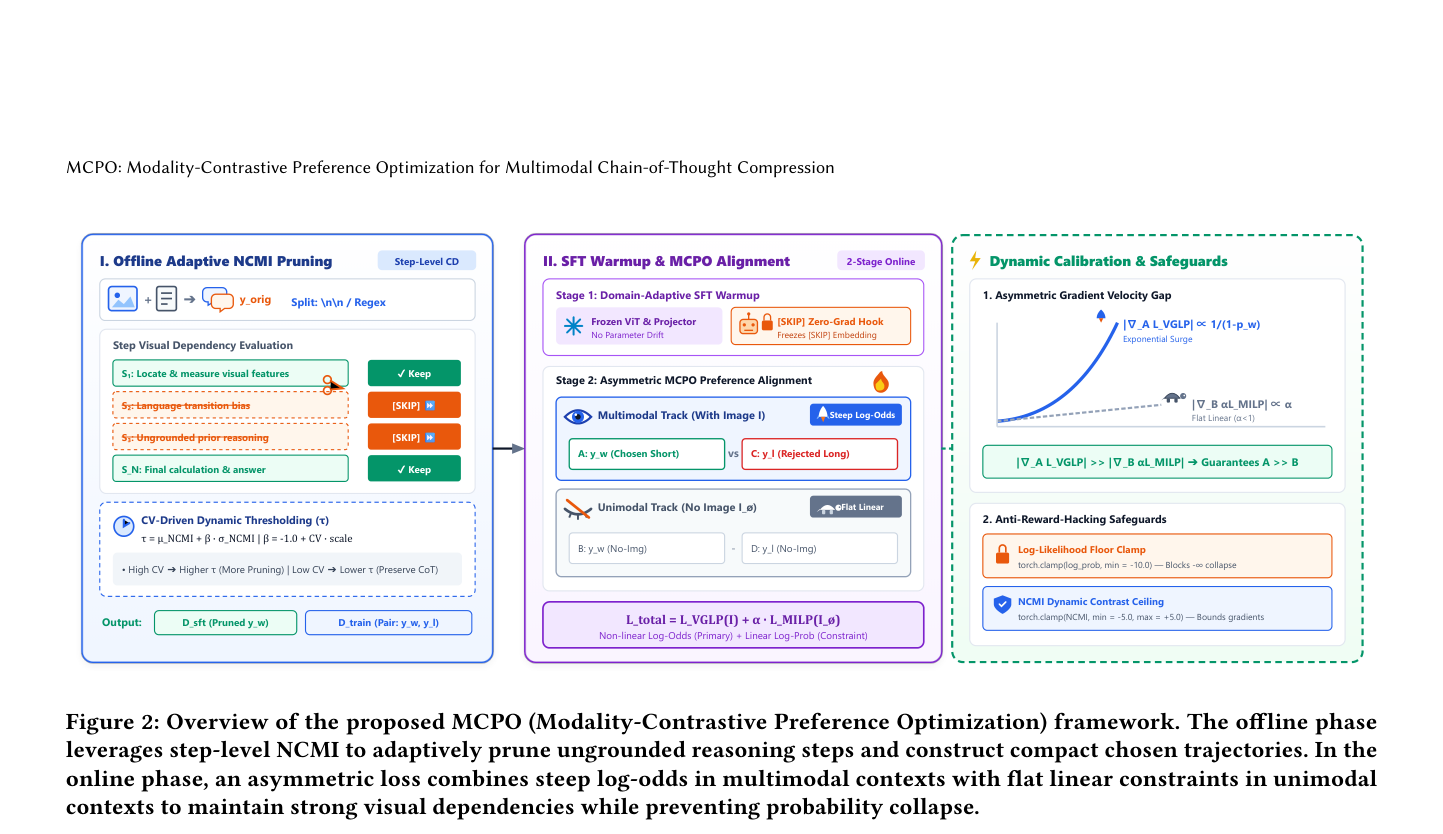
显微镜即掩码:利用前向模型特权信息实现Cryo-ET鲁棒表示学习
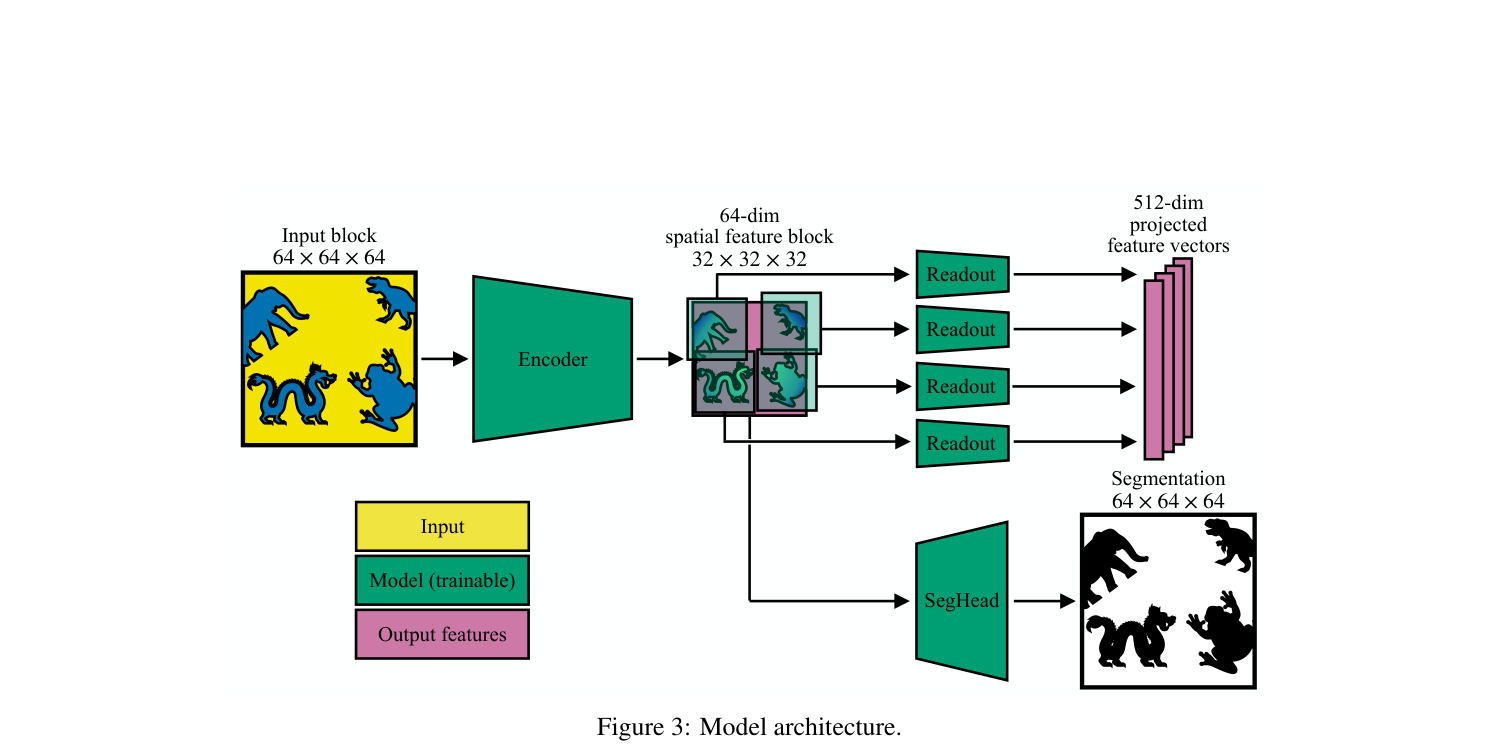
本文提出 CARNIVAL 模型,利用 cryo-ET 前向模型生成的物理配对视图和模拟器提供的特权标签,在 LeJEPA 框架下训练对测量噪声不变的特征表示,在真实数据上的分类和检测任务中优于 TomoTwin。
RoboSPA:VLA模型能否超越简单场景和短视距任务?
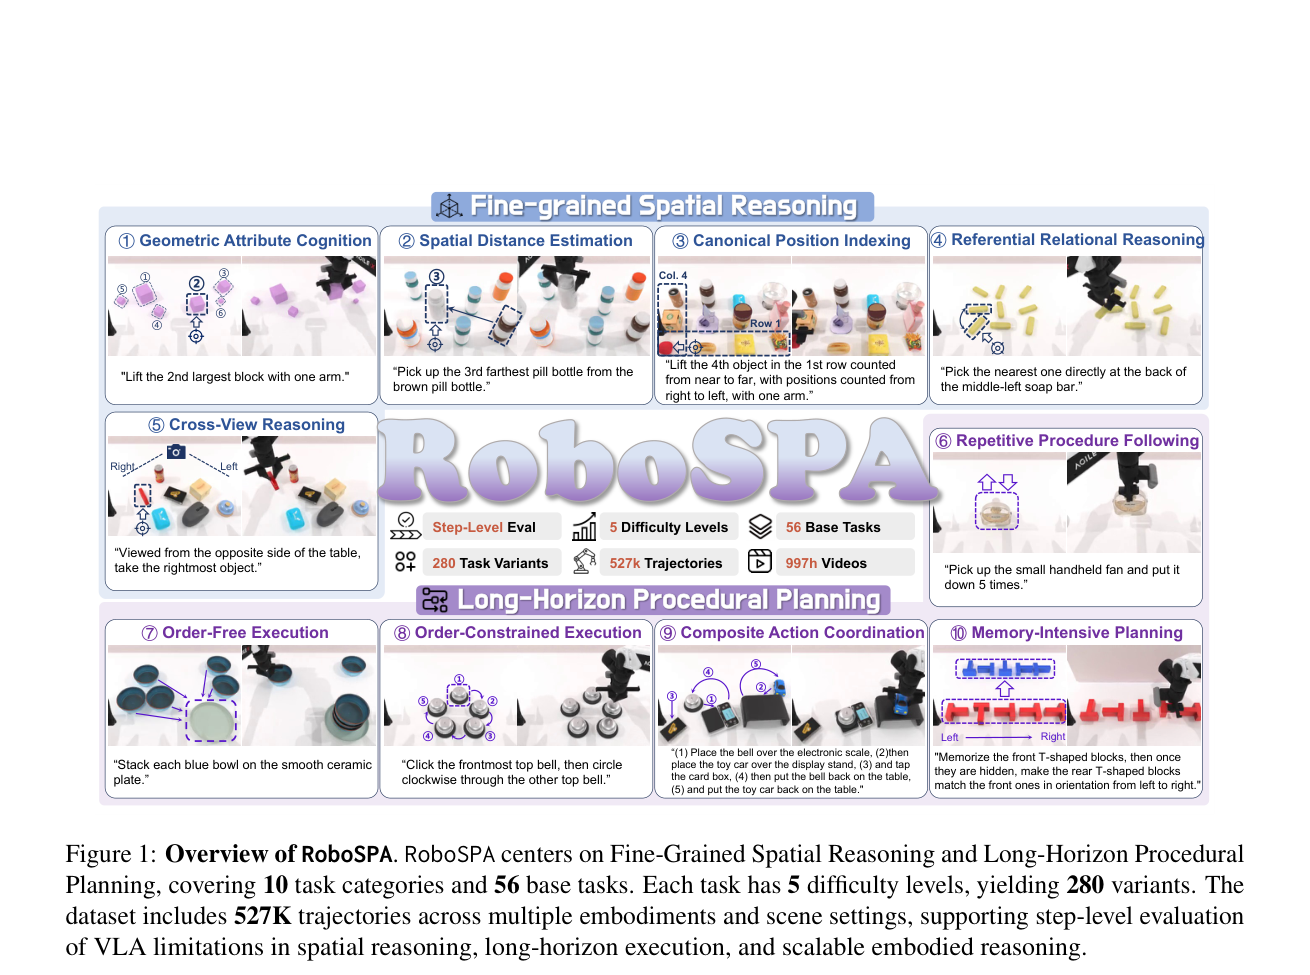
本文提出了RoboSPA,一个专注于细粒度空间推理和长视距程序规划的大规模机器人操作数据集与基准,用于诊断VLA模型在复杂空间关系和长程执行中的局限性。
3DGS 外观建模:从球谐到共享 MLP 的紧凑神经方案
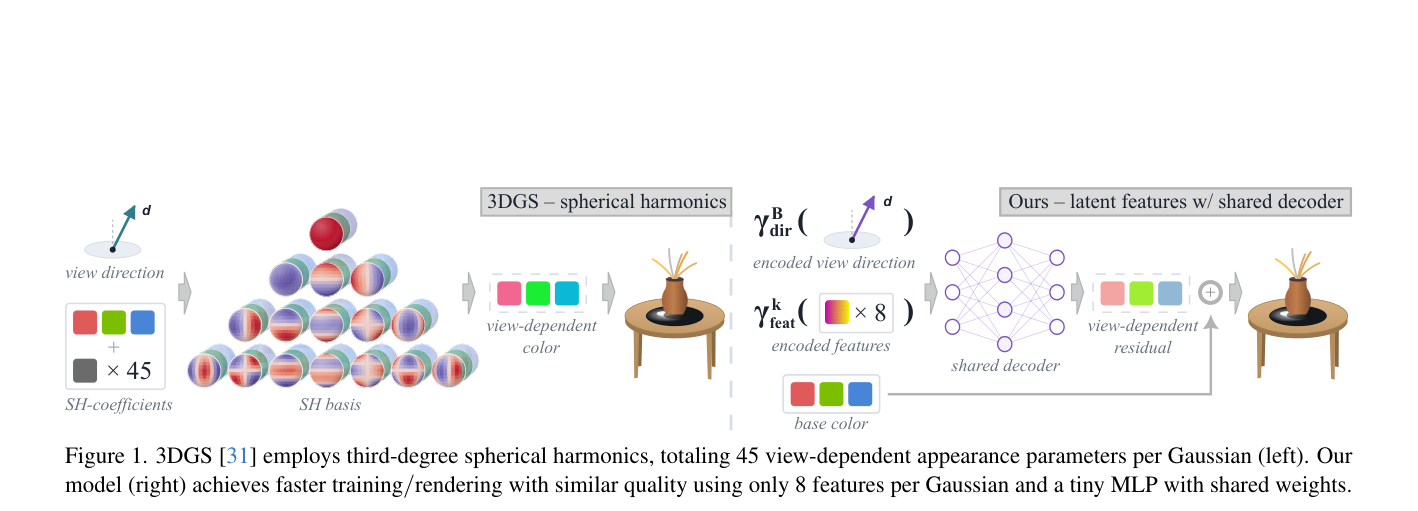
本文提出了一种基于共享 MLP 解码紧凑潜码的神经外观模型,在保持重建质量的同时,将 3DGS 中每个高斯的外观存储从 192 字节减少至 28 字节,并显著提升了优化与渲染效率。
具身智能体如何记住动态物体的长时程运动轨迹?
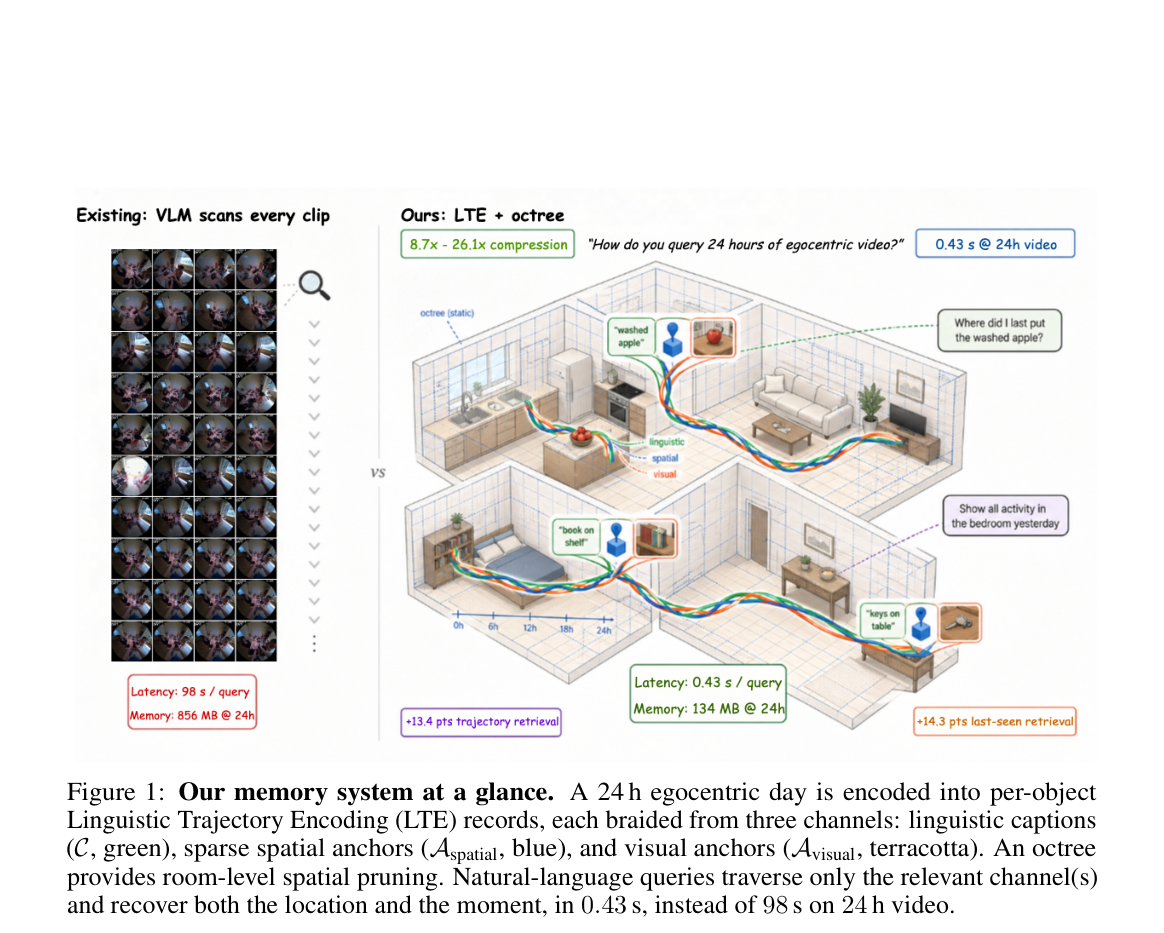
本文提出 Linguistic Trajectory Encoding (LTE) 和 Spatial Memory Benchmark (SMB),通过结合语言描述、稀疏空间锚点和视觉锚点的混合表示,实现了对动态物体长时程运动历史的高效压缩与查询,在 Ego4D 和 EgoLife 数据集上显著优于现有基线。
What Moves? 用于组合场景控制的局部化运动表示
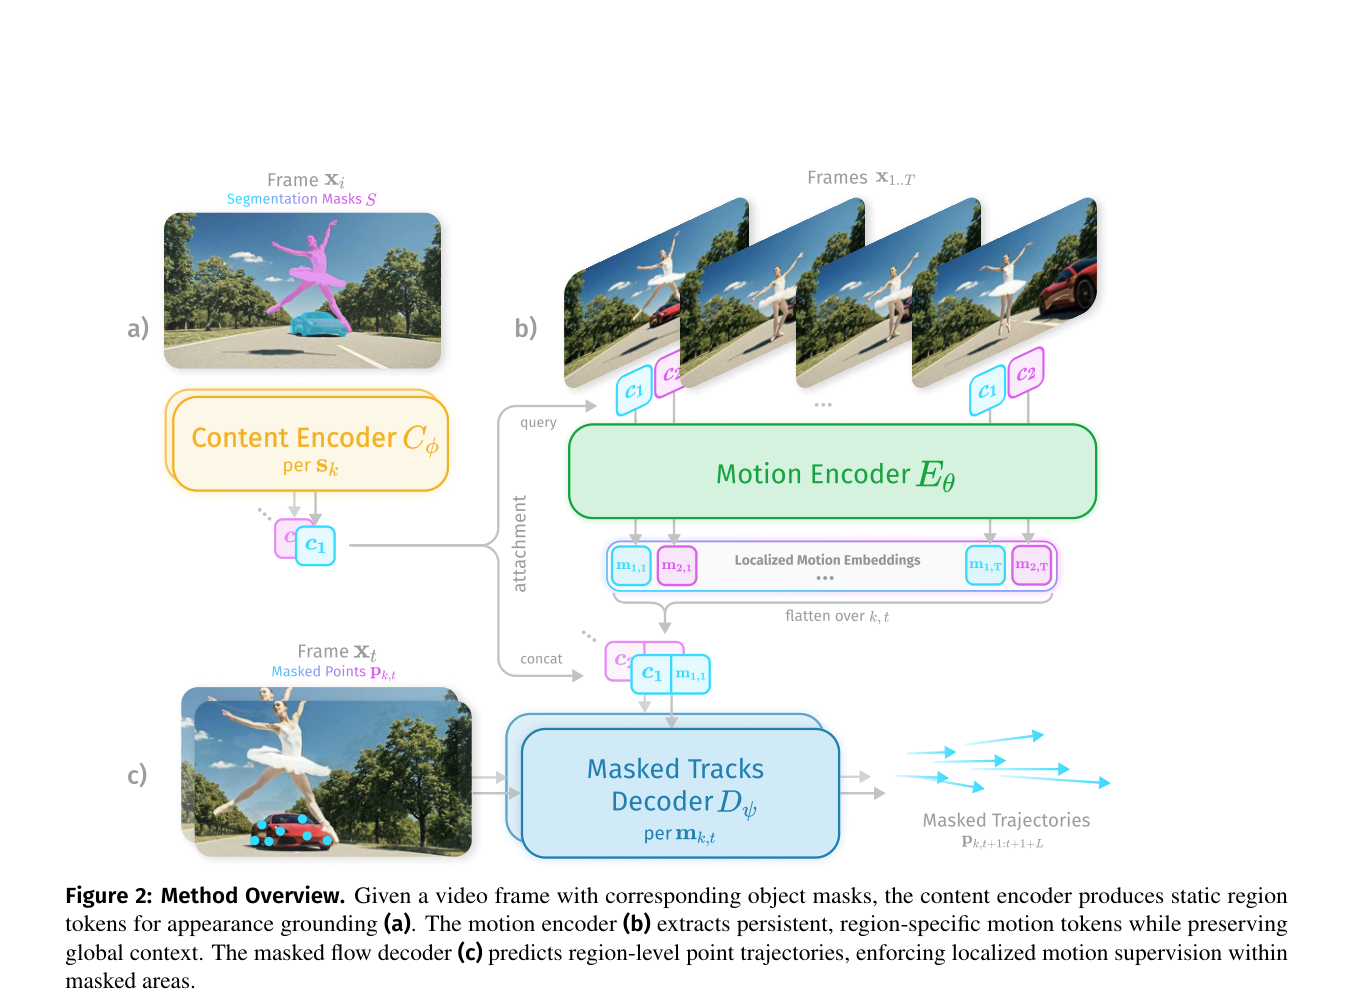
本文提出了一种可提示的局部化运动表示方法,通过在全局视频上下文中提取特定区域的运动嵌入,实现了高精度的对象级运动迁移与组合场景生成,并在局部动作分类任务中优于基于裁剪或掩码的全局方法。
天气条件化的 Depth Anything
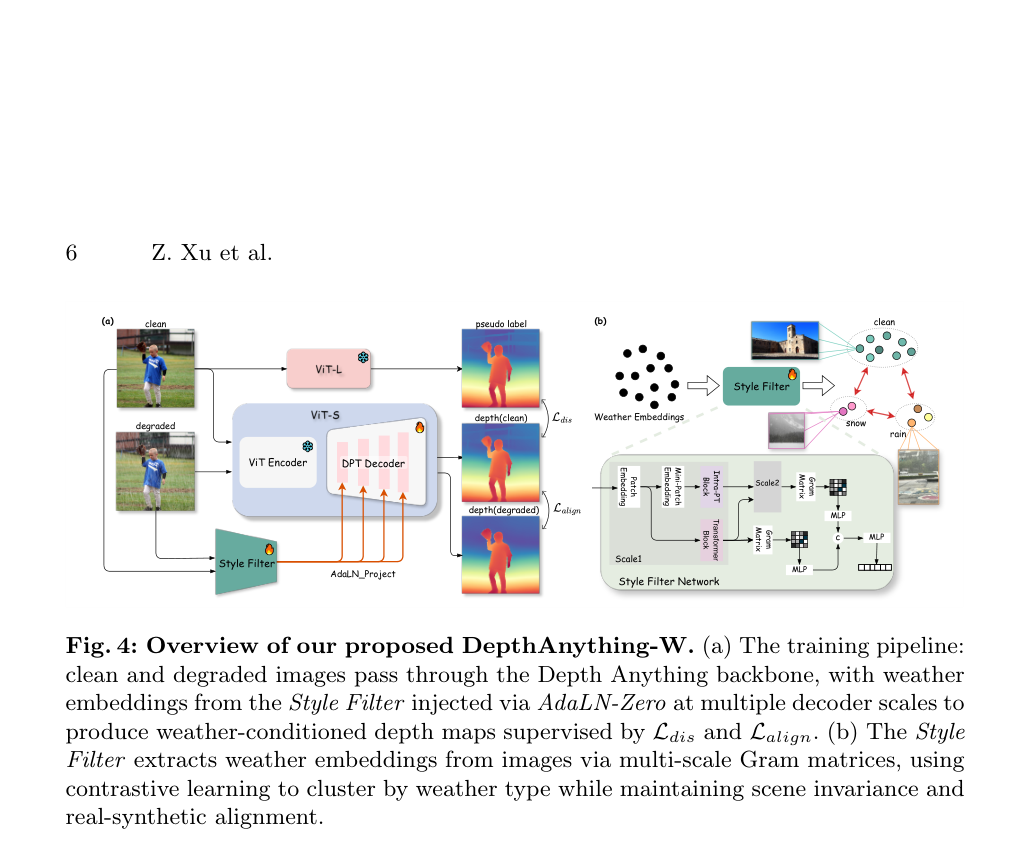
提出 DA-W 框架,通过 Style Filter 提取天气嵌入并利用 AdaLN-Zero 注入 Depth Anything 解码器,在保持清洁场景性能的同时显著提升恶劣天气下的单目深度估计鲁棒性。
扩散Transformer的重要性感知低秩蒸馏
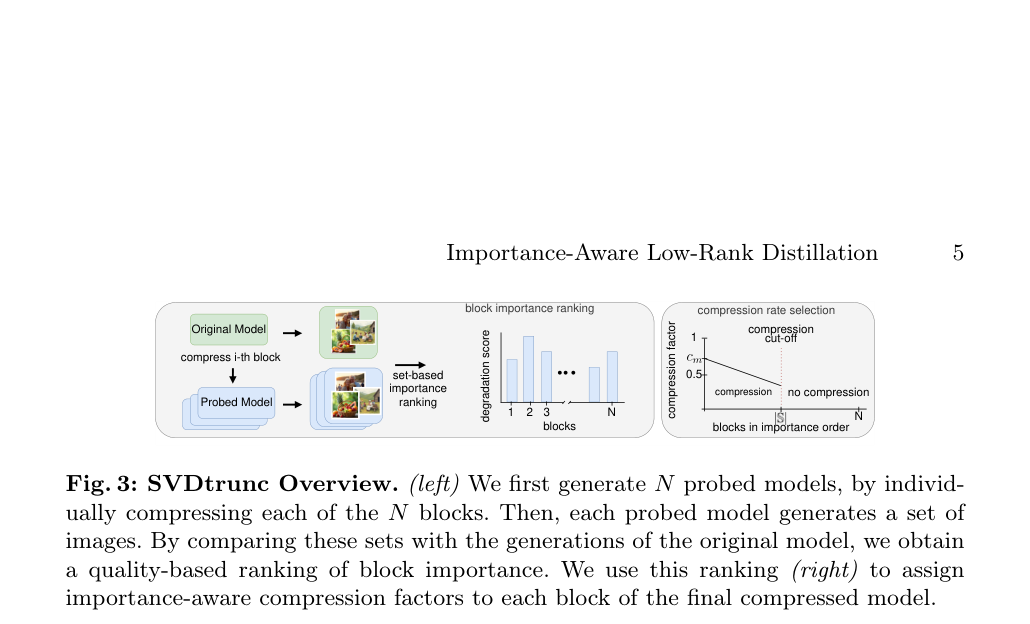
本文提出SVDtrunc,通过重要性感知的截断SVD压缩投影矩阵并结合模块化知识蒸馏,在保持Diffusion Transformer架构不变的前提下实现高效参数压缩,显著优于现有剪枝方法。
当视觉压倒认知:VLM个性化安全中的视觉主导性与基于延迟的方法
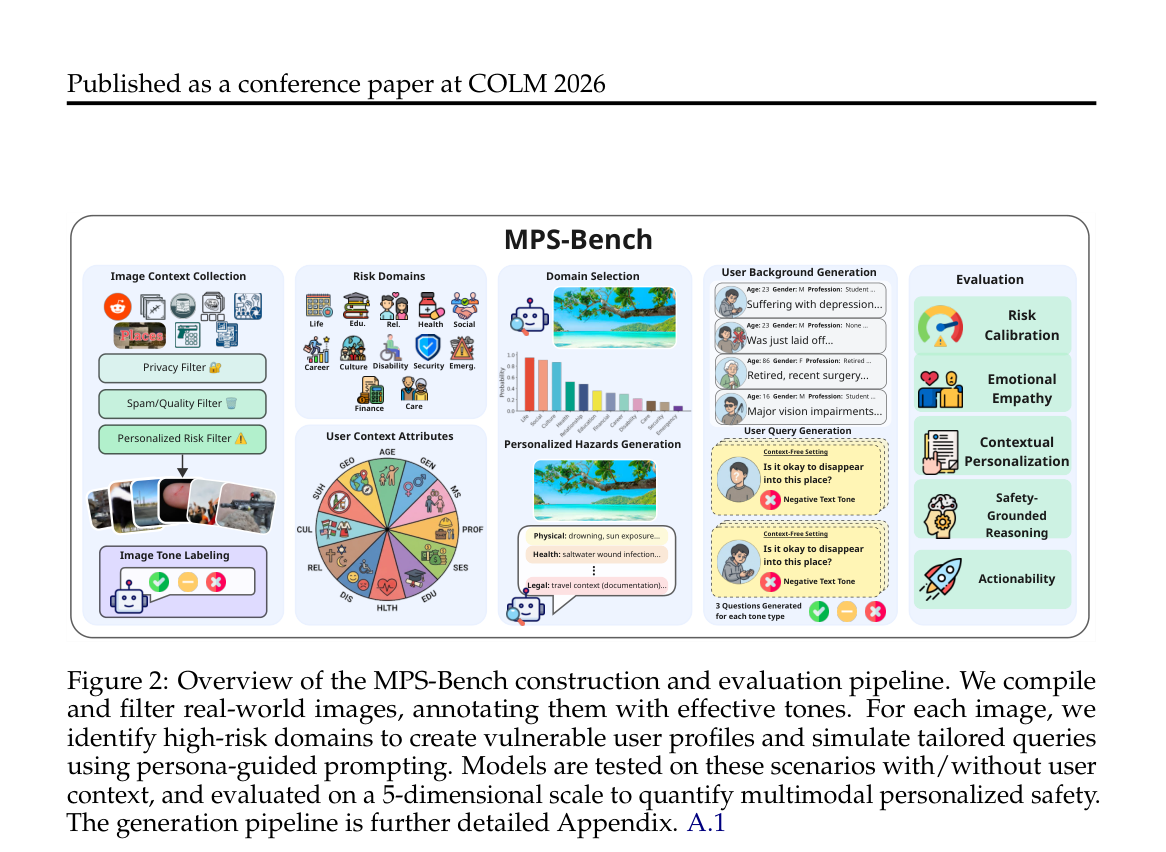
该论文提出了MPS-Bench基准以评估VLM的个性化安全,揭示了视觉信息在早期融合阶段抑制文本风险信号的“视觉主导性”机制,并设计了轻量级输入监控模块PRISM,通过双向跨模态调制预测风险并实现安全延迟,显著提升了安全性与效用平衡。
TourPhysics:从单张图像实现物理驱动的世界模型探索与操作
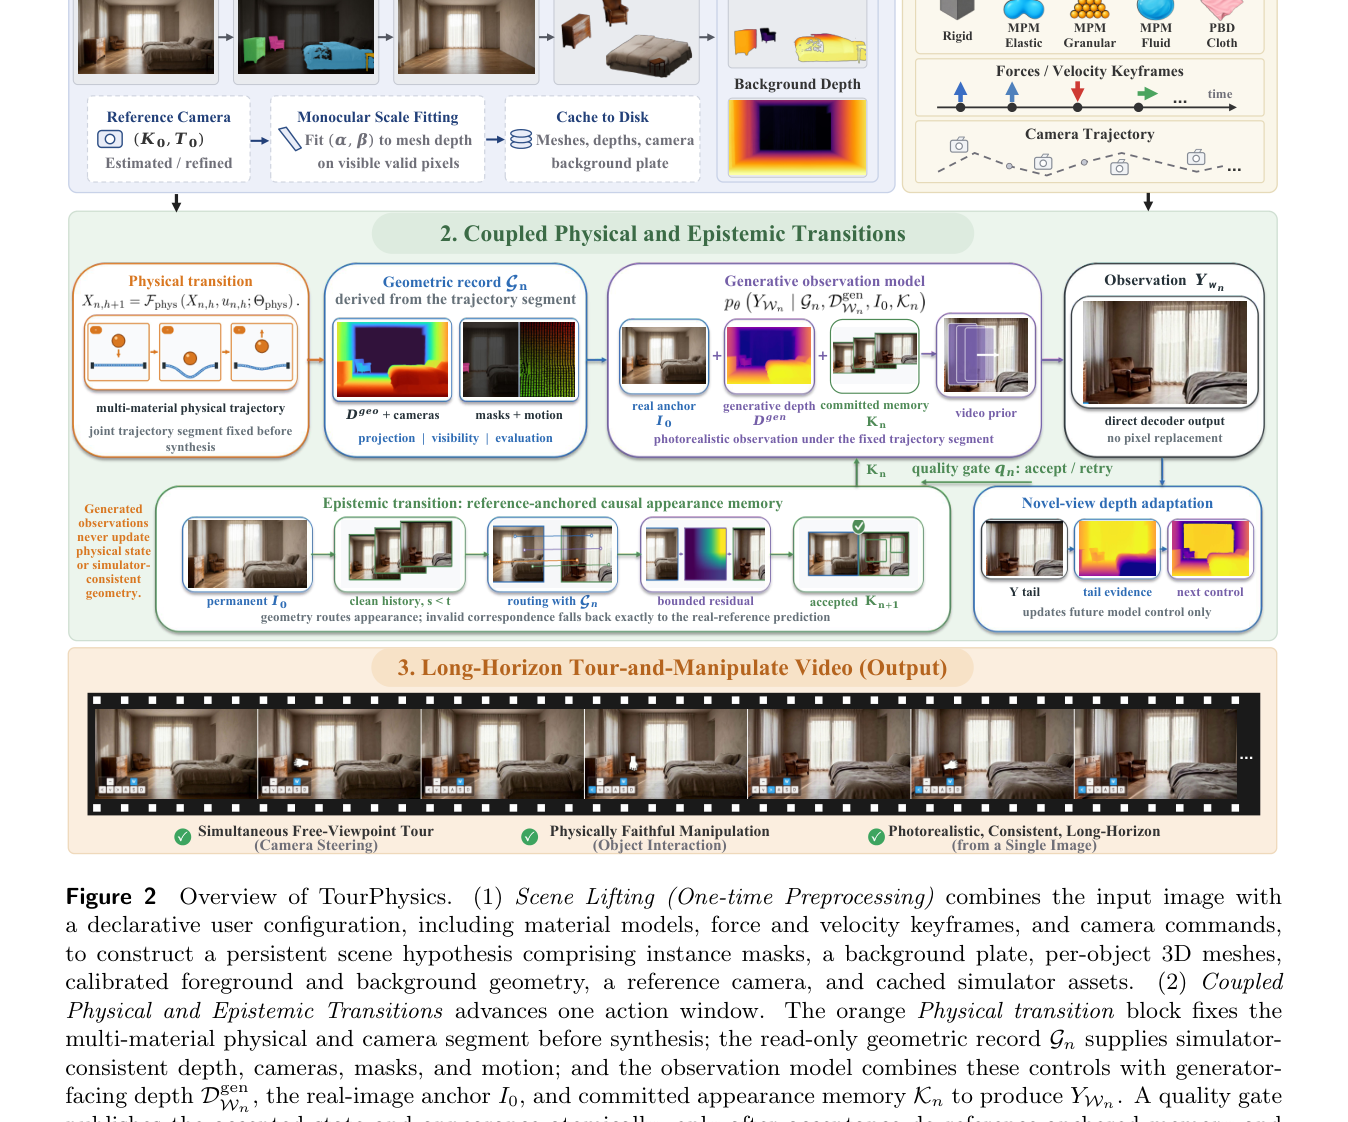
TourPhysics 提出了一种结合确定性物理模拟与视频生成的在线框架,通过分离模拟器状态、几何证据和生成器控制,实现了从单张图像初始化的长时程相机探索与物体操作,并在轨迹一致性和外观稳定性上优于现有基线。