LightMedSeg-ISLES:参数量比 nnU-Net 少 81 倍的卒中病灶分割
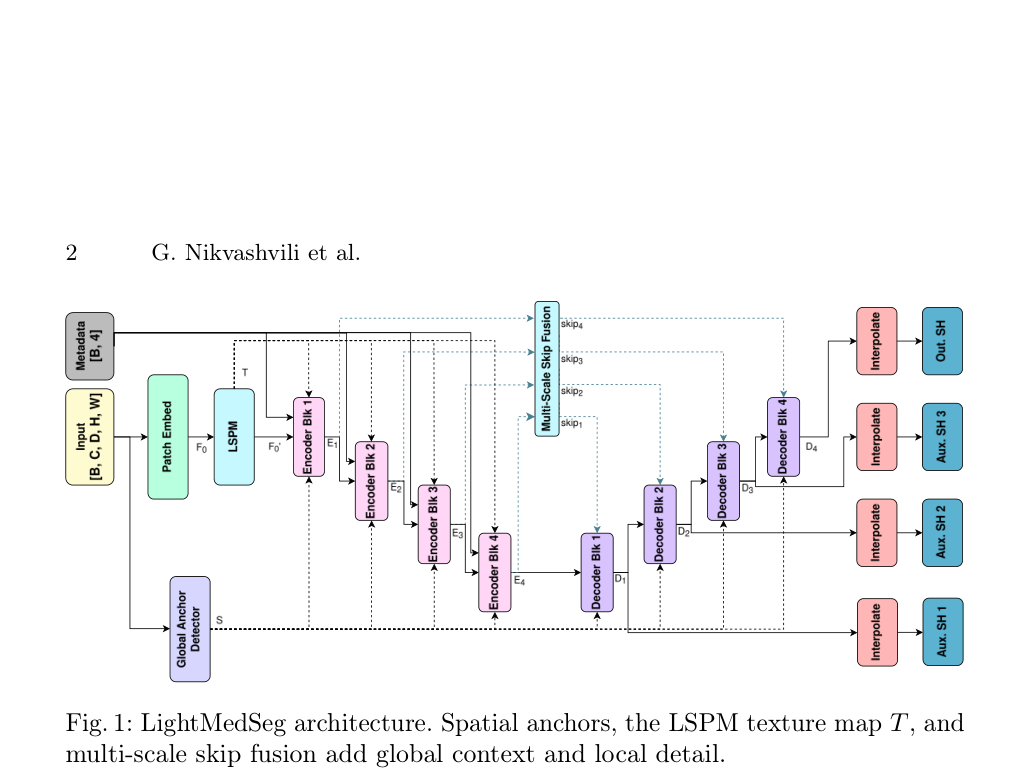
本文提出 LightMedSeg-ISLES,一个仅含 1.26M 参数的轻量级 3D 分割模型,在 ISLES’26 卒中病灶分割任务上以 81.4 倍更少的参数量保留了 nnU-Net 97.5% 的 Dice 性能,并显著提升了 lesion-wise F1。
本文提出 LightMedSeg-ISLES,一个仅含 1.26M 参数的轻量级 3D 分割模型,在 ISLES’26 卒中病灶分割任务上以 81.4 倍更少的参数量保留了 nnU-Net 97.5% 的 Dice 性能,并显著提升了 lesion-wise F1。
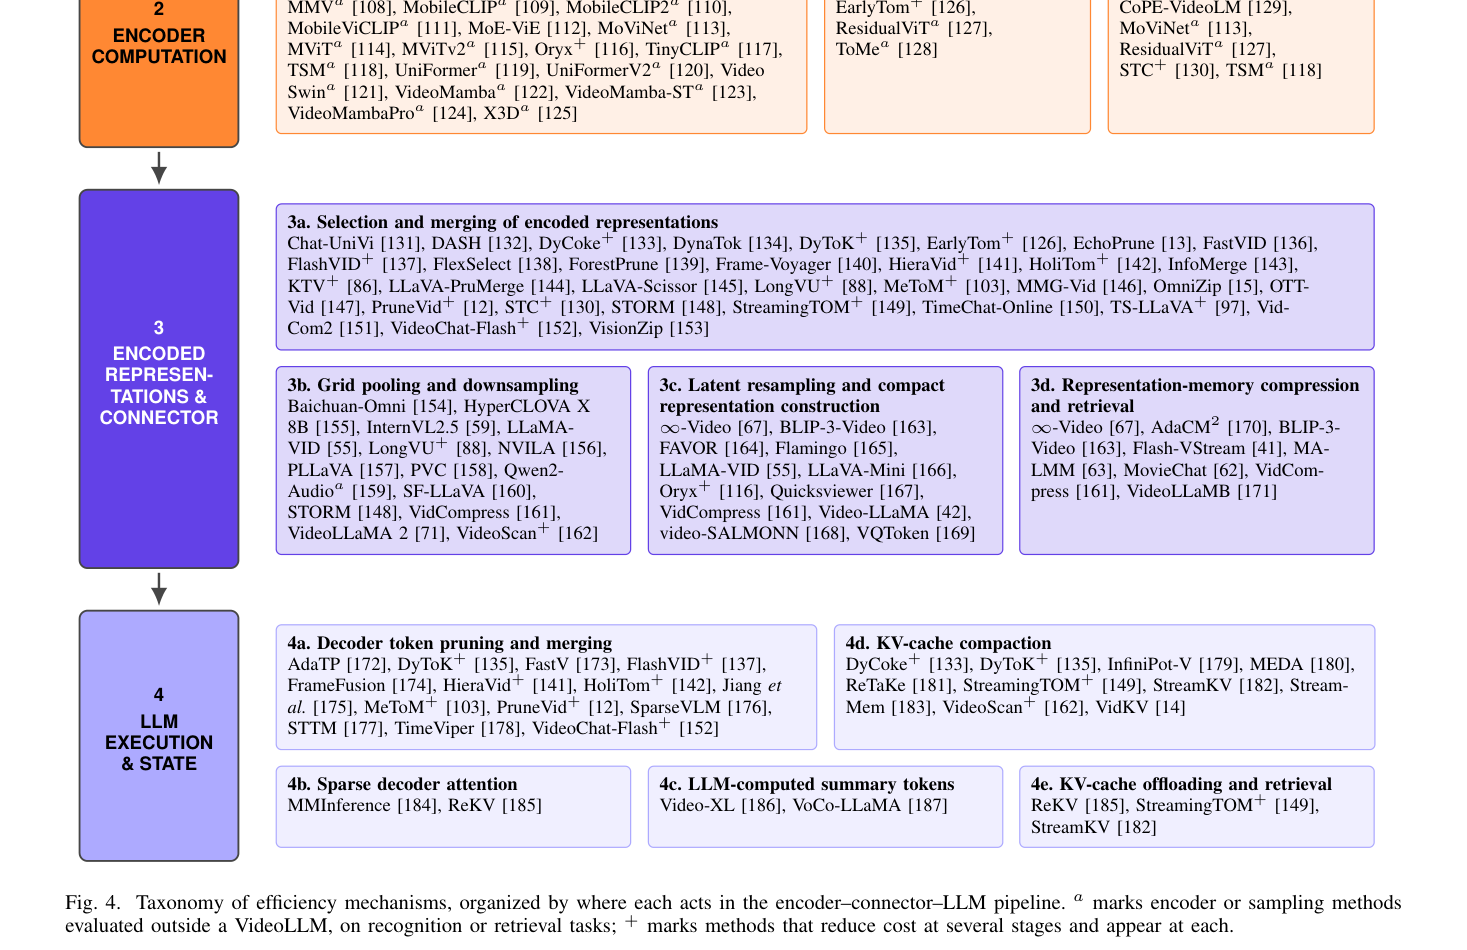
本文综述了视频大语言模型(VideoLLMs)中针对帧采样、编码器、连接器及LLM执行阶段的推理效率机制,并提供了基于共享基准的定量对比。
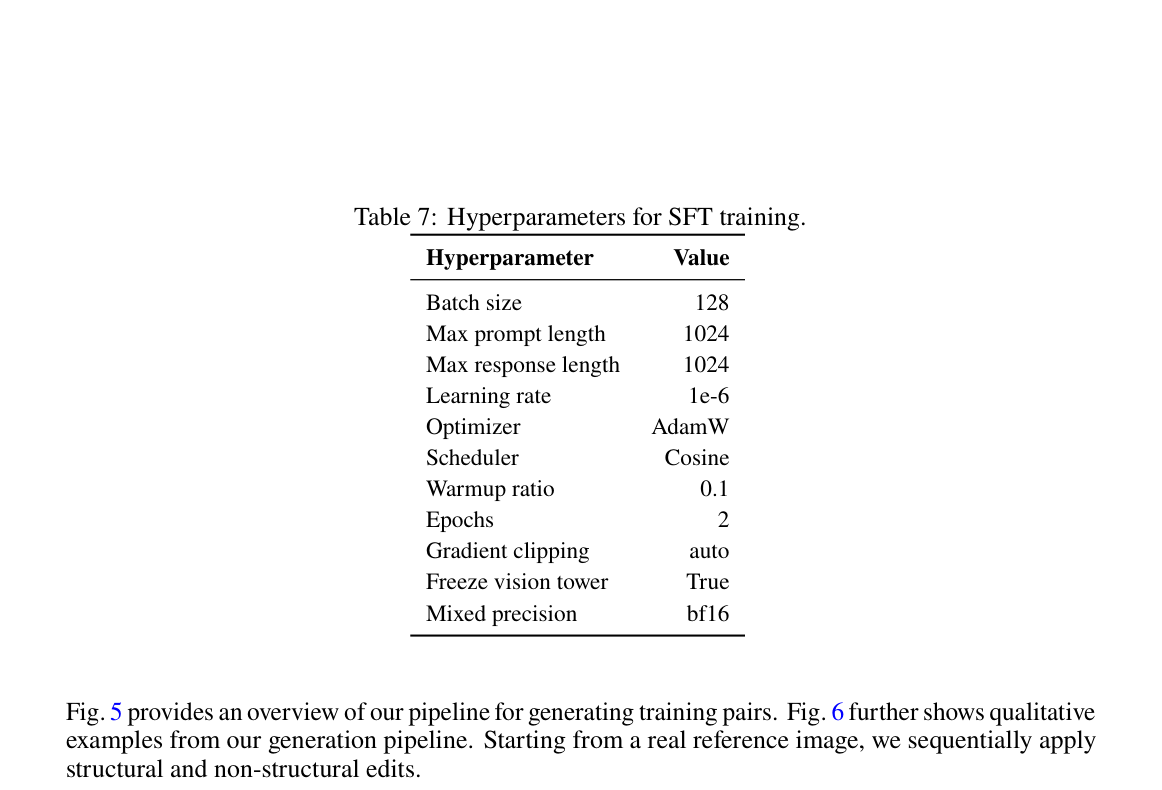
本文提出了 Spot-the-shift 基准,用于评估多模态大模型(MLLMs)在真实驾驶场景中检测、描述并定位长期结构性变化的能力,并展示了一种通过合成数据微调以提升模型性能且保持通用能力的方法。
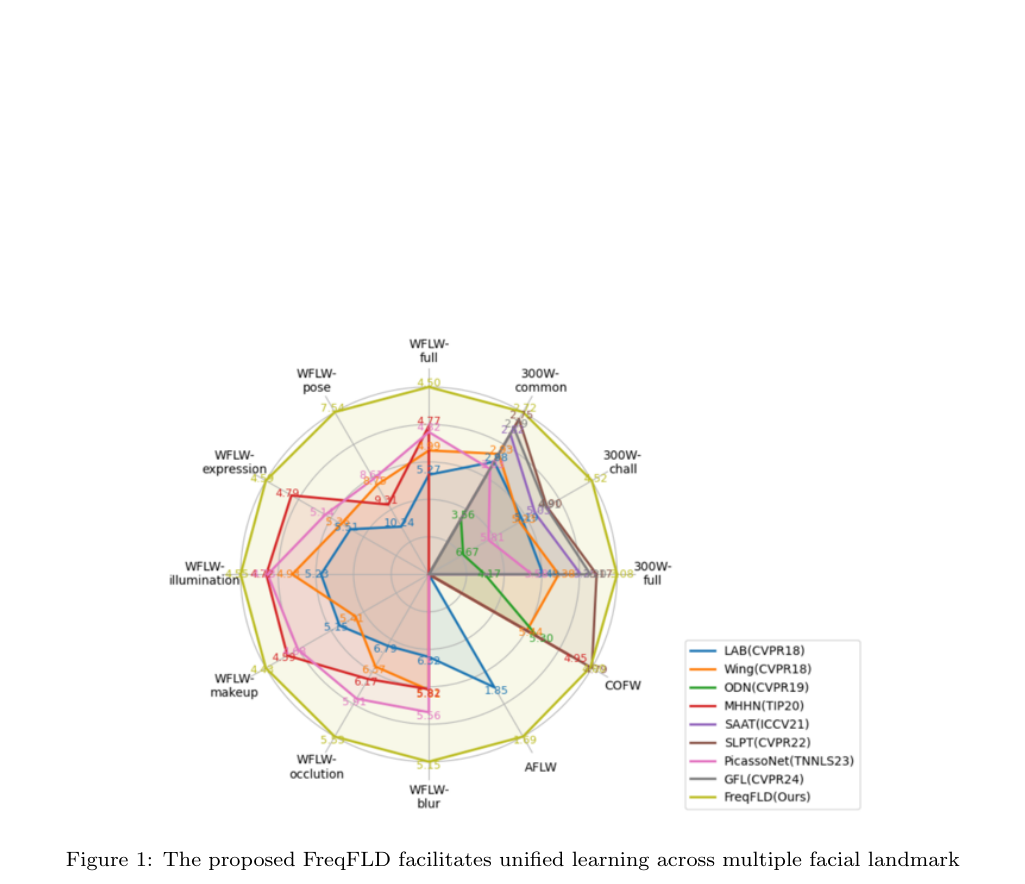
本文提出 FreqFLD,一种通过频率解耦(FreqMoM)和频率条件混合专家(FreqMoE)实现多数据集统一训练与鲁棒面部关键点检测的框架。
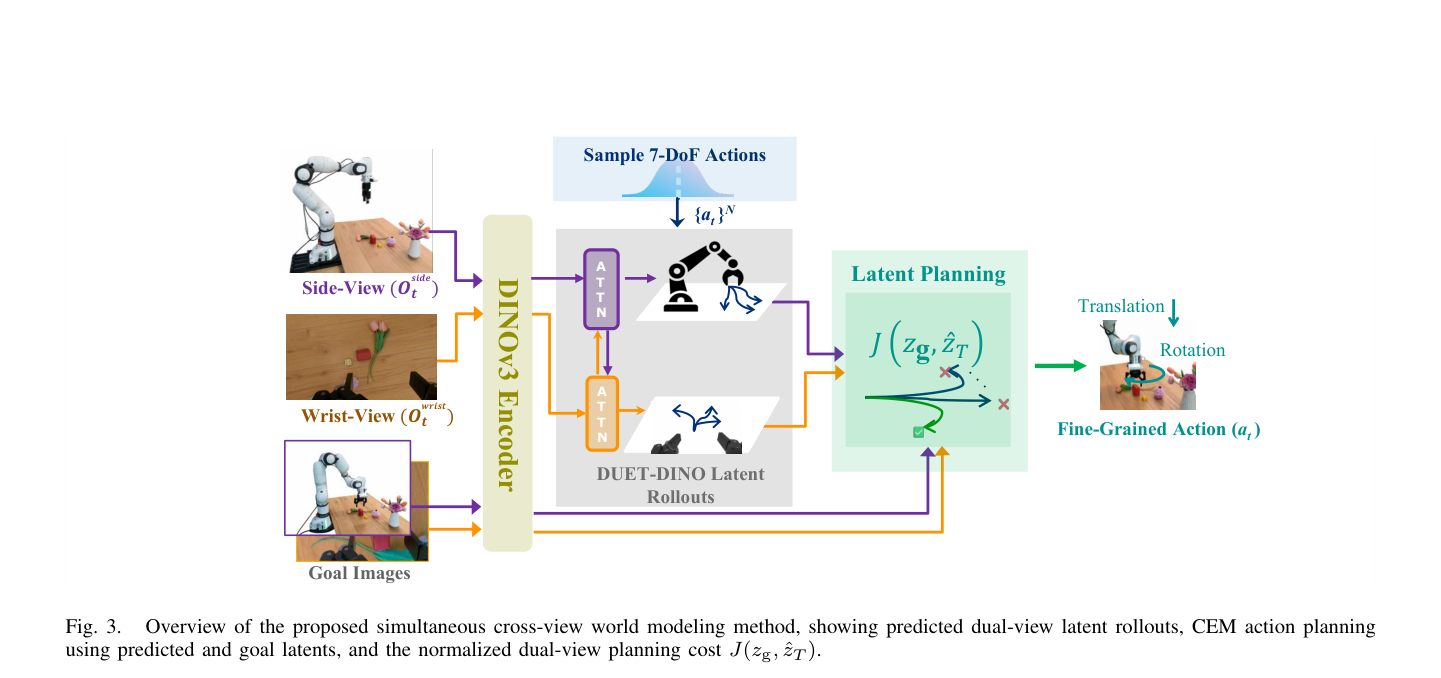
本文提出 DUET-DINO,一种通过跨视角注意力机制联合建模侧视和腕视相机观测的潜在世界模型,实现了全 7-DoF 末端执行器动作的零样本目标条件规划,并在多种操作任务中显著优于单视角基线。
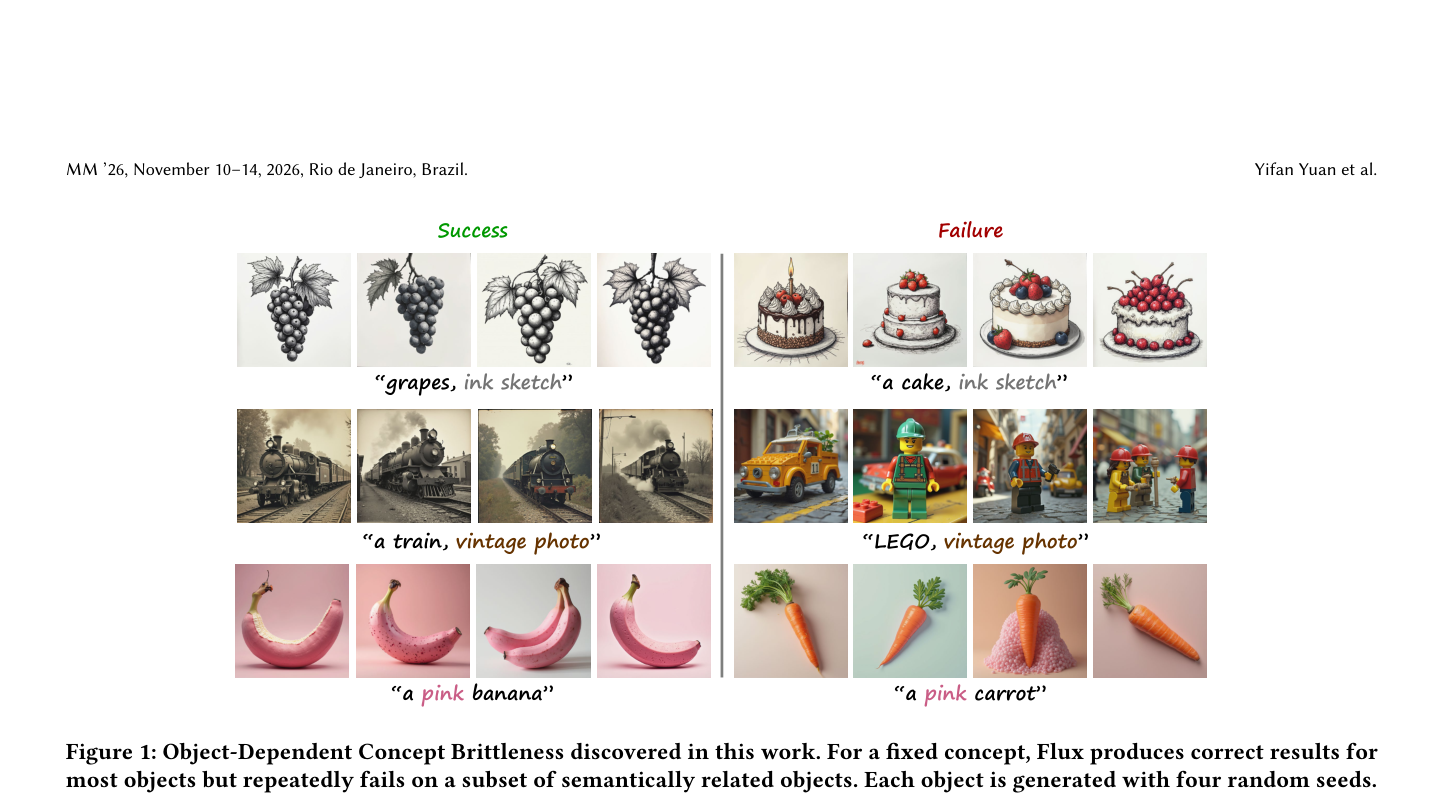
本文提出了一种基于逐步稀疏自编码器(step-wise SAE)的可解释性框架,用于诊断和修正文本到图像扩散模型中特定对象导致的概念实现失败(object-dependent concept brittleness),通过在推理时向类原型插值来恢复缺失的风格或属性证据。
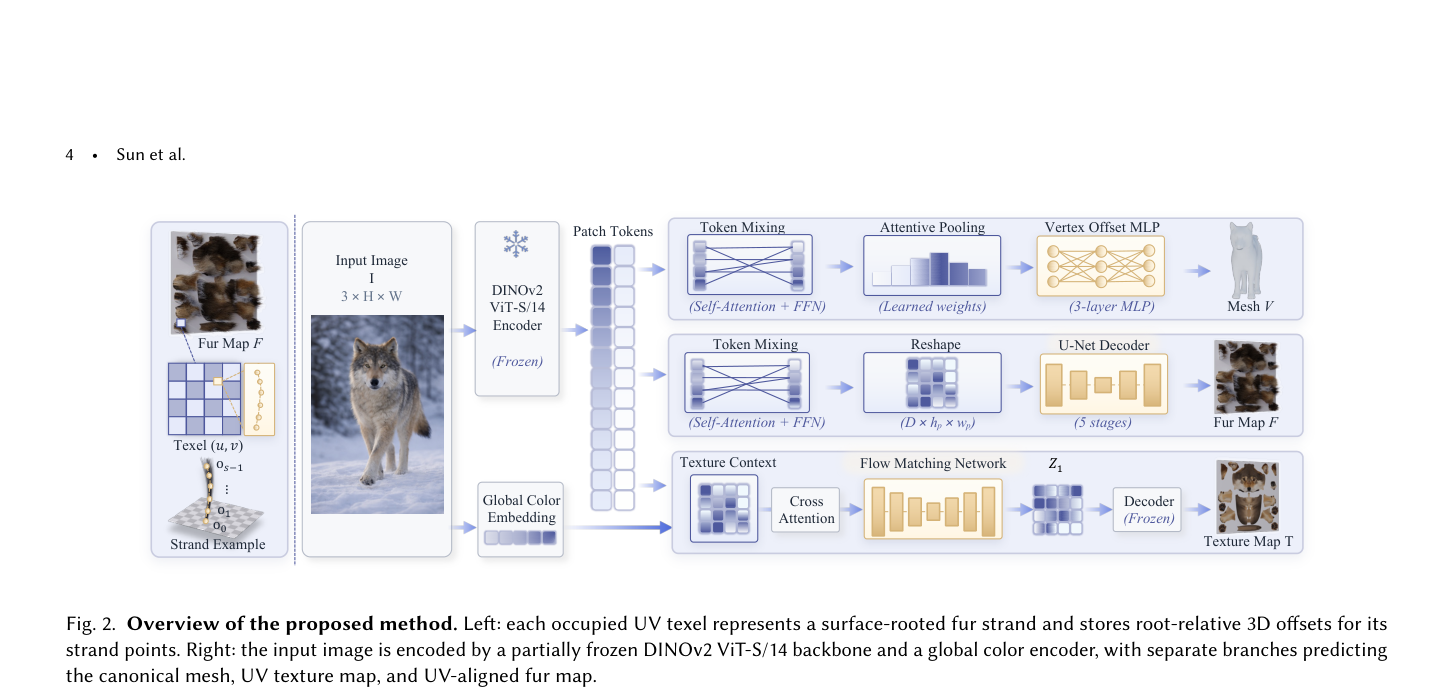
AnimalLift 提出了一种基于共享拓扑和 UV 对齐规范空间的框架,能够从单张图像前馈重建包含显式毛发几何、UV 纹理和可动画网格的 3D 动物资产,并支持下游动画、编辑和物理模拟。
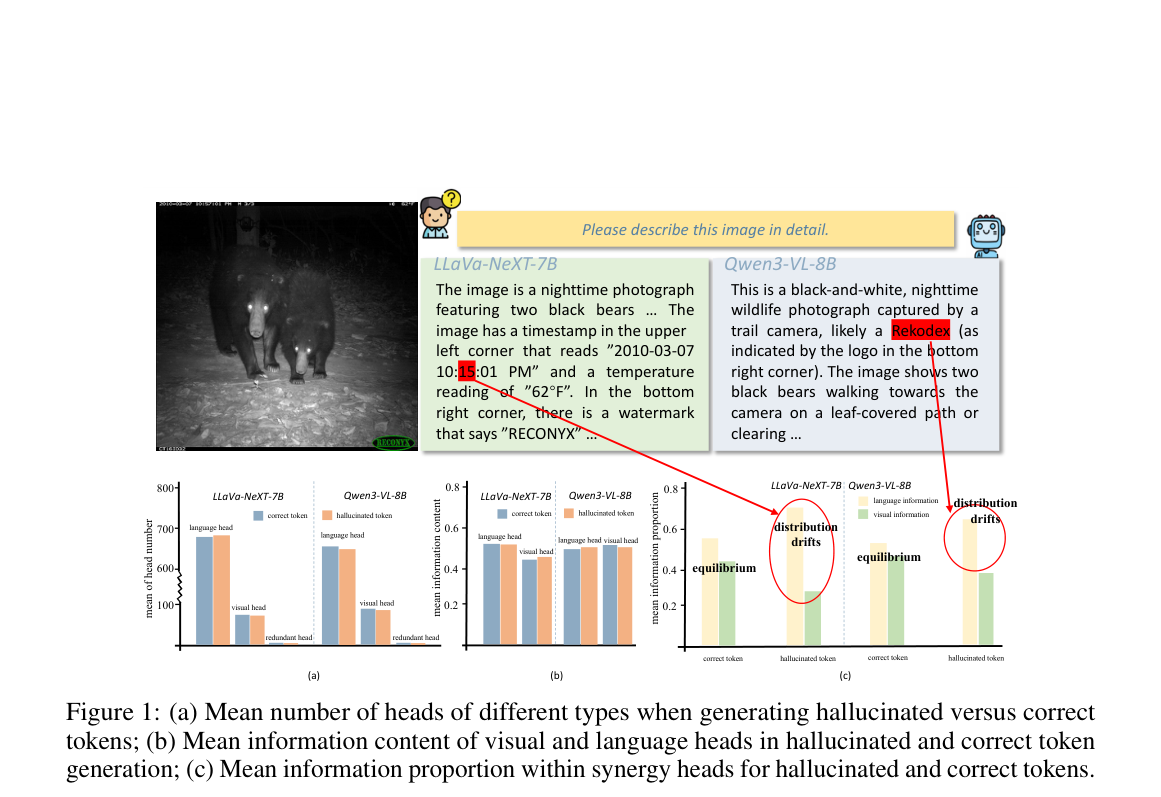
本文提出HEAL方法,通过因果噪声干预和反事实双重差分法解耦注意力头信息,发现幻觉源于协同头中视觉-语言信息分布偏离平衡态,并据此在推理时动态校准信息分布以有效抑制幻觉。
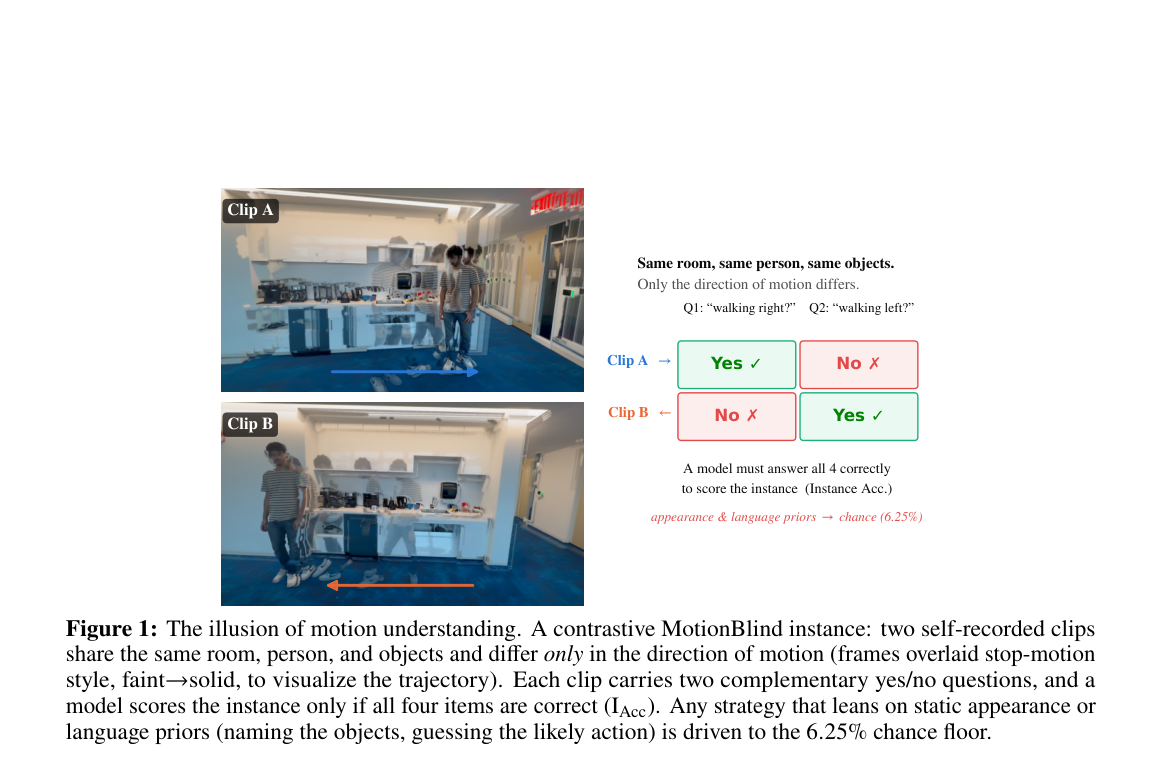
本文提出 MotionBlind 基准,通过对比式自录制视频揭示当前 Video-LLM 在物理运动感知(速度、幅度、方向)上的根本缺陷,证明增加帧数或优化帧选择策略无法弥补这一感知瓶颈。
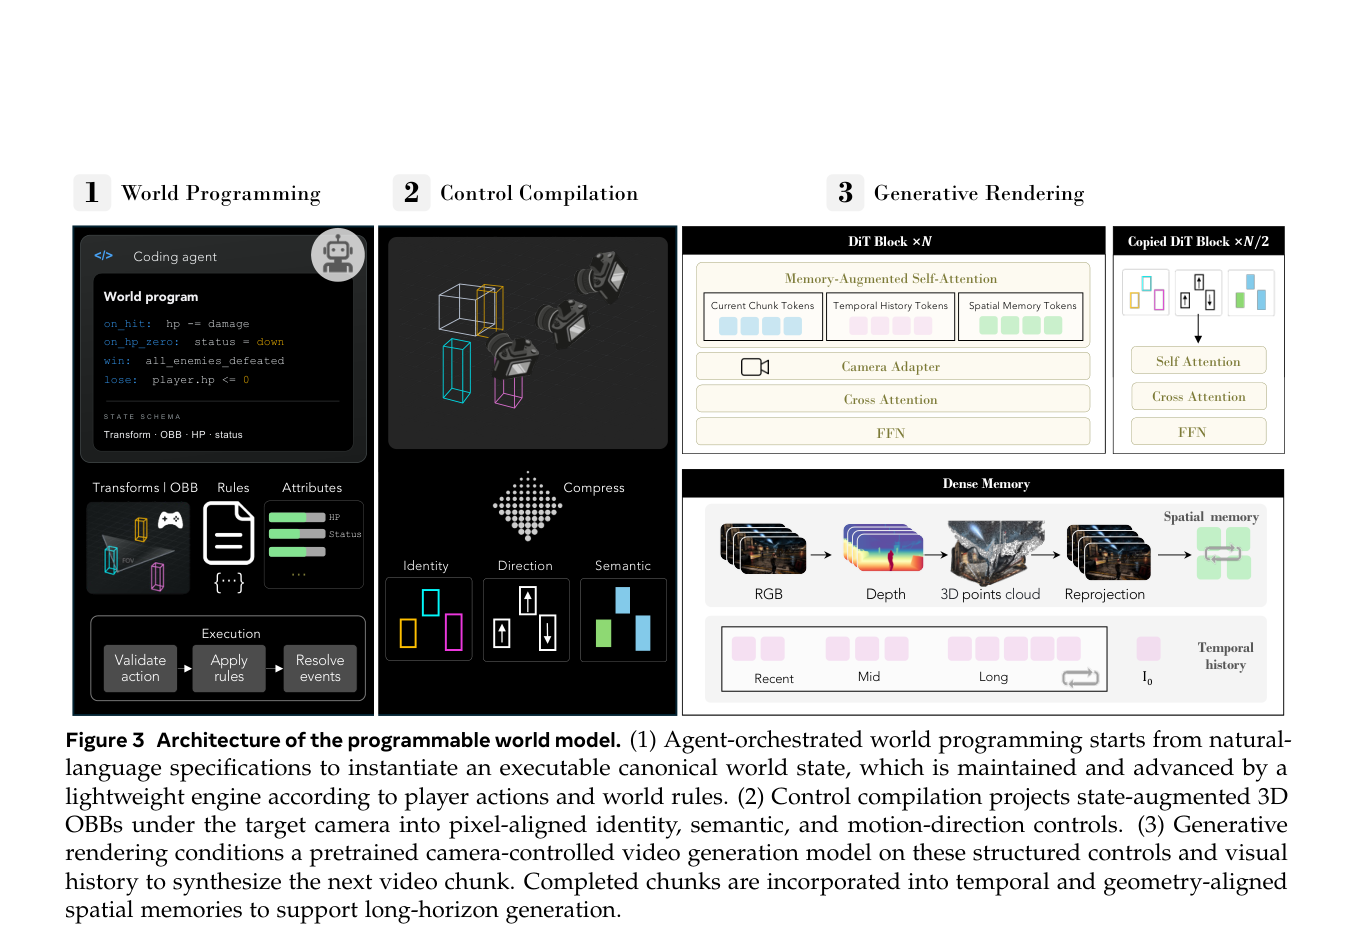
提出一种将世界状态演化与视觉生成解耦的可编程世界模型框架,通过轻量级引擎维护显式持久状态,并利用 state-augmented 3D OBBs 作为中间表示驱动视频生成器,实现了高一致性的交互式游戏世界生成。