快速导读:GS-VLA提出一个4M参数的3D高斯canonicalizer,在冻结VLA策略前恢复规范视角观测,无需策略重训练即可大幅恢复相机视角扰动造成的成功率损失。
GS-VLA解决的核心问题是:视觉-语言-动作(VLA)策略在部署时相机视角偏离训练姿态会导致成功率急剧下降。论文报告的最坏情况是π0.5在libero_10上从92.4%降至9.3%。作者提出的方案是一个仅4M参数的3D高斯canonicalizer,在冻结VLA策略前将扰动视角观测恢复为规范视角,无需策略重训练。
论文的核心论点是Locality假设:当相机扰动有界时,视角规范化退化为沿深度不连续边缘的薄带去遮挡问题,而非通用新视角合成。这一假设将学习复杂度从通用NVS大幅降低,使得一个极小的前馈网络就能完成规范化任务。
英文题目:GS-VLA: Plug-and-Play Viewpoint Canonicalization for Frozen VLA Policies via Gaussian Splatting
论文出处:arXiv 每日论文精选 · arXiv:2608.19066
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLA模型在LIBERO等基准上表现优异,但依赖训练与部署相机配置一致的隐含假设。实际部署中相机支架常发生厘米级漂移,导致观测分布偏移。LIBERO-Plus基准已揭示相机视角是SOTA VLA脆弱性的主要来源。
现有解决方案存在明显缺陷:大规模微调计算昂贵且有灾难性遗忘风险;生成式数据增强需要为每个新策略重新训练。AnyCamVLA虽然冻结策略,但依赖LVSM合成器和双视图输入,评估限于窄扰动范围。
作者提出的Locality假设是理解问题的关键:扰动有界时,大部分像素可通过深度和相机参数几何映射到规范视角,学习仅需处理O(ρ)面积的窄去遮挡带。这一假设将问题从通用NVS简化为局部去遮挡。
核心创新
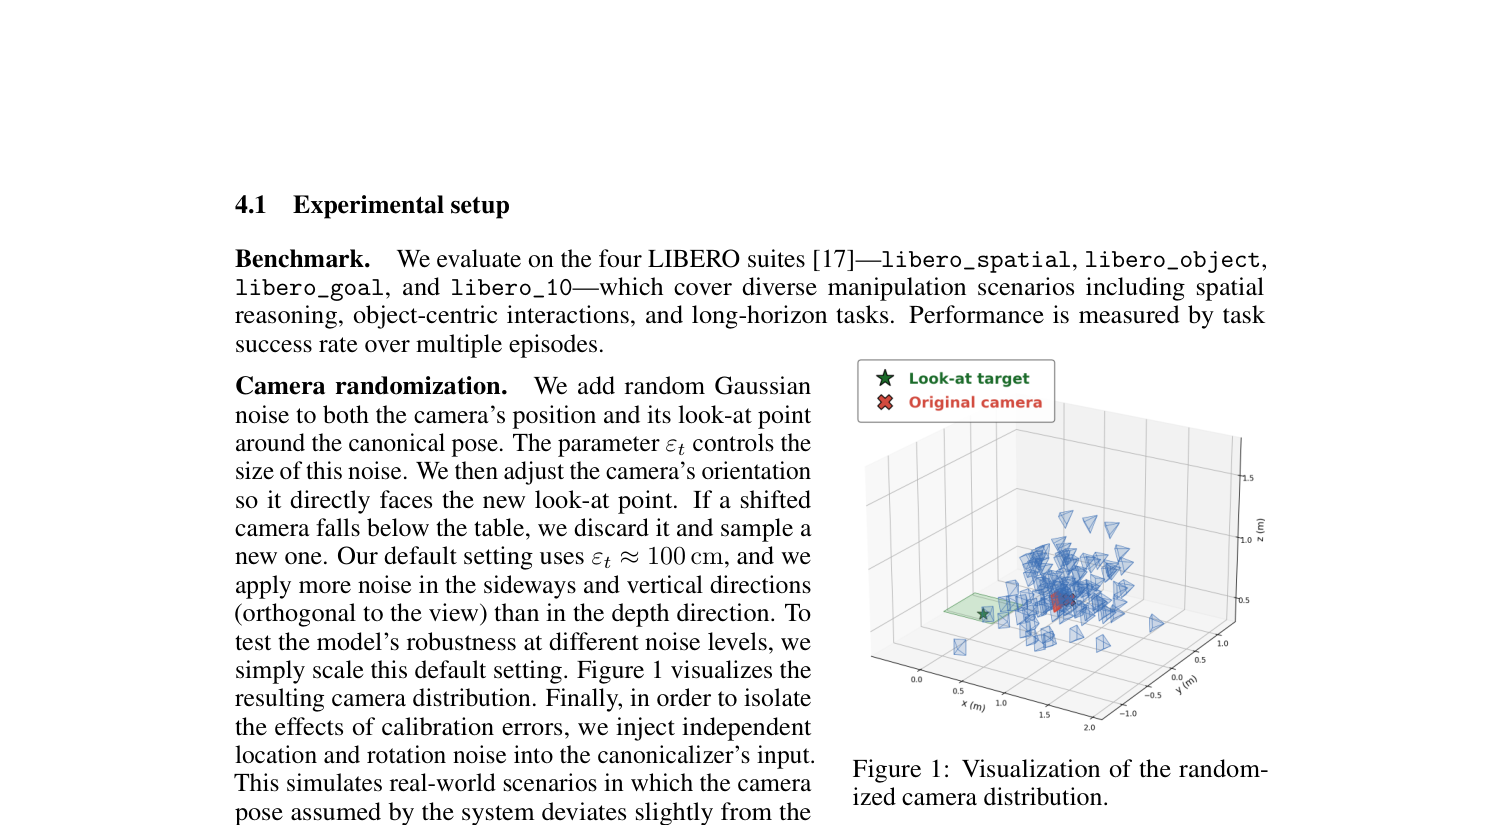
- 首次将3D高斯泼溅直接用于VLA策略的观测空间适应,实现无需策略重训练的视角规范化
- 提出Locality假设的形式化表述,将视角适应从通用NVS简化为O(ρ)面积的局部去遮挡问题
- 设计4M参数像素对齐3D高斯canonicalizer,比AnyCamVLA小42倍,比微调π0.5小约840倍
- 证明单一checkpoint可跨策略架构、任务套件和扰动尺度三轴泛化
- 通过η(ρ)线性性、silhouette-hugging和端到端耦合链的实证分析验证Locality机制
方法概览
将视角偏移重新表述为局部新视角合成问题。在Locality假设下,大部分像素可通过深度和相机参数几何映射到规范视角,学习仅需处理O(ρ)面积的窄去遮挡带。实现为4M参数U-Net,逐像素预测14维高斯描述子(位置残差、各向异性尺度、四元数方向、不透明度、颜色残差),通过gsplat可微α-blending在规范姿态合成图像。所有残差头零初始化,使fϕ从闭式前向warp起步。仅在libero_spatial上以εt=100cm训练一次,使用0.8:0.2的L1/SSIM损失。
- 将视角偏移重新表述为局部新视角合成问题。在Locality假设下,大部分像素可通过深度和相机参数几何映射到规范视角,学习仅需处理O(ρ)面积的窄去遮挡带。
- 实现为4M参数U-Net,逐像素预测14维高斯描述子(位置残差、各向异性尺度、四元数方向、不透明度、颜色残差),通过gsplat可微α-blending在规范姿态合成图像。
- 所有残差头零初始化,使fϕ从闭式前向warp起步。这一设计确保训练初期输出即为几何正确的前向映射,网络只需学习残差。
- 仅在libero_spatial上以εt=100cm训练一次,使用0.8:0.2的L1/SSIM损失。训练仅需5小时,单张RTX A5000,峰值显存约18GB。
- 推理延迟约13ms/帧(约75Hz),U-Net前向~5ms,α-splat~8ms。下游策略保持原生action-chunk调度,canonicalizer成本被摊销到多步动作中。
逐图理解论文
失败案例与直觉
论文报告的最坏情况是π0.5在libero_10上从92.4%直接跌到9.3%。相机支架只是厘米级漂移,策略却几乎完全失效。直觉上,这不是策略本身变笨了,而是它看到的观测已经不在训练分布里。
Locality假设:核心区分
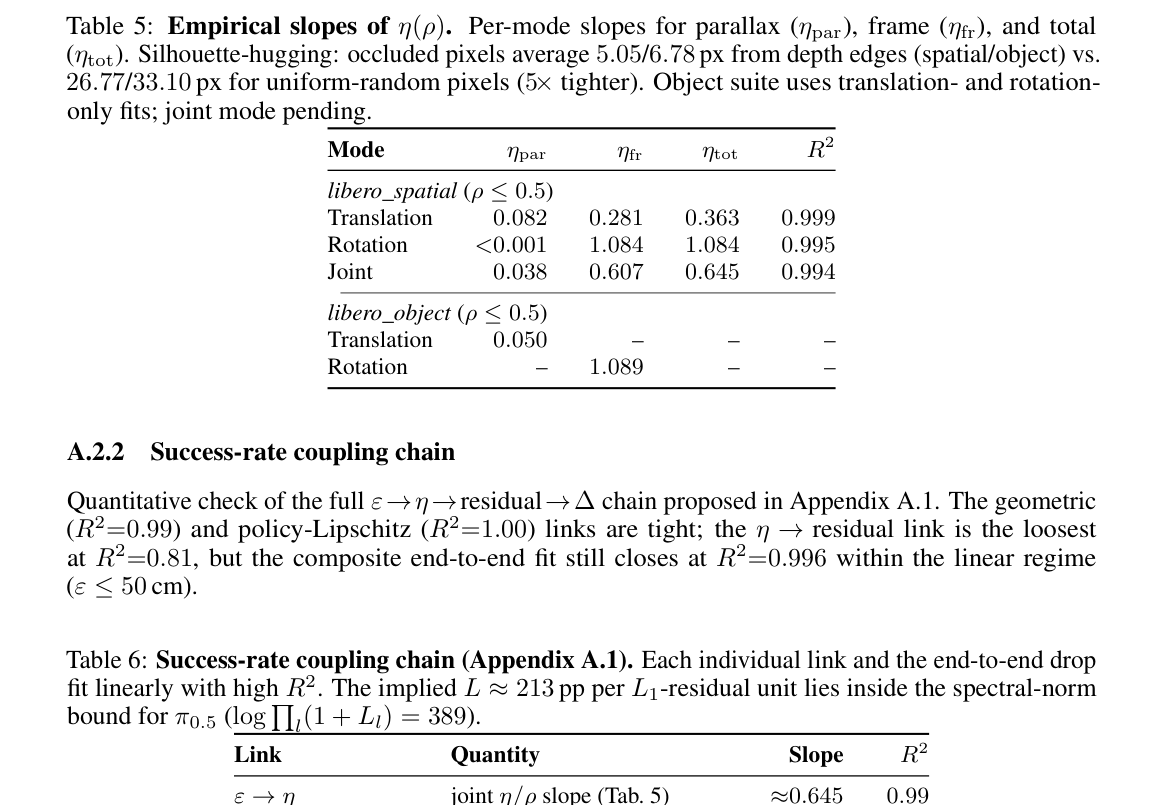
关键区分在于:现有方案要么大规模微调策略,要么用生成式数据增强,都昂贵且有遗忘风险。GS-VLA提出Locality假设——扰动有界时,视角规范化不是通用新视角合成,而是沿深度不连续边缘的薄带去遮挡问题。大部分像素只需几何映射,学习只需处理O(ρ)面积的窄带。
方法贡献与验证
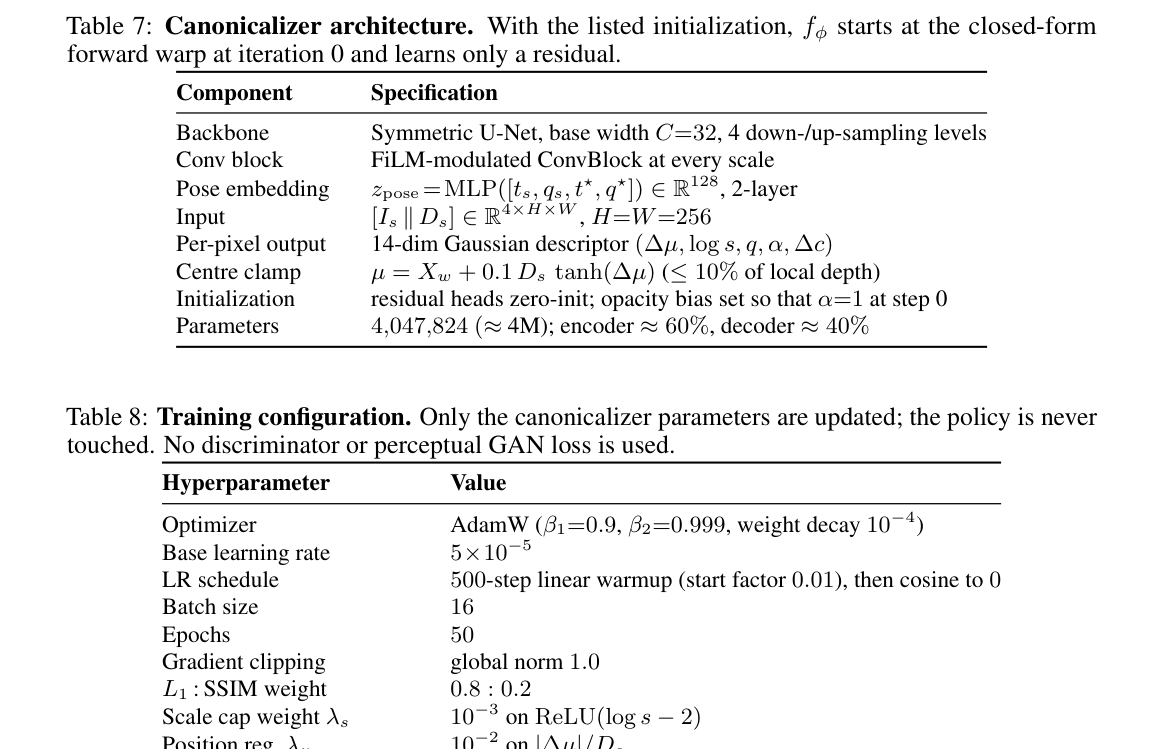
GS-VLA实现为一个4M参数的U-Net,逐像素预测14维高斯描述子,通过可微α-blending在规范姿态合成图像。所有残差头零初始化,让网络从闭式前向warp起步。它只在libero_spatial上训练一次,却能在四种冻结策略、四个LIBERO套件和多个扰动尺度上零样本迁移。
最强结论
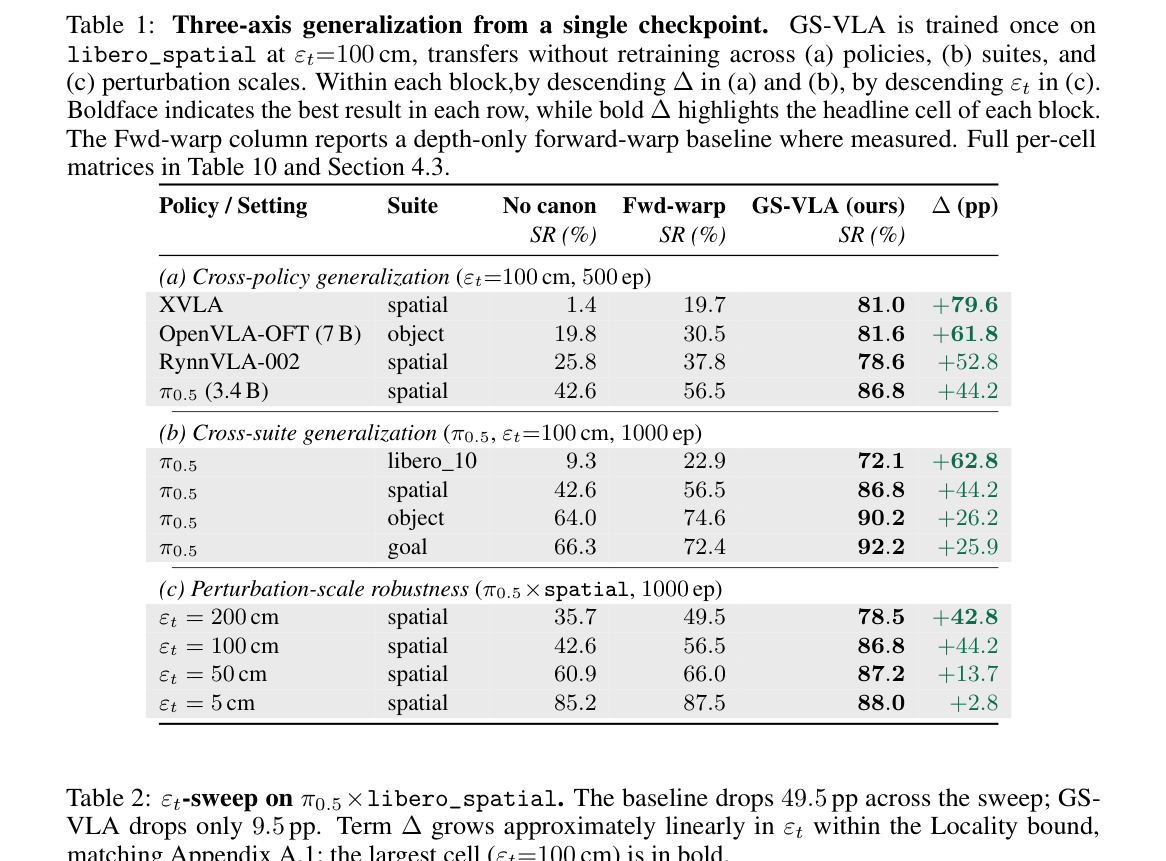
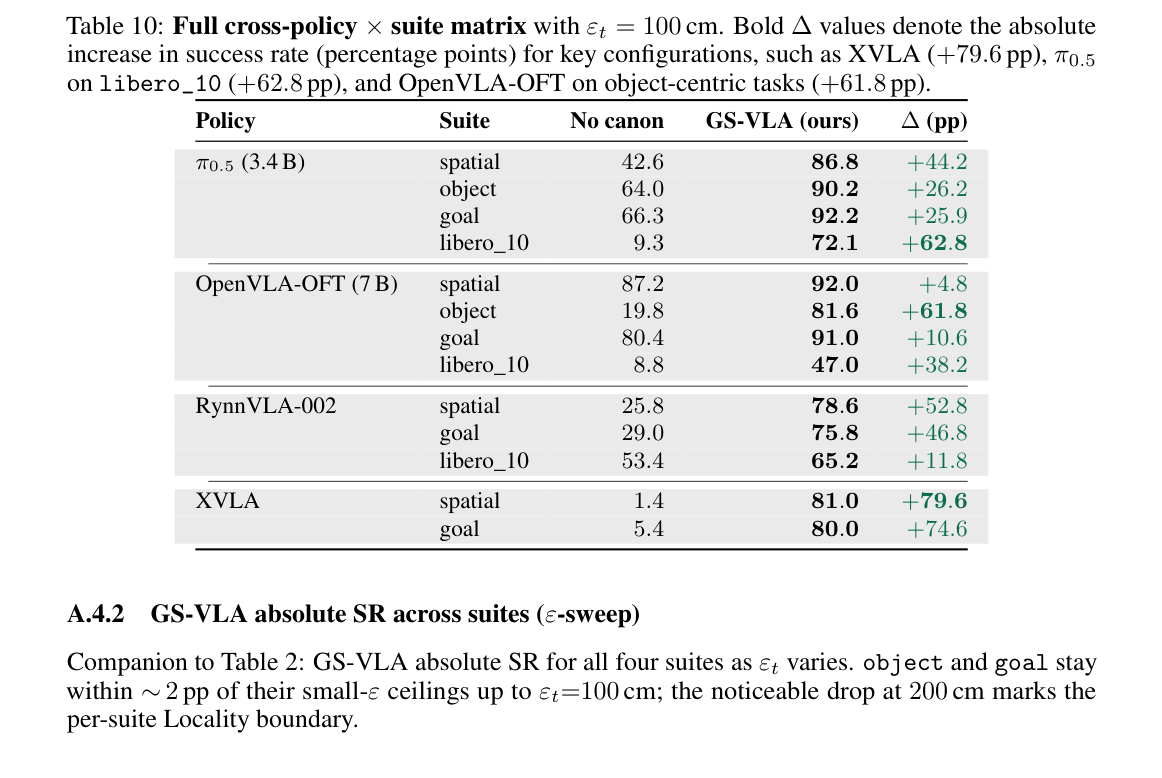
三轴泛化主表。关注每个block中bold ∆的headline cell,理解单一checkpoint如何跨策略、套件和扰动尺度恢复成功率。
实验如何设计?
- 跨策略泛化:XVLA、OpenVLA-OFT、RynnVLA-002、π0.5四种冻结策略在εt=100cm下评估。
- 跨套件泛化:libero_spatial、libero_object、libero_goal、libero_10四个LIBERO套件零样本迁移。
- 扰动尺度扫描:εt∈{5,15,30,50,100,200}cm,以及联合平移×旋转ε∈{100,200}cm与yaw θ∈{10°,20°}交叉。
- 外参标定噪声压力测试:(T cm, R°)∈{(1,1),(2,2),(3,3),(5,5)},噪声仅注入canonicalizer看到的姿态。
- 消融实验:容量(C=16/24/32/64)、数据量(10k/25k/50k)、深度替换(DepthAnything V2校准/微调/refinement head/端到端梯度)。
关键结果与论文证据
- XVLA在libero_spatial上从1.4%恢复至81.0%(+79.6pp),是最大单点恢复(第7页,Table 1)。
- π0.5在libero_10上从9.3%恢复至72.1%(+62.8pp),OpenVLA-OFT在libero_object上从19.8%恢复至81.6%(+61.8pp)(第7页,Table 1)。
- εt扫描中baseline下降49.5pp,GS-VLA仅下降9.5pp,∆近似线性增长,匹配Locality预测(第7页,Table 2)。
- 联合平移×旋转最大增益+42.2pp(ε=200cm, θ=10°),但θ=20°时∆收窄,归因于训练时大旋转采样不足(第8页,Table 3)。
- 标定噪声≤3cm/3°时三套件平均下降≤5pp;5cm/5°时libero_10下降23.8pp,长时程任务最敏感(第8页,Table 4)。
- 容量C=64时PSNR升至28.4dB但SR降至85.2%(C=32为86.8%),额外容量用于策略不消费的纹理细节(第19页,Table 13)。
- 数据量10k对已达~84% SR,50k为86.8%,信号在~25k对饱和,与Locality预测的低学习复杂度一致(第19页,Table 14)。
- DepthAnything V2仅校准达44.5% SR,微调后达71.7%,GT深度上限86.8%,残余-15pp差距不是深度精度瓶颈(第20页,Table 16)。
阅读时需要注意
- 单视图输入:源相机完全不可见的内容无法恢复,多视图扩展(腕部相机或前一帧)留待未来工作。
- 旋转Locality边界:εt=100cm已相对~0.7m工作空间很大,叠加有意义的旋转常使相机完全偏离工作空间,无法进行干净的旋转扫描。
- 仅仿真评估:所有实验在LIBERO模拟器内完成,真实机器人验证需要外部度量深度源和物理装置,尚未实现。
- 深度替换存在结构性差距:即使微调DepthAnything V2,仍有约-15pp的SR差距,被归因于分布不匹配和splat模块的信息瓶颈。
关联工作
- SPARTN利用NeRF生成新视角轨迹用于行为克隆的相机鲁棒方法,但需要策略重训练。
- AnyCamVLA同样冻结策略但依赖LVSM合成器和双视图输入,评估限于窄扰动;GS-VLA参数少42倍。
- Flash3D是前馈3D高斯预测器,利用单目深度先验但面向跨场景泛化;GS-VLA专门针对分布内相机扰动。
- SpatialVLA面向空间表示的VLA内部修改,与GS-VLA的观测空间方案正交可组合。