快速导读:本文提出 GRF-Recon,通过重归一化 LoRA 注入单目几何先验、混合权重稀疏射线场优化与轨迹拼接,把前馈三维重建扩展到千米级未标定单目序列并抑制长期漂移。
前馈三维重建把未标定图像序列直接变成位姿与稠密点云,短序列上已经很强,但一放到千米级单目驾驶视频,就会同时撞上三件事:Transformer 注意力让显存随帧数二次膨胀,局部深度在细杆、树叶和车辆边缘过平滑,以及块与块之间只做松散拼接时长期 Sim(3) 漂移。GRF-Recon 把这三件事收进同一套可扩展框架:先用轻量几何先验把局部几何做锐,再用稀疏射线场把跨帧约束写进全局优化。
系统以 Depth Anything 3 (DA3) 为骨干。作者把重归一化 LoRA 插进 DINOv2 encoder 的 Query-Key-Value 投影并冻结 decoder,用 MoGe 伪标签与真值点云做教师-学生蒸馏;长视频按重叠块做 Sim(3) 粗对齐;随后用深度置信度、射线置信度与深度梯度引导稀疏射线采样,并以射线距离、图像梯度与光度误差的混合权重做跨帧匹配。回环由 DINOv2 全局描述子触发,因子图同时吃射线场与多帧位姿先验。作者报告在 KITTI 与 Waymo 上轨迹精度可与代表性 SLAM 竞争,且无需已知相机内参。
英文题目:GRF-Recon: Global Ray-Field Optimization for Long-Sequence Feed-forward Reconstruction
论文出处:arXiv 每日论文精选 · /tmp/ingest_20260920/arxiv-2609-20012.pdf
原始论文:PDF / 论文页面
这篇论文解决什么问题?
单目视频没有绝对尺度,长轨迹上尺度误差会不可逆地放大。传统大场景管线依赖标定、视觉里程计、多传感器融合和沉重的后端图优化;松耦合里传感器噪声与数据关联错误会随运动距离累积。COLMAP 一类增量 SfM 在纹理缺失处脆弱,DROID-SLAM 虽把深度特征与稠密光束法平差结合起来,作者仍指出它缺少显式全局几何约束,长序列上三维不一致。
DUSt3R、MASt3R、VGGT 与 DA3 把位姿、内参回归和场景表示收进端到端基础模型,优势是能直接吃未标定 RGB。但自注意力使计算与显存随 token 二次增长,消费级 GPU 上往往只能处理几十帧;缺少显式全局约束时,局部误差会变成 Sim(3) 漂移,多视一致性与度量精度一起掉。预训练分布之外的大视差或未见几何,还会让细结构和深度不连续处失稳。
为了拉长序列,Spann3R 与 LONG3R 探索时空记忆流式重建,MUSt3R 与 Fast3R 做多视并行,VGGT-Long 把问题收成 chunk-and-align。分块先缓解了显存,但现有拼接多半只对齐重叠位姿,块内几何仍几乎完全交给前馈预测。作者在路口处观察到 DA3-Streaming 的位姿不连续,正是这种“块间有约束、块内无全局几何”的结果。
因此长序列前馈重建需要同时做两件事:前端要在几乎不增加推理成本的前提下恢复高频几何;后端要用可扩展的显式三维约束把跨帧射线耦合起来,而不是只拼轨迹。GRF-Recon 的设计就是沿着这条缺口展开的。
核心创新
- 用重归一化 LoRA 把单目几何线索蒸馏进前馈骨干,改善细结构深度同时保持多视匹配泛化。
- 提出混合权重稀疏射线场优化,用高频几何特征引导局部点云并施加跨帧射线约束。
- 用分块轨迹拼接与联合射线误差优化显式压低累积漂移,无需已知相机内参。
- 在 24 GB 显存预算下把前馈重建稳定扩展到千米级未标定单目序列。
方法概览
GRF-Recon 以 DA3 为感知骨干:在 DINOv2 encoder 的 QKV 上插入重归一化 LoRA,冻结 decoder,用 MoGe 伪标签深度与真值点云做教师-学生蒸馏;长序列按块做重叠帧 Sim(3) 粗对齐得到初始全局轨迹;按深度/射线置信度与深度梯度稀疏采样 7 通道射线,用射线距离、梯度相似与光度 SAD 的混合分数做跨帧匹配并双向对称校验;用 DINOv2 全局描述子触发关键帧与回环,再在因子图中联合优化稀疏射线场与多帧回环位姿。
- 局部深度细化借鉴 Fin3R:冻结 DA3 decoder 以保住跨视相关能力,只在 encoder 注意力层插入低秩适配。朴素单目蒸馏会让特征范数漂移,与冻结 decoder 的输入分布错位,因此对更新后的有效权重做 Frobenius 范数重归一化,使可训练参数增加不到 1%,同时稳住激活分布。蒸馏损失为 L = Ldepth + λ Lpoint,λ = 0.4;深度分支用 MoGe 伪标签的对数不确定度加权 ℓ2,点分支用真值点云回归以维持多视几何一致。微调使用 r = 8 的 Re-normalized LoRA,总参数增加严格低于 3%,在单张 RTX 3090 上 AMP、batch size 16、15 个 epoch,约 14 小时。
- 有了高保真深度与射线后,长序列按块处理。相邻块 Ck 与 Ck+1 取出重叠帧位姿,用解耦优化求 Sim(3):旋转由重叠协方差的 SVD 得到,尺度与平移由最小二乘求解,再把 Msim 作用到下一块。沿序列传播后得到粗但全局一致的初始轨迹 Tglobal。
- 射线头为每个像素预测 7 通道向量:前 6 维是局部坐标系下的射线 ri = [di⊤, oi⊤]⊤,第 7 维是射线置信度;深度分支给出度量深度 zi 与深度置信度。局部三维点重建为 Pi = oi + zi di。为控制匹配复杂度,先把深度与射线置信度 min-max 归一化后以 β = 0.5 融合成联合置信度,再与深度梯度幅值组成复合分数 si(γconf = 0.8,γgrad = 0.2),按概率采样并做非极大值抑制以保持空间均匀。
- 跨帧关联不以针孔模型做唯一几何推理。源点 Pi 投影到目标帧得到搜索锚点,在窗口内最小化混合分数 S = wr eray + wg egrad + wp ephoto,默认 wr, wg, wp = 0.6, 0.2, 0.2。eray 是目标射线到三维点的垂直欧氏距离,egrad 是梯度余弦差异,ephoto 是局部块 SAD。匹配还要双向对称校验,重投影误差阈值 τsym = 5.0,以滤掉结构相似造成的假对应。
- 关键帧与回环共用 DINOv2 全局描述子的余弦相似度:与上一关键帧相似度低于 τkf = 0.70 时插入新关键帧,KITTI 上平均间隔约 3 到 5 帧;与历史关键帧相似度超过 τsim = 0.85 且时间间隔大于 100 帧时作为回环候选。检测到回环后扩大时间窗,用 DA3 提取高置信相对位姿,再在 SE(3) 位姿集合上建因子图。
- 全局能量把稀疏射线场的几何一致性与多帧回环位姿先验加在一起,位姿项权重 λpose = 10.0,并用 Huber 核。有了分段轨迹对齐提供的度量尺度初始化后,Levenberg-Marquardt 收敛,得到漂移更低的全局一致重建。作者强调这与只优化块间位姿的流式拼接不同:射线场直接编码三维几何并与深度先验耦合,从而施加刚性尺度约束。
逐图理解论文
研究缺口
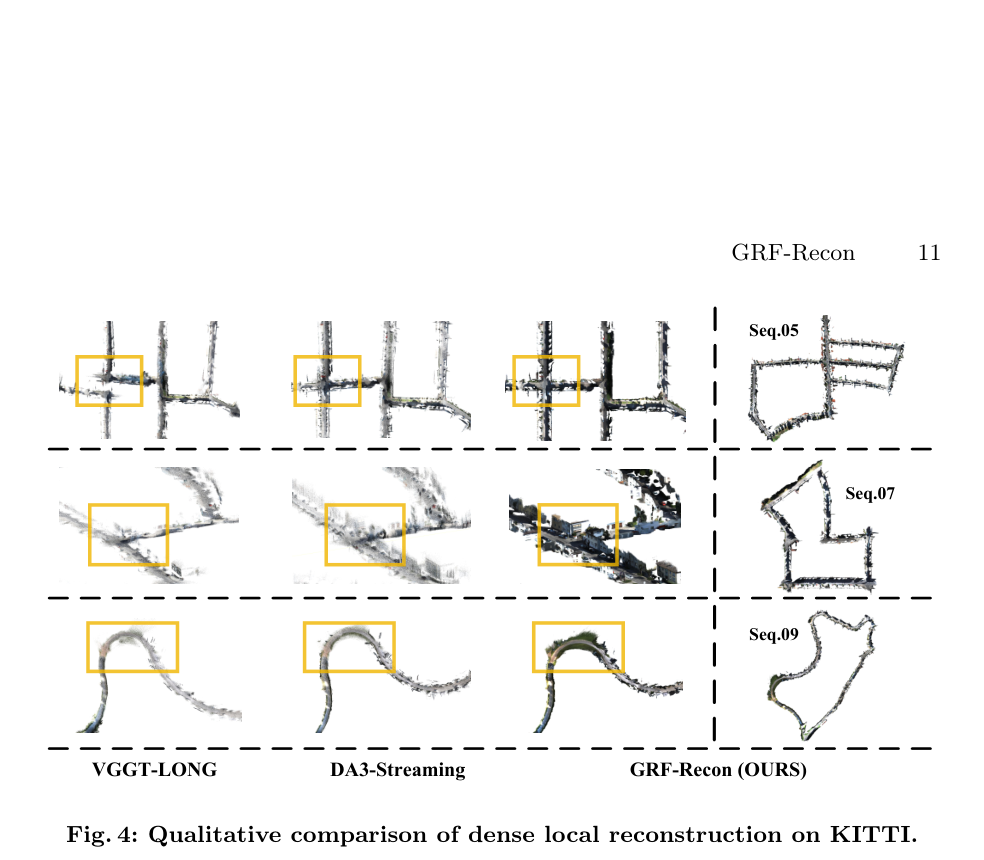
三行对应 KITTI Seq.05/07/09 的局部放大,三列是 VGGT-Long、DA3-Streaming 与 GRF-Recon。黄框标出路口交叉、坡道与弯道,右侧是各序列全局轨迹。用来对照块内几何发糊与本文更干净的局部结构。
方法贡献
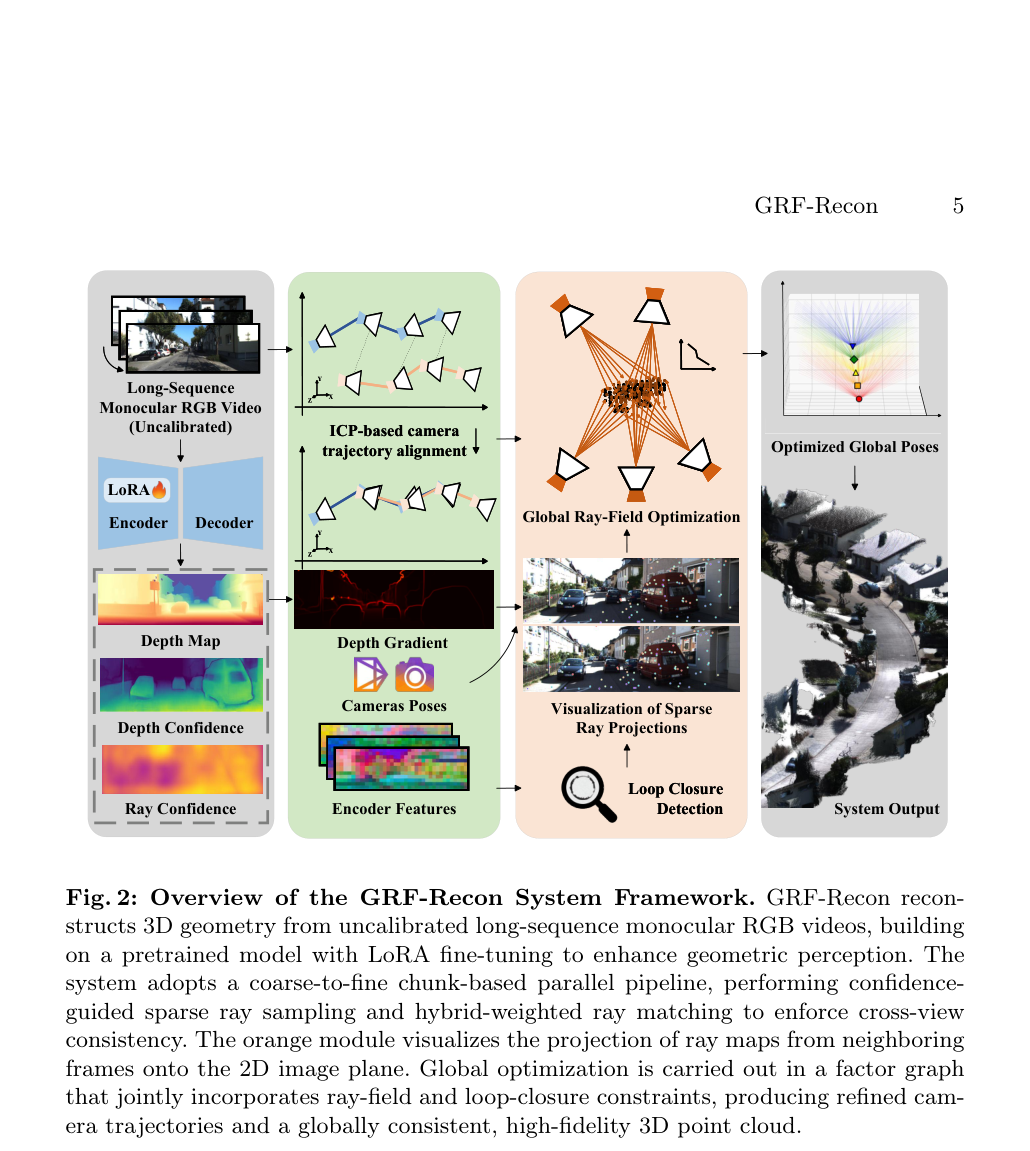
按四列阅读系统框架:未标定长单目视频经 LoRA 增强的 encoder/decoder 得到深度、深度置信度与射线置信度;中间绿色列做 ICP 式轨迹对齐并准备深度梯度、位姿与 encoder 特征;橙色列做稀疏射线投影可视化、回环检测与全局射线场优化;最右列输出优化后的全局位姿与点云。
关键机制
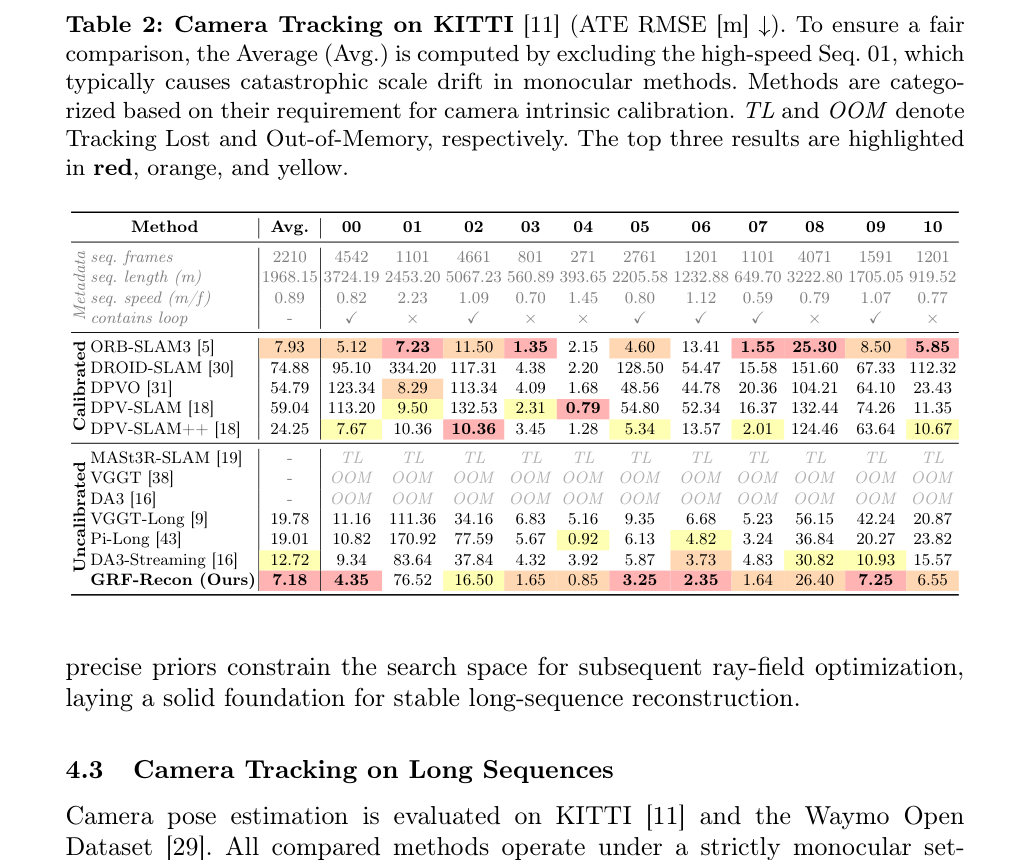
KITTI 跟踪主表。先看是否需要内参的分组,再看 Avg 列:GRF-Recon 7.18 为未标定组最低,并低于 ORB-SLAM3 的 7.93。Seq. 00 为 4.35。记住 Avg 排除 Seq. 01;MASt3R-SLAM 为 TL,VGGT 与 DA3 为 OOM。
核心结论
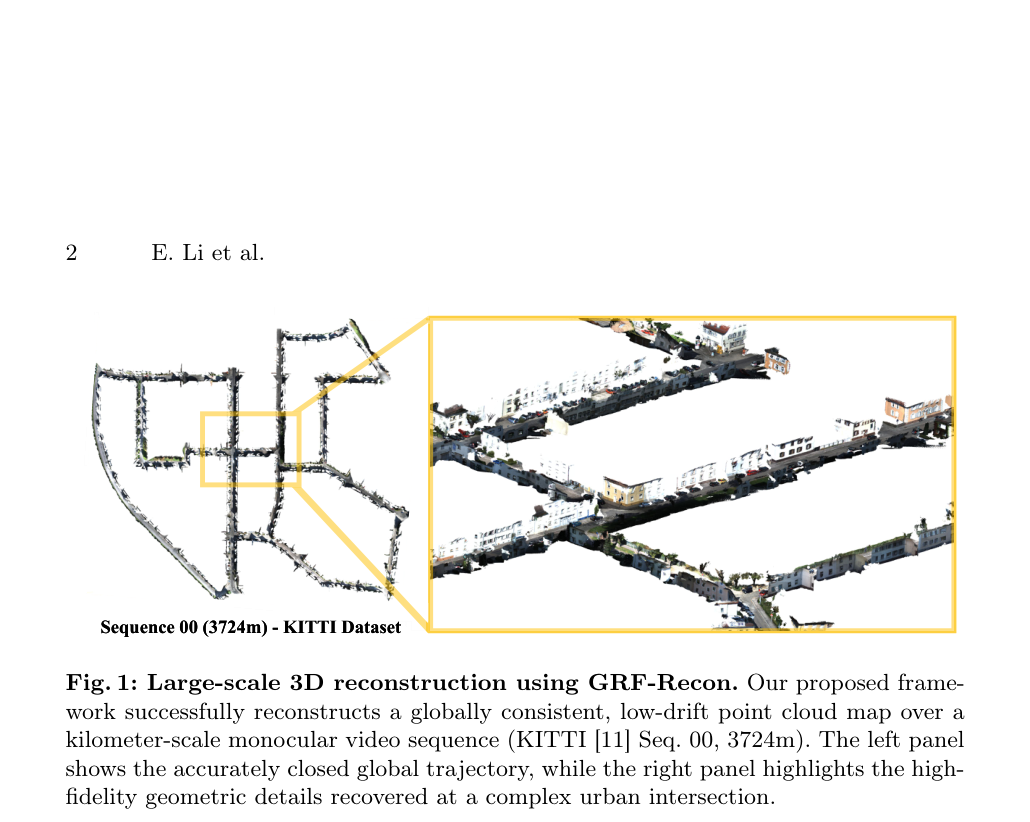
先看左侧 KITTI Sequence 00 的闭合点云轨迹,标注为 3724 m;再看黄色框拉出的路口细节:楼体、路面与交叉口几何保持连续,用来建立“千米级单目也能低漂移闭合”的直觉。
实验如何设计?
- 轨迹与场景重建在 KITTI 与 Waymo Open Dataset 上评测,深度在 ETH3D、SINTEL 与 DIODE 以及半稠密 KITTI Depth 上评测。工作站为 Ubuntu 22.04、i9-13900K、128 GB 内存、单张 RTX 3090 24 GB。相机跟踪报告 ATE RMSE(米,越低越好);深度报告 Rel 与阈值精度 δ1;点云报告 Accuracy、Completeness 与 Chamfer Distance。因单目尺度歧义,评测前用全局 Sim(3) 把轨迹和点云对齐到 LiDAR 真值。下游新视角合成报告 PSNR 与 SSIM。
- 推理时把图像宽度缩放到 504 像素并保持宽高比,另一维取 14 的倍数以匹配 ViT patch。对预测置信度的方法,统一保留大于全局均值 0.7 倍的三维点。作者特别提醒:Waymo 车载 LiDAR 受安装高度与垂直视场限制,楼顶和树冠等区域没有真值,视觉前馈重建若恢复了这些结构,距离指标反而会重罚,因此定性对比是定量表的必要补充。
- KITTI 跟踪把方法按是否需要相机内参标定分组。平均分明确排除高速 Seq. 01,因为该序列通常会让单目方法出现灾难性尺度漂移。VGGT 与原始 DA3 在长序列上记为 OOM,MASt3R-SLAM 在 KITTI 上记为 Tracking Lost。默认分块配置 C/O = 60/10。
- 消融覆盖:去掉 LoRA、去掉稀疏关键帧、改变射线匹配权重 (wr, wg, wp)、完全去掉射线匹配 (0,0,0)、去掉回环、去掉全局优化后直接拼接位姿,以及 chunk/overlap 取 30/10、60/10、60/20。应用实验在无 GPS 的无人机城市场景进行,用重建点云初始化 3D Gaussian Splatting,不再单独跑 COLMAP。
关键结果与论文证据
- 深度方面,LoRA 增强后的 DA3 在 KITTI 上 Rel 从 5.14 降到 4.50,δ1 从 92.4 升到 97.1;ETH3D、SINTEL、DIODE 与 KITTI 的平均 Rel 为 6.95、平均 δ1 为 91.4,贴近教师 MoGe 的 5.62 / 93.8,且明显优于全量微调容易过拟合的风险表述。定性上,原始 DA3 NESTED-GIANT-LARGE-1.1 权重在细杆、树叶和车辆轮廓上过平滑,微调后这些高频结构能从背景中干净分开(第 9–10 页,Figure 3,Table 1)。
- KITTI 长序列跟踪中,GRF-Recon 排除 Seq. 01 后的平均 ATE 为 7.18 m,低于标定 ORB-SLAM3 的 7.93 m,也低于未标定 DA3-Streaming 的 12.72 m 与 VGGT-Long 的 19.78 m。Seq. 00 长 3724.19 m、4542 帧,ATE 为 4.35 m。DROID-SLAM 平均 74.88 m 且多条轨迹漂移严重;MASt3R-SLAM 全序列 Tracking Lost;VGGT 与原始 DA3 为 OOM。高速 Seq. 01 上本文仍为 76.52 m,作者未把它计入平均分(第 10 页,Table 2)。
- Waymo 上平均 ATE 为 1.39 m,优于 DA3-Streaming 1.76、VGGT-Long 2.03 与 MASt3R-SLAM 5.01。定性对比 KITTI Seq.05/07/09 的局部稠密重建时,VGGT-Long 与 DA3-Streaming 在路口和弯道处点云分层、几何发糊,GRF-Recon 的路口结构更完整,全局轨迹也更闭合(第 11 页,Figure 4,Table 3)。
- 效率上,块大小 60 时前端推理约 8 秒每块,射线匹配约 0.16 秒每关键帧、分块对齐约 0.15 秒每块,可被前馈推理掩盖;KITTI 00 后端 LM 优化 10.23 秒,端到端 11 分 45 秒;KITTI 07 为 2 分 41 秒,KITTI 09 为 4 分 03 秒。作者称千帧以上序列的全图优化仍可在约 10 秒内收敛,并维持 24 GB 显存预算(第 12 页,Table 4)。无回环条件下,射线优化相对相机 decoder 与原始射线预测能压低块内漂移(第 12 页,Figure 5)。
- Waymo 点云重建中,本文在多数序列的 Accuracy、Completeness 与 Chamfer Distance 上优于 MASt3R-SLAM、VGGT-Long 与 DA3-Streaming。以 Seq.163 为例,三项指标为 0.910 / 1.980 / 1.560,对照 DA3-Streaming 的 1.050 / 2.680 / 1.820。作者把收益归因于射线场全局约束抑制了长轨迹上的点云分层与重影(第 13 页,Table 5)。
- 消融显示前端深度微调与混合权重射线匹配都不可少:KITTI 00 上去掉 LoRA 后 ATE 从 4.35 升到 6.80,去掉射线匹配升到 8.12,去掉全局优化后直接拼接升到 12.35。C/O 在 30/10、60/10、60/20 之间变化很小,默认取 60/10 以平衡显存与速度。无人机应用中,点云初始化的 3DGS 约 1000 次迭代即可收敛,四张示例渲染的 PSNR/SSIM 为 29.96/0.929、28.72/0.903、28.78/0.894、26.35/0.849(第 13–14 页,Table 6,Figure 6)。
阅读时需要注意
- 结论写明方法在刚体环境较稳健,但对高度动态物体仍然困难;未来工作指向复杂场景中的重建精度与实时一致性。
- 高速 KITTI Seq. 01 仍出现大幅尺度漂移(ATE 76.52 m),平均分把该序列排除,阅读 KITTI 表时不能把 7.18 m 理解成全部 11 条序列的简单平均。
- LiDAR 真值视场有限,楼顶、树冠等视觉重建会被 Accuracy 一类距离指标惩罚,定量几何表会低估这些区域的有效重建。
- 深度虽接近教师模型,平均 Rel 6.95 仍高于 MoGe 的 5.62;SINTEL 上 Rel 15.21,动态高光场景仍难。
- 长序列仍靠分块才跑进 24 GB;原始 VGGT 与 DA3 直接推理会 OOM,说明可扩展性来自系统工程而非骨干本身能一次吃完整视频。
关联工作
- DA3 是本文的感知骨干,也提供 DA3-Streaming 对照。原始权重在细结构上过平滑,完整模型在长序列上 OOM;流式版本能跑完,但主要优化块间位姿,块内几何缺少全局射线约束。
- VGGT 把视觉几何收进 Transformer,VGGT-Long 用分块、回环与对齐把范围推到千米级 RGB,但作者认为这类拼接仍缺深层几何约束,KITTI 平均 ATE 明显高于本文。
- ORB-SLAM3 代表需要内参的传统视觉 SLAM,KITTI 平均 7.93 m,是作者用来说明“未标定前馈也能接近标定 SLAM”的参照。DROID-SLAM、DPVO 与 DPV-SLAM 同属学习型里程计/SLAM,长序列漂移或对标定依赖更明显。
- MASt3R-SLAM 试图把前馈先验嵌进实时 SLAM,但仍依赖复杂传统后端;在 KITTI 上因关键帧基线突然变大而 Tracking Lost。Fin3R 用单目蒸馏做参数高效微调,直接启发了本文的 LoRA 注入。COLMAP 则是下游 3DGS 初始化中被替换掉的 SfM 阶段。