快速导读:Osnabrück、Wuppertal 与 Wayve 用高召回众包流水线重标 COCO、Pascal VOC、Cityscapes 与 KITTI,用至少 11 名标注者的软标签揭示漏标主导的标签错误,并给出面向软标签的检测评测与真实漏标检测基准。
目标检测的排行榜看起来越来越密,但 COCO、Pascal VOC、Cityscapes、KITTI 上的框仍经常是不完整的硬标签。小目标、遮挡和挤在一起的实例一旦没被标出,标准 AP 就把模型对它们的预测记成假阳性,同时忽略类别本身的歧义。Osnabrück 大学、伍珀塔尔大学与 Wayve 的这篇 arXiv:2609.21822 认为,基准质量首先被漏标限制,而不是只被网络结构限制。
作者用同一套三阶段微任务重标四个数据集,强调高召回,并用至少十一名标注者的投票构成软标签。对象数量在 KITTI 上增加约六成、在 COCO 上增加约四成;专家复核显示假阴性率至少减半。基于 Validated GT,他们比较原始与验证真值上的检测器表现,提出 Average Similarity,并构建真实标签错误检测基准。代码与四套验证标注声称将公开到 GitHub。
英文题目:Object Detection Benchmarks are Incomplete: The Role of Label Errors and Annotation Uncertainty
论文出处:arXiv 每日论文精选 · arXiv:2609.21822
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有检测数据默认每个物体只有一个确定类别、一套确定框。漏掉的物体在评测里变成“不该被检出”的背景,于是完整度越高的预测反而可能被罚。同时,单次标注无法表达 aleatoric 不确定性,训练出来的模型容易过自信。
相关工作通常只解决一半问题。LVIS 与 OpenImages 提高覆盖和细粒度,Pascal+ 精炼 Pascal 标注,但都不显式建模不确定性。CIFAR-10H、DCIC、ReLabel 把软标签做进分类。Rechecked 给 KITTI 子集提供检测软标签,却停在单一数据集和单一类别。本文要把补全与不确定性同时铺到多套检测基准上。
核心创新
- 在 COCO、Pascal VOC、Cityscapes、KITTI 上用同一高召回流水线同时补全漏标并采集多标注者软标签。
- 提出把 AP 推广到软标签的 Average Similarity,直接比较预测分布与人类软标签。
- 用真实漏标而非合成噪声构建大规模标签错误检测基准。
- 后处理校正类别提案带来的确认偏差,使软标签更接近无偏人类判断。
方法概览
三阶段微任务加后处理构成 Validated GT。Stage 1 按类别标全部可能实例的关键点并重复三轮以抬召回;Stage 2 为每个关键点画紧框并由两名标注者核对;Stage 3 至少 11 名标注者在数据集类别或 can't solve 中投票,得到类别软标签;歧义样本再加 11 票。后处理由专家按 IoU 去重,并用无提案无偏标注校正确认偏差。硬标签取众数且 p>0.5。AP 评测把软标签阈值取 0.8≤p。另提出 Average Similarity(AS/AUSRC):用 1−TVD 替代二值精度,按熵排序,并与背景比较未匹配预测。标签错误基准用 Validated GT 对照原始 GT,分成漏框、错位框、错类,宽松设定为 p≥0.5 的全部物体,严格设定为高度≥40 像素且 p≥0.8。
- 流水线见图 1。Stage 1:按图像和类别标全部可能实例的关键点,指令允许不确定或只露出一部分的物体;已有点会展示给后续轮次,共三轮,以减少漏点。没在这一阶段出现的物体后面不再进入。
- Stage 2:每次只展示一个关键点,标注者画紧包围框,两人重复,减少漏处理和框不准。
- Stage 3:把框交给至少十一名独立标注者,在数据集类别或 can't solve 中选择;关键点所属类别只作为提案。票数聚成类别概率分布。歧义样本再追加十一票。
- 后处理包括去重与偏差校正。已知提案会在不确定时被更容易接受,作者另采一小批无提案标注,用既有方法把提出类概率往无偏分布拉近,再用专家按 IoU 排序的重叠框对清重复。
- 覆盖:KITTI 全训练集 7481 张、7 类;Cityscapes 验证集全量重标、训练集只补漏,8 类;COCO 2017 验证 5000 张、80 类;Pascal VOC 2012 训练加验证、20 类。
- 硬标签 AP 把软标签阈值设为 0.8≤p。AS/AUSRC 用 1−TVD 当连续精度,未匹配预测与背景比,预测按熵排序。需要完整类别含背景的分布;若模型只给独立类别分数,则先做 isotonic 校准再用补概率乘积构造背景。
逐图理解论文
失败直觉
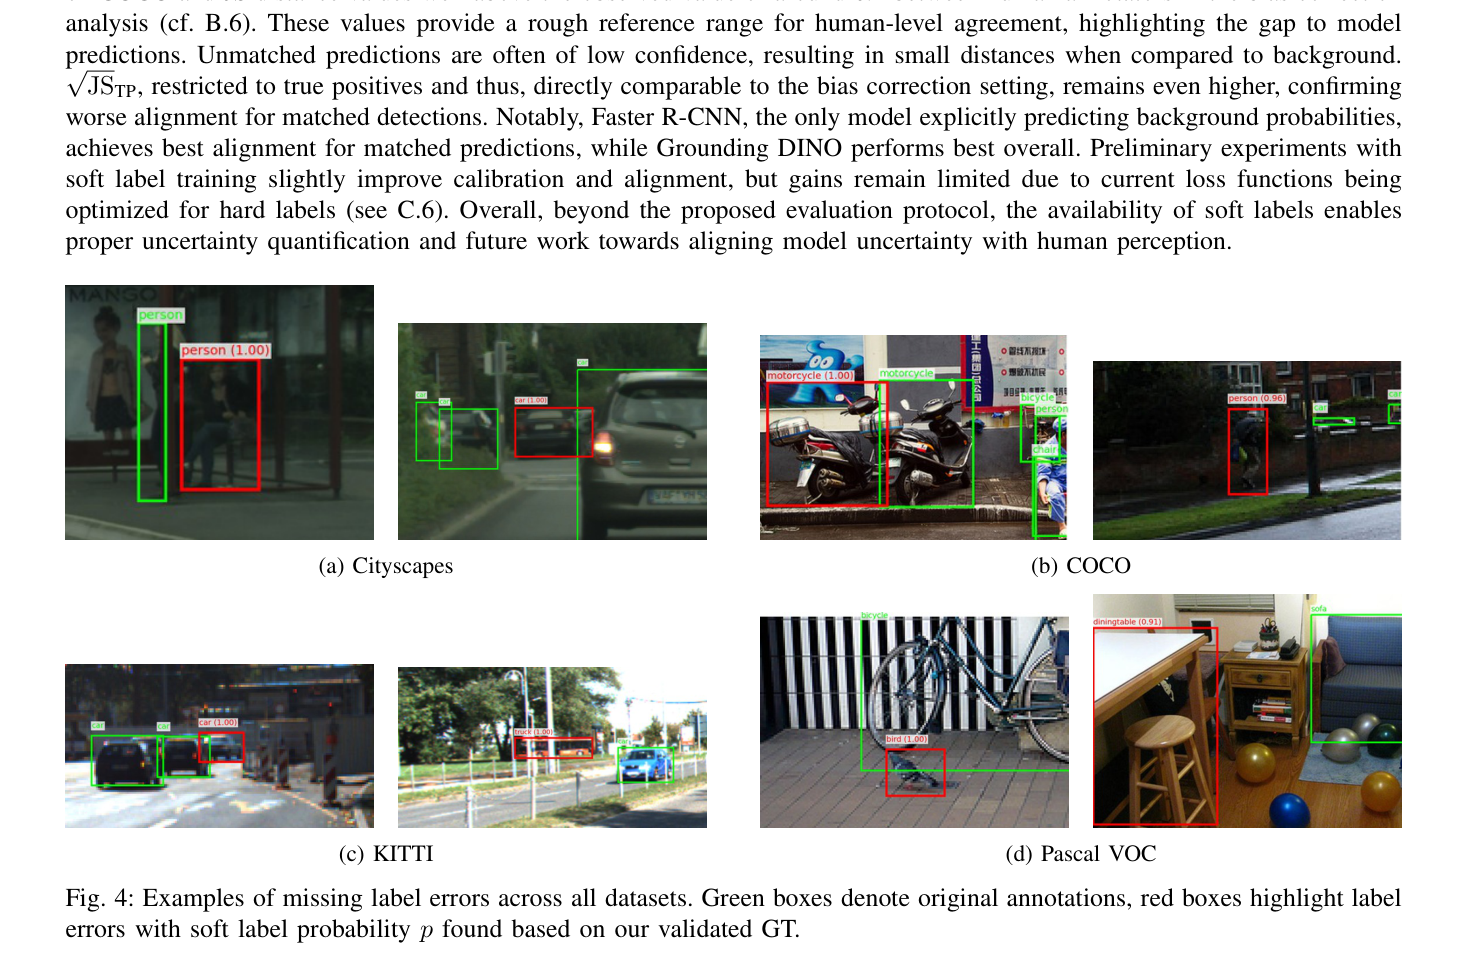
绿框是原始标注,红框是漏标,红字是类别与软标签 p。四宫格覆盖 Cityscapes、COCO、KITTI、Pascal VOC。重点看远处、截断和原协议可能忽略的区域。图顶正文是上一节残留,不是图注。
方法贡献
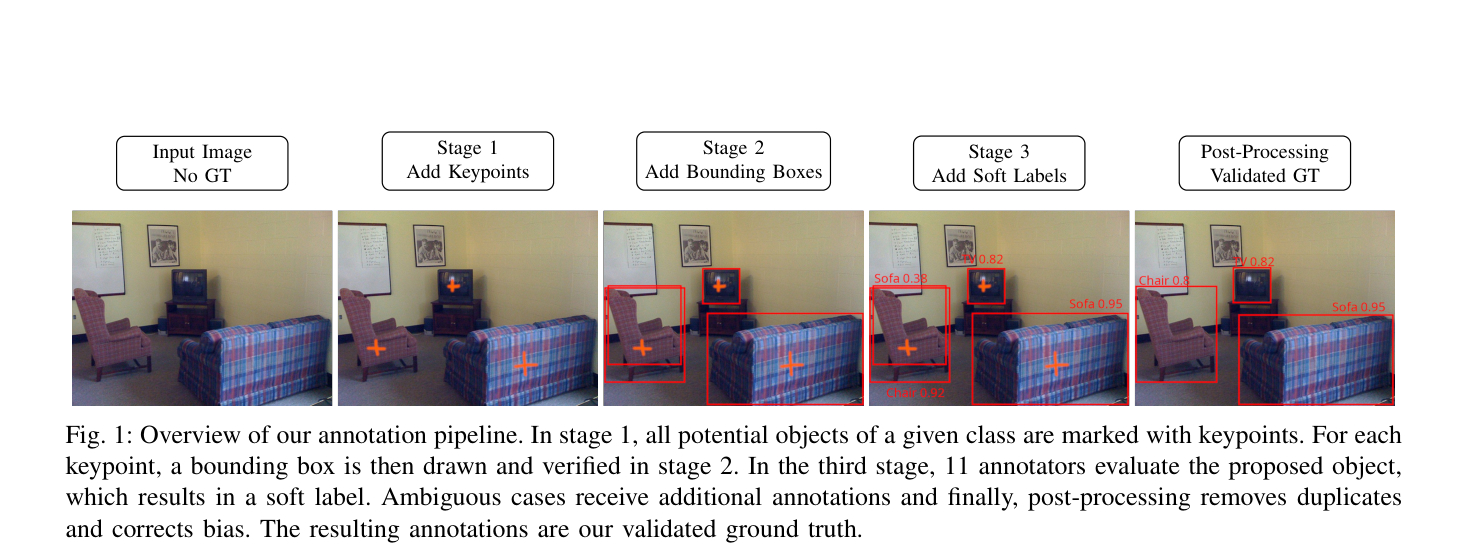
从左到右读五列:无真值输入、打关键点、画框、写软标签、后处理。注意 Stage 3 沙发框上的 Sofa 0.38 在末列消失,Chair 与高置信沙发被保留。这张图适合当方法总览和特色图,不要把它里的小数当成基准指标。
核心结论
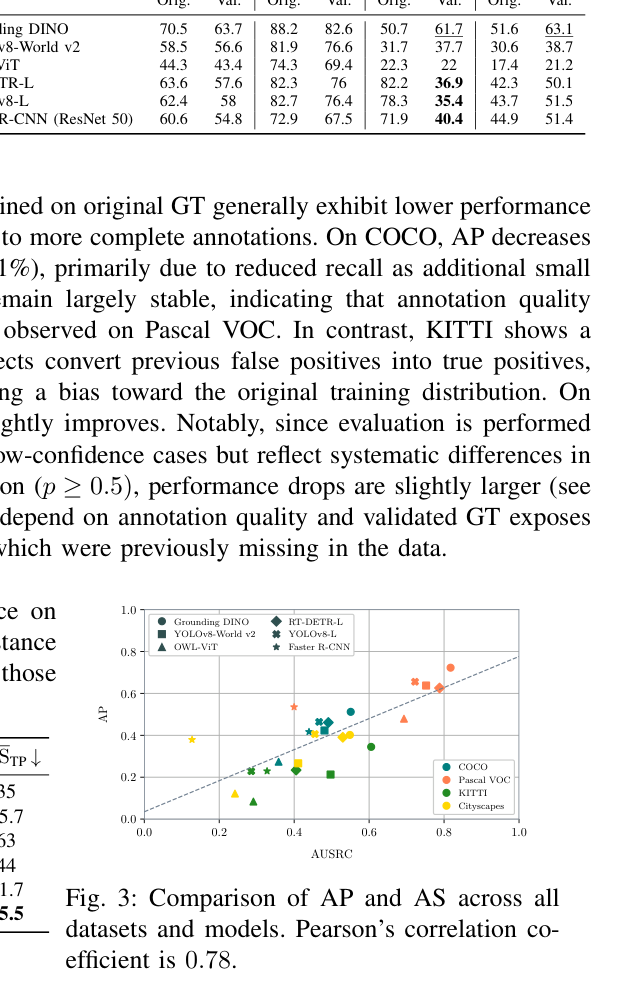
横轴 AUSRC、纵轴 AP,虚线对应 0.78 的相关。按颜色看数据集簇,Pascal VOC 最高,KITTI 微调模型在左下。图上方残表是 Table 8 的 AR,不要读进散点。用这张图说明 AS 能跟 AP 同向,但 AP 单独量不出与人类软标签的距离。
实验如何设计?
- 描述统计比较原始与验证对象数。完整性评估每数据集抽 600 图(Cityscapes 用全部 500 张验证图),三名专家互斥审可见物体,报告 Wilson 95% 区间的假阴性率。
- 标签错误分成漏框、错位框、错类。宽松 LEGT:全部物体且 p≥0.5;严格 LEGT:高度≥40 像素且 p≥0.8。COCO 只聚合验证集。
- 检测器:YOLOv8-L、RT-DETR-L、Faster R-CNN、Grounding DINO、YOLOv8-World v2、OWL-ViT,均在原始 GT 上训练或按原设定使用,再分别在原始与验证 GT 上算 COCO 风格 AP。
- 标签错误检测对照:Naive baseline(所有相对原始 GT 的假阳性)、Score baseline(按检测器置信度排序)、Loss Inspection(Cascade R-CNN)、ObjectLab、MetaDetect;主检测器用 Grounding DINO,匹配 IoU=0.1。
关键结果与论文证据
- Table 2(第 4 页):Cityscapes +5.1%(62,649→65,856),Pascal VOC +8.6%(31,561→34,262),KITTI +60.0%(39,597→63,348),COCO +40.0%(36,781→51,487)。增幅主要来自原先未标的小、遮挡、密集实例。
- Table 3:FNR 从 Pascal VOC 18.6% 降到 9.3%,COCO 13.1% 到 6.1%,Cityscapes 11.1% 到 3.8%,KITTI 41.5% 到 11.6%。KITTI 原标注的高 FNR 包含 don't care 区域里仍可见的物体。
- Table 4:漏框是主错误,错类通常低于 1%。宽松设定下 COCO 漏框 16,219(相对原 GT 44.1%),KITTI 22,710(57.4%);严格设定后 COCO 漏框降到 2,685,说明大量错误与小物体有关。
- Fig.2 与 Table 5:Pascal VOC 与 COCO kitchen 超类确认偏差明显,KITTI 很弱;后处理最多把提出类偏差相对降约一半。Table 6 显示软标签与专家 clearly/maybe/not 分桶大致落在预期区间。
- Table 8(第 7 页):COCO 与 VOC 上 AP 普遍下降(Grounding DINO COCO 56.9→52.1),排序大体稳定。KITTI 上开放词汇模型上升、微调模型大降(RT-DETR-L 78.5→27.3)。Cityscapes 因标注差异较小甚至略升。
- Fig.3:AP 与 AS 相关 0.78;AP 几乎不相关 TVD/JS,AS 相关约 −0.58/−0.60。匹配检测在 COCO 上 TVD 仍超过 25%,高于人类标注者之间约 0.1 的 JS 参考。
- Table 10:Score baseline 最强(KITTI F1 59.29,COCO F1 43.53);专门方法在真实漏标上达不到合成噪声论文里的表现。Naive baseline 召回接近满但精度只有约 0.4–2%。
阅读时需要注意
- 十一票软标签仍有标注者可靠性与确认偏差,Validated GT 不是完美真值。
- 评测多半改造硬标签流程,预测分布常靠事后校准。
- 没有对框位置建模空间不确定性,那需要每物体多次独立画框。
- COCO 只动验证集;Cityscapes 训练集不是全量重标。
- 标签错误匹配用很低的 IoU,服务人工审阅优先级,不是定位评测。
关联工作
- LVIS/OpenImages 说明覆盖可以做厚,但留下不确定性空白。
- 分类软标签文献说明单标注不够,却没有检测框这一层。
- Rechecked 是最接近的检测软标签前作,规模停在 KITTI 子集。
- ObjectLab、MetaDetect 与 loss inspection 在合成噪声上好看,换成真实漏标后排序质量掉到 Score baseline 之下。