在世界模型中训练物体恒常性
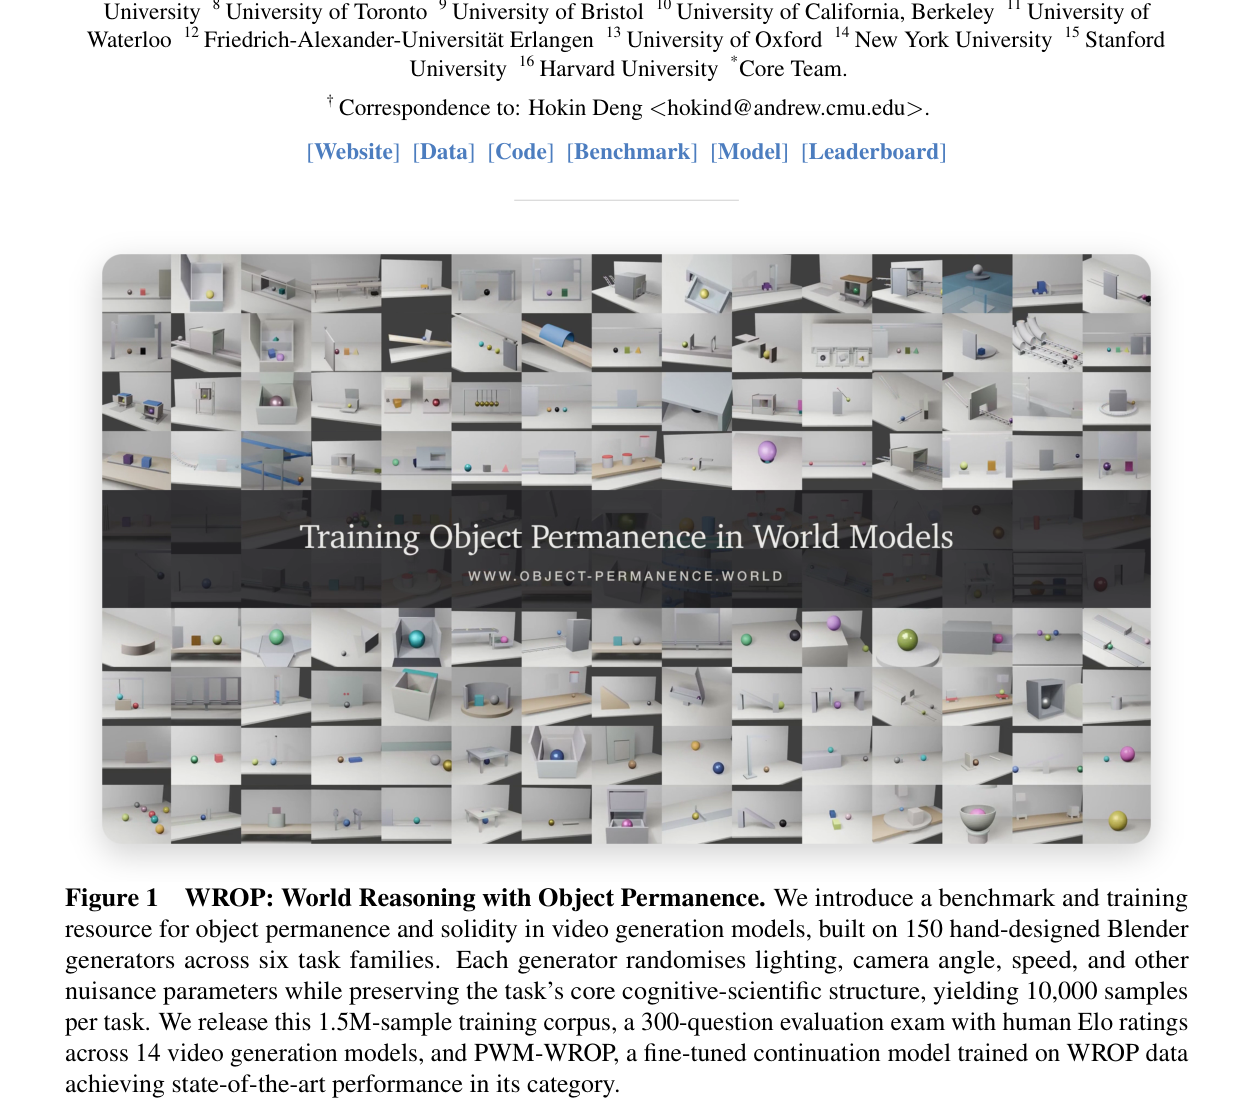
WROP 用 150 个认知科学启发的 Blender 任务构建 150 万样本与 300 题考试,评测并微调视频世界模型的物体恒常与固体性;PWM-WROP 在人评 Elo 中拿下真续写类第一、总榜第三。
WROP 用 150 个认知科学启发的 Blender 任务构建 150 万样本与 300 题考试,评测并微调视频世界模型的物体恒常与固体性;PWM-WROP 在人评 Elo 中拿下真续写类第一、总榜第三。
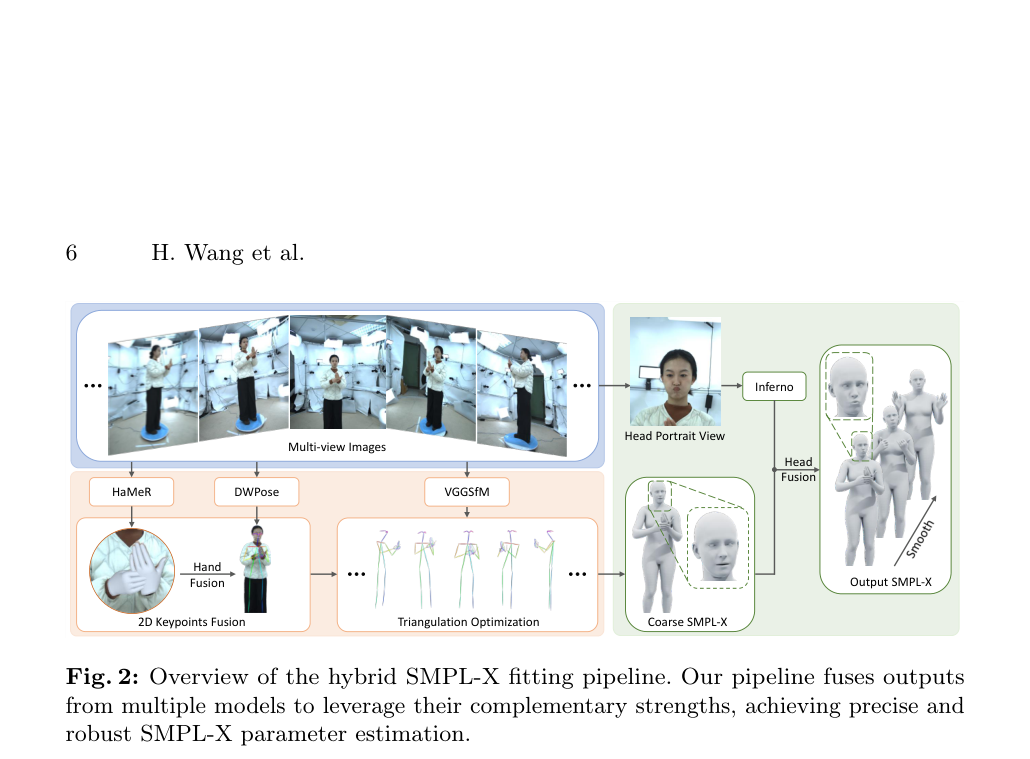
PHOSA(ECCV 2026)发布与听障专家共设的多视角中文手语数据集 MVSign,用混合 SMPL-X 拟合与身/头/手解耦高斯表示,做可驱动的逼真手语虚拟人。
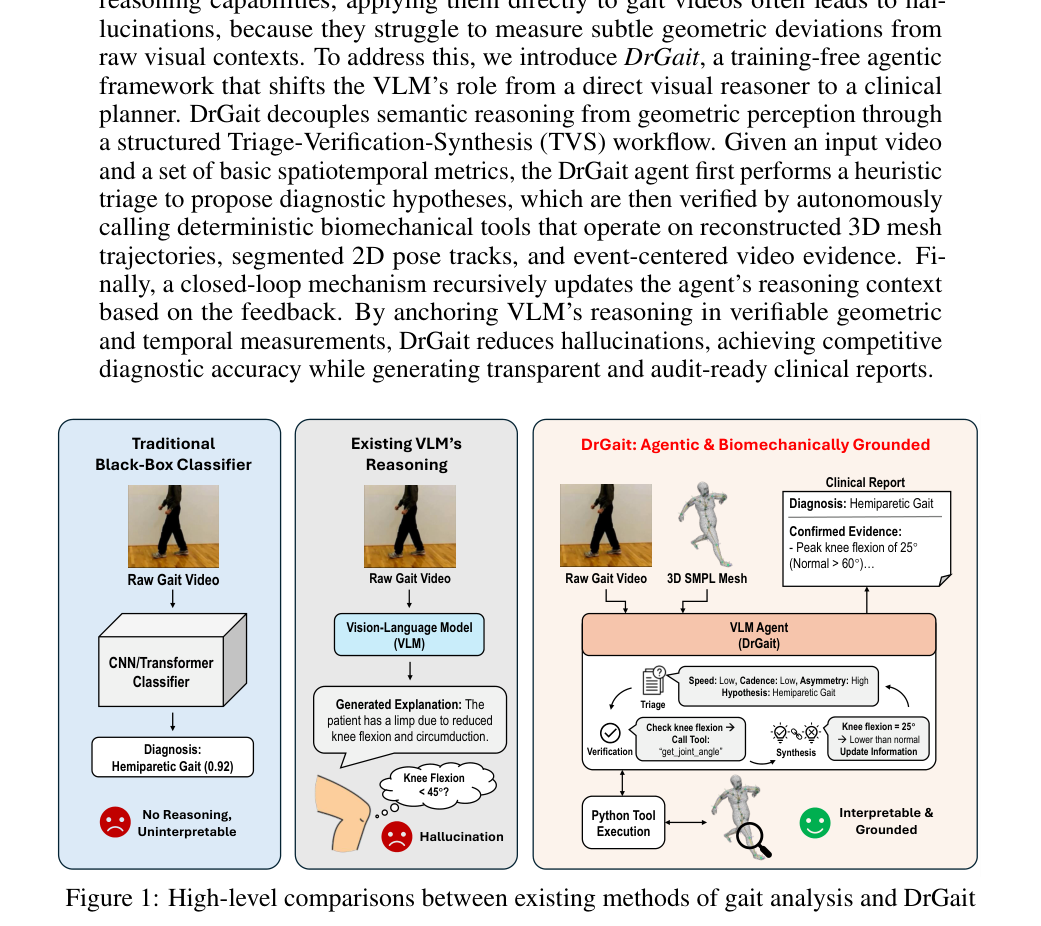
DrGait 是免训练智能体:把 VLM 从直接看视频推理改成临床规划器,经分诊-验证-综合闭环调用确定性生物力学工具,生成可审计步态报告;本文为研究原型,不是临床产品。
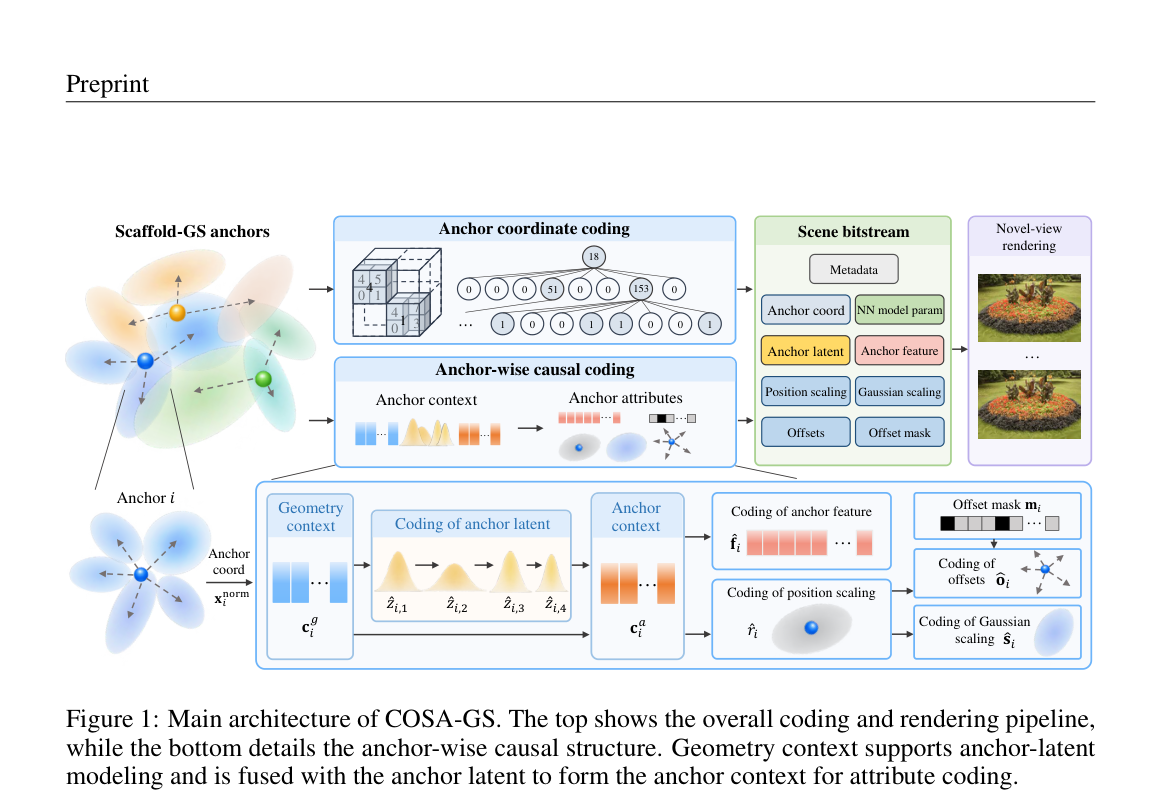
COSA-GS 在 Scaffold-GS 锚点上用无空间聚合的锚内因果上下文建模属性分布,结合率失真优化、自适应剪枝与整数量化感知推理,实现强压缩与跨平台比特级一致解码。
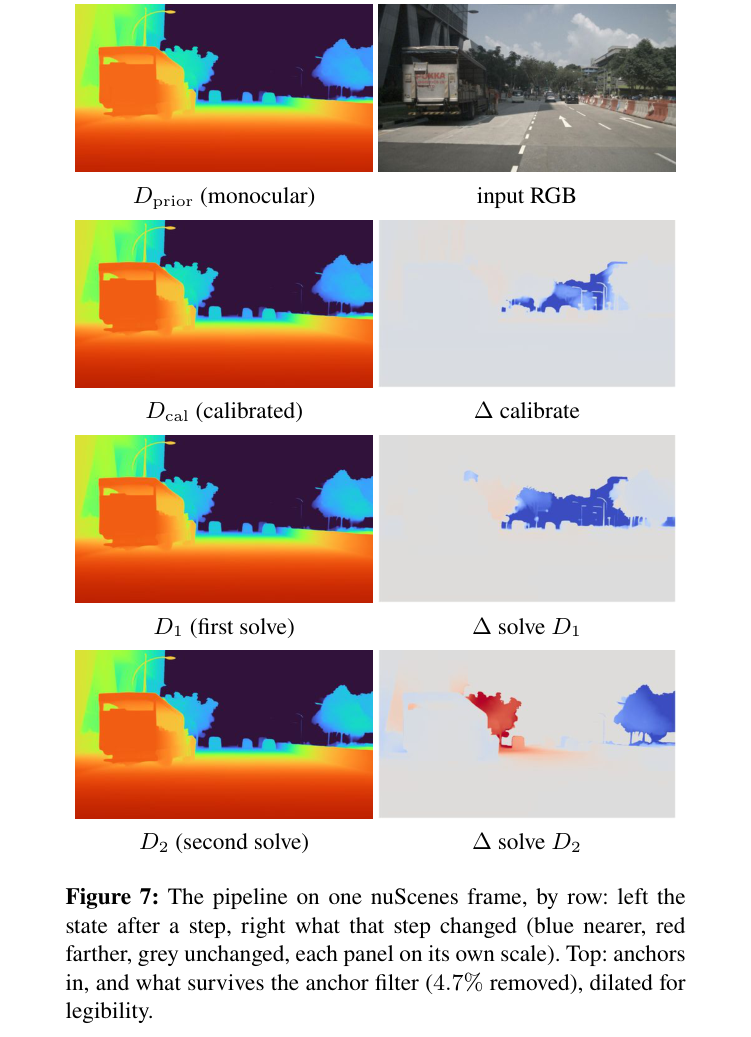
FounRef 是无需任务训练的模块化流程:用稀疏度量锚点校准冻结单目深度先验,经表面一致性过滤与双边网格结构保持求解,得到稠密度量深度。
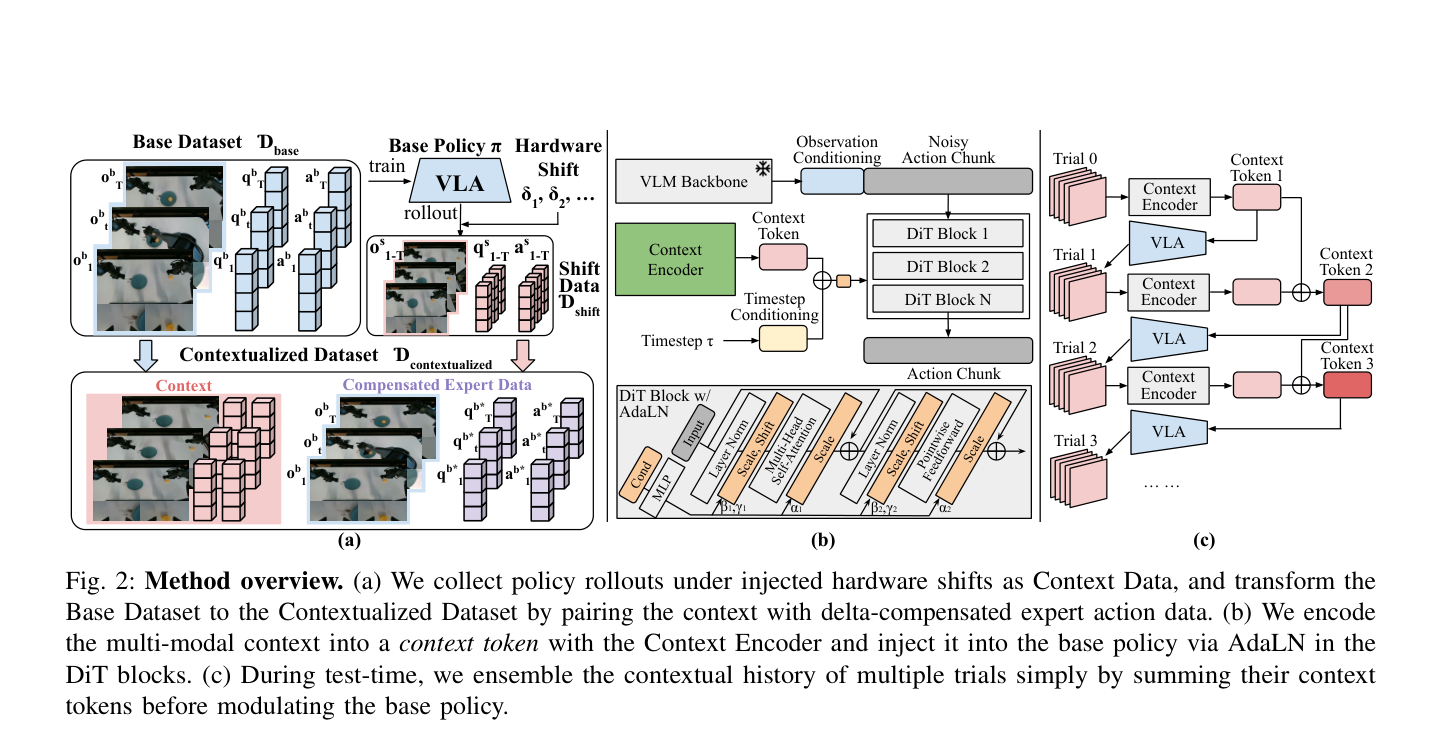
Self-Adaptive VLA 用漂移条件下的上下文专家数据训练插入式编码器,使 VLA 能在部署时凭借自身 rollout 迭代补偿未知硬件漂移。
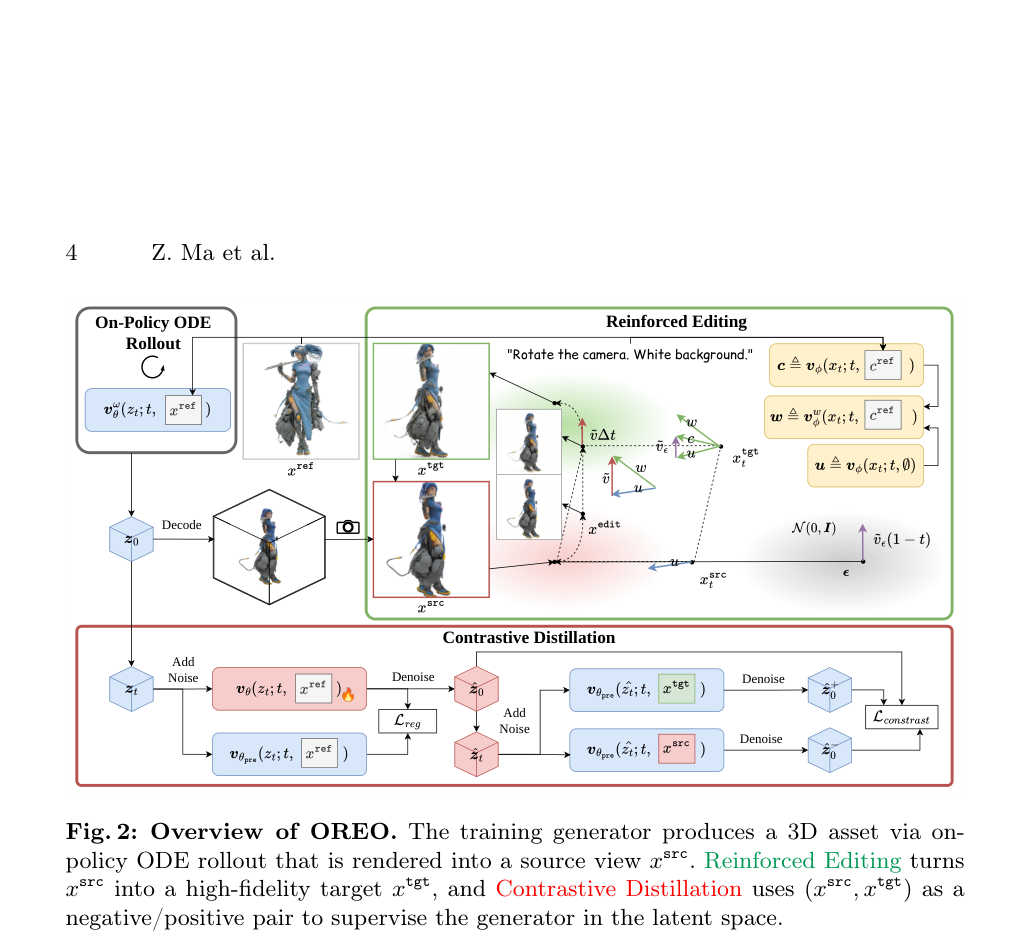
OREO 以 Reinforced Editing 生成结构对齐的二维伪目标,再经对比蒸馏把二维扩散先验在线写回三维生成器,提升 Trellis 等资产的视觉保真。
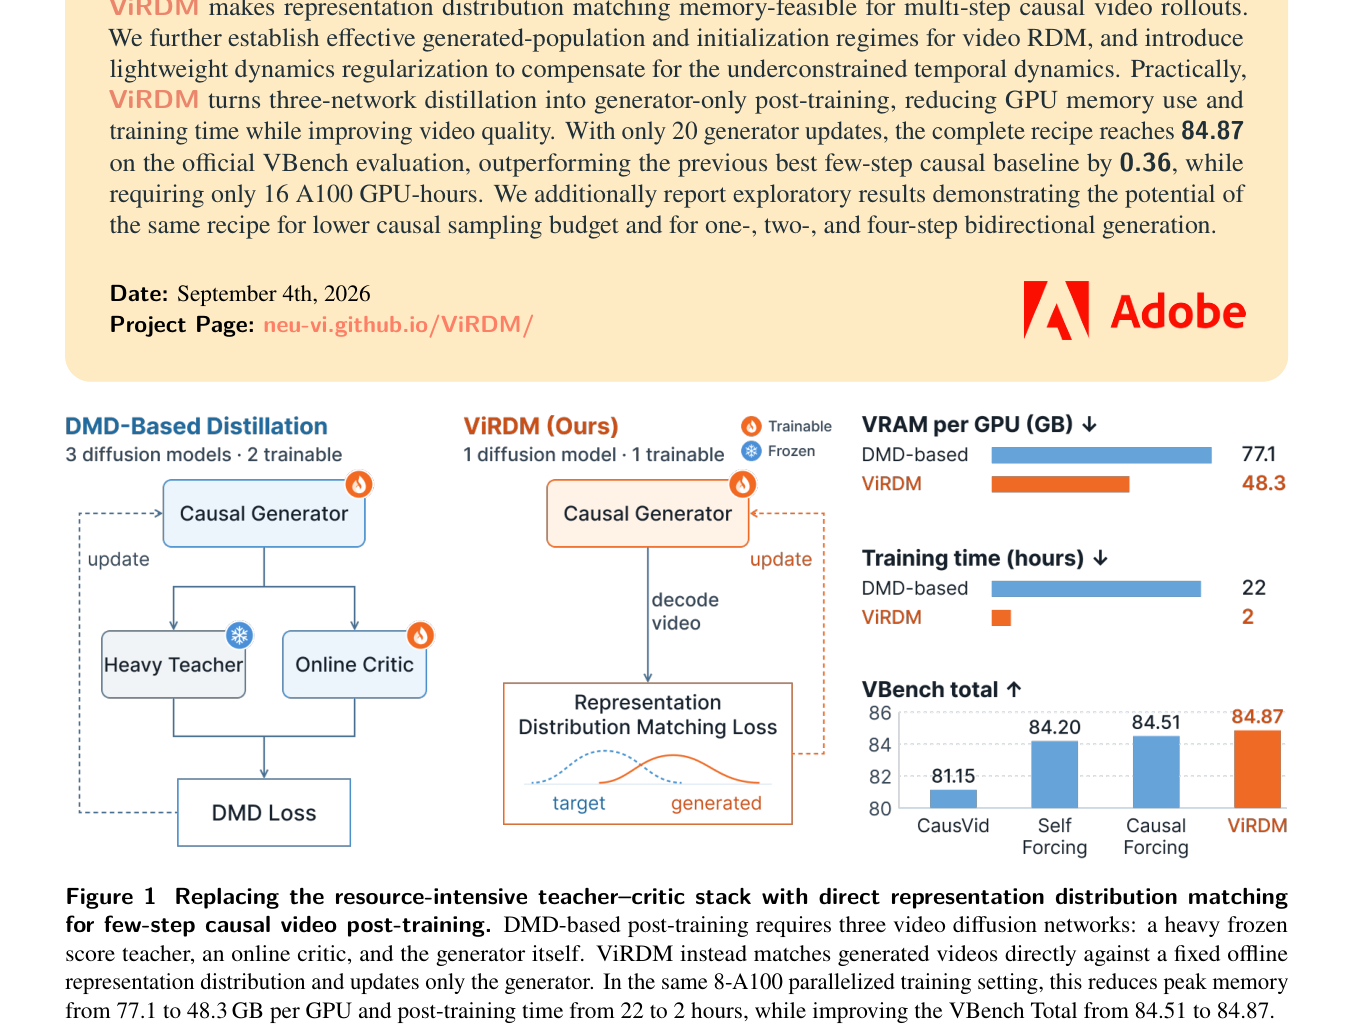
ViRDM 把图像侧表示分布匹配做成少步因果视频的生成器-only 后训练配方:用随机退出、分阶段 VJP 与轻量解码打通显存,再配因果 ODE 初始化与光流动力学正则,20 次更新达到 VBench 84.87。
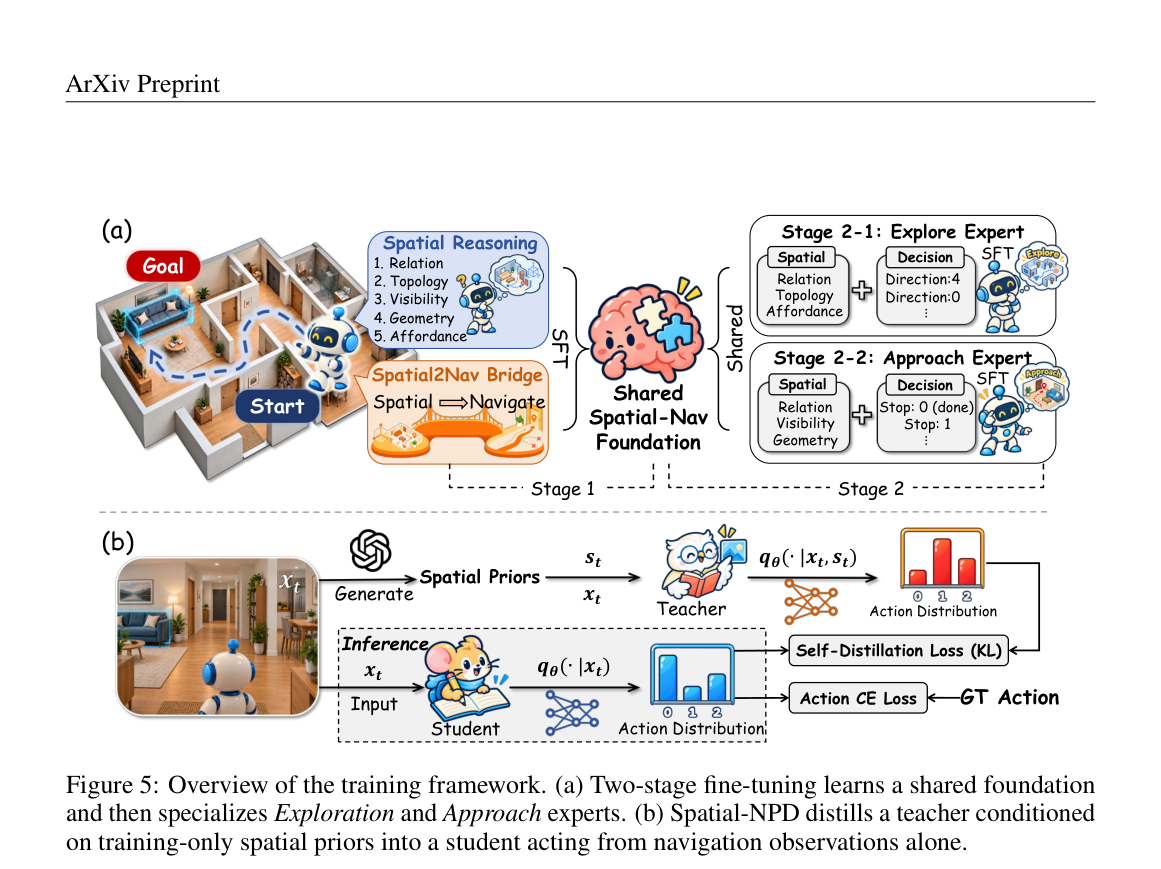
Spatial-Nav 分析表明空间基准专精难直接迁移到 ObjectNav;据此构建 SPATIAL-NAV-100K,经两阶段空间-导航微调与 Spatial-NPD 蒸馏,使 8B 策略在 HM3D/MP3D 上达到有竞争力的 SR/SPL,且推理无需显式空间思维链。
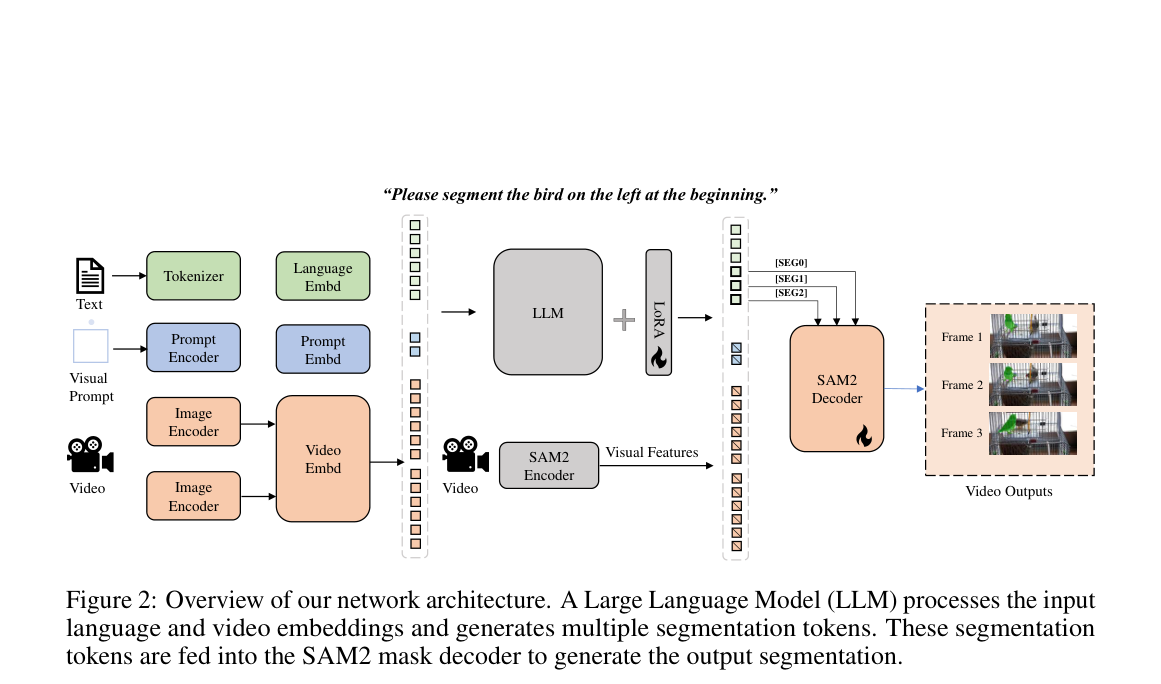
MoVISA 用对象-帧对齐的多个