PengChao
超越综述:视觉多目标跟踪中检测与关联的系统实证
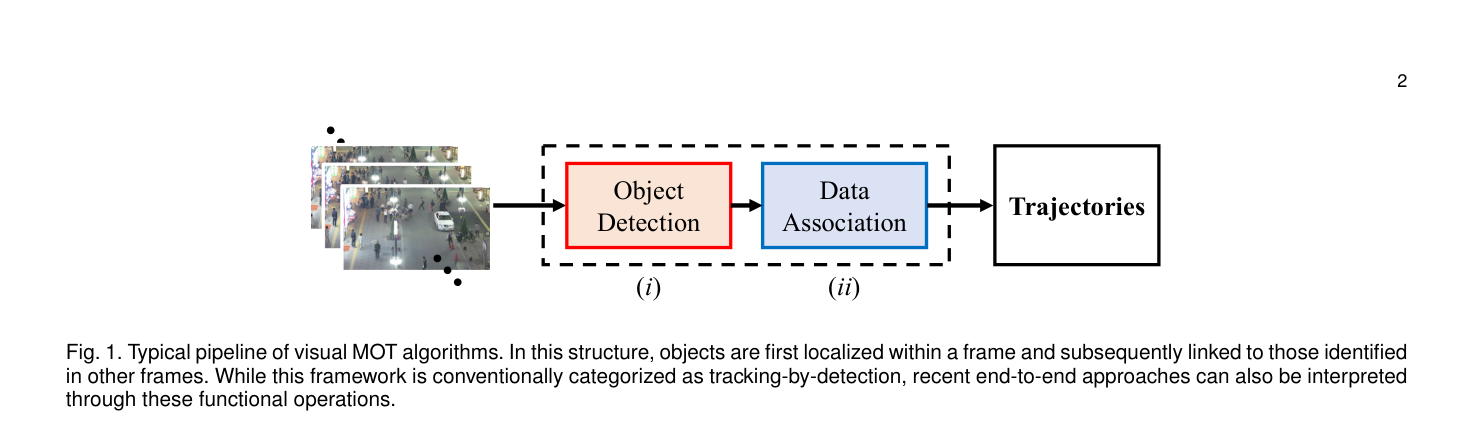
GIST 与华盛顿大学塔科马分校用公开实现把视觉 MOT 拆成检测和关联,在受控对照里检验“检测质量主导跟踪”这一长期直觉,并给出相机运动补偿矩阵的写法。
MinCU:用离散空间锚点同时描述并定位图像对中的最小变化
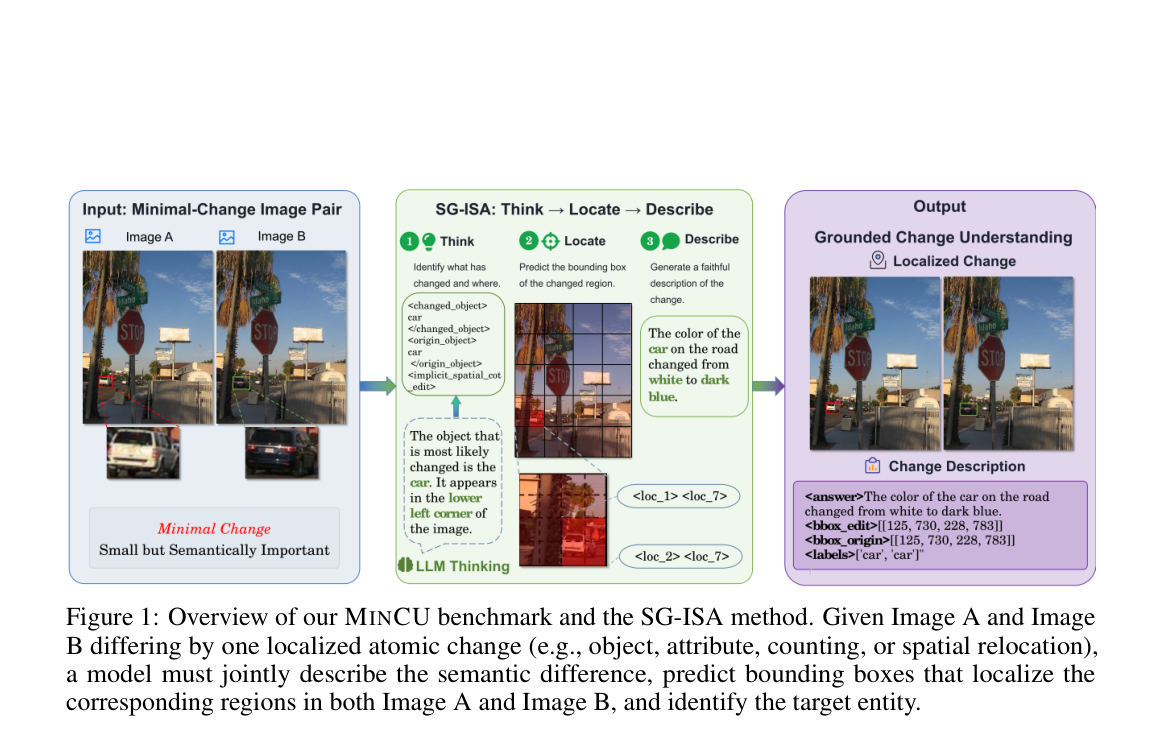
MinCU 用 2000 对只有一处原子变化的近重复图像,同时要求描述、双图框和实体名;SG-ISA 让 Qwen3-VL 先输出语义线索,再用 10 个离散位置锚点约束描述和细框。
PhysReflect:用几何与感知监督让扩散模型画出符合反射定律的镜子
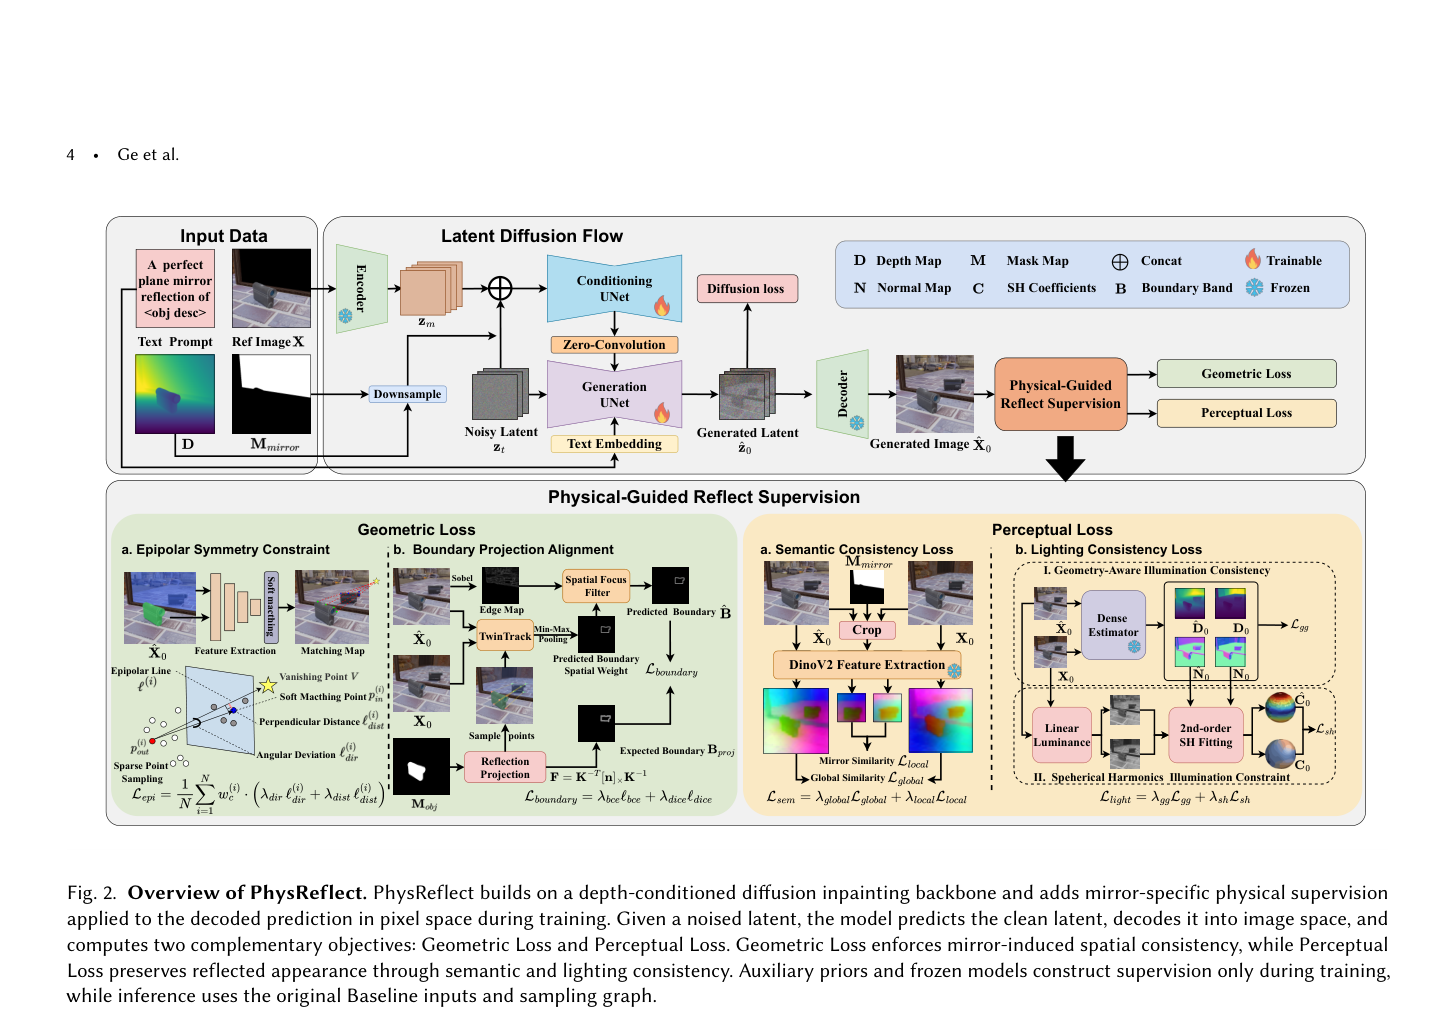
PhysReflect 在深度条件 BrushNet 修补骨干上,训练时把预测干净潜变量解回像素,用极线对应、TwinTrack 边界投影、DINOv2 语义和低阶球谐光照做镜面监督,推理图保持不变。
看见不够:视觉语言模型感知到证据却没有按证据做决定
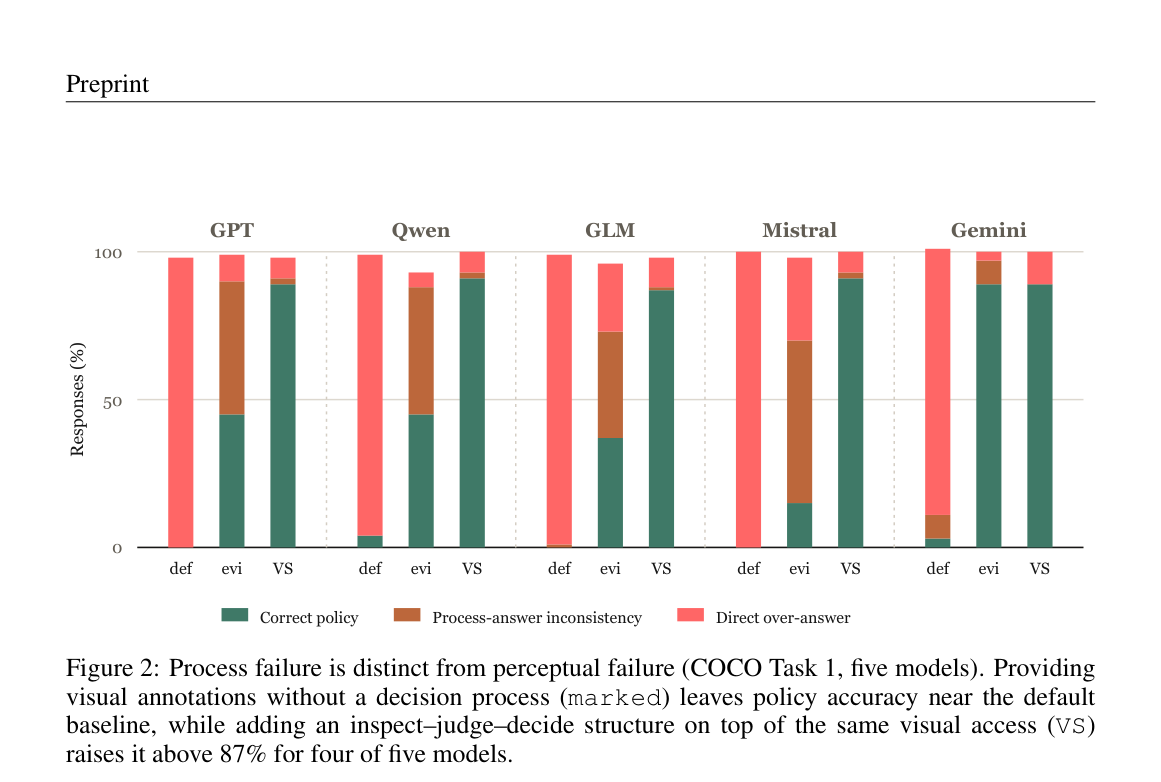
佛罗里达州立大学与 JAIST 的工作区分感知失败和过程失败:模型可以正确列出证据仍给出与证据矛盾的答案;SRT 用状态抽取、相关性核验和目标承诺约束决策,而增益取决于过程先验是否对齐图像当前的阶段边界。
SVEET:只在双向模型上训练的流式视频编辑
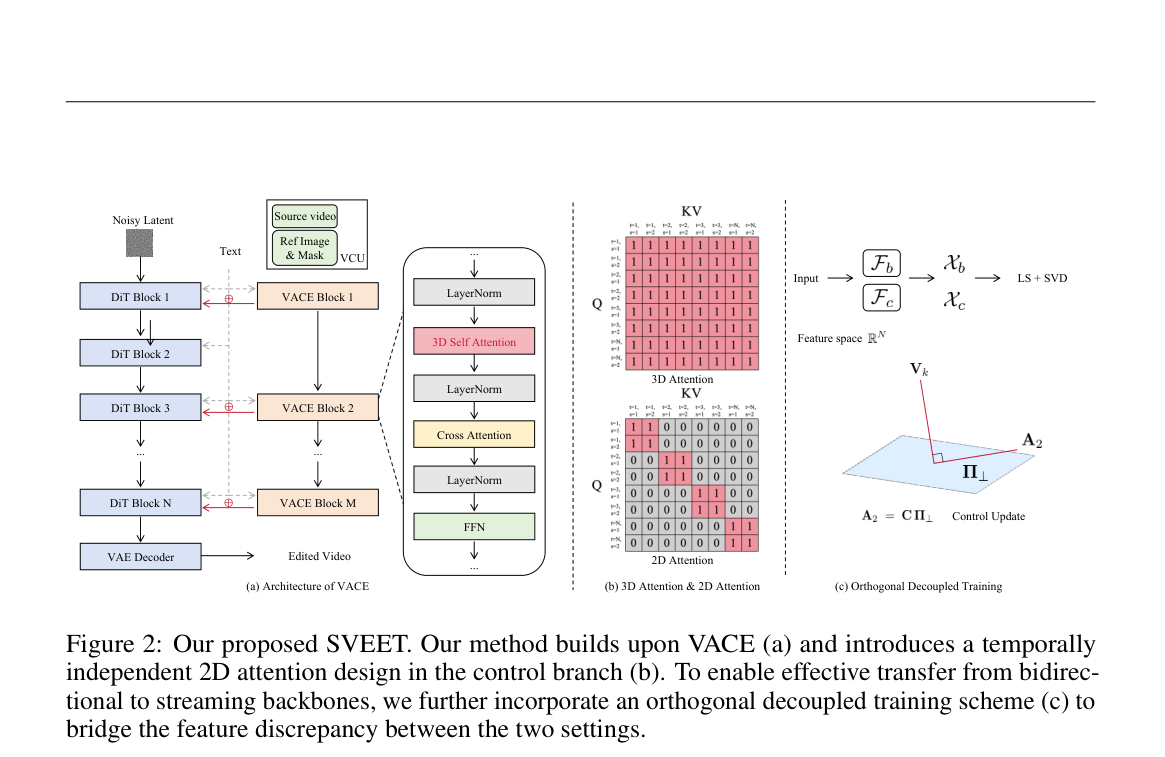
上海交通大学的 SVEET 只在冻结的双向 Wan-VACE 上训练逐帧二维控制分支,并用正交解耦训练避开双向到因果的特征差,从而把编辑零样本迁到冻结的 Causal Forcing,在单卡 H100 上达到 15 FPS。
RegVGGT:用按帧调控的记忆做流式几何重建
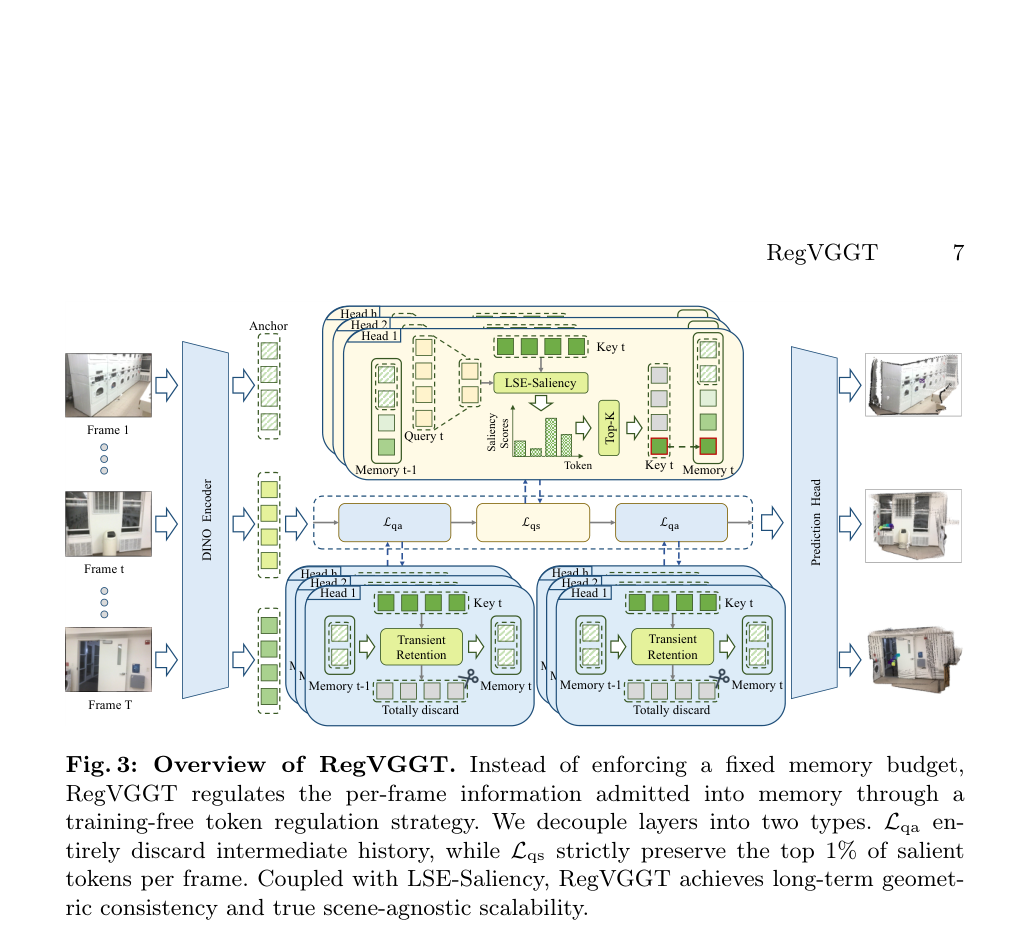
RegVGGT 冻结 StreamVGGT,按层按头只把最显著的约 1% 新令牌写进记忆,用 FlashAttention 的对数配分打分,从而在长视频流上少涨显存又少忘几何。
VideoGen-Agent:用多任务强化学习训练会调用工具的视频生成智能体
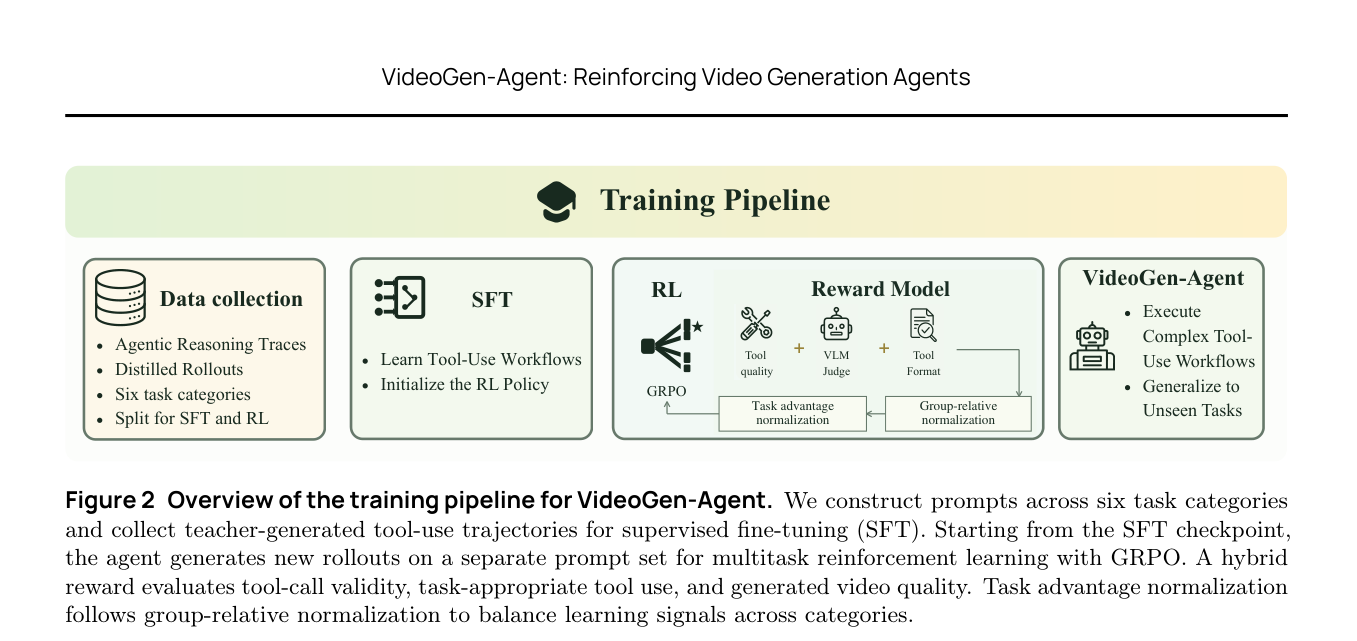
VideoGen-Agent 用教师轨迹监督微调和多任务 GRPO,训练一个共享策略去调度检索、仿真、生成与校验工具,并可用更强生成器替换后端。