边际覆盖达标,最差类别却归零:零样本VLM共形预测的类别尾部审计
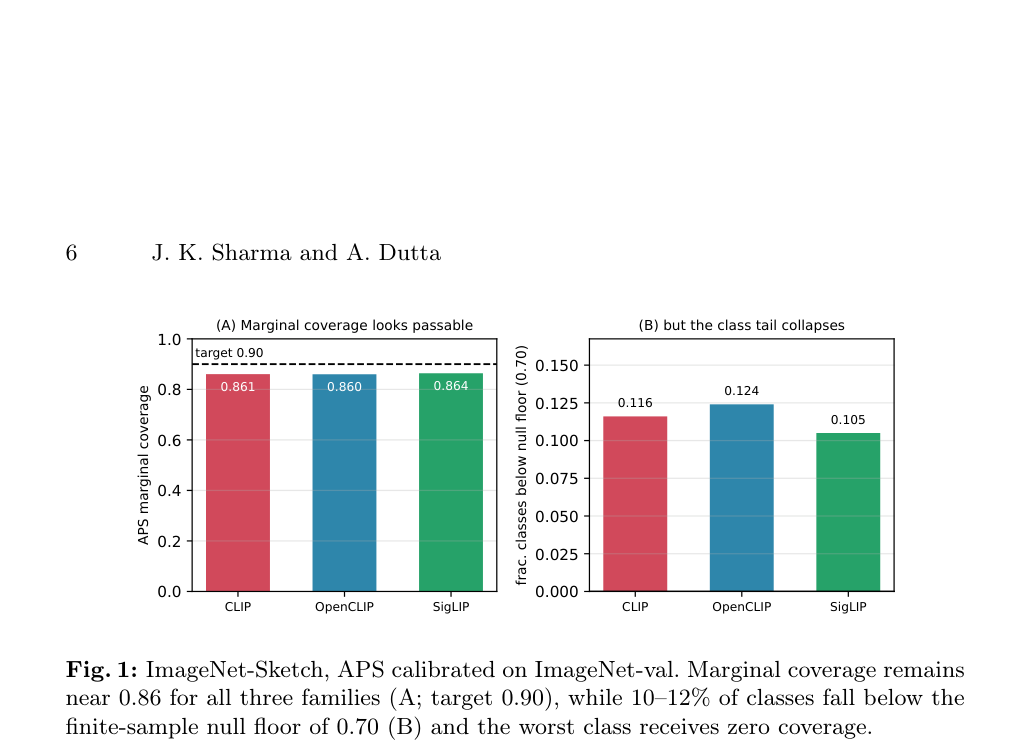
审计发现:零样本VLM的split-conformal预测在分布偏移下边际覆盖看似达标,但最差类别覆盖坍缩至≈0,且源域诊断无法预测该失效。
审计发现:零样本VLM的split-conformal预测在分布偏移下边际覆盖看似达标,但最差类别覆盖坍缩至≈0,且源域诊断无法预测该失效。
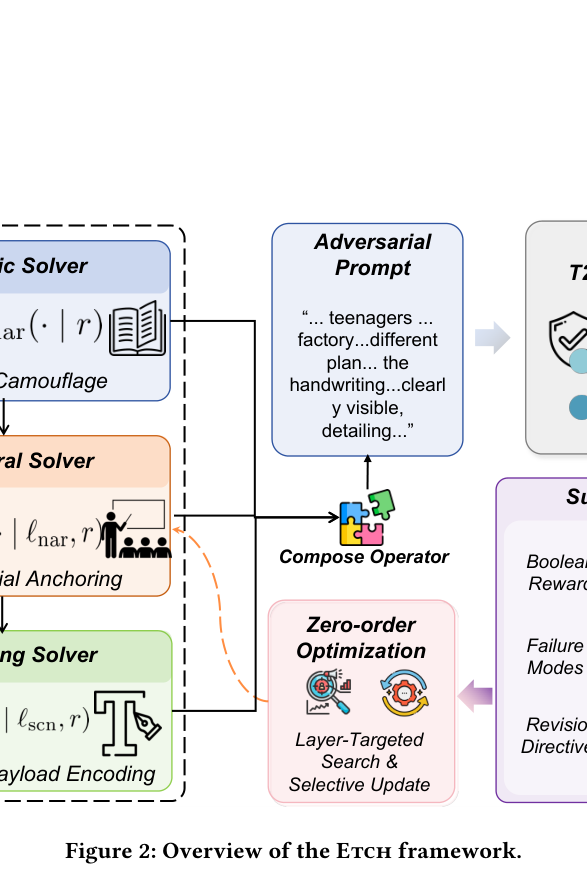
提出并形式化“铭文式越狱”(inscriptive jailbreak),通过 Etch 框架将对抗提示分解为语义伪装、视觉空间锚定与排版编码三层,利用零阶语义优化使 T2I 模型在视觉无害图像中渲染有害文本。
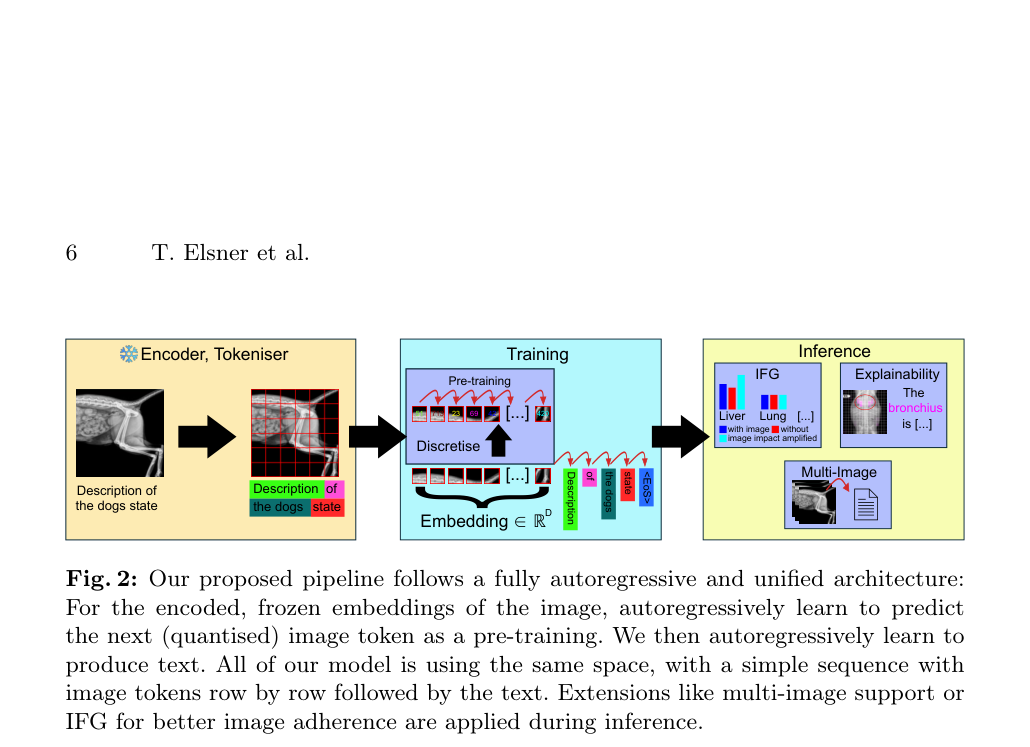
提出V-REX,一种从零训练小型专家VLM的完整方案,通过专家级tokenisation、生成式预训练和图像自由引导(IFG),在兽医放射报告生成任务上以远小于通用基础模型的参数量超越其性能。
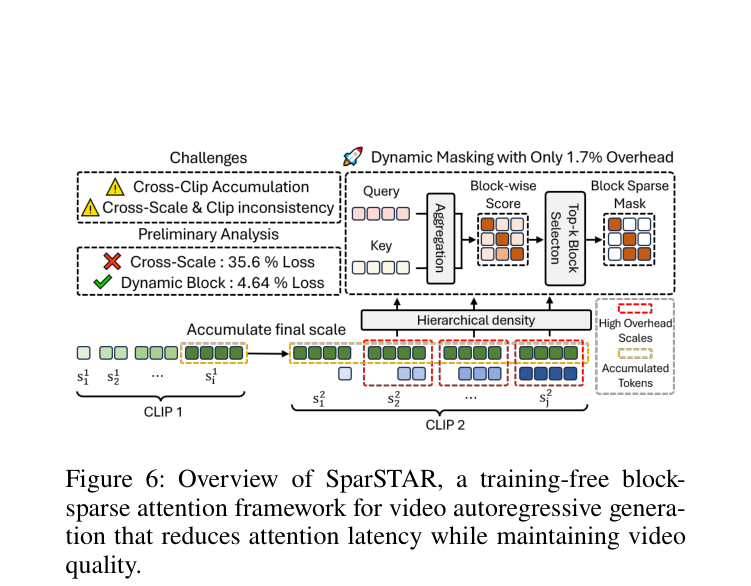
SparSTAR提出一种免训练的块稀疏注意力框架,在每个高成本尺度上动态构建per-head稀疏掩码,为InfinityStar视频自回归生成提供约1.6×端到端加速且保持VBench质量。
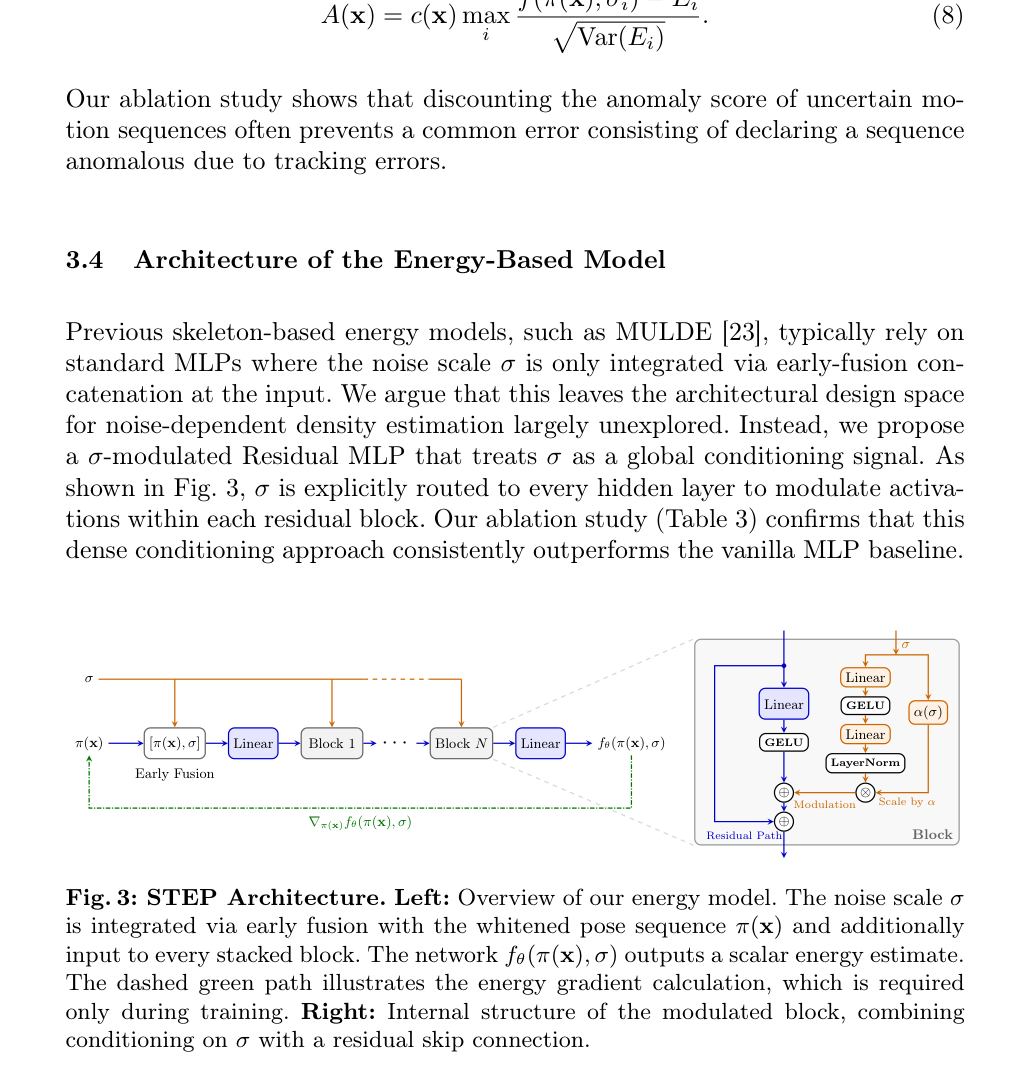
STEP 通过将姿态序列投影到白化 PCA 空间并结合置信度加权,解决了去噪分数匹配在原始关节坐标上的结构坍塌问题,在 UBnormal 上以 90.1% AUROC 刷新骨架 VAD 纪录。
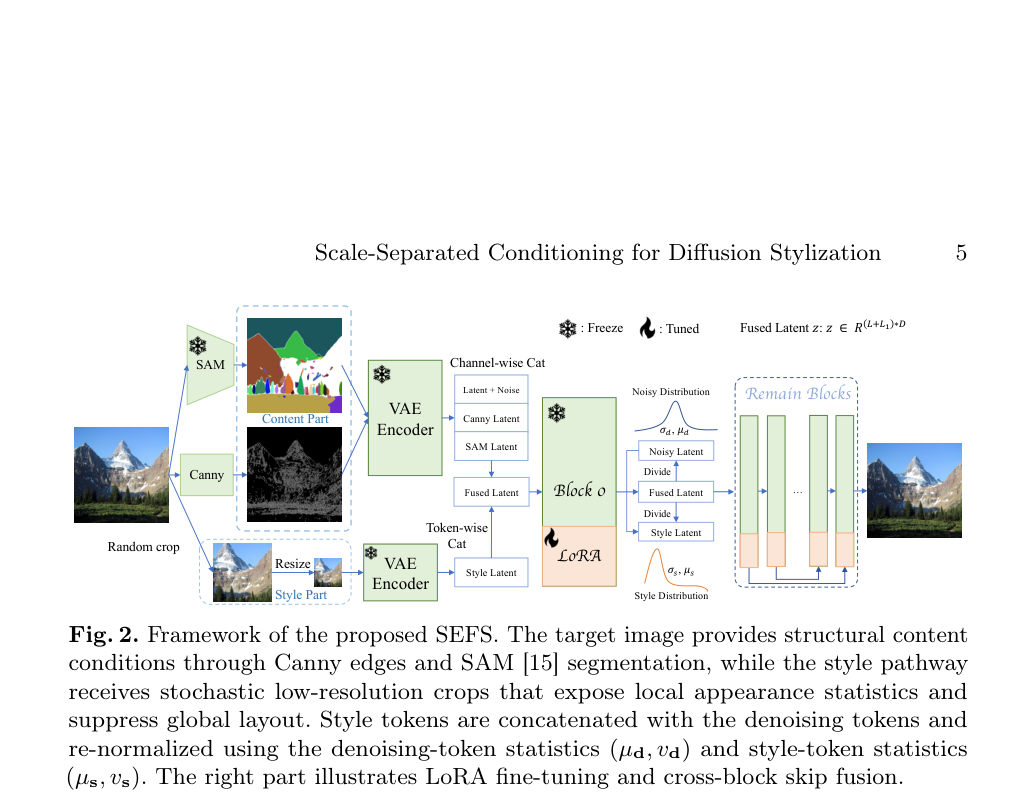
SEFS 提出一种无风格编码器的扩散风格化框架,通过随机低分辨率裁剪构建风格 token,结合目标结构条件、重归一化与跨块跳跃融合,在保持目标几何的同时迁移参考外观。
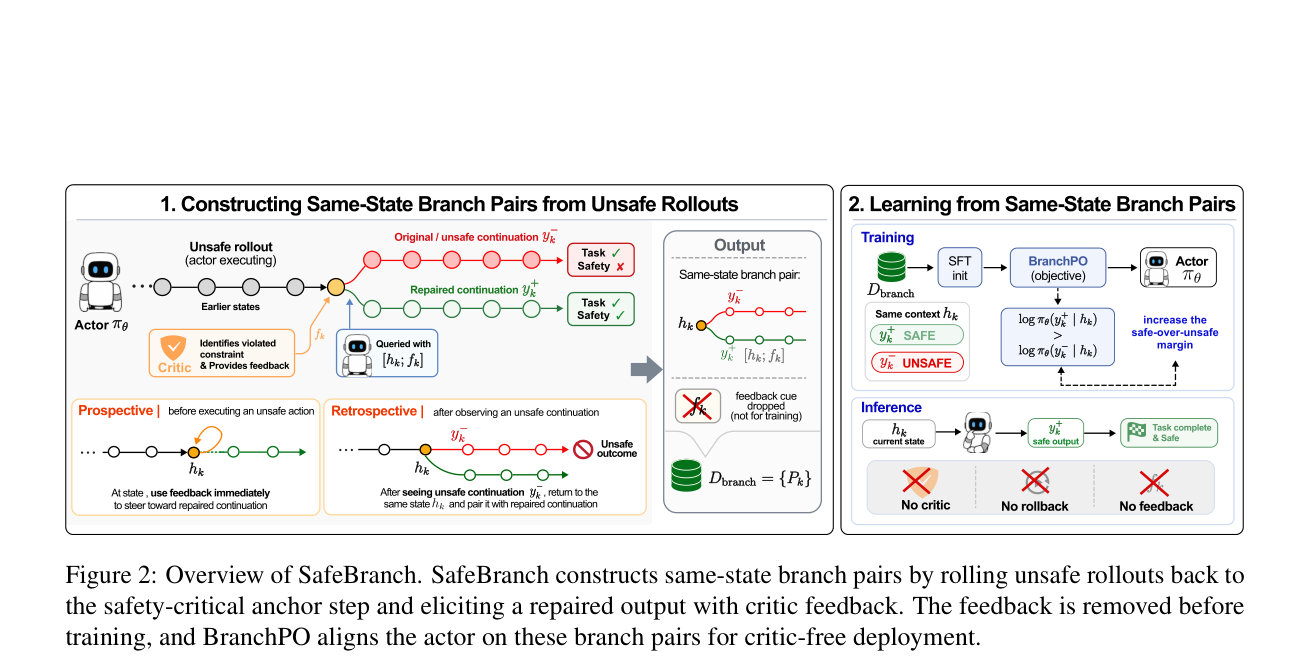
SafeBranch 通过环境回滚从智能体自身的不安全轨迹中构造同状态分支对,并用 BranchPO 将安全信号内化到 VLM 具身规划器中,实现无 critic 部署。
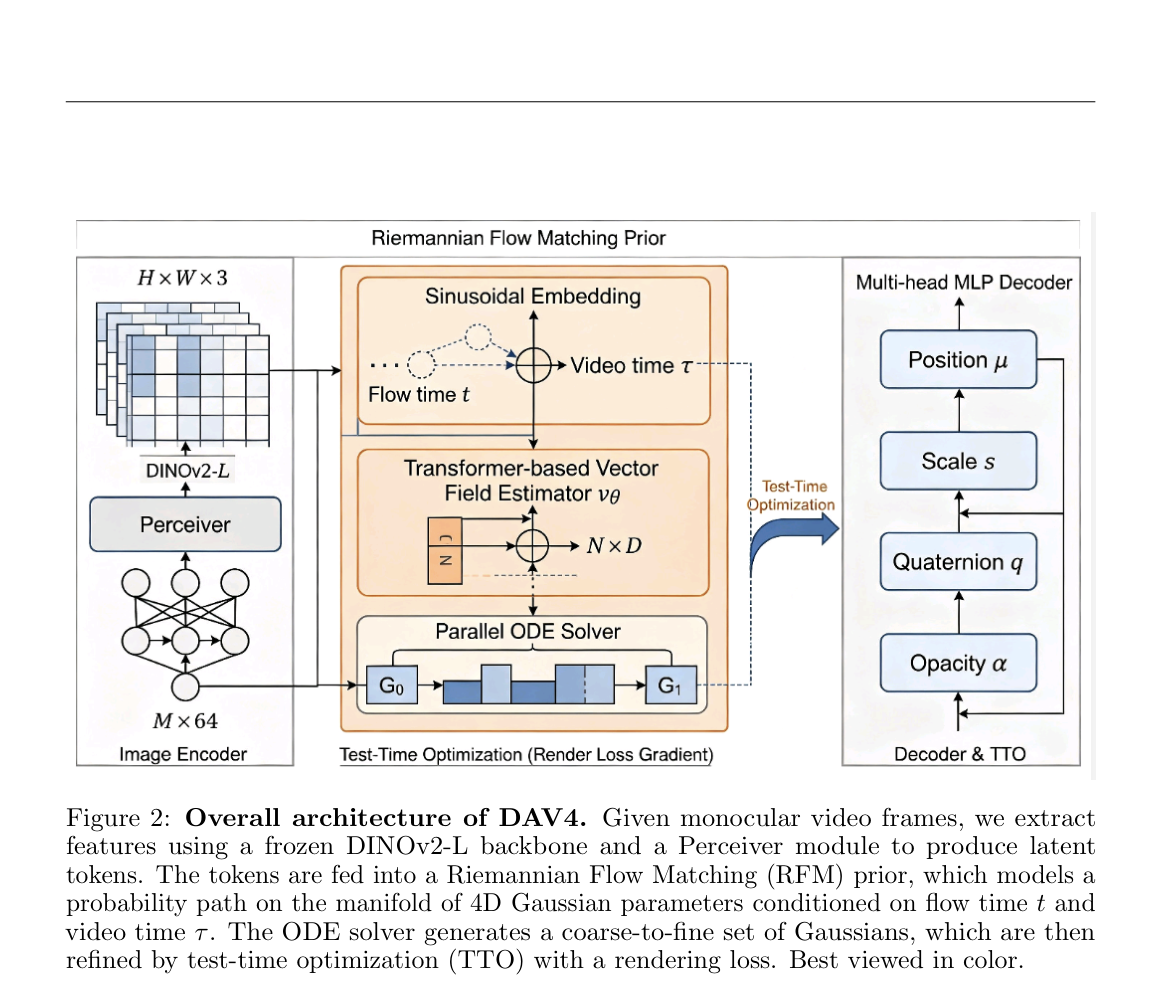
DAV4将Riemannian Flow Matching应用于4D Gaussian Splatting参数的非欧几里得流形,从单目视频实现动态4D场景重建,并通过受控实验隔离出RFM相对确定性MLP基线的+0.044 F-score增益。
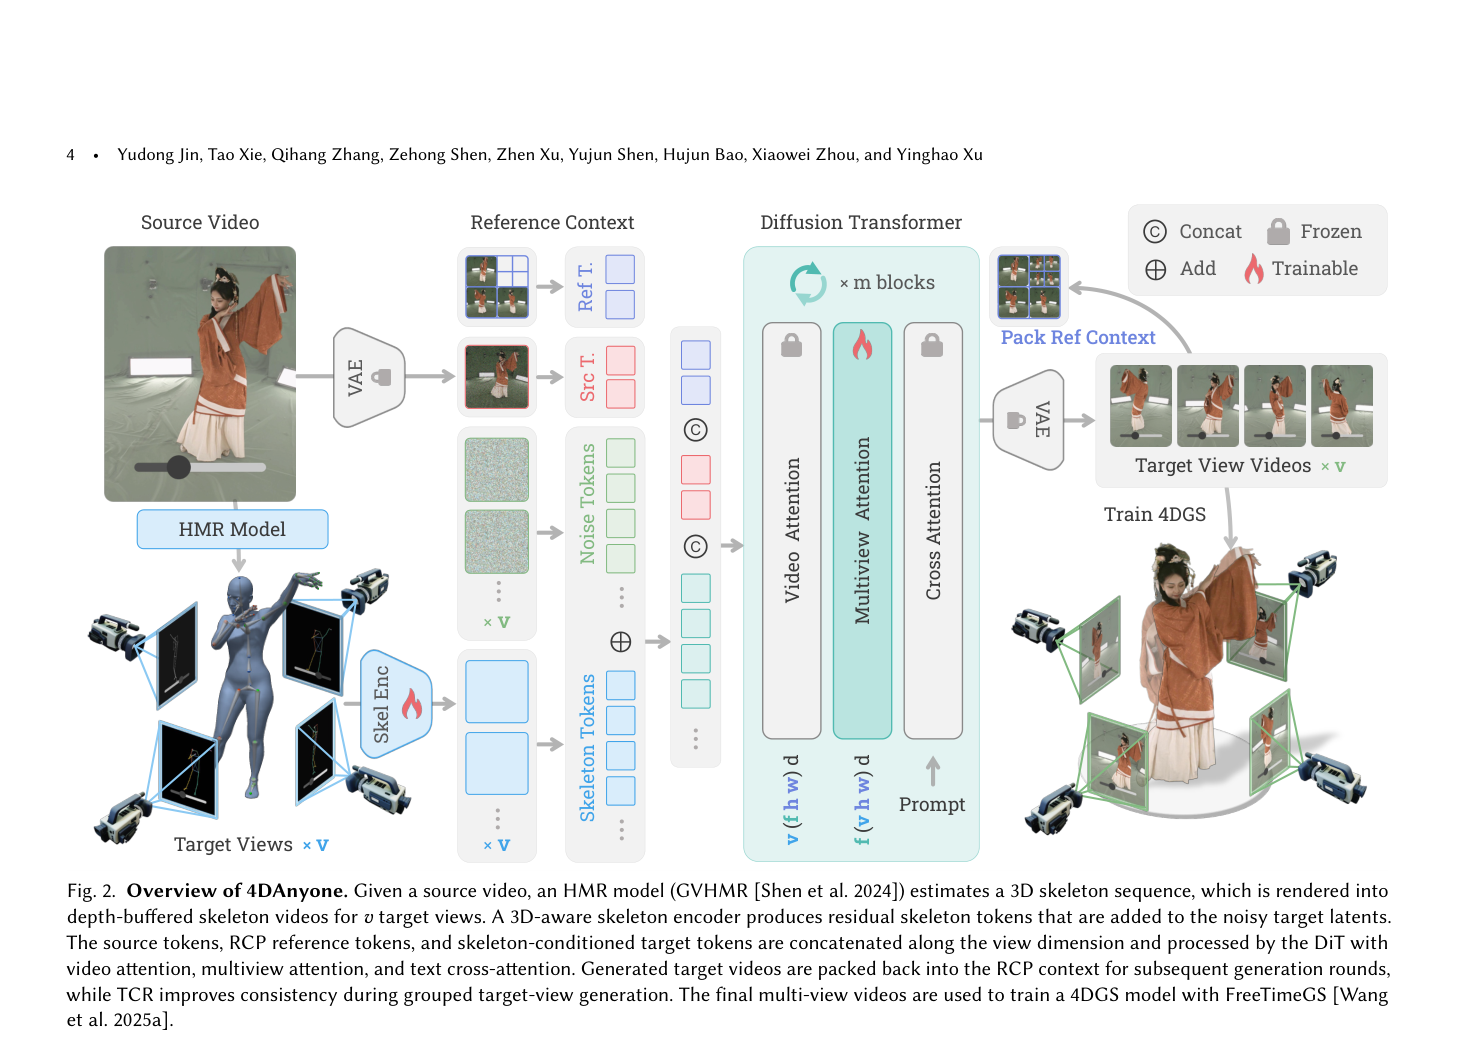
4DAnyone 通过生成重建级多视角一致视频并将其提升为 4D Gaussian Splatting,从无标定单目视频重建可自由视角渲染的 4D 人物。
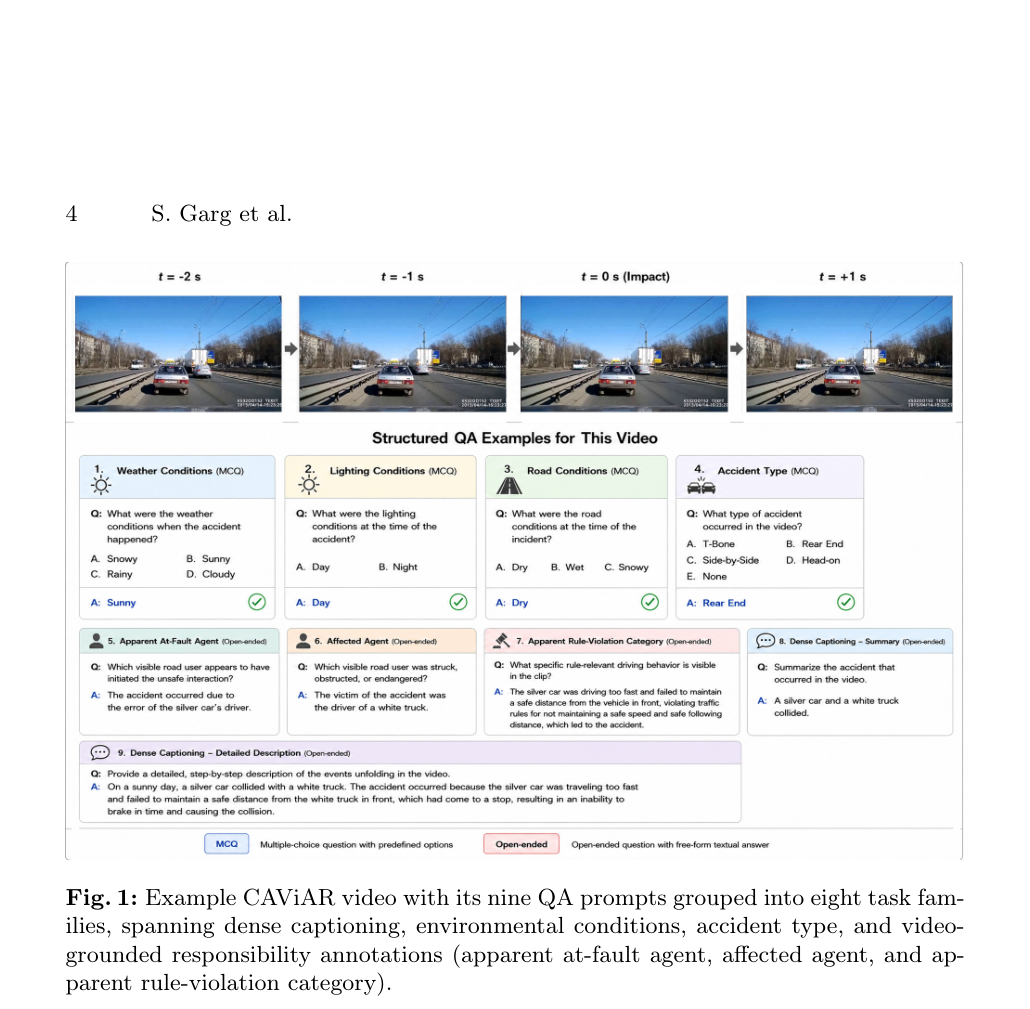
CAViAR 是一个基于 CCD 和 Nexar 的 2,249 段真实行车记录仪事故视频基准,提供事故责任归因与交通规则违反的结构化标注,用于揭示 VLM 的感知-推理差距。