FreqDINO++:面向通用超声分析的频率引导多任务路由视觉基础模型
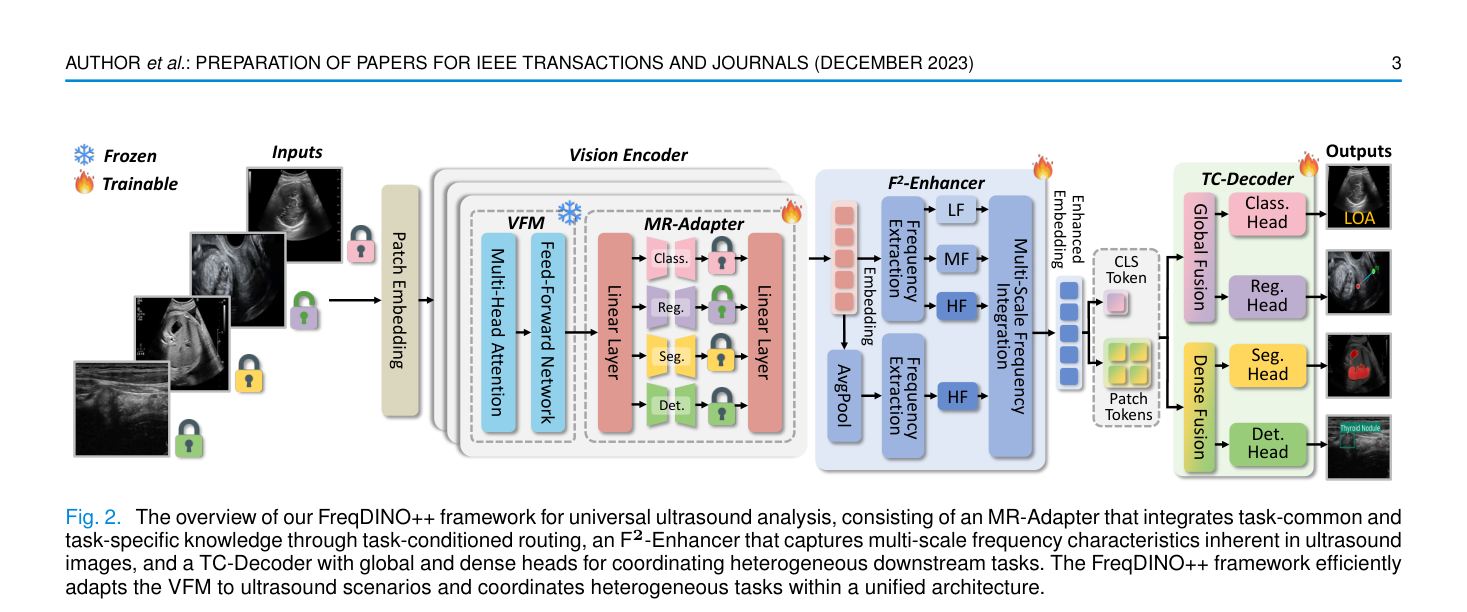
FreqDINO++ 在冻结 DINOv3 上用 MR-Adapter、F2-Enhancer 与 TC-Decoder 把分割、分类、检测和回归收进同一套超声框架。
跨架构地基模型蒸馏:把洪水分割压进边缘设备
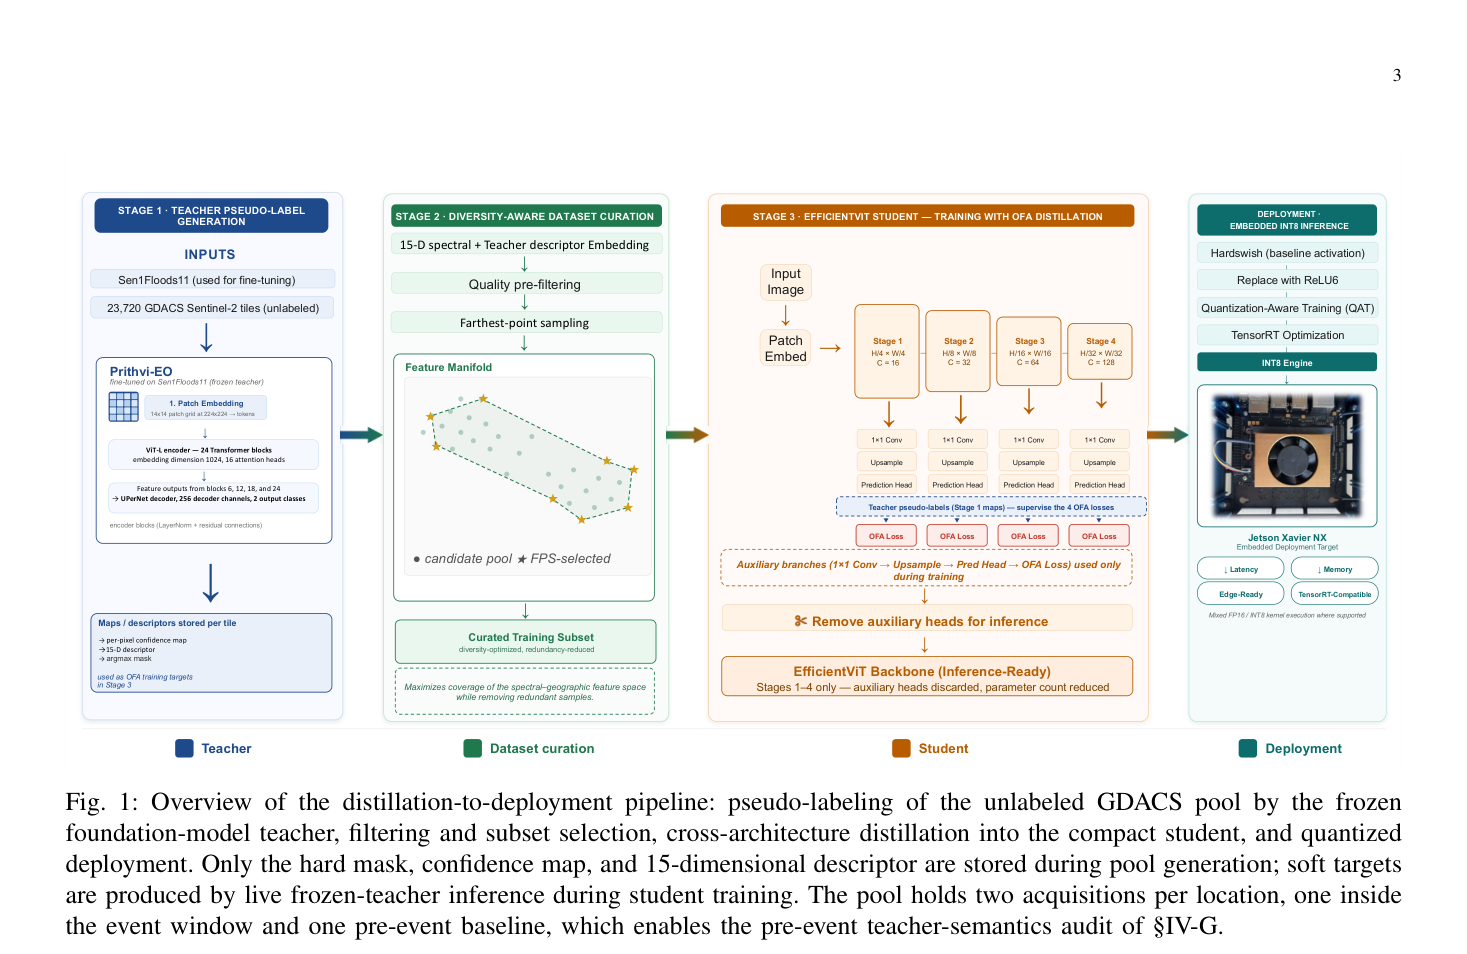
把微调后的 Prithvi-EO-2.0(300M)冻成任务老师,给未标注 Sentinel-2 写监督并蒸馏进 EfficientViT-B0(0.7M);N=2500 时学生水 IoU 0.787 对老师 0.822,INT8 引擎在 Jetson Xavier NX 上 5.57 ms/512²。
PointEvent:用序列化运动证据积累做事件微小无人机检测
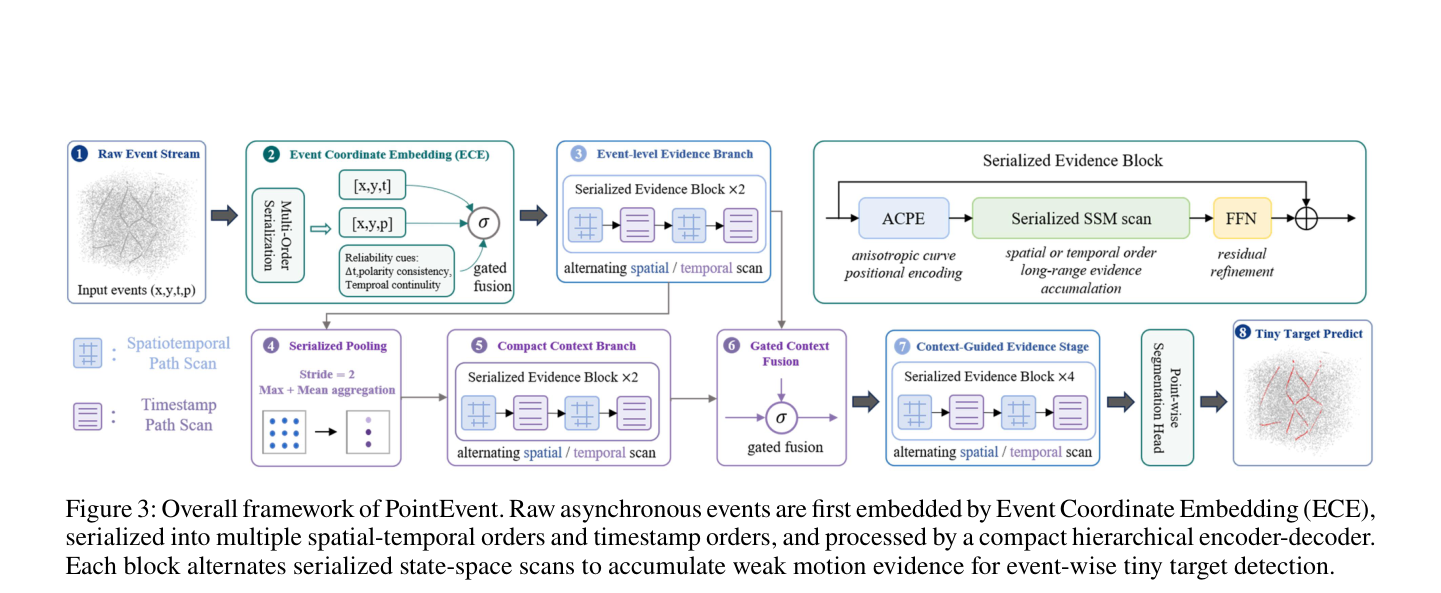
PointEvent 把稀疏事件排成保局部的时空序和保时序的时间戳序,用轻量状态空间扫描沿互补路径积累弱运动证据,在 EV-UAV / ES-UAV 上以极少参数达到作者报告的最高精度与最快推理。
PROVIA:第一人称视频里按工序状态做在线错误检测
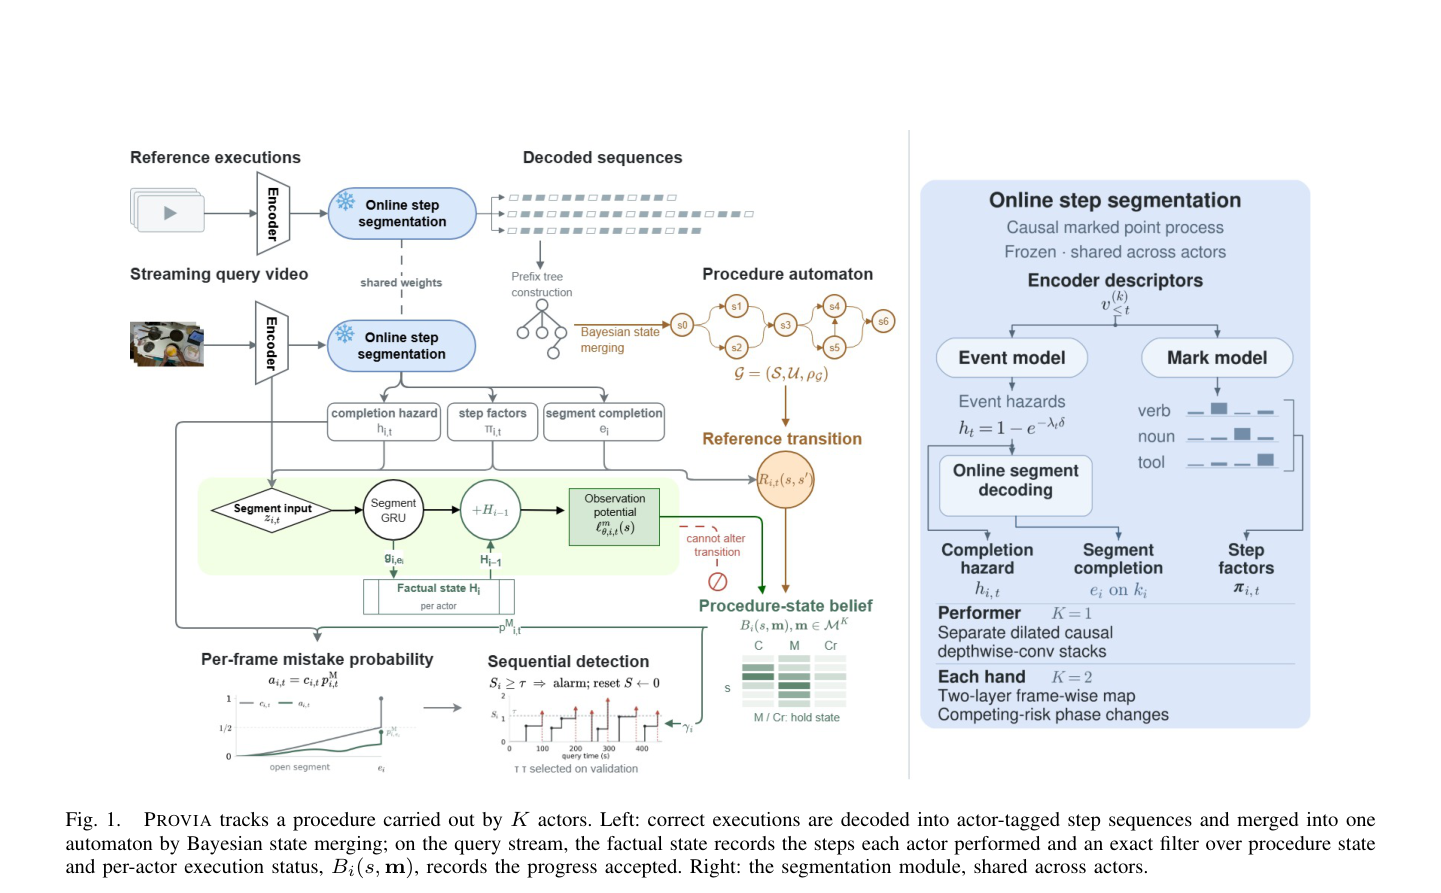
PROVIA 把各 actor 实际做过的步骤与自动机上被接受的进度分开,只在正确状态分支推进工序,并用 Shiryaev–Roberts 在验证集误报预算下把逐步错误概率变成报警。
WeVisDoc:从覆盖到能力的端到端文档解析数据配方
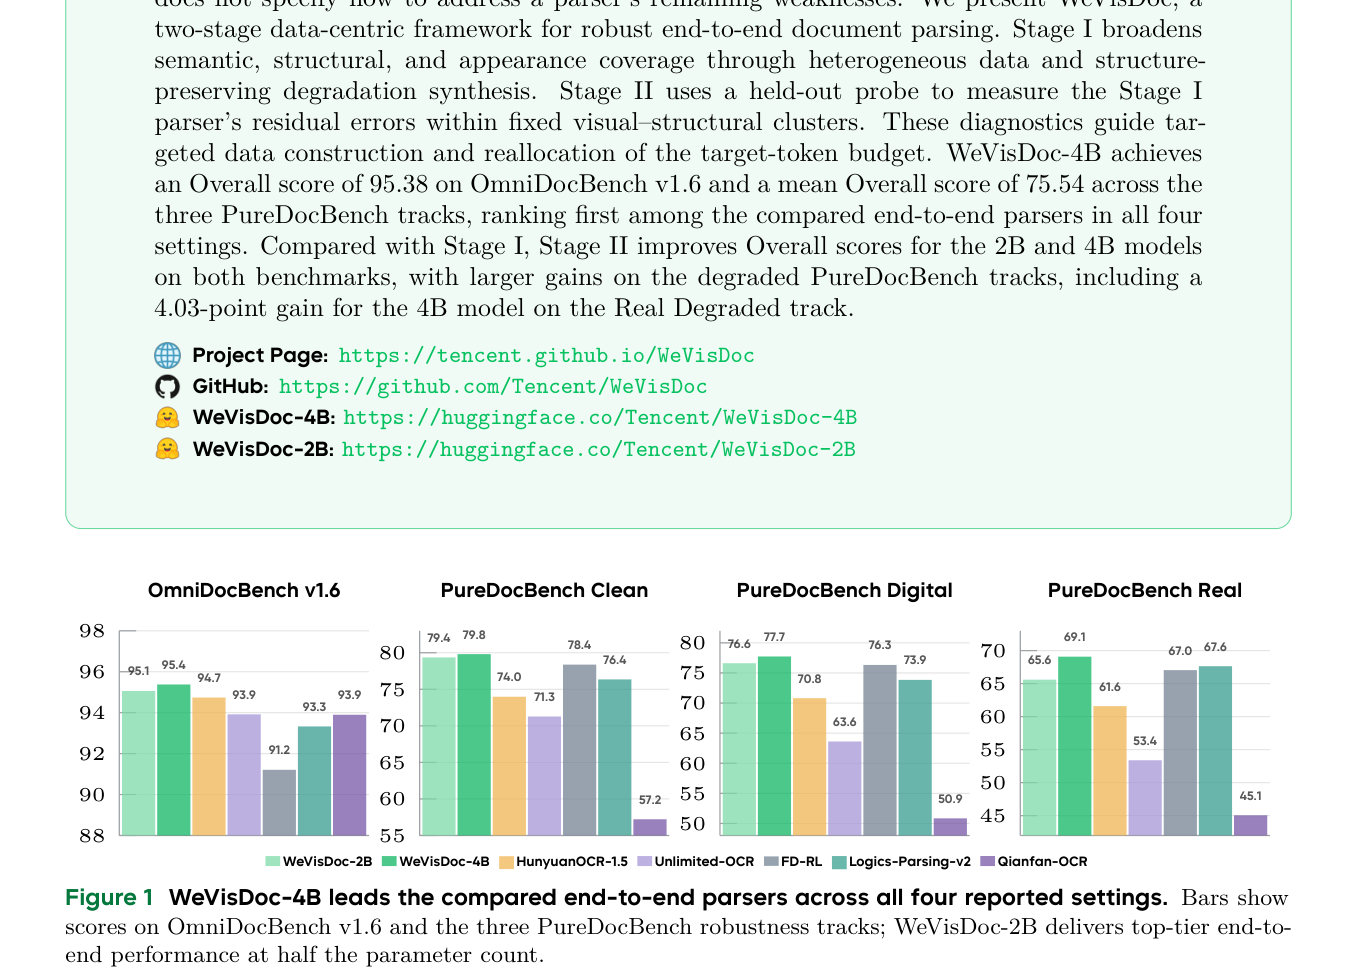
微信视觉提出两阶段数据中心配方 WeVisDoc:先铺语义结构外观覆盖,再用留出探测诊断剩余错误并按固定目标 token 预算重分配;作者报告 WeVisDoc-4B 在 OmniDocBench v1.6 Overall 95.38、PureDocBench Avg3 75.54。
RefineEdit:在生成式精炼网络上做免训练的提示到提示图像编辑
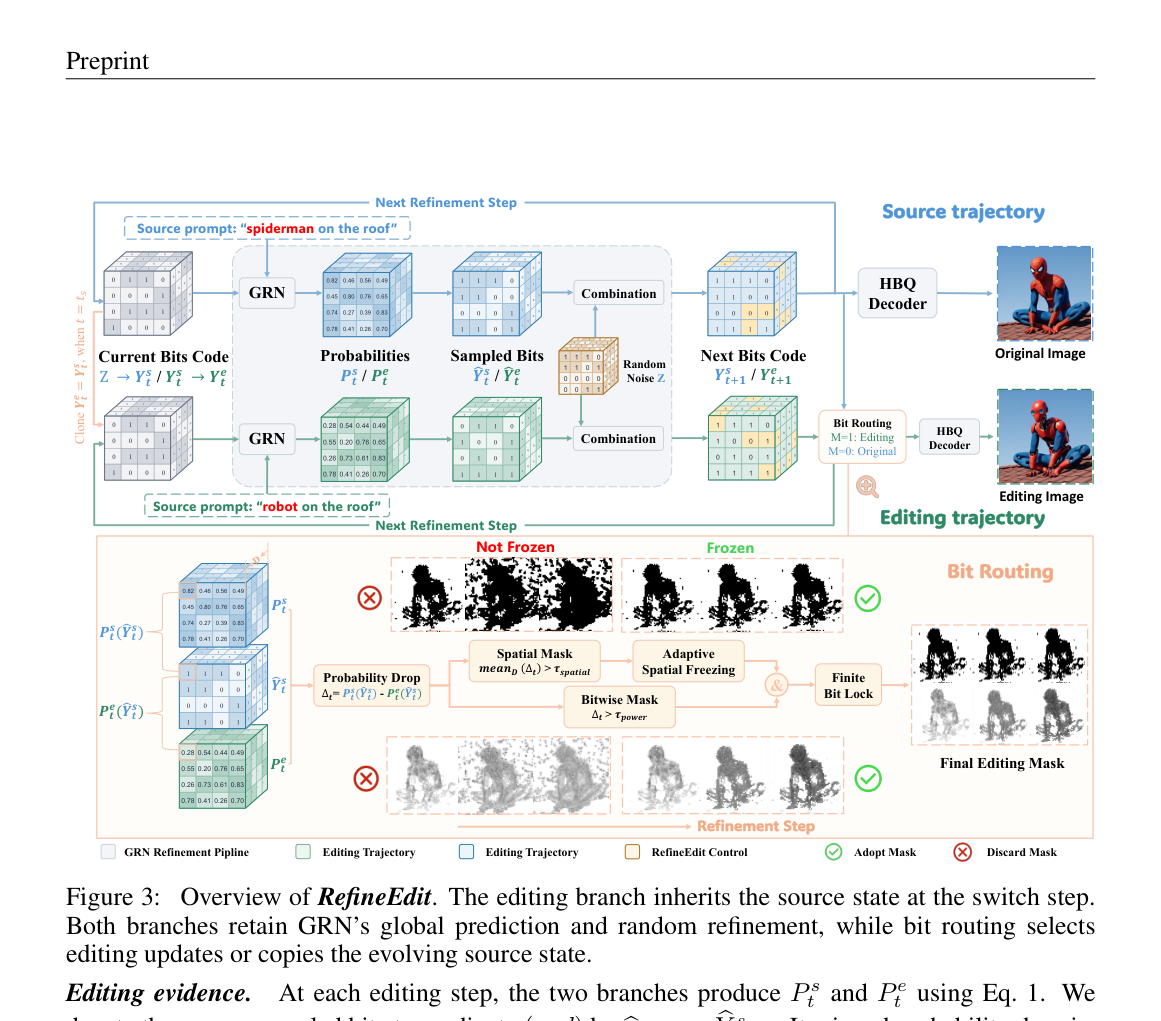
RefineEdit 把生成式精炼网络的全局二值码更新改造成免训练编辑:用源支与编辑支的比特概率差选择可改坐标,并在精炼过程中同步修正定位。
CleanVideo:用三模态门控子空间干预做视频概念擦除
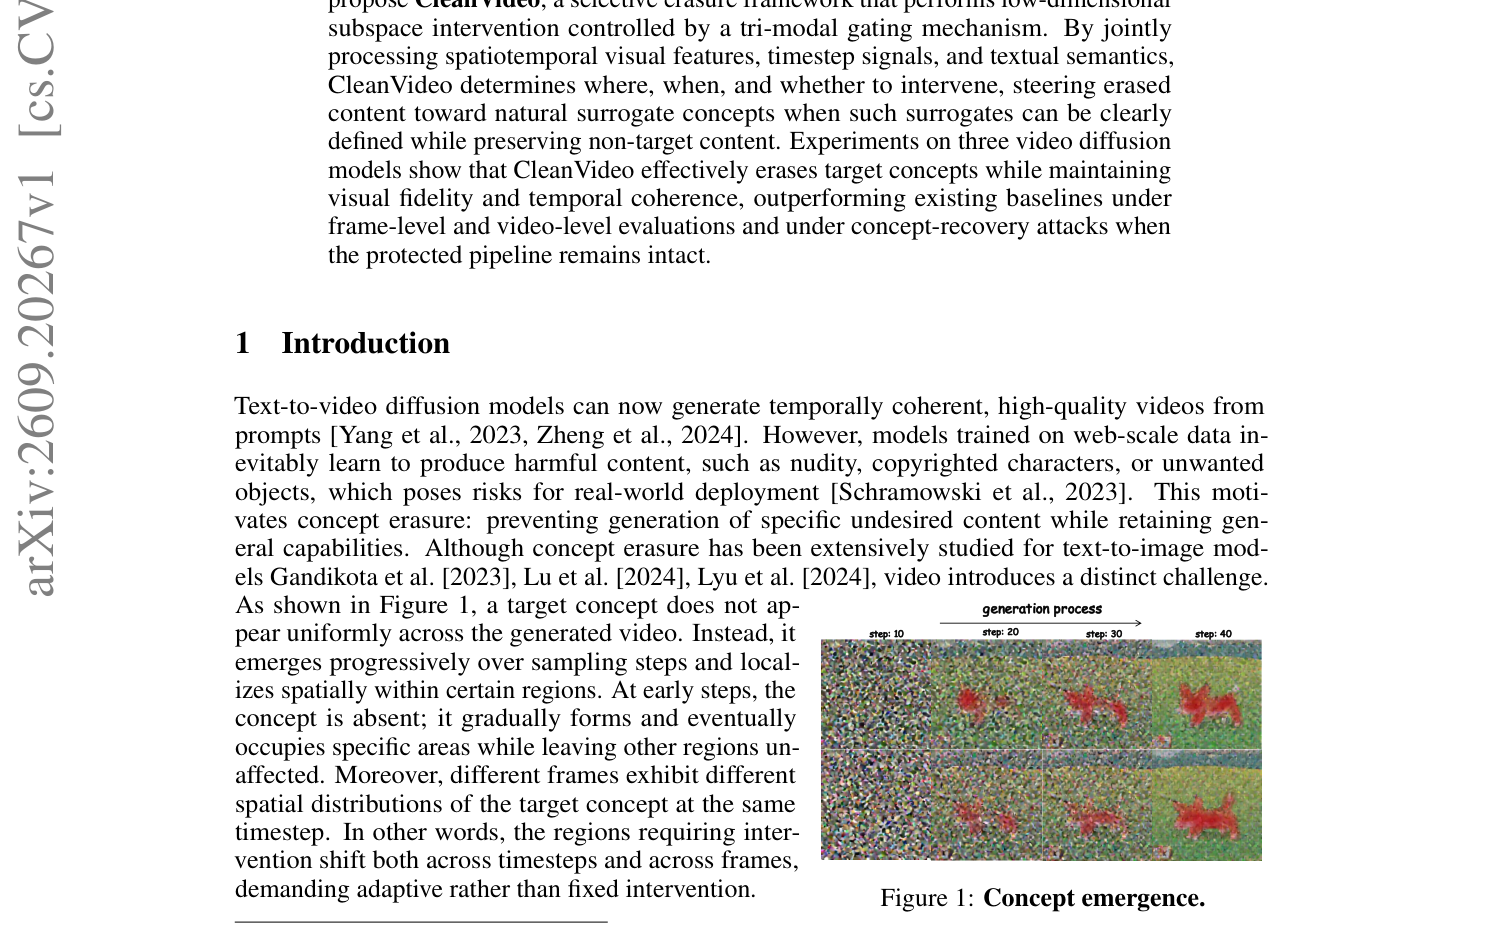
CleanVideo 在冻结的文本生成视频扩散模型里插入低维子空间干预,并用视觉、时间步、文本三路门控决定何时何地擦除目标概念、将其推向替代语义。
PART:用统一Transformer做三维零件检索与六自由度装配
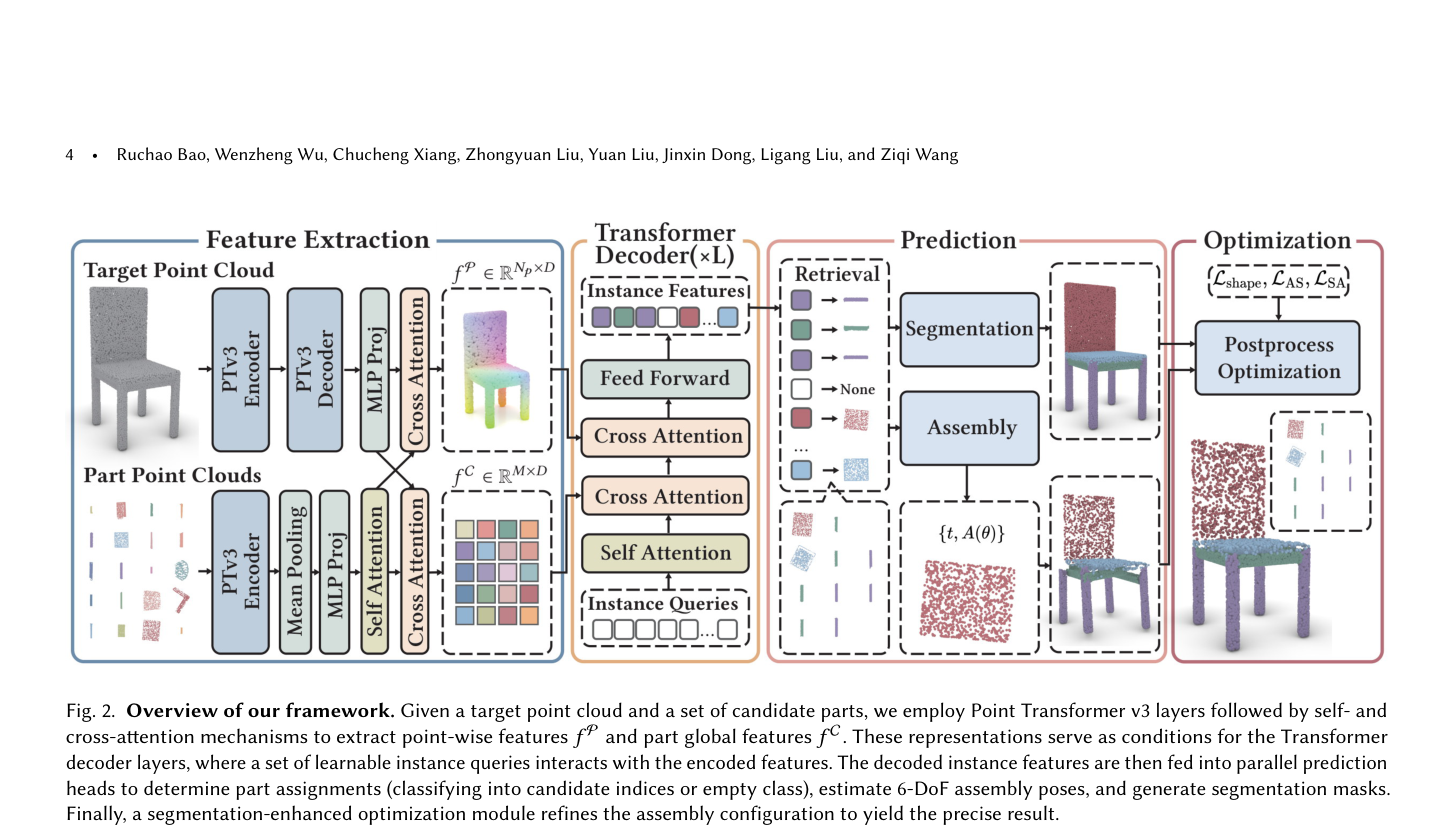
PART 把三维零件检索与装配写成集合预测,用查询式 Transformer 同时选出零件、估计六自由度位姿并分割目标,再以分割增强优化 refinement 装配。