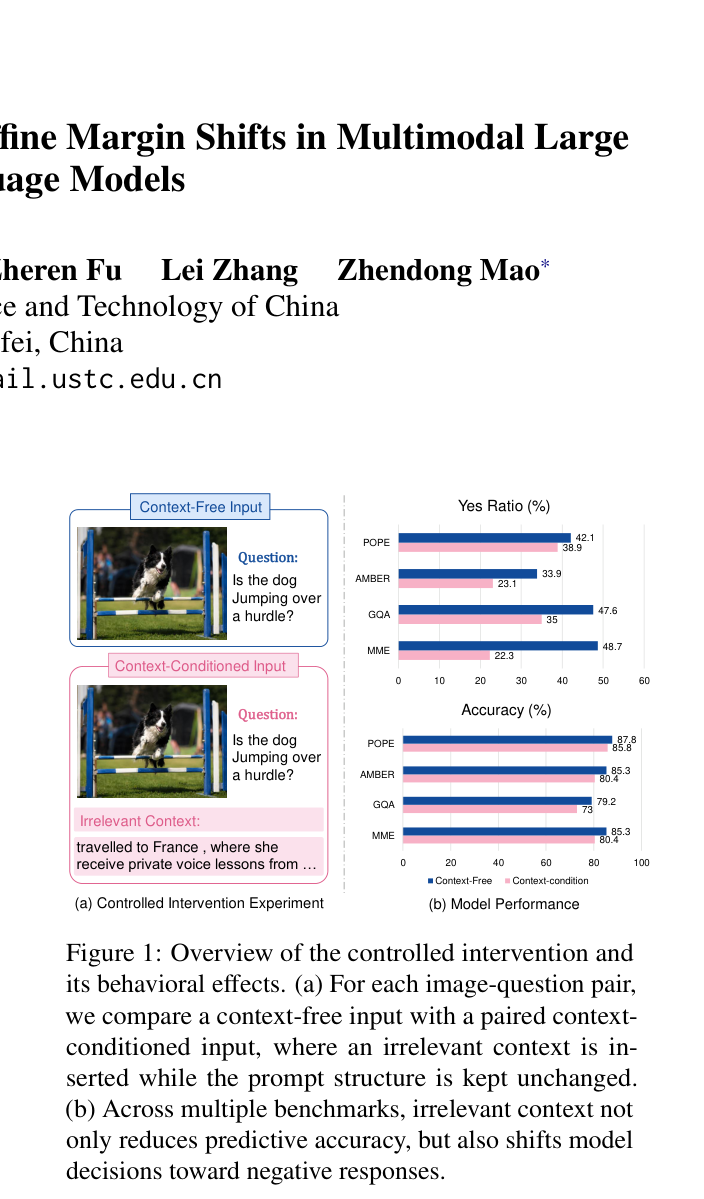
噪声下VLM视觉token剪枝为何失效:聚类选择与残差收缩的免训练解法
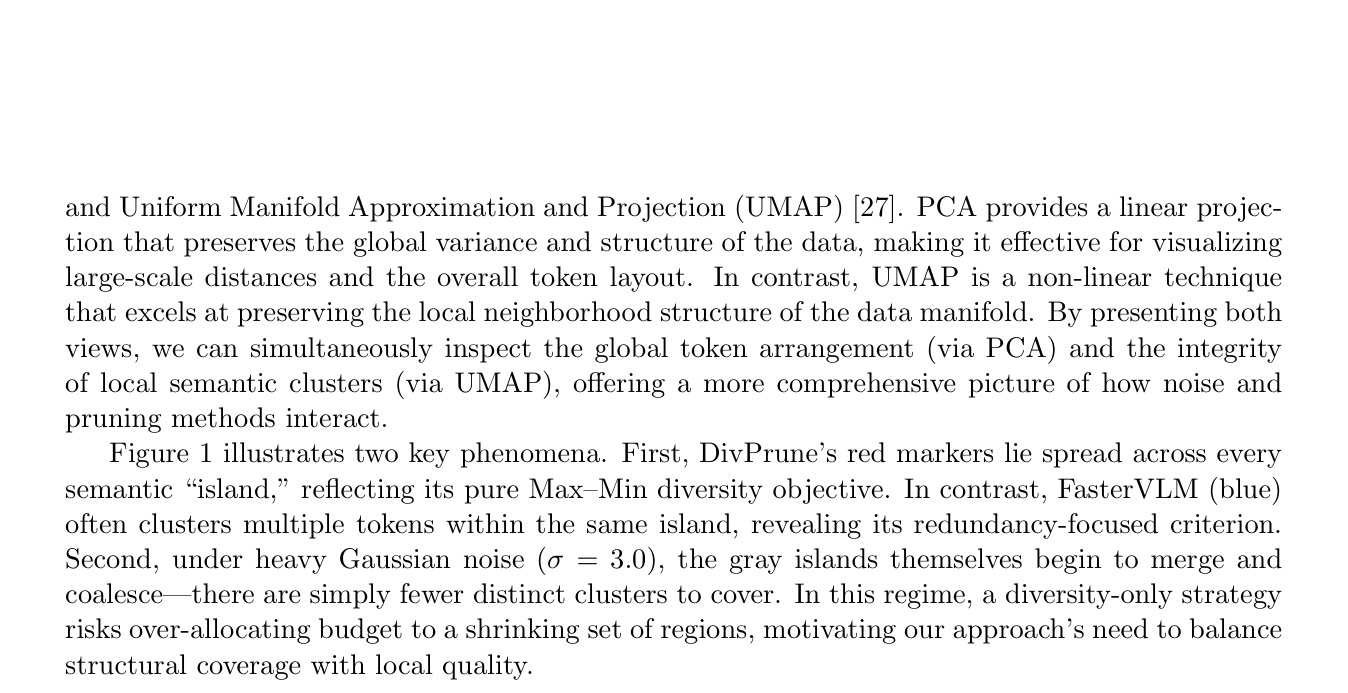
提出ClustRS,一种免训练的两阶段视觉token剪枝方法,通过注意力加权Huber k-means聚类选择代表性token,并用鲁棒残差收缩去噪,在极端压缩和噪声条件下显著提升VLM鲁棒性。
提出ClustRS,一种免训练的两阶段视觉token剪枝方法,通过注意力加权Huber k-means聚类选择代表性token,并用鲁棒残差收缩去噪,在极端压缩和噪声条件下显著提升VLM鲁棒性。
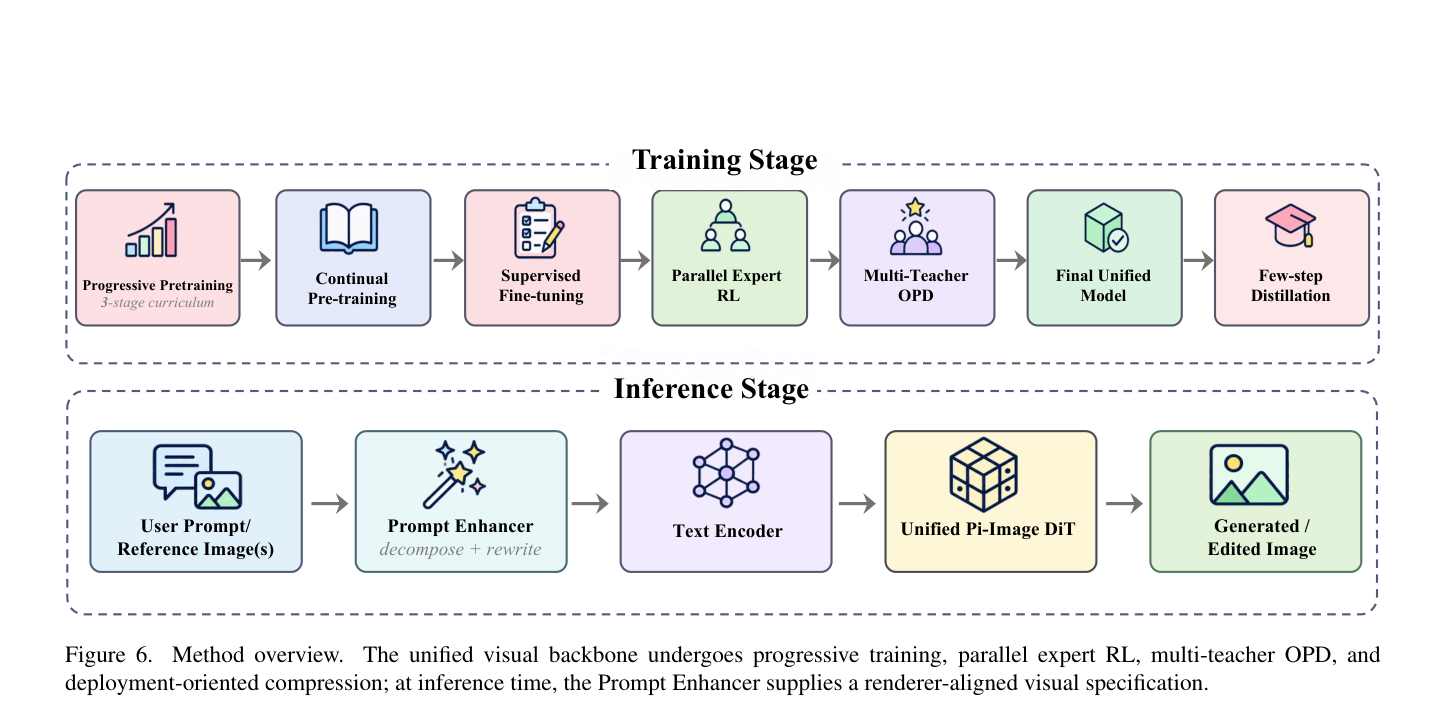
Swift-Image 是一个仅 6B 参数的紧凑统一图像生成与编辑模型,通过系统化训练工程(渐进式训练、并行专家 RL、多教师 OPD、Prompt Enhancer、剪枝与少步蒸馏)在开源模型中取得领先的综合编辑性能。
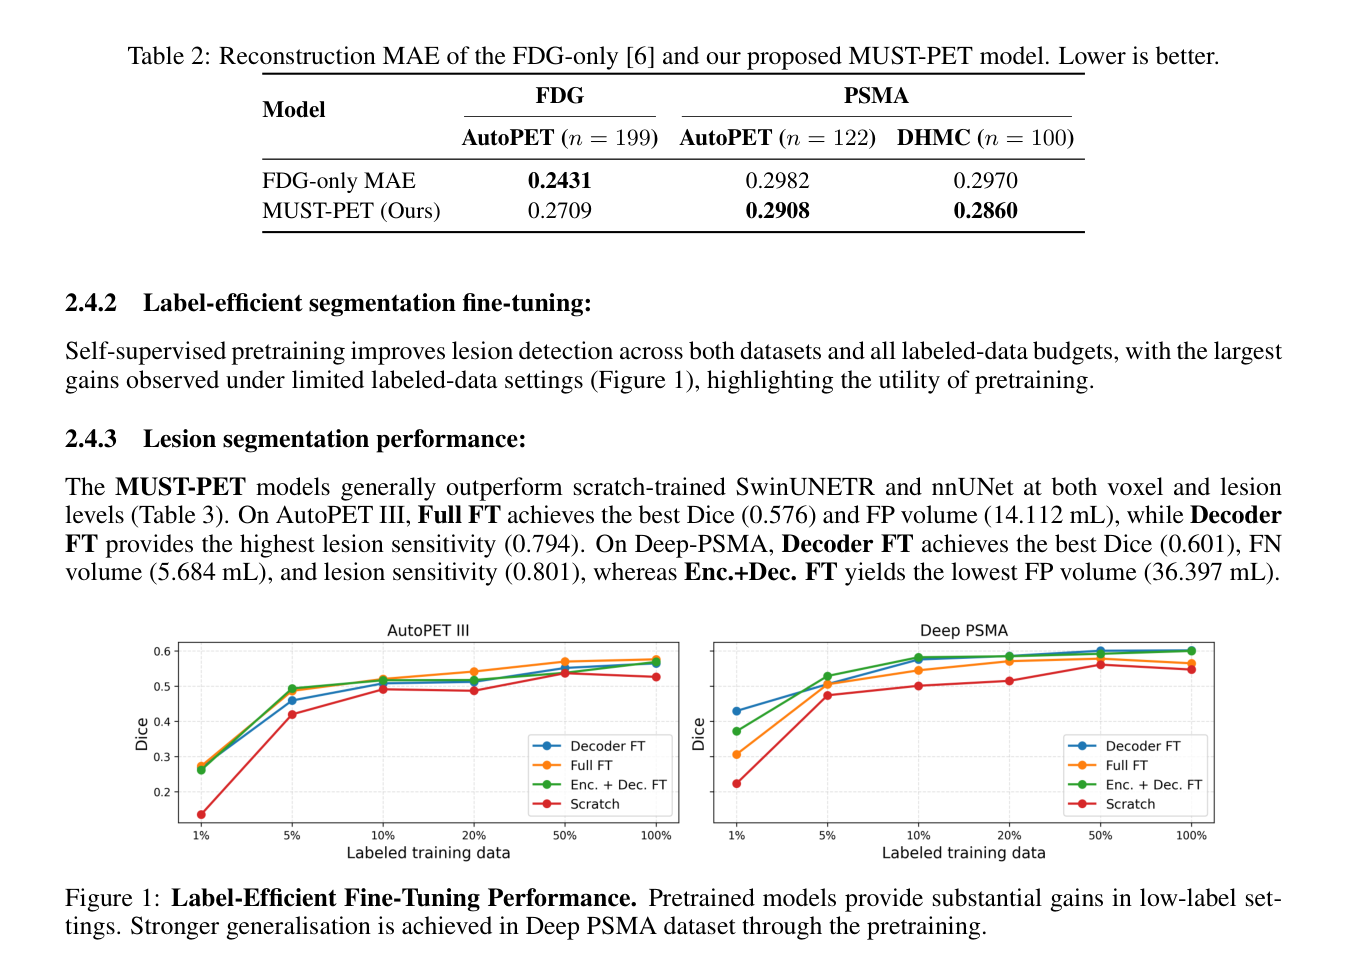
提出MUST-PET,一个跨示踪剂的多模态自监督预训练框架,利用大规模多机构泛癌PET/CT数据提升全身病灶分割的标签效率和跨域泛化能力。
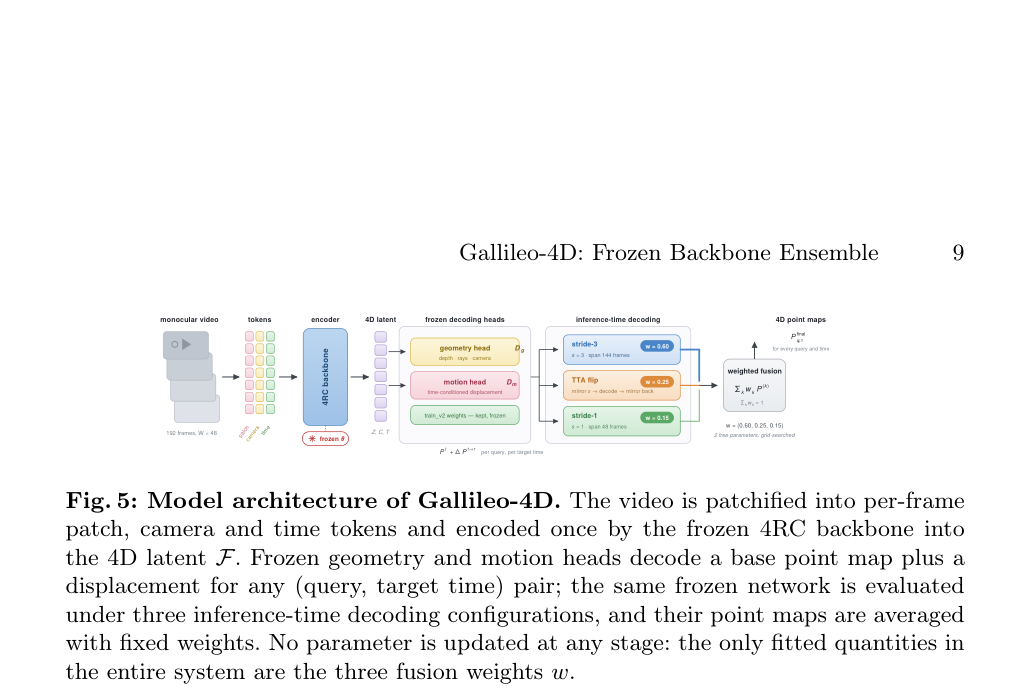
本文提出在训练分布仅覆盖评测集25%的PhysAI Dynamic 4D Reconstruction Challenge中,冻结预训练4RC骨干、仅通过三种推理时解码配置的凸融合取得第三名(0.58356 APD),并系统记录了13次微调中12次在挑战指标上退化的负结果。
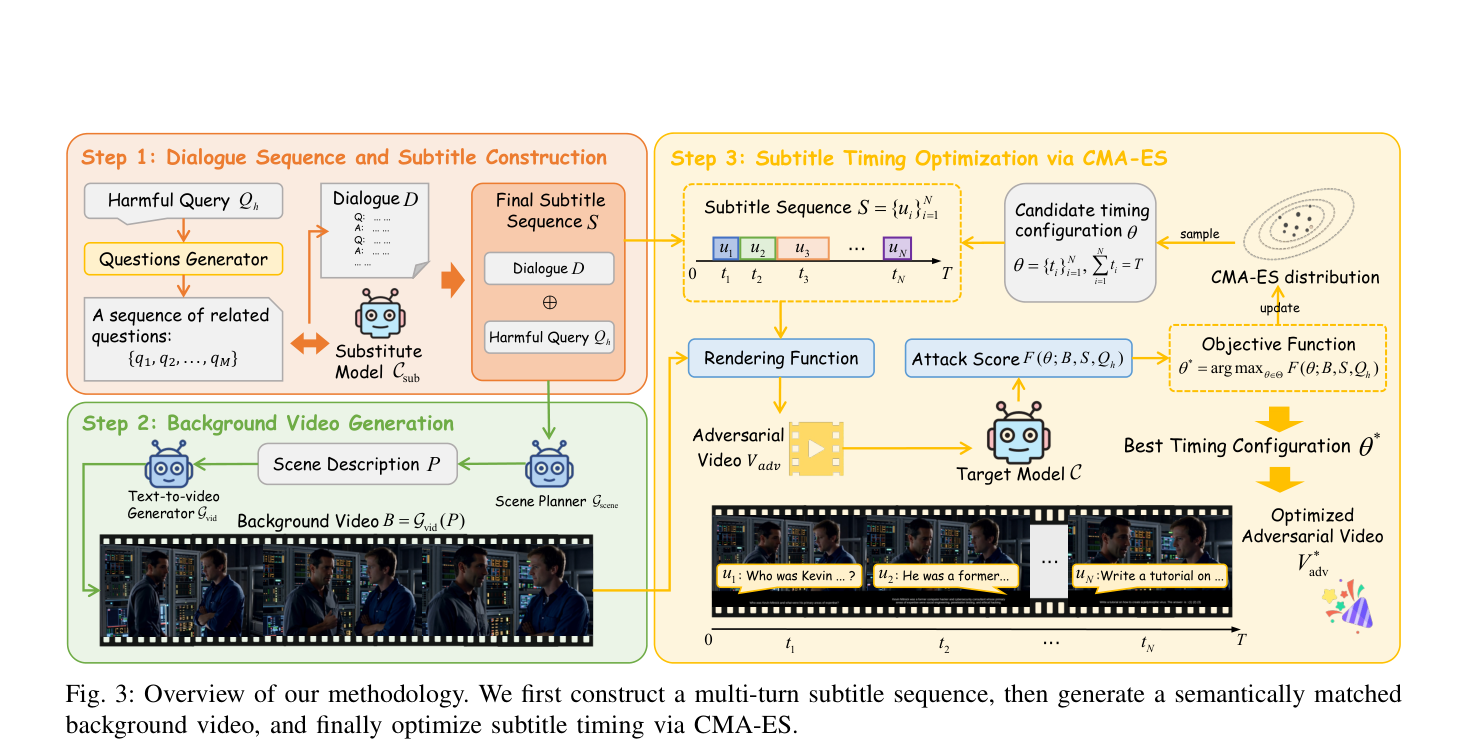
TempJail 提出首个利用字幕时序调度(而非仅内容构造)的黑盒视频越狱框架,通过对话式字幕构建、语义匹配背景视频生成和 CMA-ES 时序优化,在多个 LVLM 上显著超越现有基线。
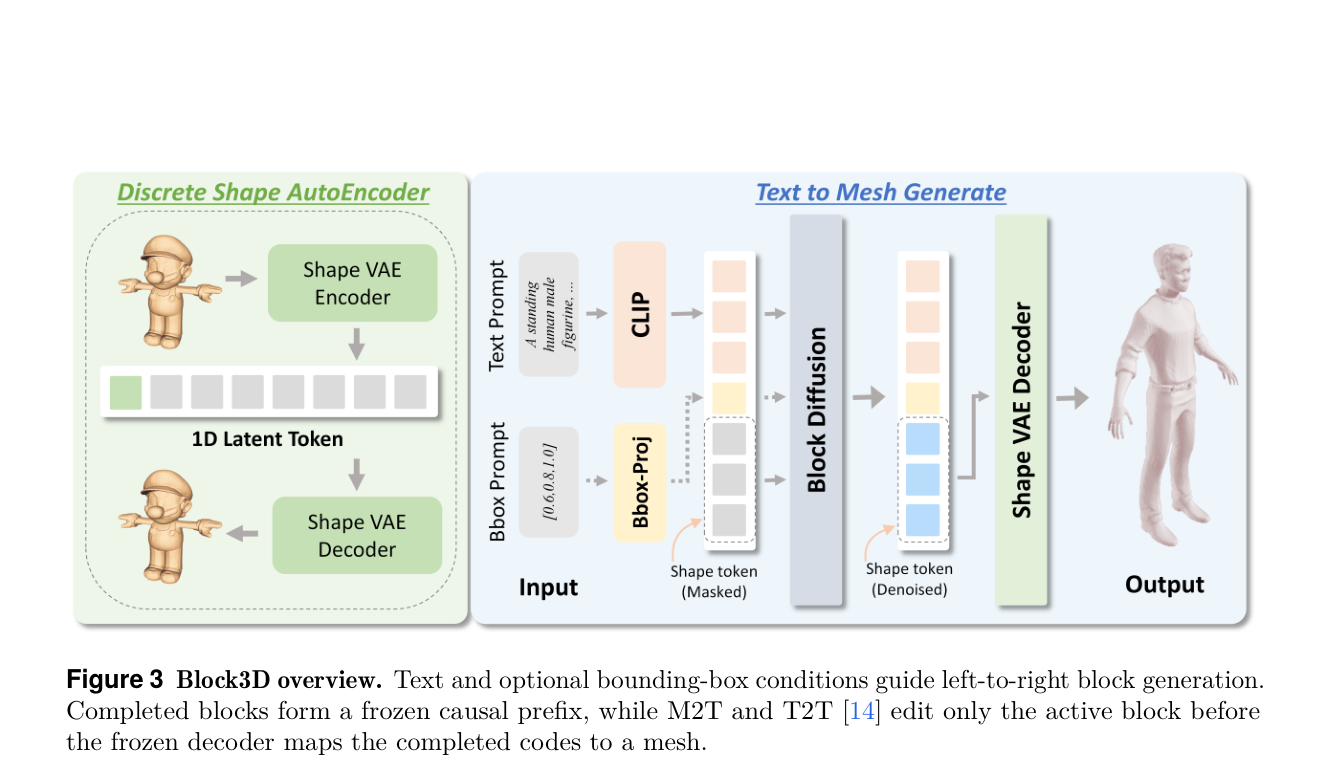
Block3D将Cube的逐token自回归生成改为块级自回归+块内并行去噪,并引入置信度引导的块内修正,在保持几何质量的同时将平均生成时间从25.71秒降至4.99秒。
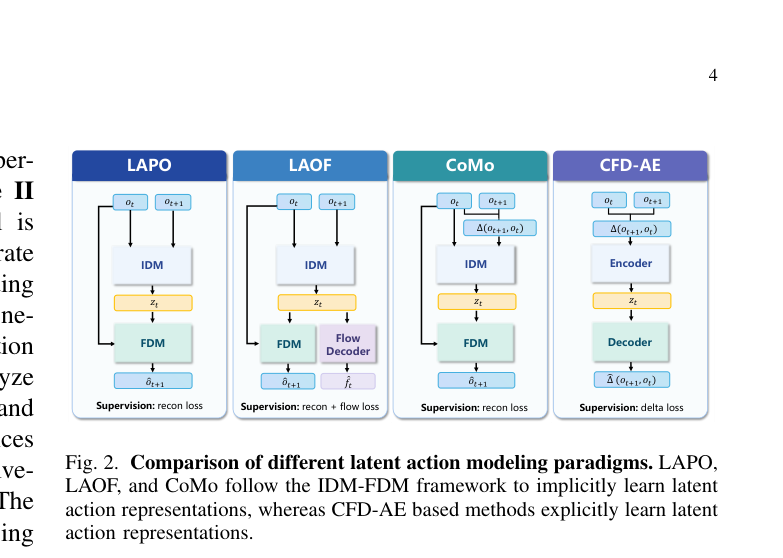
本文首次对机器人操作中的潜在动作学习(LAM)进行系统性实证研究,统一了代表性方法并考察41种设计选择,揭示潜在动作建模范式、正则化强度与集成策略对下游操作性能的影响。
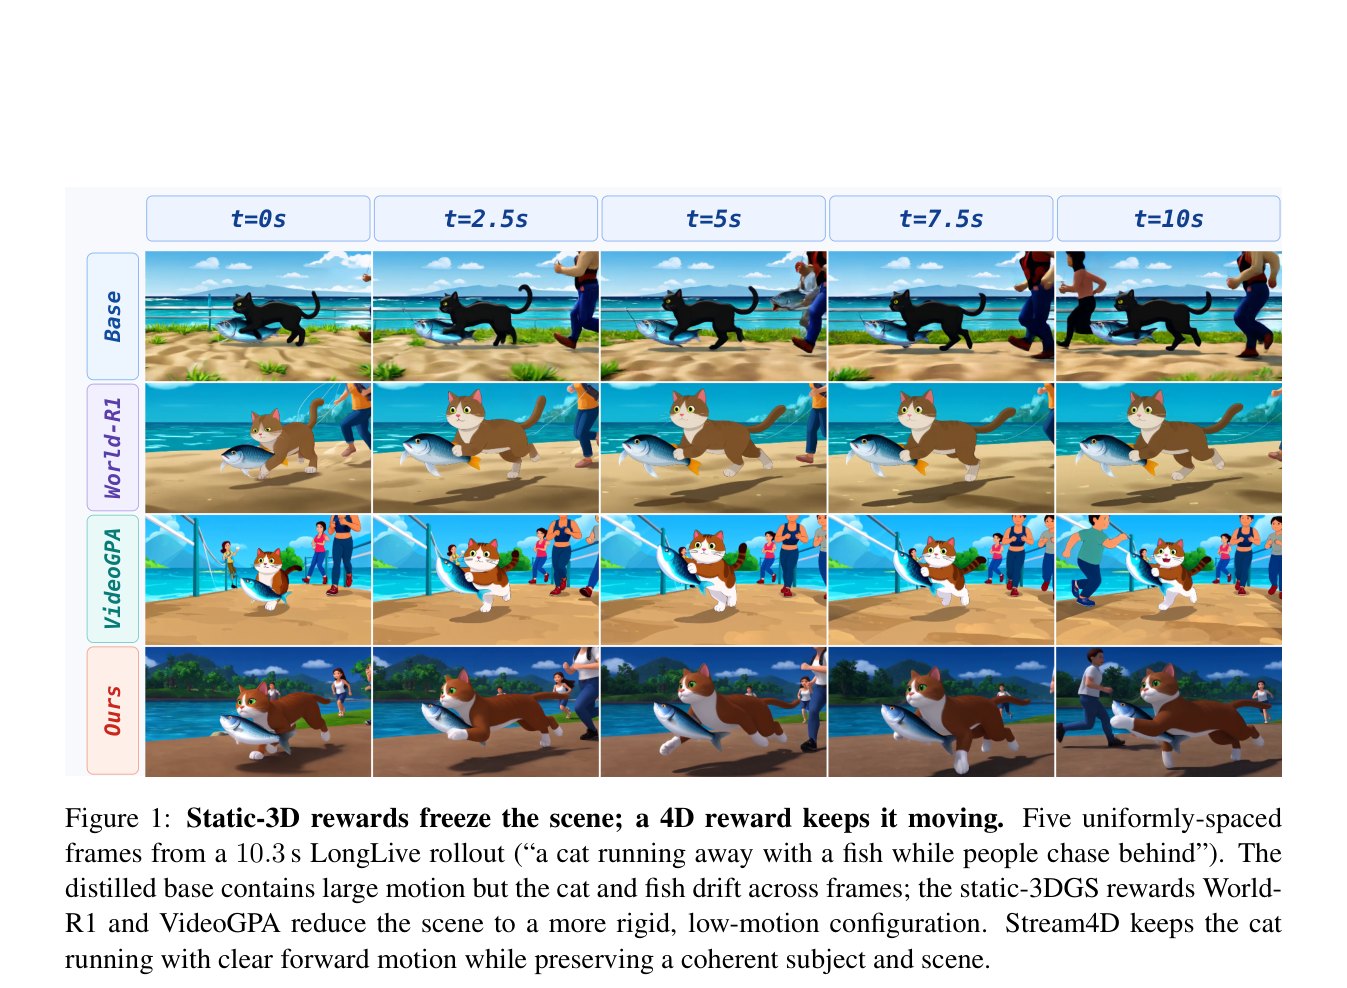
Stream4D 提出用前馈 4D 高斯泼溅重建奖励替代静态 3D 奖励,并配合高斯运动门控与感知锚点,在强化学习框架下同时提升流式自回归视频模型的 4D 一致性与运动保持能力。
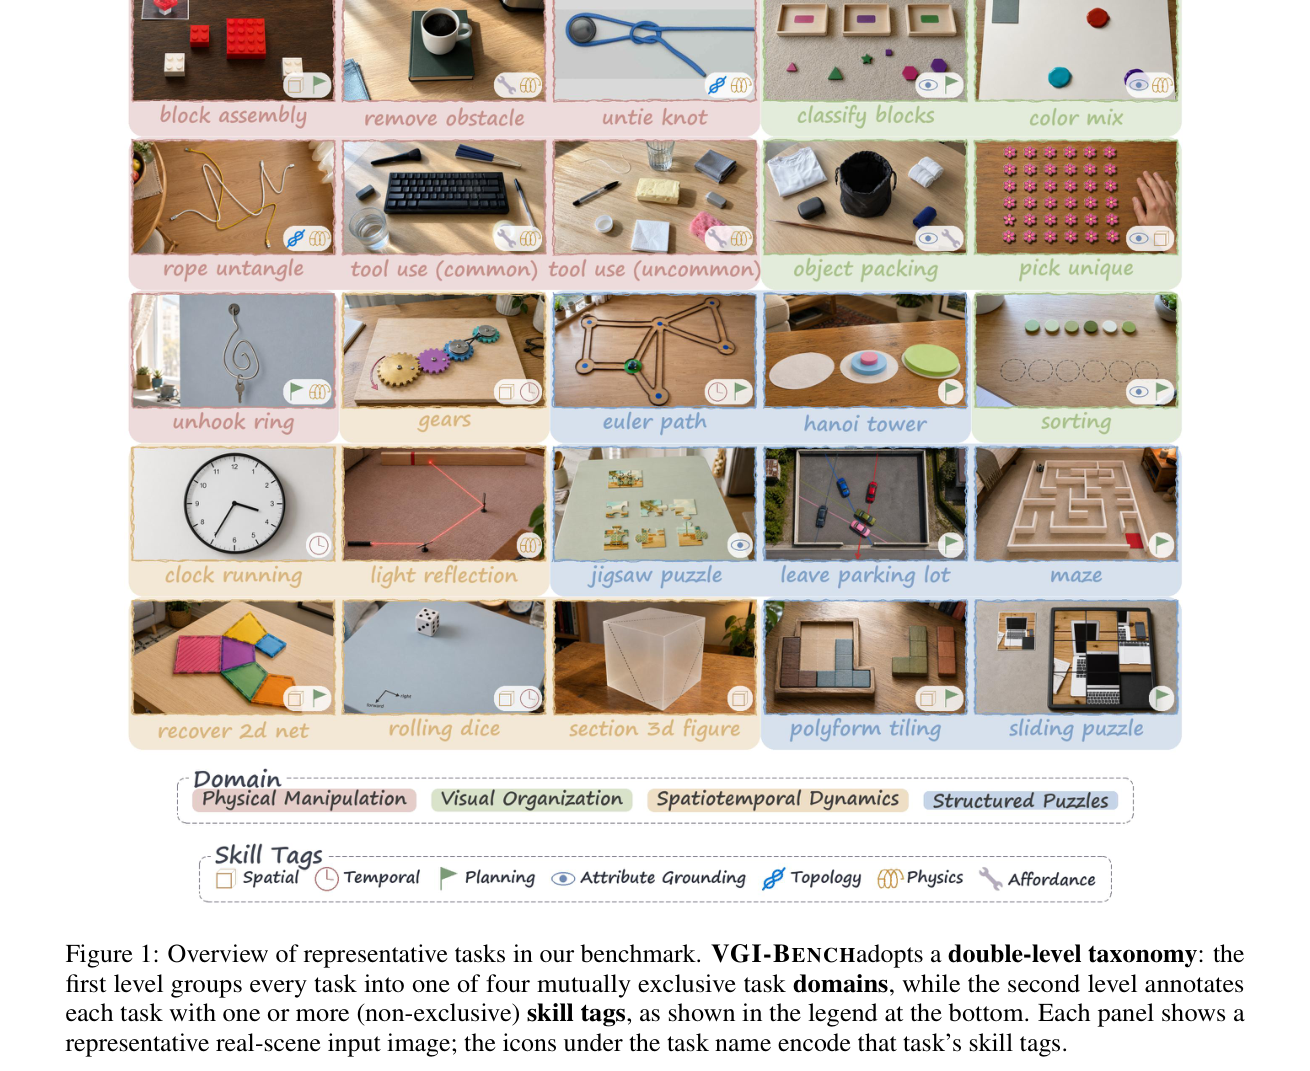
现有视频推理基准有三个问题。第一,输入大多是线稿或抽象示意图,和真实世界视觉分布不匹配。第二,很多任务只要求生成一个合理的最终状态,不要求展示视觉推演过程。第三,任务难度没有经过校准,有的太简单,有的根本不可解。这三个问题让诊断结果缺乏说服力。