PIVOT:当三维重建走出实验室,位姿、内参与轨迹泛化如何被真实部署击穿?
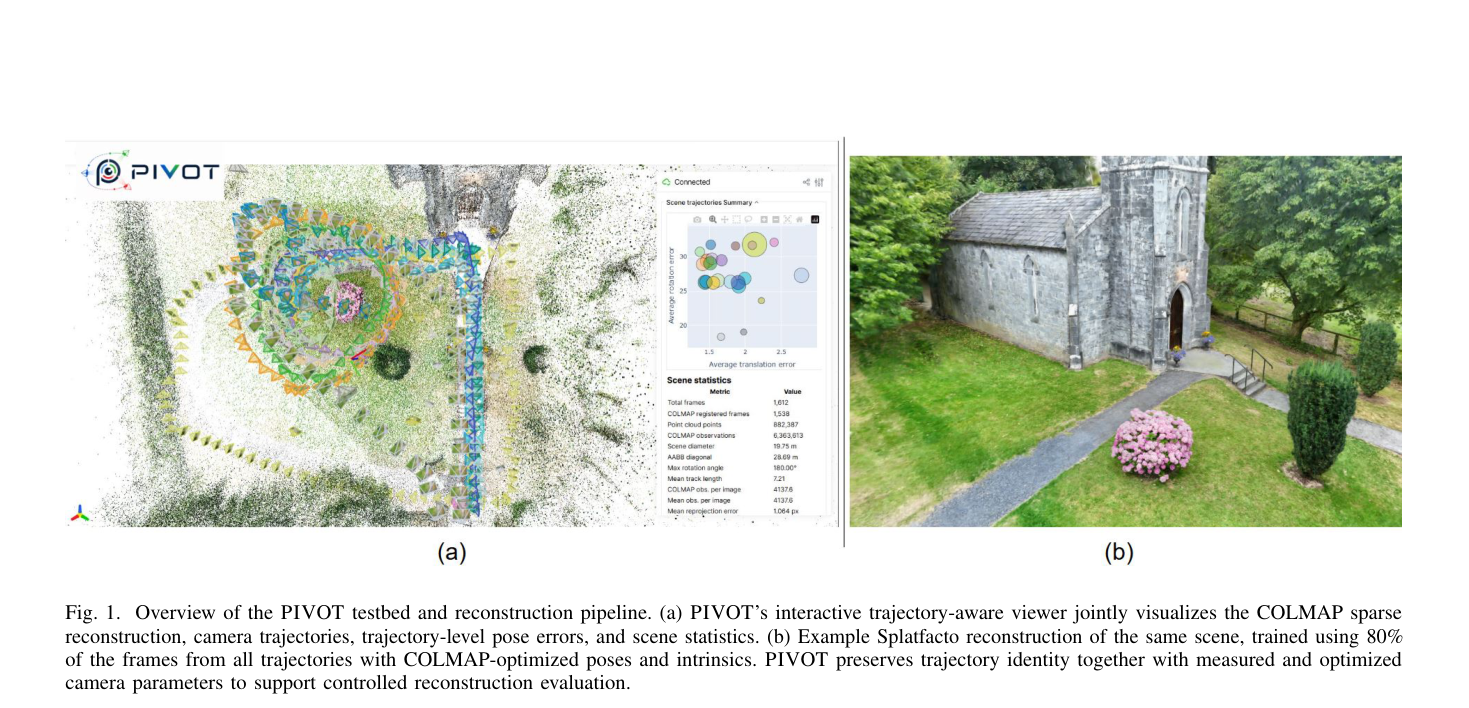
PIVOT是一个多轨迹数据集与测试平台,通过保留传感器测量位姿与COLMAP优化位姿、物理标定与场景优化内参,并显式区分已见/未见轨迹,系统研究真实部署条件下三维重建的泛化与敏感性。
PIVOT是一个多轨迹数据集与测试平台,通过保留传感器测量位姿与COLMAP优化位姿、物理标定与场景优化内参,并显式区分已见/未见轨迹,系统研究真实部署条件下三维重建的泛化与敏感性。
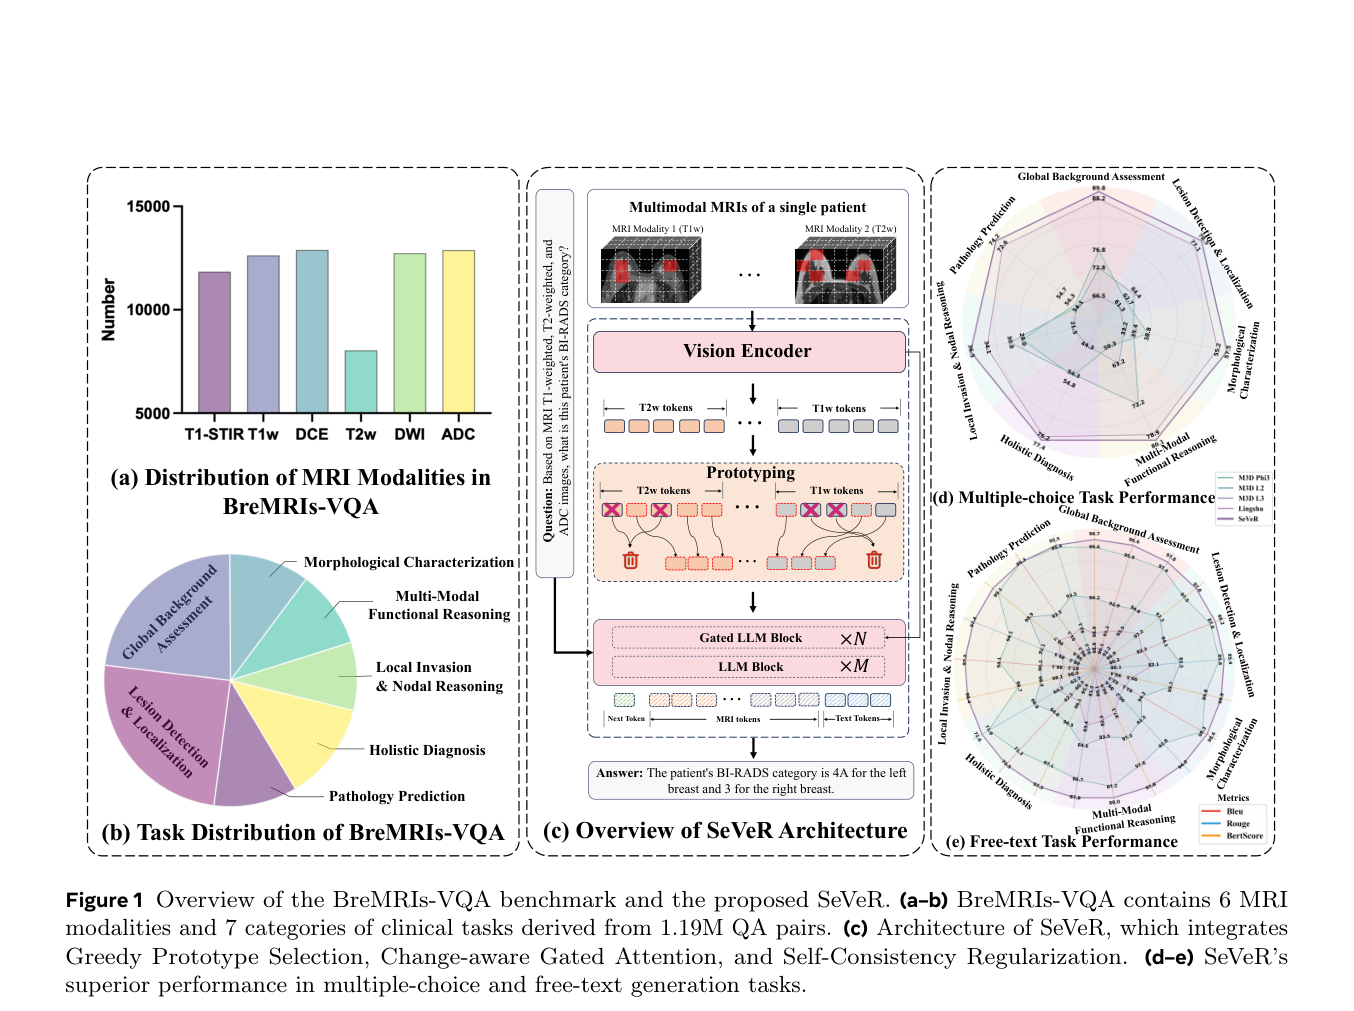
提出BreMRIs-VQA多序列乳腺MRI问答基准与SeVeR框架,通过原型选择与门控检索在暴露更少视觉token的同时提升3D医学VQA性能。
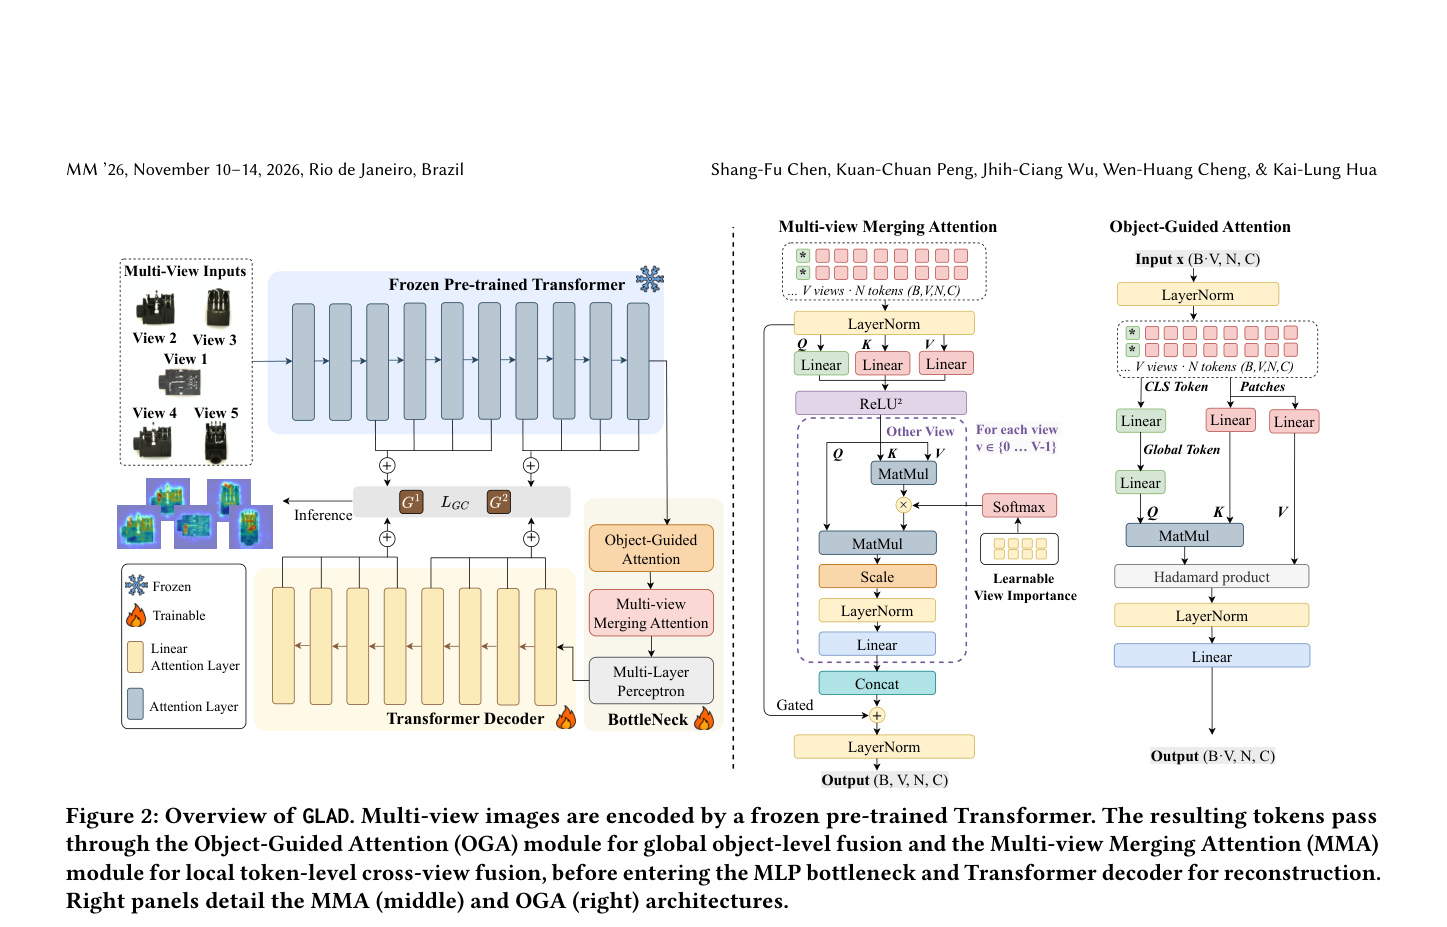
GLAD 提出信息受限的全局-局部多视角融合框架,通过 OGA 和 MMA 模块防止跨视角信息泄漏导致的重建差距坍缩,在多视角异常检测上取得 SOTA 性能。
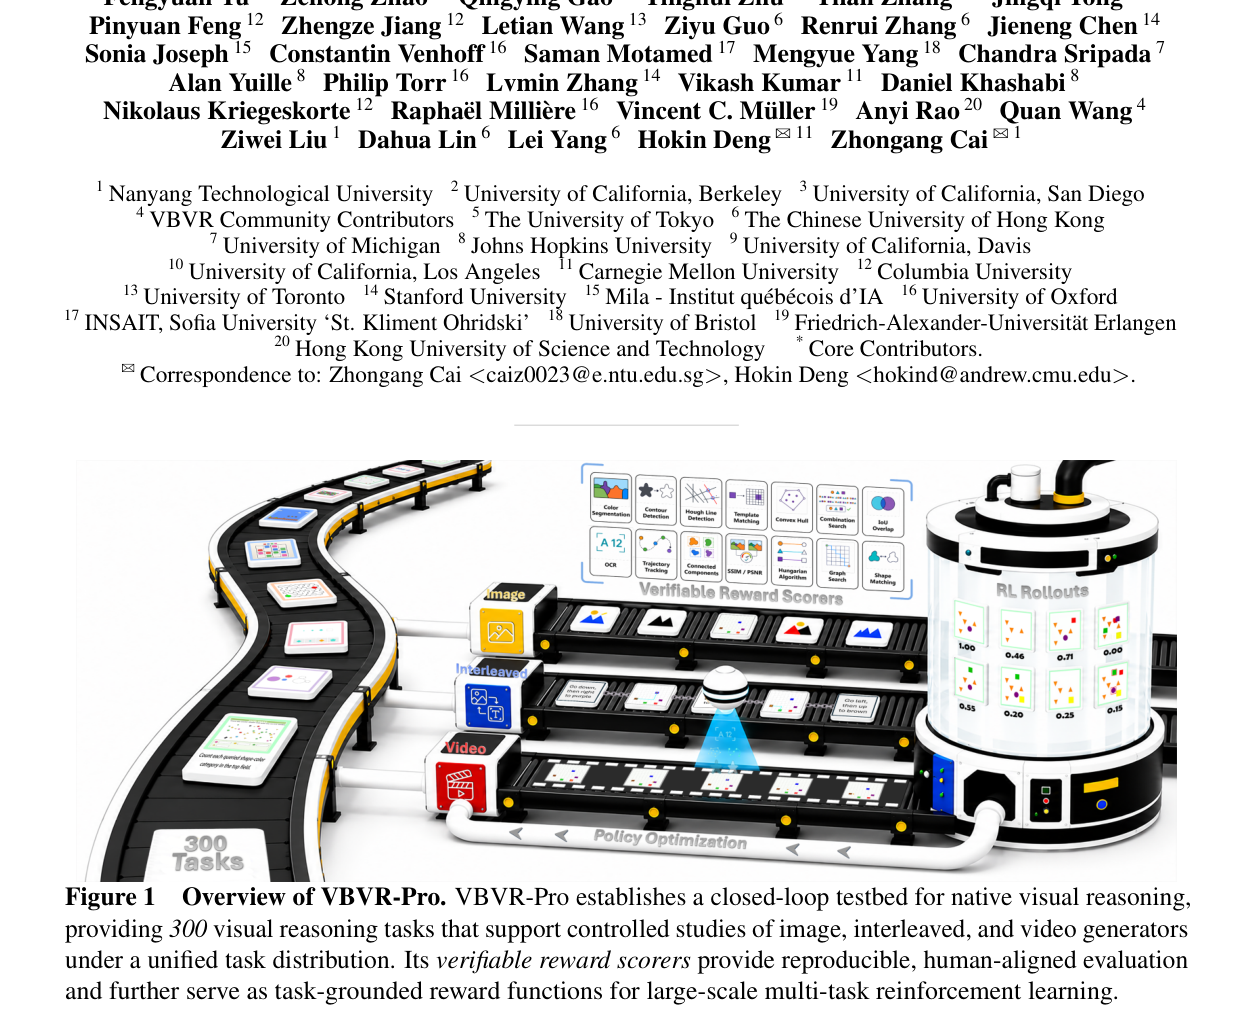
VBVR-Pro 构建了一个包含300个程序化生成任务、可验证奖励评分器和多模态受控对比的闭环测试平台,使原生视觉推理可训练、可验证、可优化、可实验控制。
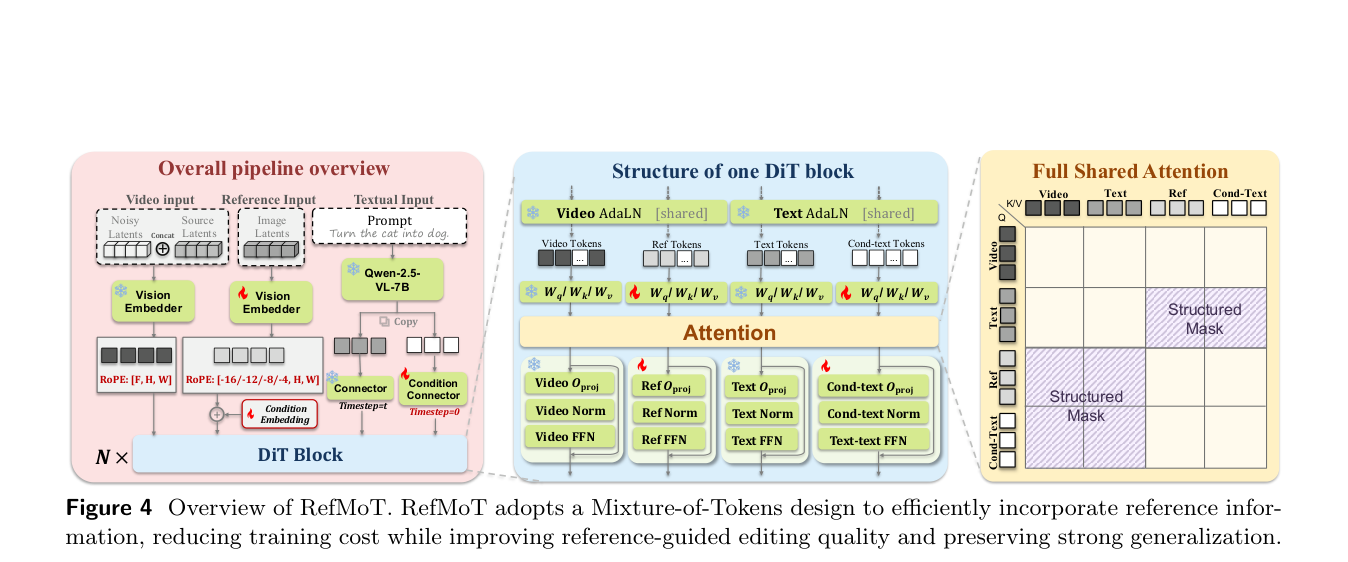
提出包含5M视频对和1M图像对的可靠参考引导编辑数据集RefVideo-6M,并基于此训练RefMoT模型,在指令式和参考式视频编辑上取得SOTA性能。
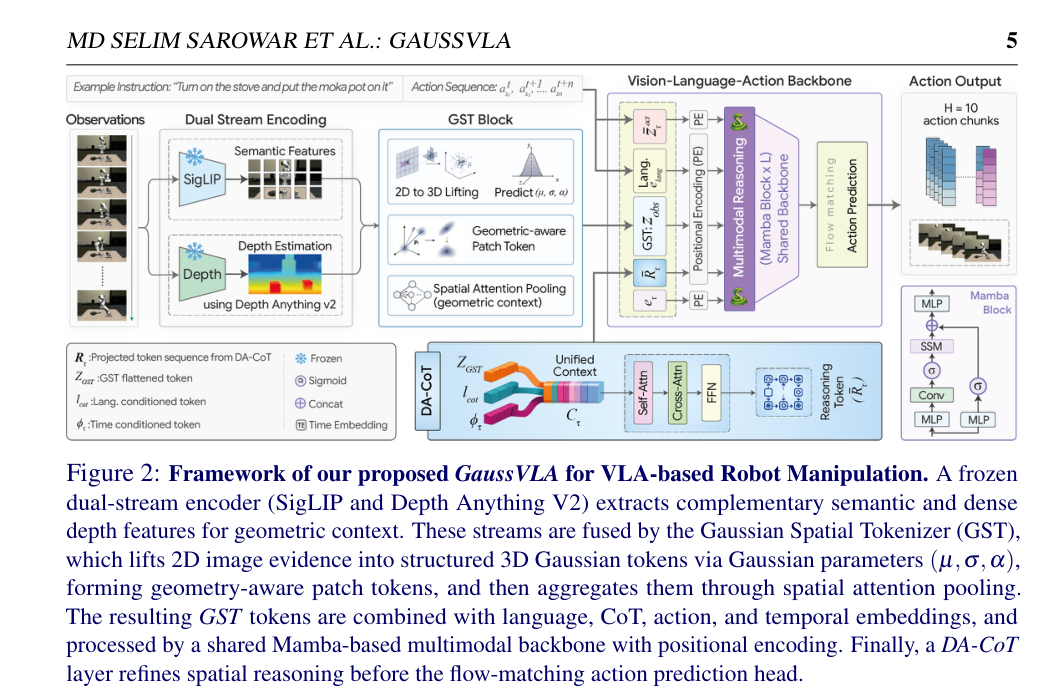
GaussVLA 提出 Gaussian Spatial Tokenizer (GST) 与 Depth-Aware Chain-of-Thought (DA-CoT),将 2D 视觉特征提升为结构化 3D 高斯 token 并进行深度感知推理,在仅 200M 参数下于 LIBERO 达到 93.5% 平均成功率。
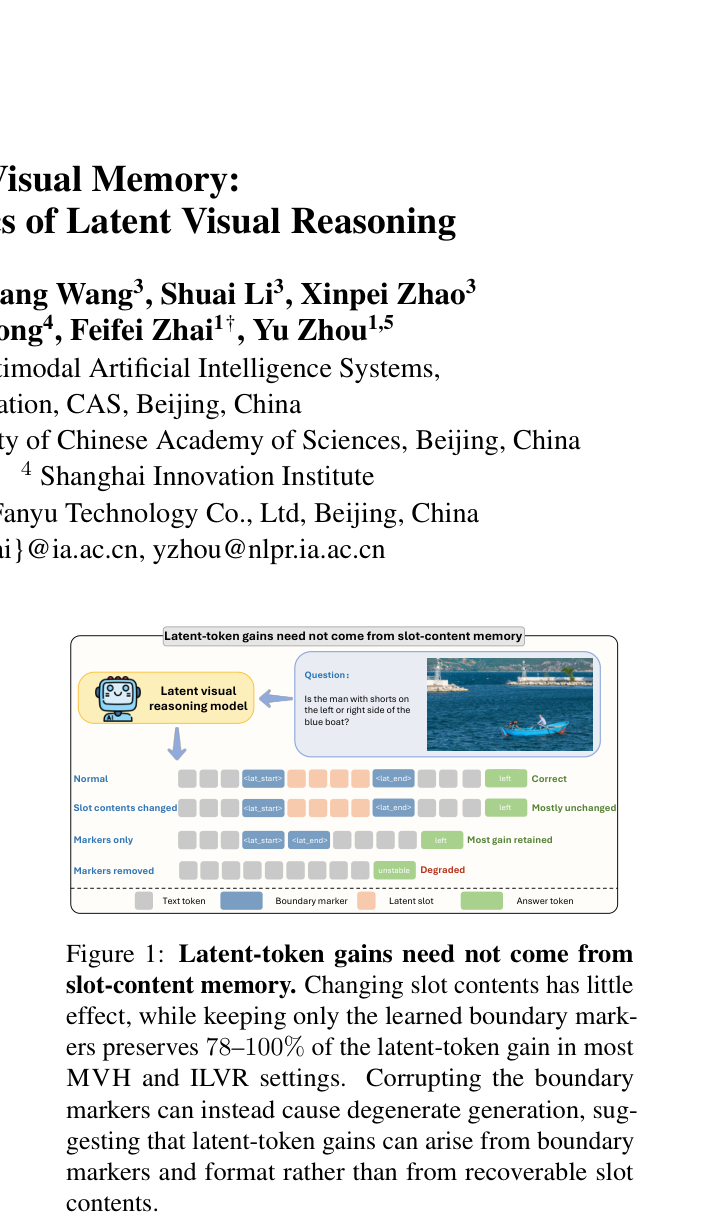
该论文将潜在token分解为槽内容、边界标记和格式三个组件,通过构建内容有利的MVH探针,证明潜在槽内容并非可恢复的视觉记忆,潜在token的增益主要来自标记与格式控制及视觉注意力路由。
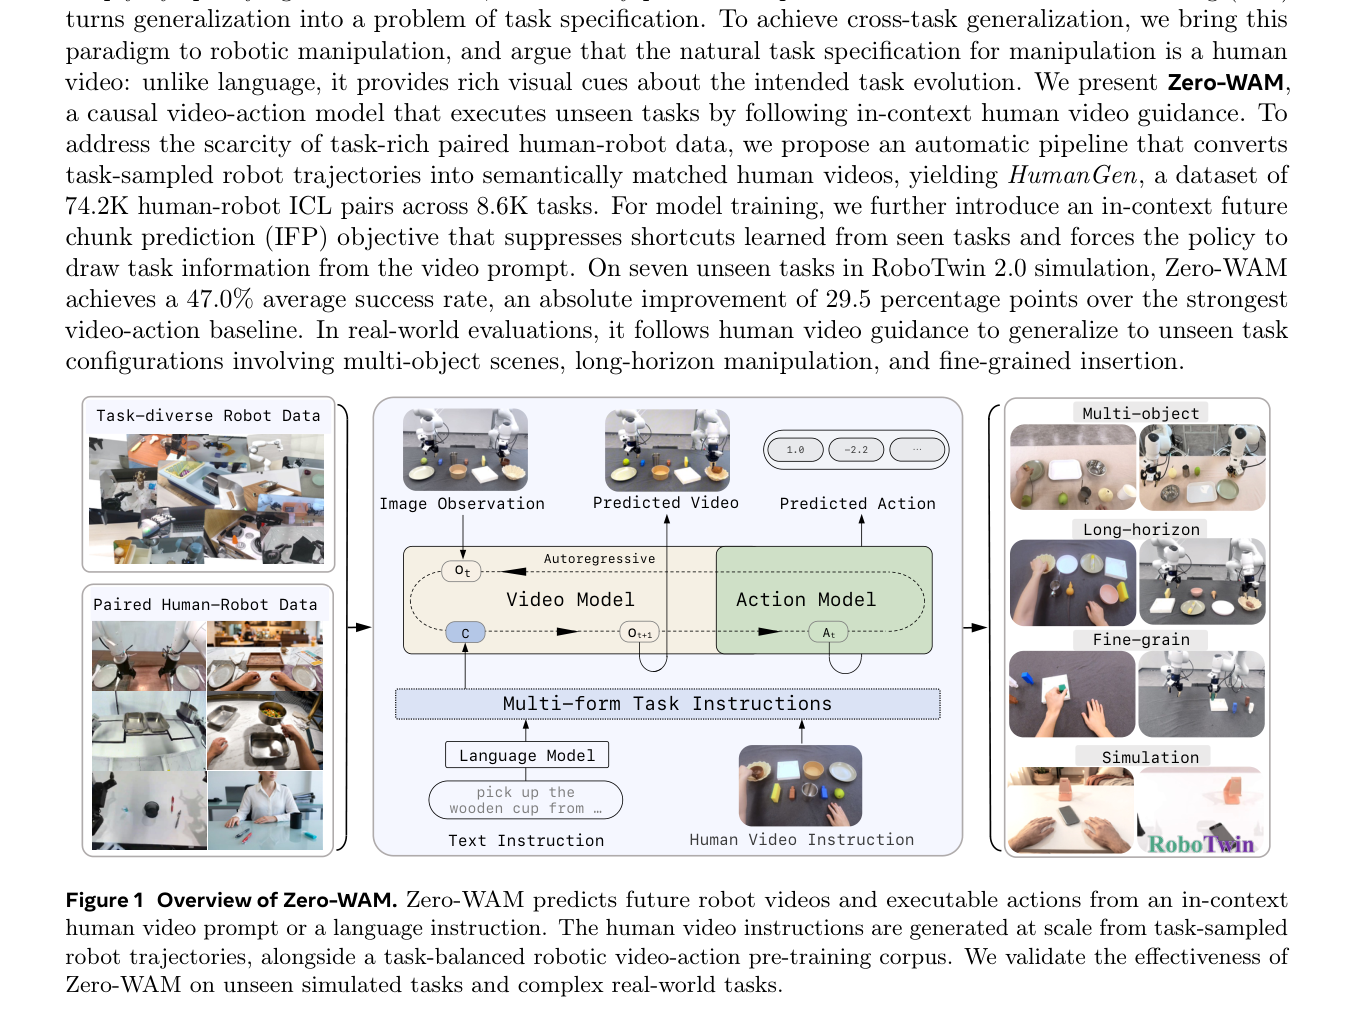
Zero-WAM 提出以人类视频作为上下文任务指令,通过大规模自动生成的人-机器人配对数据(HumanGen)和上下文未来块预测(IFP)目标,实现零样本跨任务机器人操作泛化。
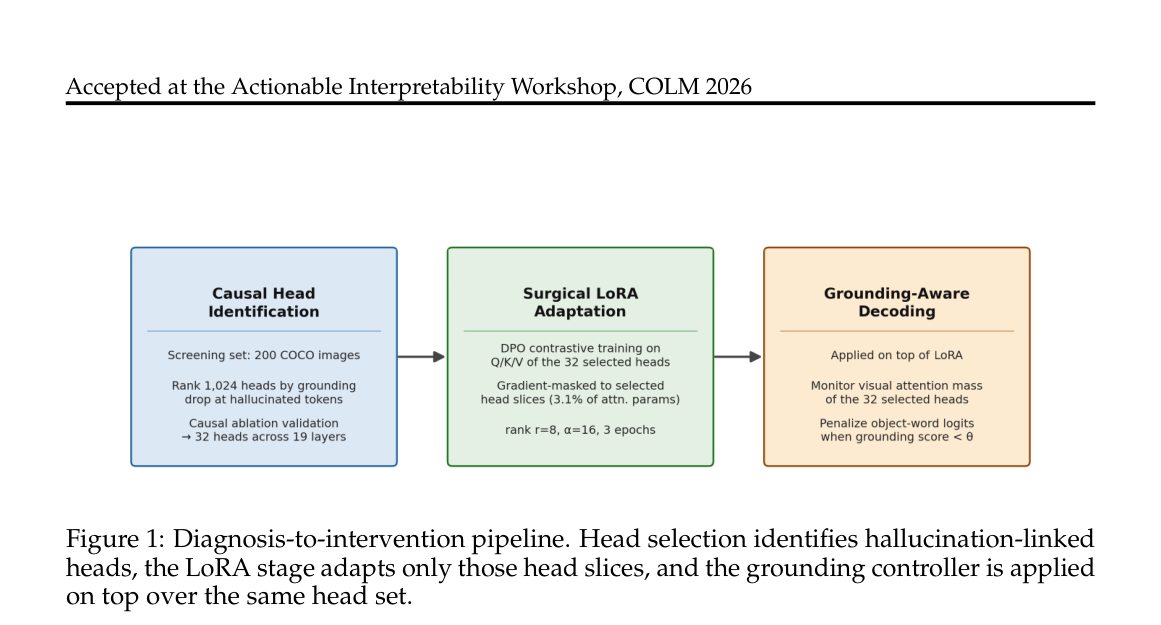
通过诊断筛选出与物体幻觉相关的32个注意力头,仅对这些头做 LoRA 适配并叠加推理时 grounding 控制器,在 COCO 上显著降低 CHAIRs/CHAIRi,同时使生成更短更保守。