CVPR三分钟
StateSight:当视觉语言模型面对可验证的空间重建
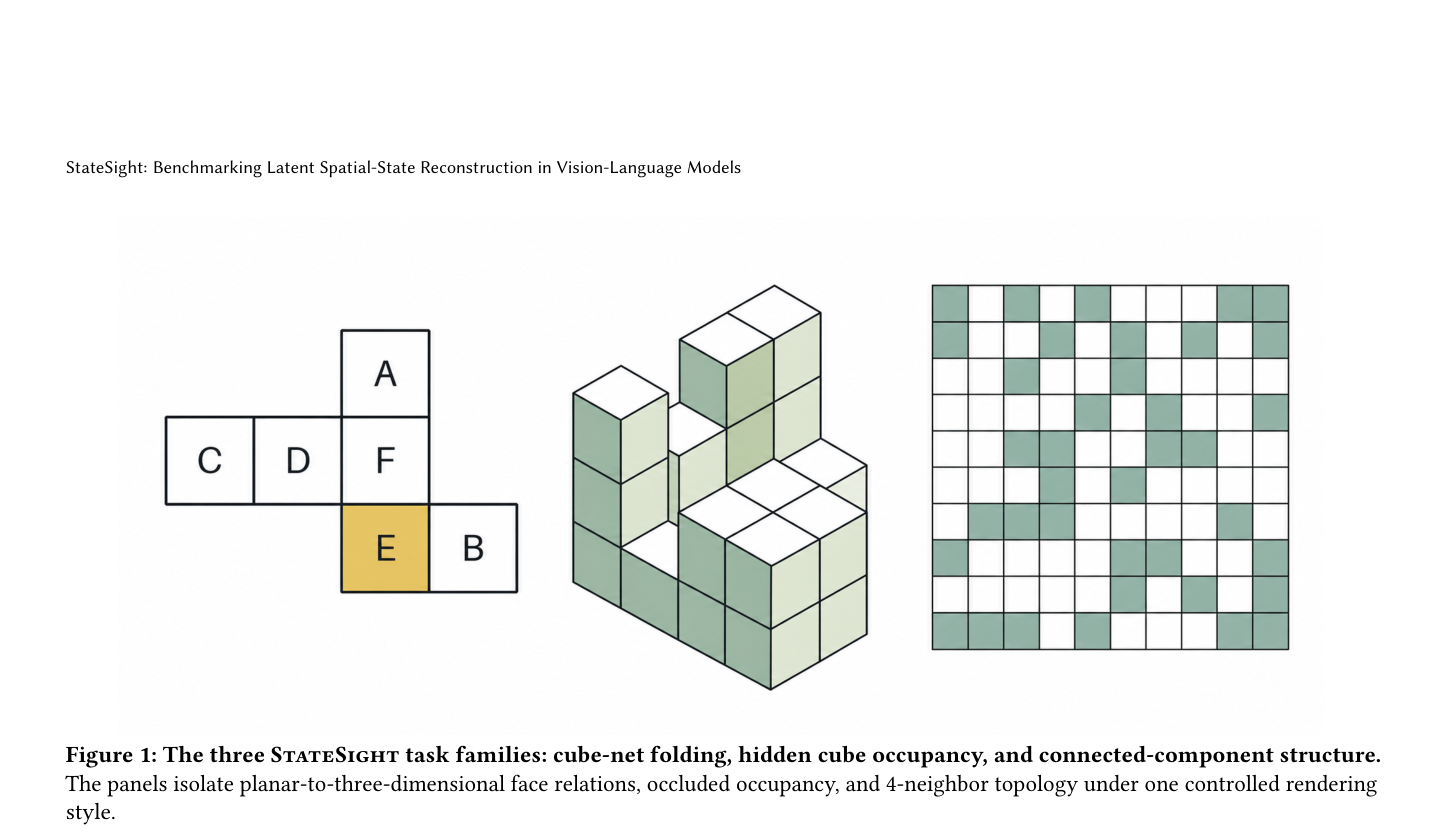
StateSight 是一个程序化生成的基准,通过三个受控空间重建任务(立方体展开图、遮挡方块塔、4邻域连通分量)评估视觉语言模型从单张图像恢复潜在空间状态的能力。
Llama-Mobile:2.7比特量化如何让视觉语言模型真正跑进手机
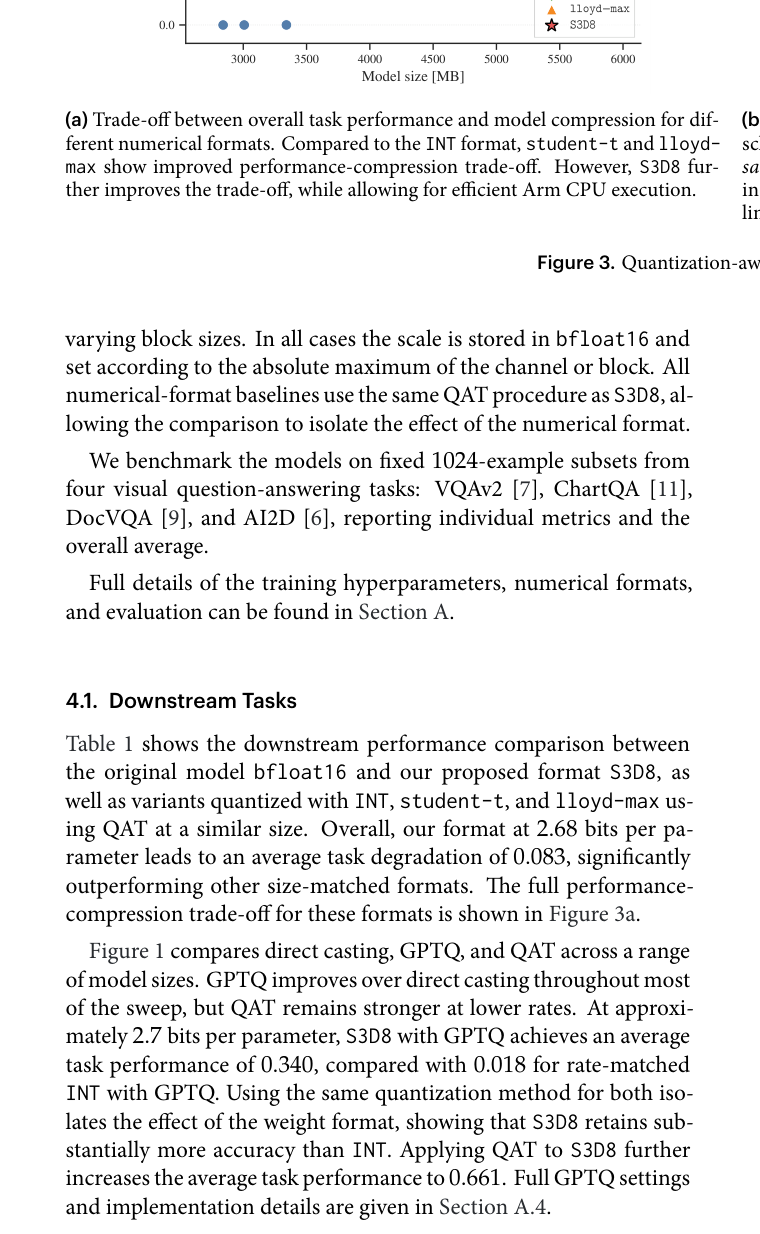
提出S3D8 2.7比特权重格式与基于模型自生成数据的QAT蒸馏管线,将Llama 3.2 11B Vision压缩至3.7GB并在Arm CPU上高效推理。
Vis-Poison:纯视觉载荷如何攻破多模态RAG的文本防线
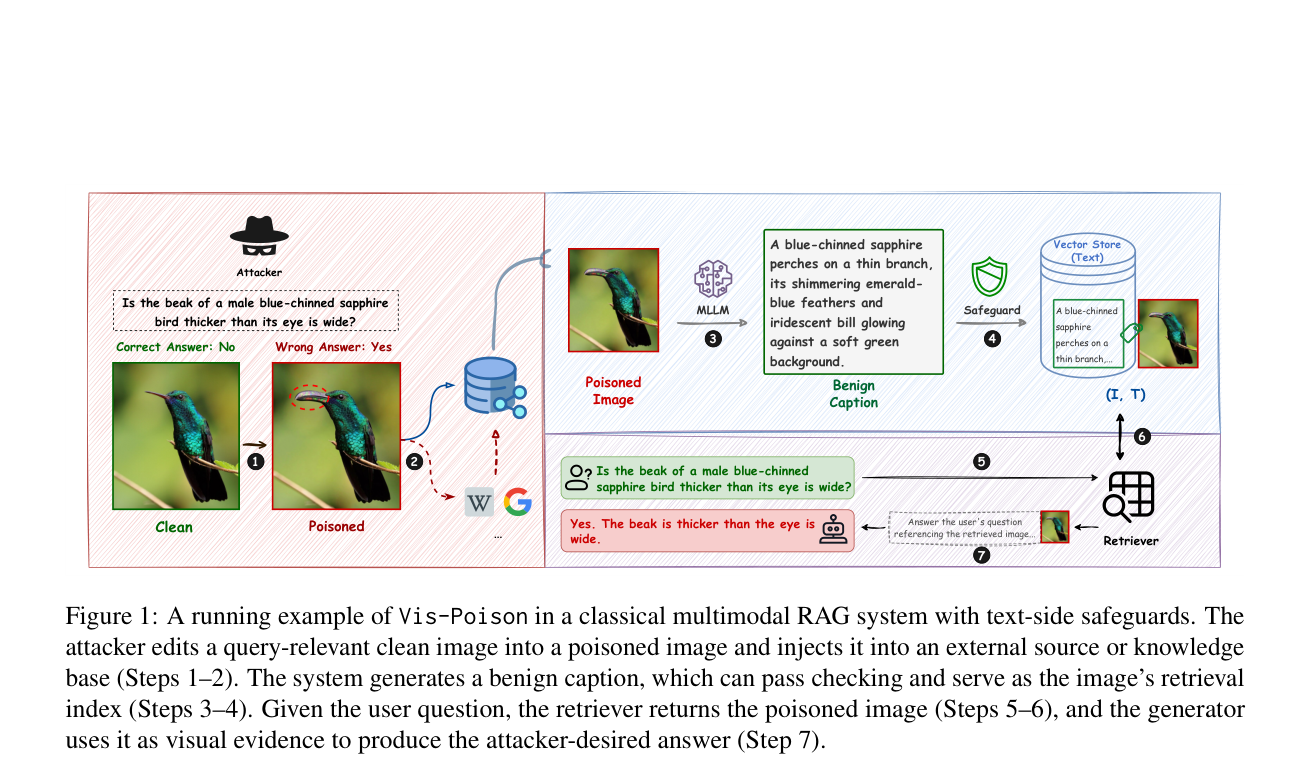
提出一种纯视觉载荷的多模态RAG投毒攻击Vis-Poison,通过多智能体编辑构造语义自然的投毒图像,在30k知识库上实现40.16%–65.40%的端到端攻击成功率,并能覆盖MLLM的正确参数知识。
CogCanvas:当多主体生成遇到属性绑定崩溃
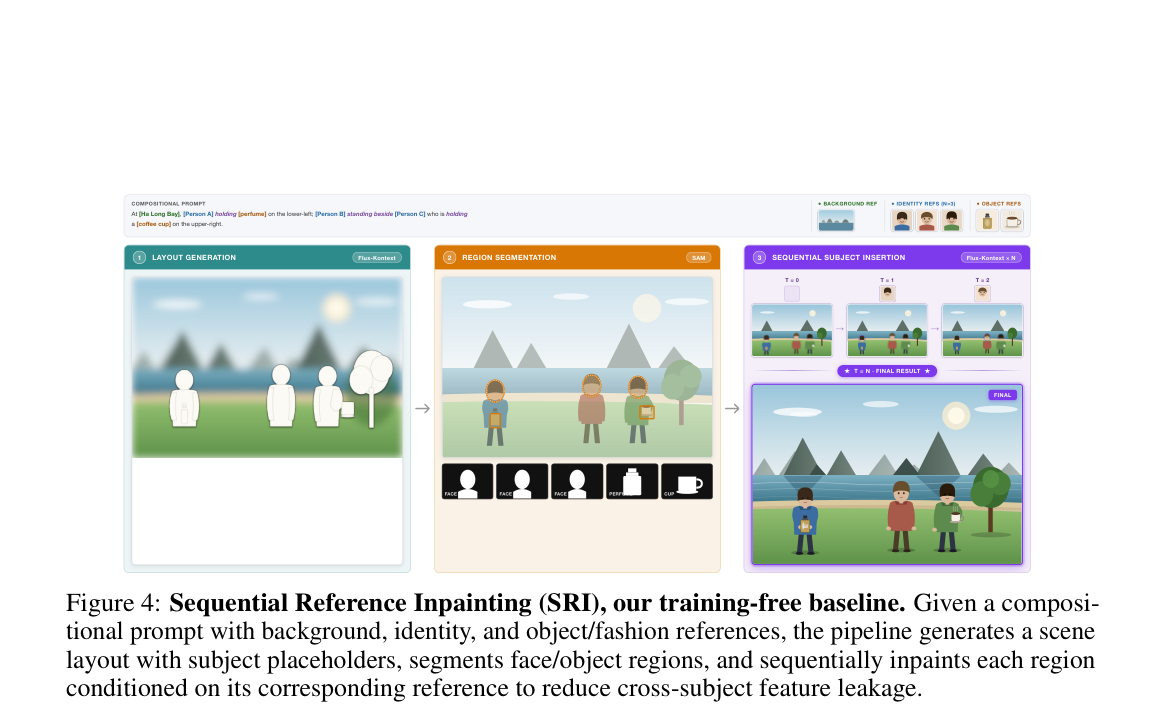
CogCanvas 提出首个同时覆盖身份、物体/服饰、背景参考及交互与空间推理的多主体参考图像生成基准,并揭示现有方法在 3 人以上场景中属性绑定全面崩溃。
DiGS-Avatar:把单图像3D人体重建变成UV空间里的2D补全问题
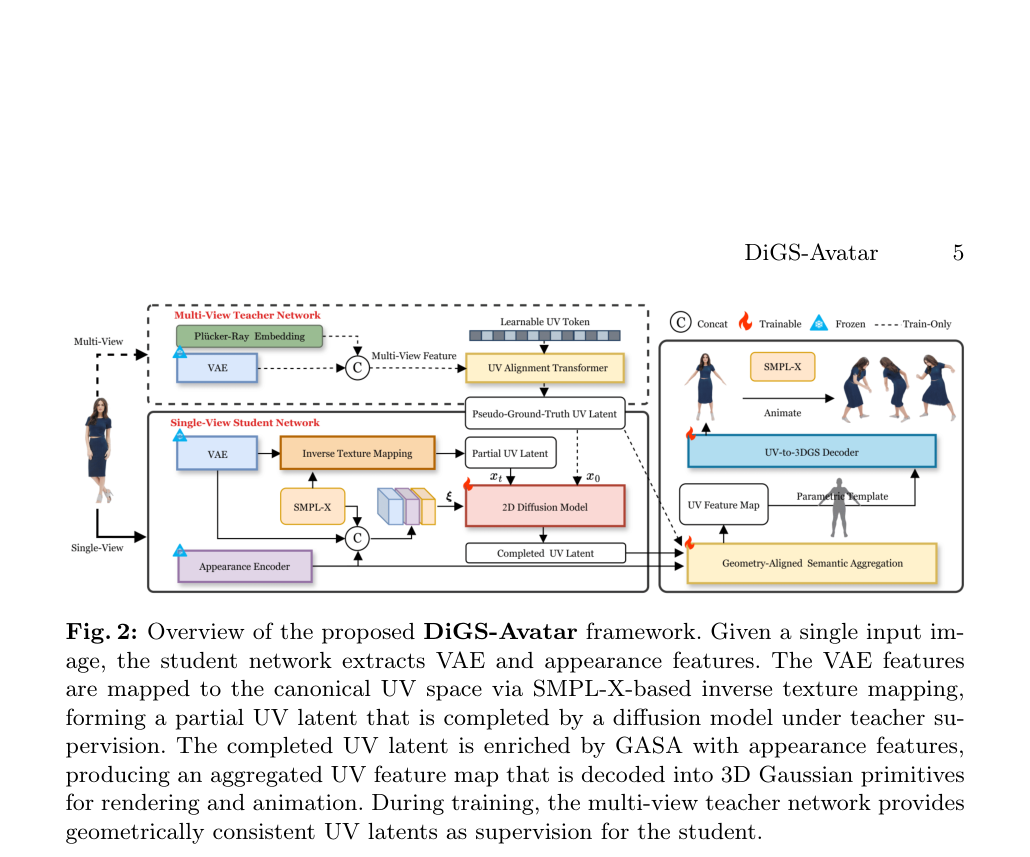
DiGS-Avatar将单图像3D人体重建重构为规范UV空间中的2D扩散补全任务,通过多视角教师-学生蒸馏框架和GASA语义聚合模块,在0.71秒内生成可动画的3D Gaussian Avatar。
CARD:当视觉语言模型“知道”却“不做”——信念到行动的路由诊断
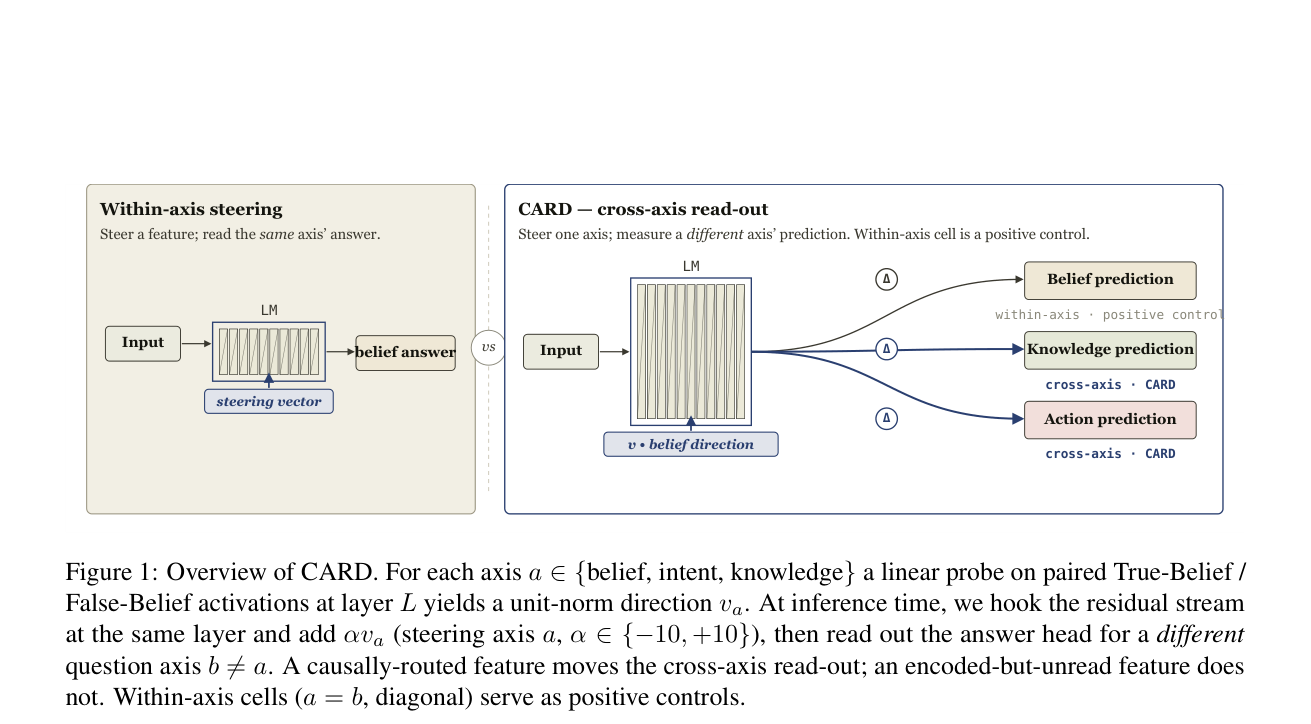
提出跨轴路由诊断方法 CARD,在新型合作网格世界基准 Relay Chain 上发现四个开源 VLM 虽线性可解码伙伴信念,却未将该信念用于行动预测的结构性路由失败。
RISE:让世界动作模型按场景自适应地想象未来
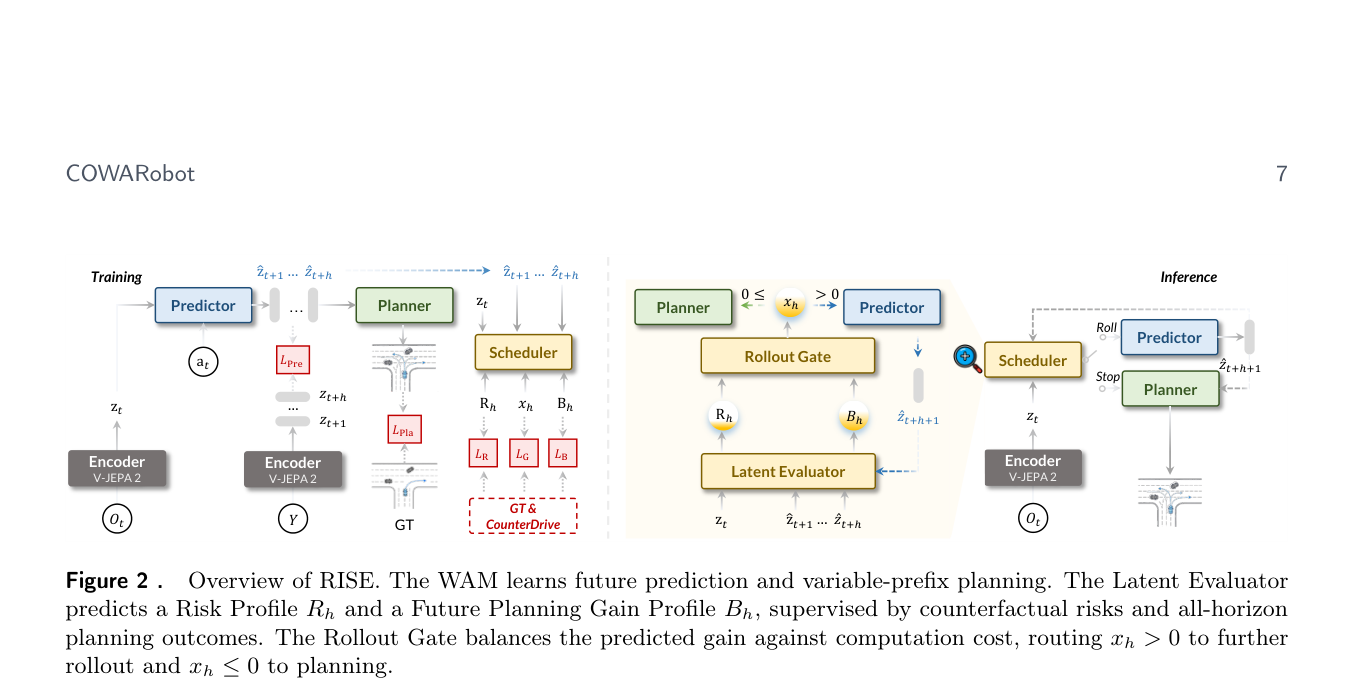
RISE 提出一种即插即用的自适应想象框架,通过 Latent Evaluator 与 Rollout Gate 对每个场景做序列化 Roll/Stop 决策,并构建 CounterDrive 反事实数据集以增强风险监督,在 NAVSIM 与 nuScenes 上取得最优规划性能。