深度学习
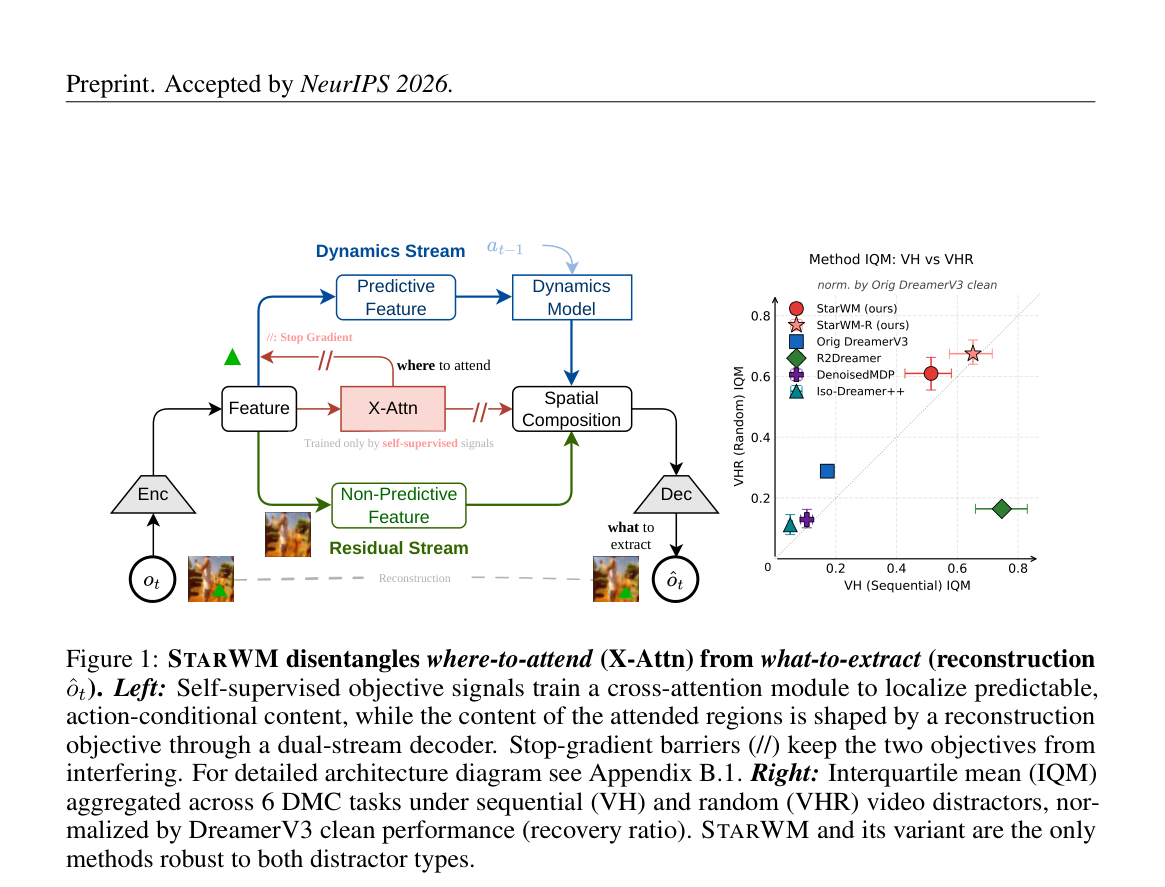
SatNav:面向长程无人机视觉语言导航的可扩展卫星基准
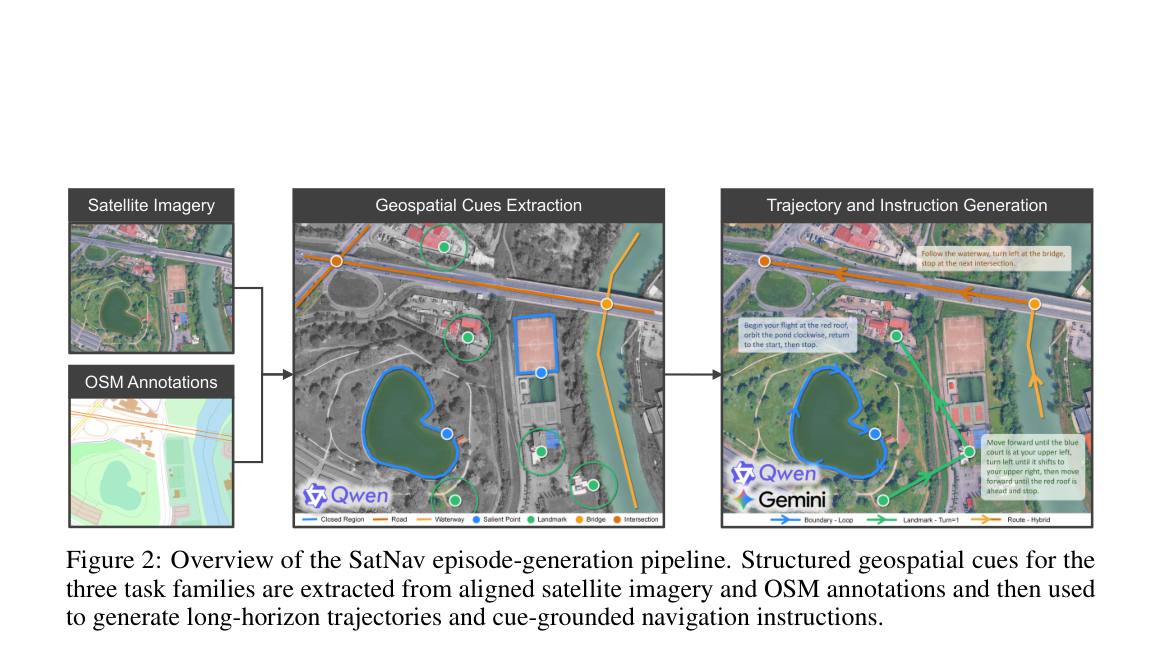
SatNav 从卫星影像与 OSM 自动构建 18 城、59 场景、约 118K 长程 UAV VLN 轨迹,定义 Boundary/Landmark/Route 三任务族,并配套 SwiftVLN 记忆消融与卫星到真机迁移实验(NeurIPS 2026)。
算力用在刀刃上:面向高效视频扩散的异构注意力 HetA-DiT
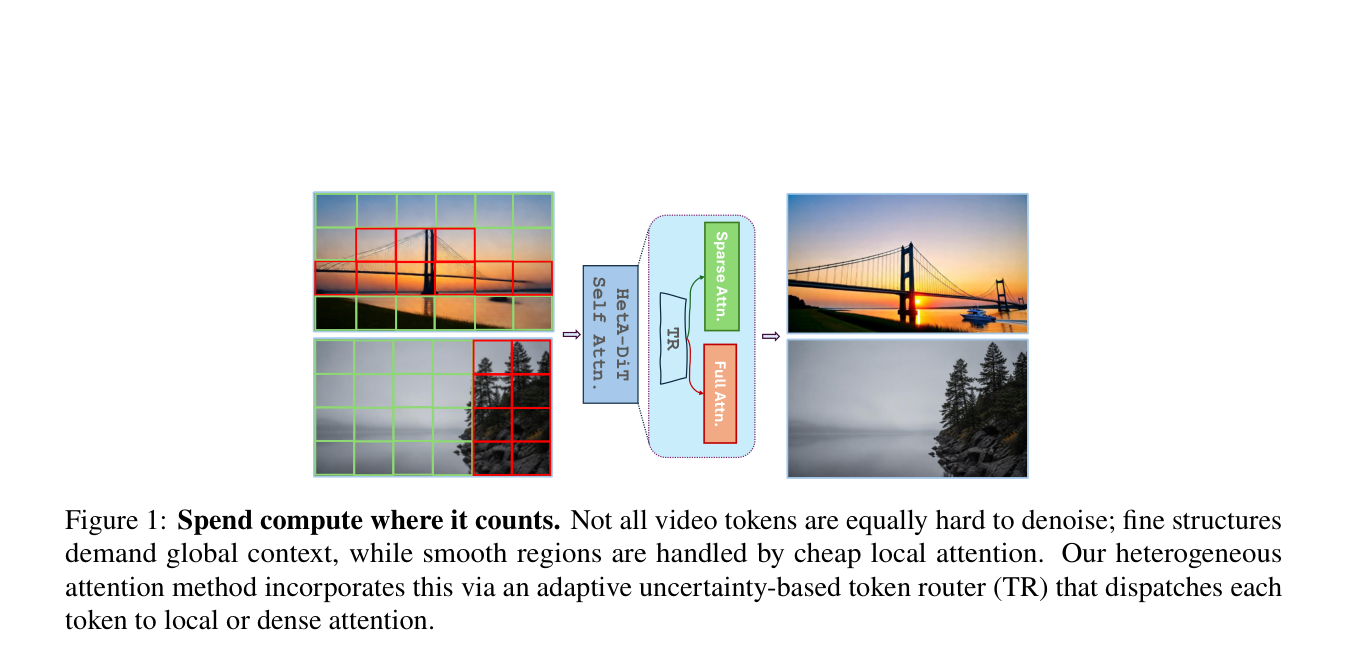
HetA-DiT 用轻量不确定性分支按 token 去噪难度把可靠区域交给局部注意力、困难区域交给稠密注意力,在 DMD 少步视频扩散上用约 20% 稠密计算保持接近基线的质量。
放大你注视的地方:文生图中的目标显著性提升
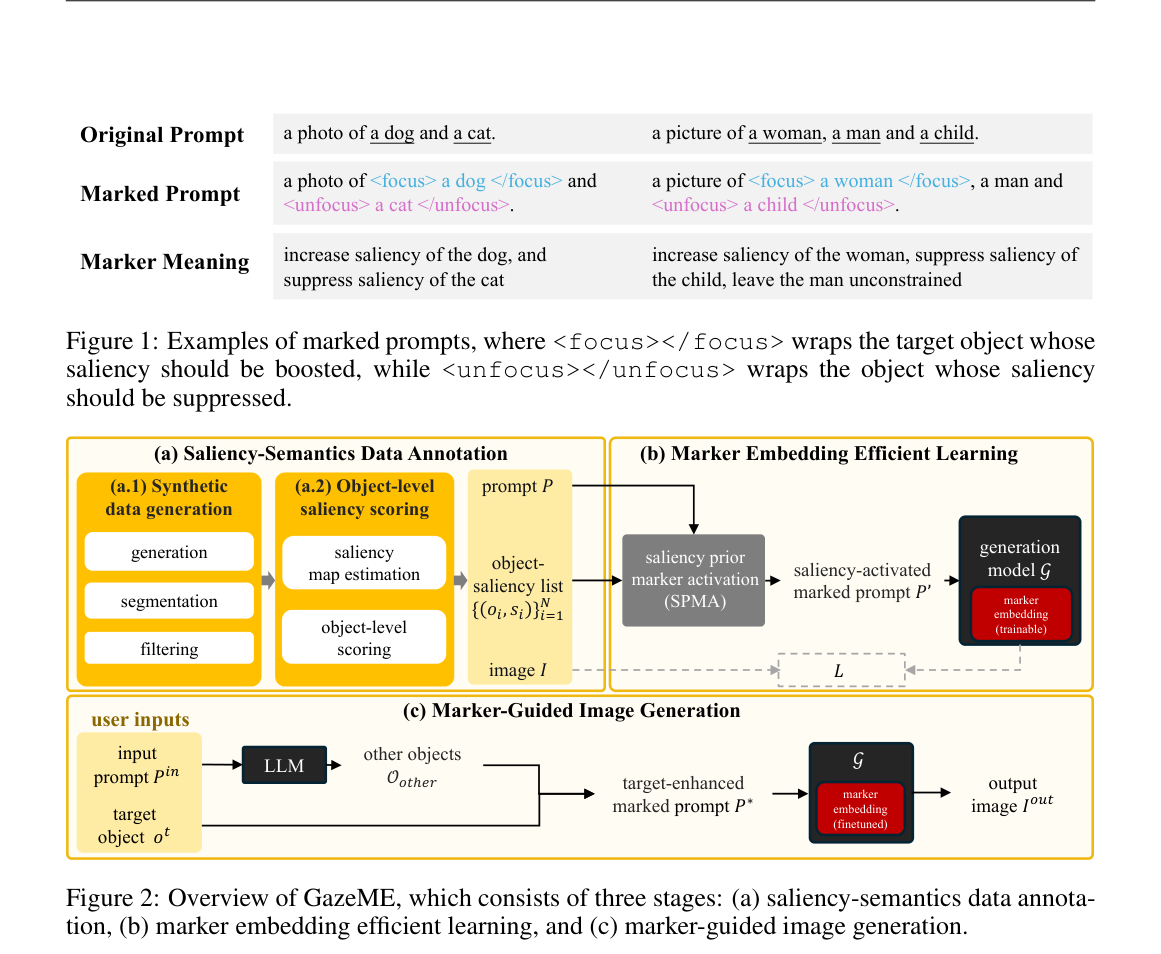
GazeME 提出 Target Saliency Boosting:用
从奖励信号到视觉效用:医学VLM后训练的受控审计
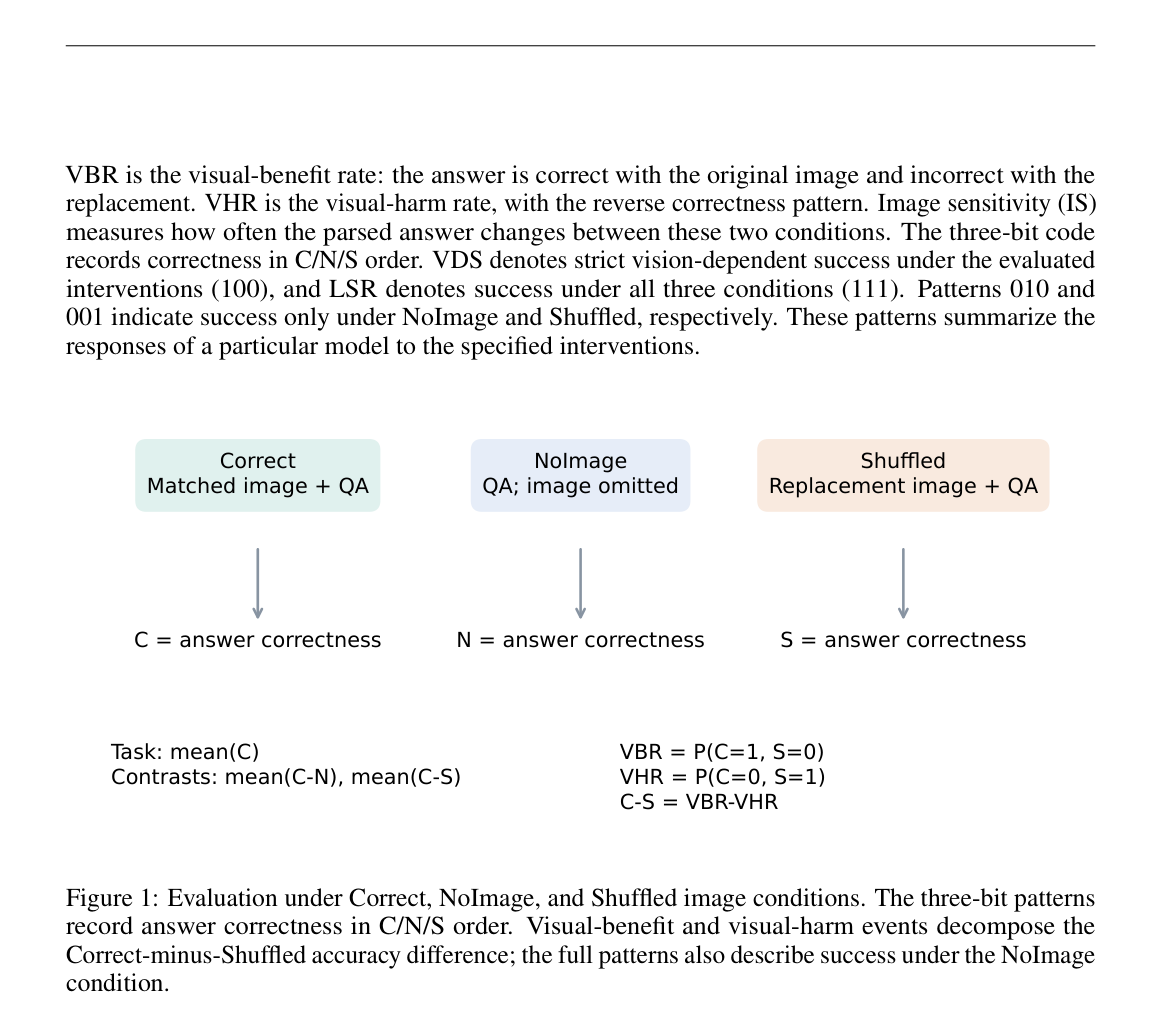
在 Qwen2.5-VL-3B 与 PMC-VQA 上,用正确/无图/打乱图干预与配对转移,审计 SFT 与 GRPO 后训练如何改写个体图像收益,而非只看平均准确率;本文是研究审计,不是临床产品。
TRACKGRAPH:基于图像空间跟踪的在线开放词汇三维场景图
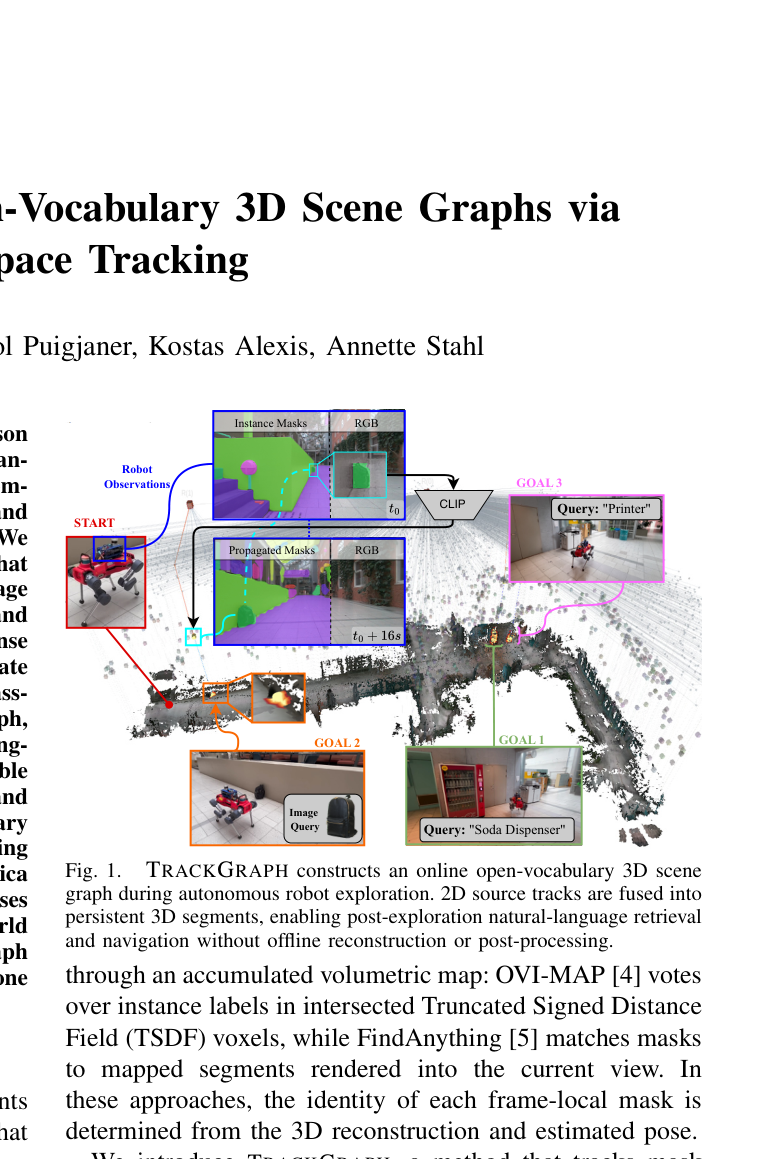
TRACKGRAPH 先在图像空间用 DINOv3 传播稀疏 FastSAM 掩码形成 source track,再融合进层次化场景图的类无关三维段,并以多视角 CLIP 库支持在线开放词汇检索与导航。
LiTe-GS:面向三维高斯泼溅的预言机高效下一最优视角选择
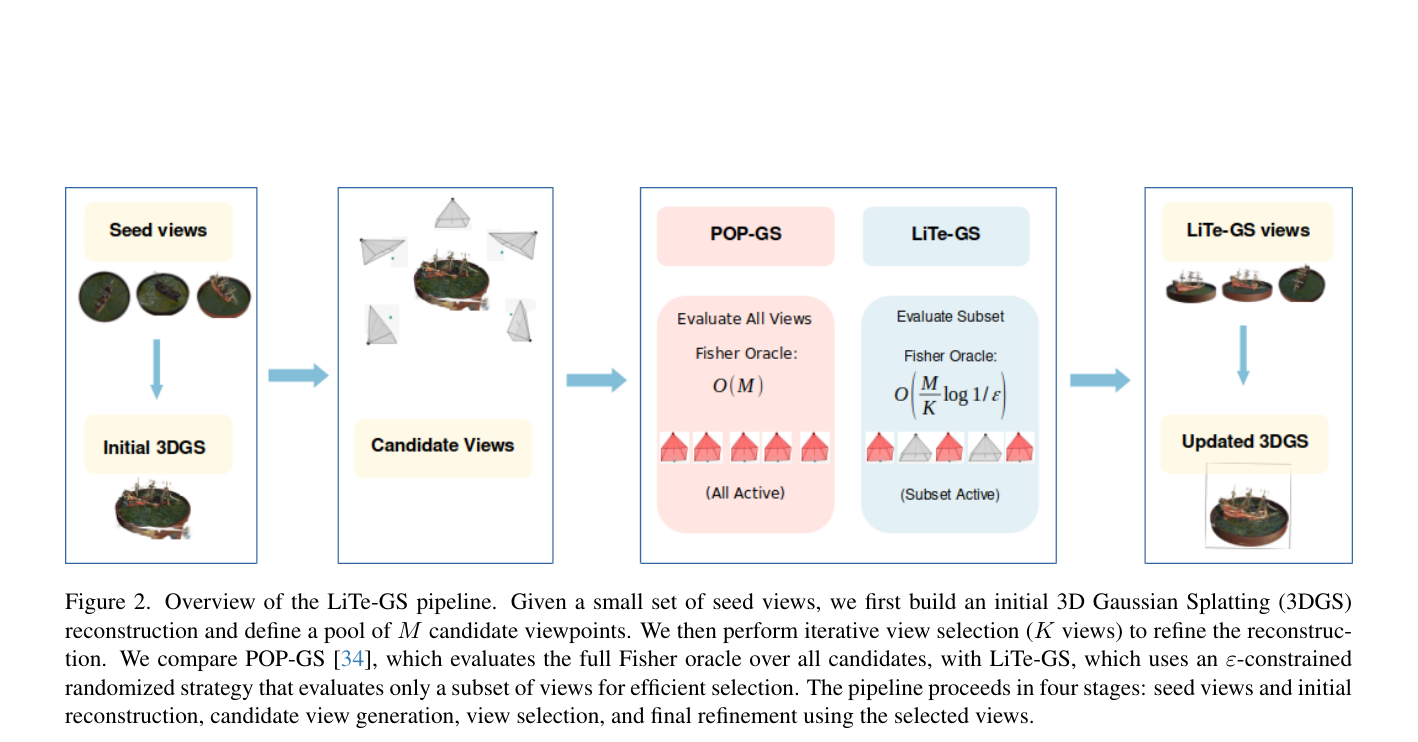
LiTe-GS 用 ε 约束的随机子集评估替代全池 Fisher 预言机,在 3DGS 下一最优视角选择中把期望复杂度降到 O(M log(1/ε)),重建质量可比 POP-GS。
Skip the Talk:用潜空间推理重聚焦视觉的推理分割
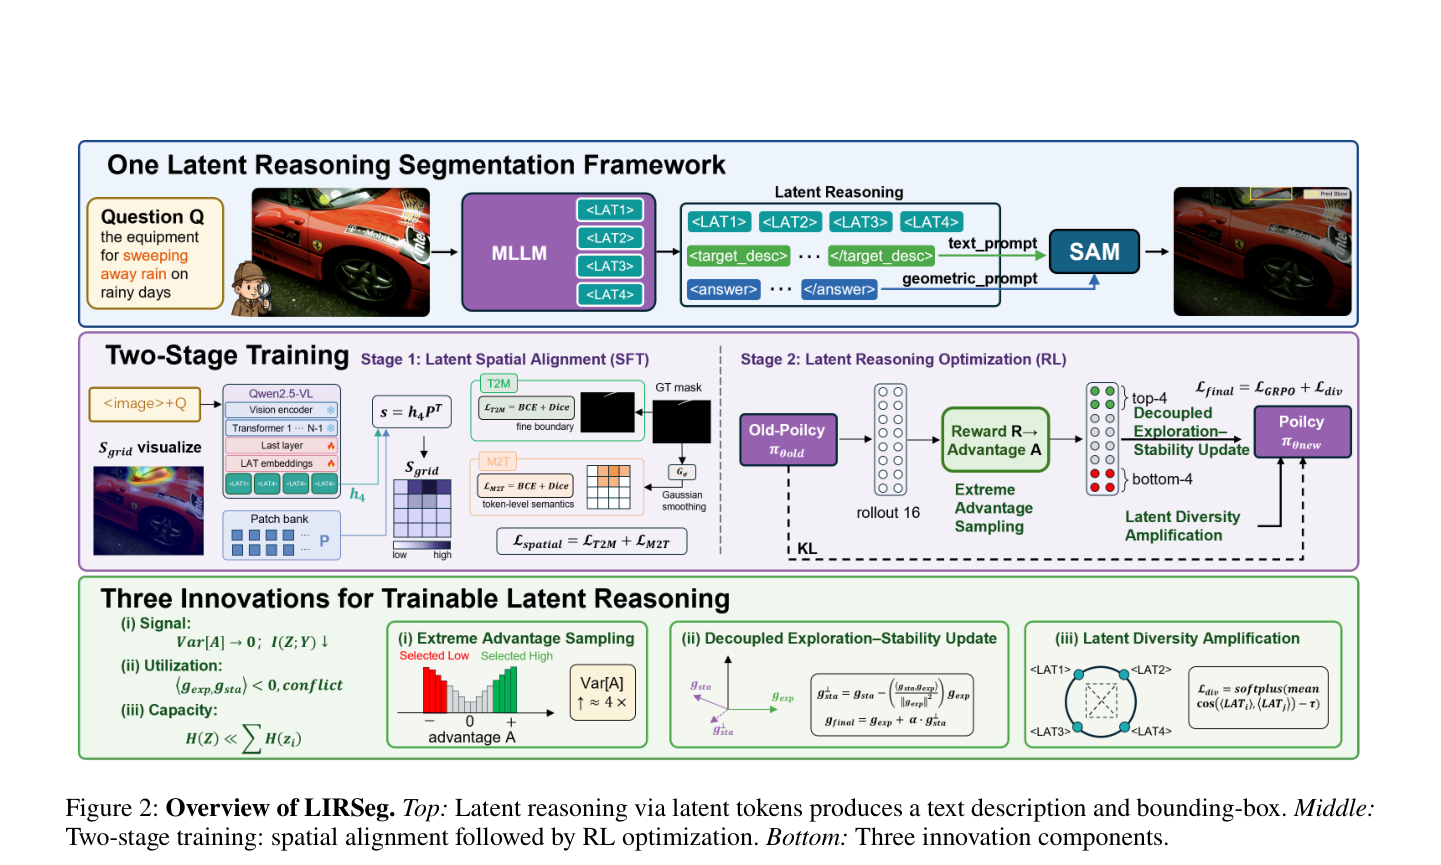
LIRSeg 用少量可学习潜空间令牌完全替代显式 CoT,经空间对齐与 GRPO,并配合 EAS/DES/LDA,在推理分割上提点同时把推理令牌压到约十六分之一。
DepthEvidence:在多模态语言模型中统一度量深度预测与几何推理
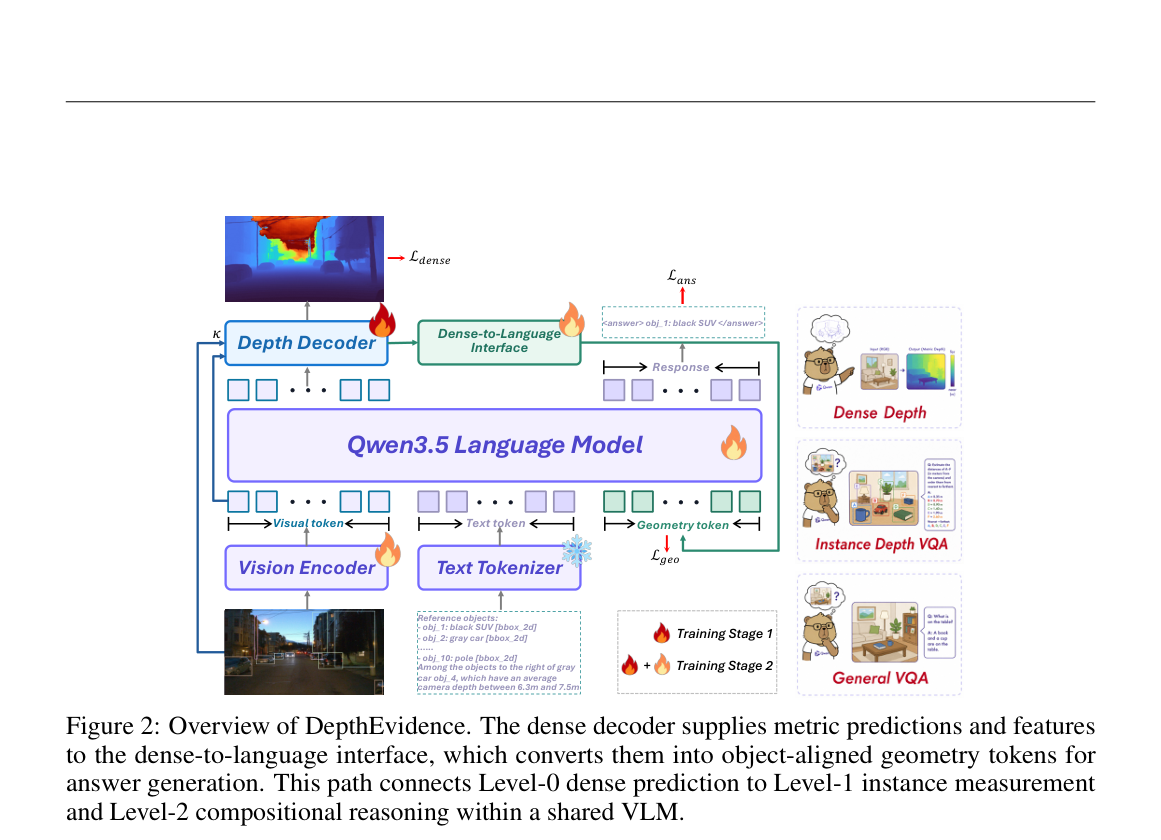
DepthEvidence 是约 4B 参数模型:用相机条件解码器预测稠密度量深度,经稠密到语言接口转成对象对齐的连续几何令牌,让回答直接条件于自身深度证据。