跳至内容

pchao.org

PengChao

入口点决定跨任务可用性:统一多模态模型中新概念从何处进入
23 8 月, 2026 作者 PengChao
一个失败案例

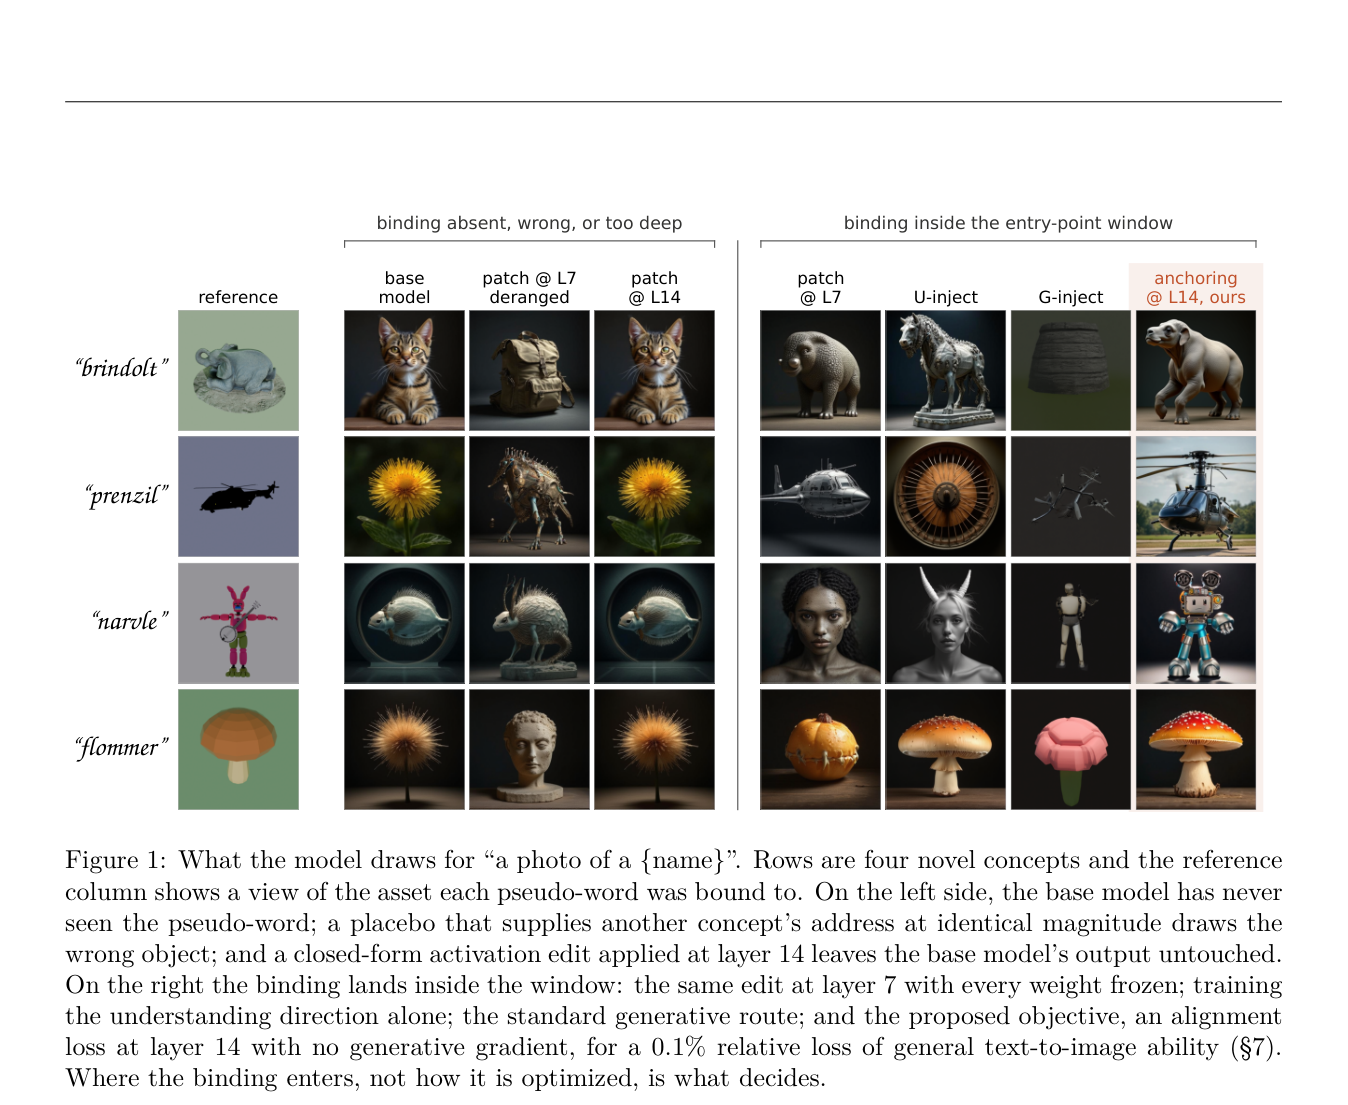
本文通过构造性分离实验证明,在统一多模态模型中,新概念绑定的跨任务可用性由其在共享计算中的入口深度和语义格式决定,而非由训练目标或参数共享程度决定。

分类 CVPR三分钟 标签 CVPR三分钟、 entry point、 export、 TransferRate、 人工智能、 深度学习、 计算机视觉 发表评论

SpurCon:用加权对比学习重塑表示几何,缓解医学影像虚假相关性

23 8 月, 2026 作者 PengChao
方法贡献

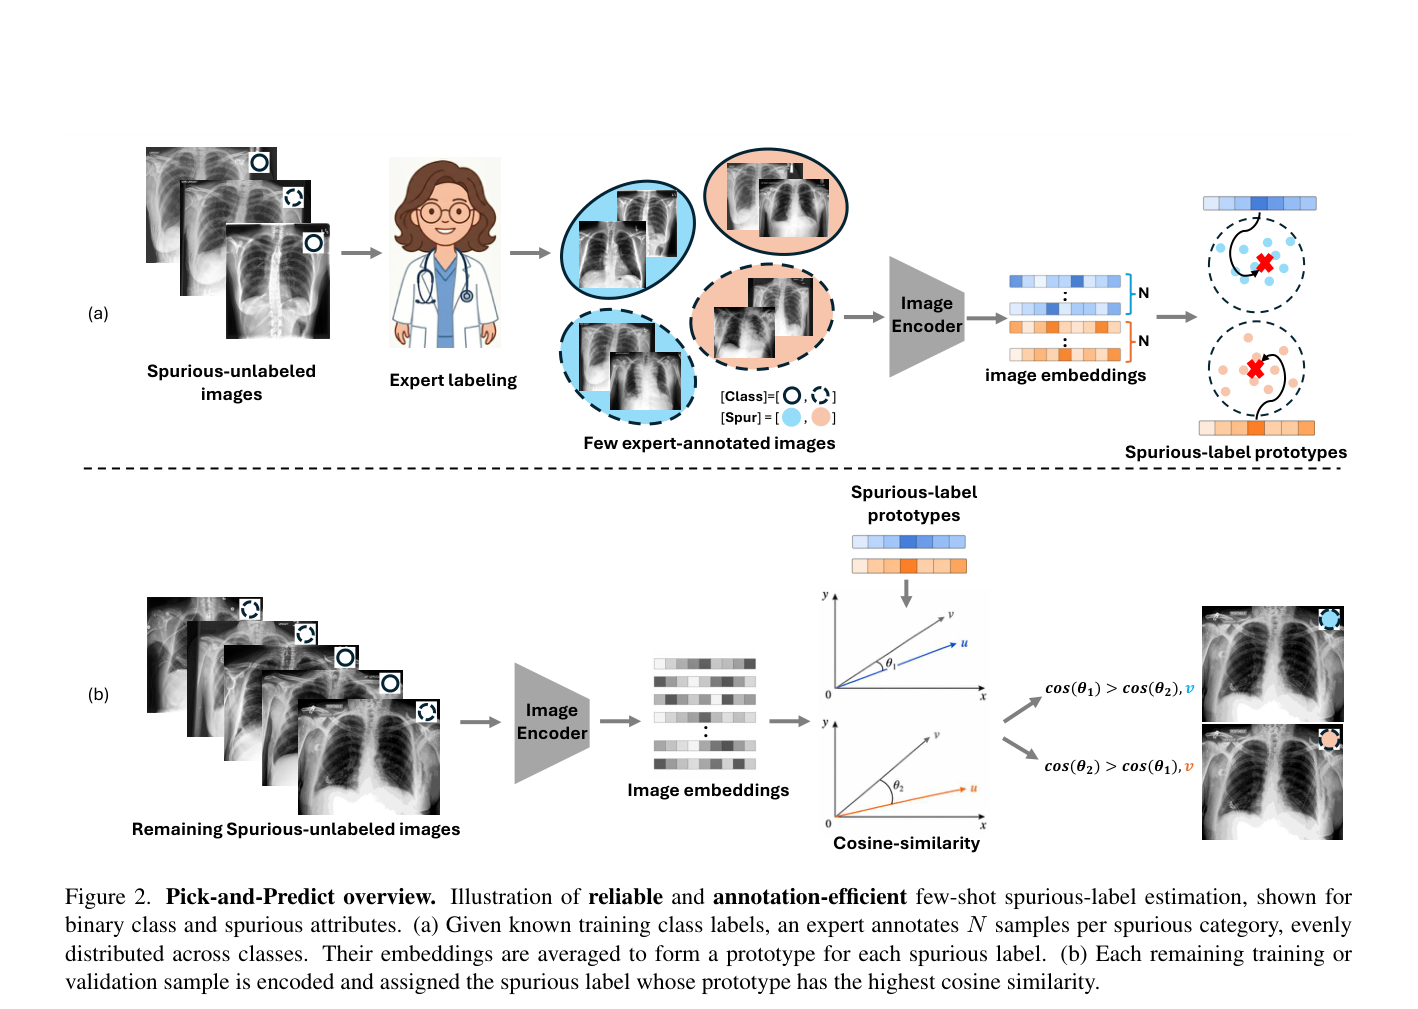
SpurCon 提出一种轻量级框架,通过少样本虚假标签估计(Pick-and-Predict)和加权监督对比损失(WtSupCon)利用元数据(如患者ID)重塑表示几何,以缓解医学影像中的虚假相关性。
分类 CVPR三分钟 标签 CVPR三分钟、 Pick-and-Predict、 SpurCon、 WtSupCon、 人工智能、 深度学习、 计算机视觉 发表评论

幅度与方向解耦:流匹配视频生成免训练加速的新思路

23 8 月, 2026 作者 PengChao
失败案例与直觉

提出MDD方法,通过解耦模型输出的幅度与方向分量,用轻量小模型估计幅度、残差复用提供方向,实现流匹配视频生成模型的免训练加速。

分类 CVPR三分钟 标签 CFG、 CVPR三分钟、 Flow Matching、 MDD、 人工智能、 深度学习、 计算机视觉 发表评论

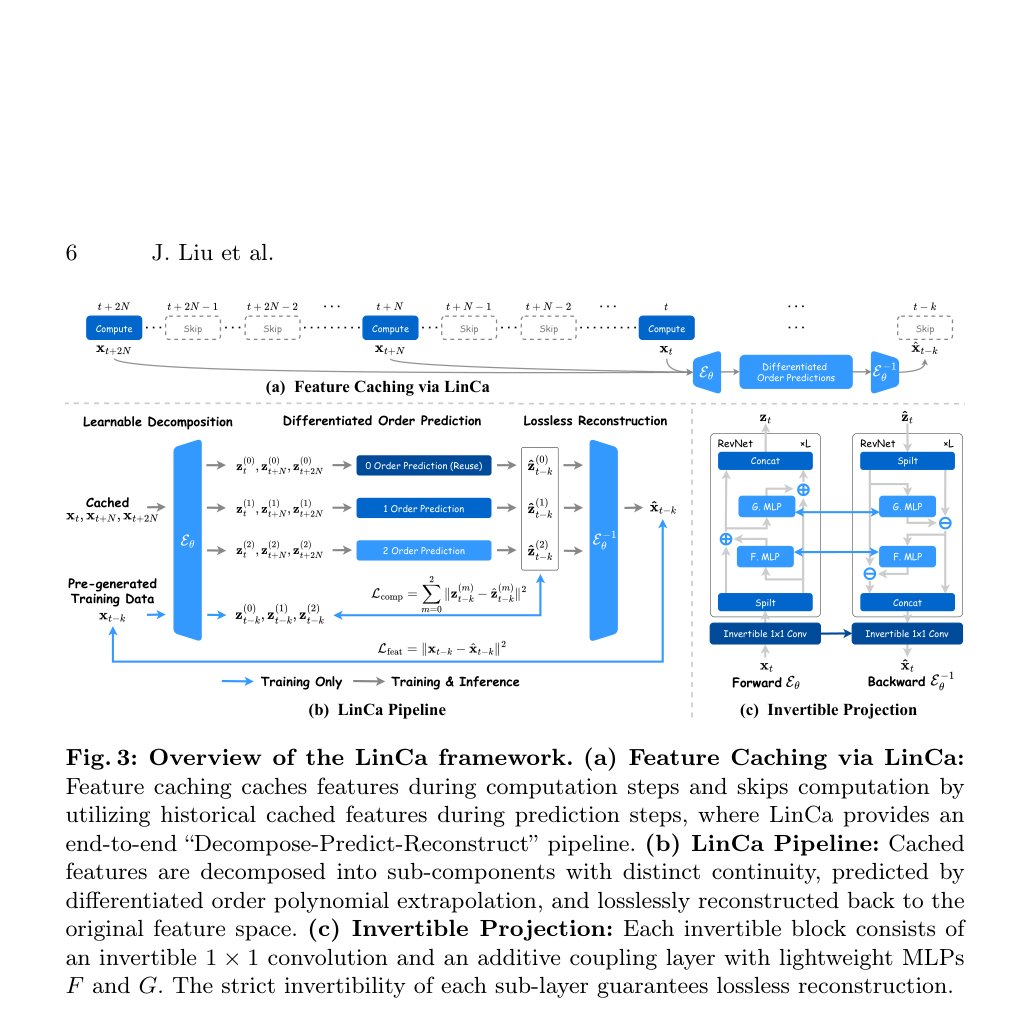
LinCa:为什么特征缓存必须学会“区别对待”不同特征维度

23 8 月, 2026 作者 PengChao
LinCa 的贡献与验证

LinCa 提出基于可学习可逆网络的特征缓存框架,将缓存特征分解为不同连续性的子分量并施加差异化阶数预测,在 FLUX、Qwen-Image、HunyuanVideo 等模型上实现 5–7× 近无损加速。
分类 CVPR三分钟 标签 CVPR三分钟、 FLUX、 LinCa、 Qwen-Image、 人工智能、 深度学习、 计算机视觉 发表评论

DynaForcing:自强制蒸馏为何让数字人“冻住”,又如何解冻

23 8 月, 2026 作者 PengChao
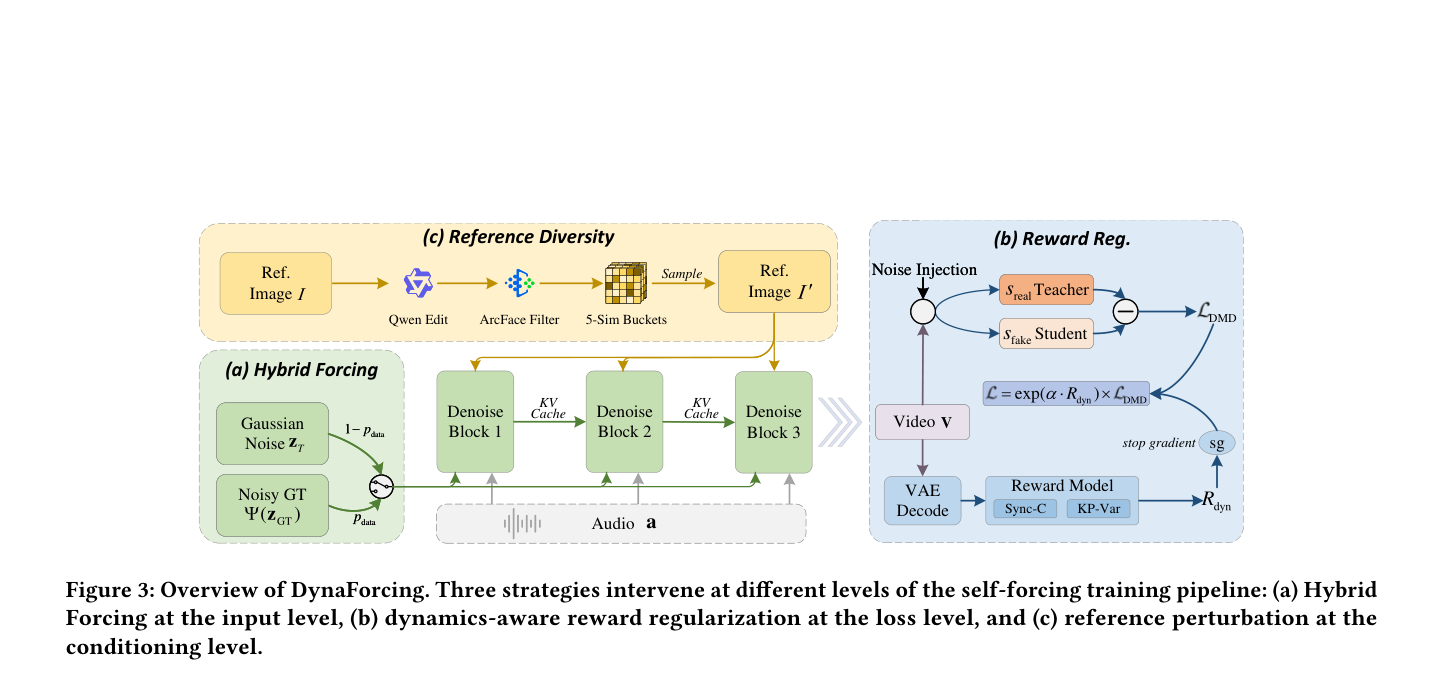
三层干预

提出DynaForcing训练框架,通过混合强制、动态感知奖励正则化和参考图像扰动三种策略,解决自强制蒸馏在流式数字人生成中的动态坍缩问题。
分类 CVPR三分钟 标签 CVPR三分钟、 DynaForcing、 Dynamics-Aware、 Sync-C、 人工智能、 深度学习、 计算机视觉 发表评论

EditBridge:用扩散桥把低分辨率编辑精炼成高保真超高分辨率图像

23 8 月, 2026 作者 PengChao
扩散桥的视角转换

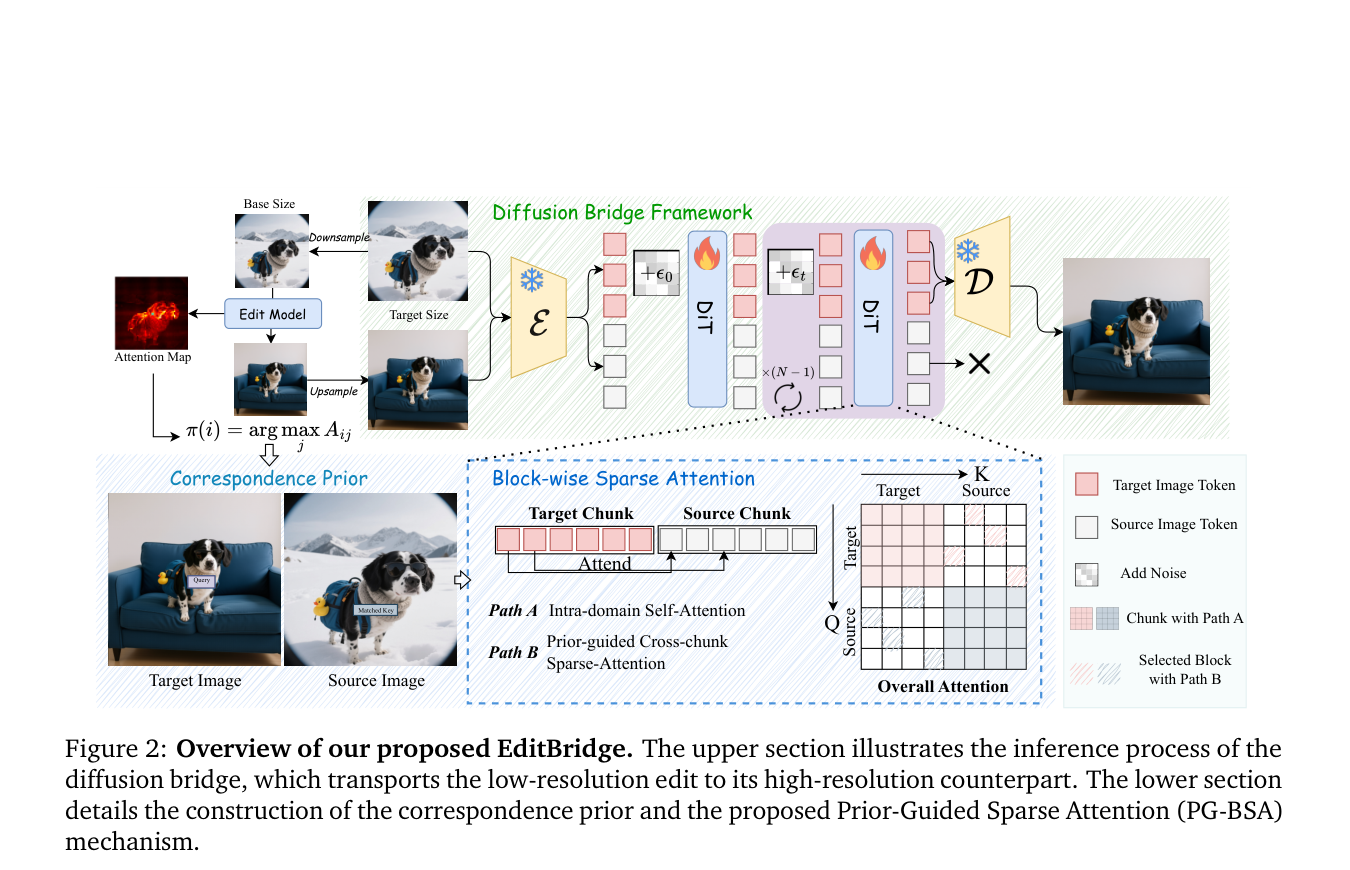
EditBridge 提出基于扩散桥的粗到细框架,利用先验引导的块级稀疏注意力,将低分辨率编辑结果精炼为高保真超高分辨率输出。

分类 CVPR三分钟 标签 CVPR三分钟、 Diffusion Bridge、 EditBridge、 PG-BSA、 人工智能、 深度学习、 计算机视觉 发表评论

PathoArgus:病理问答的准确率,能证明模型真的在看切片吗?

23 8 月, 2026 作者 PengChao
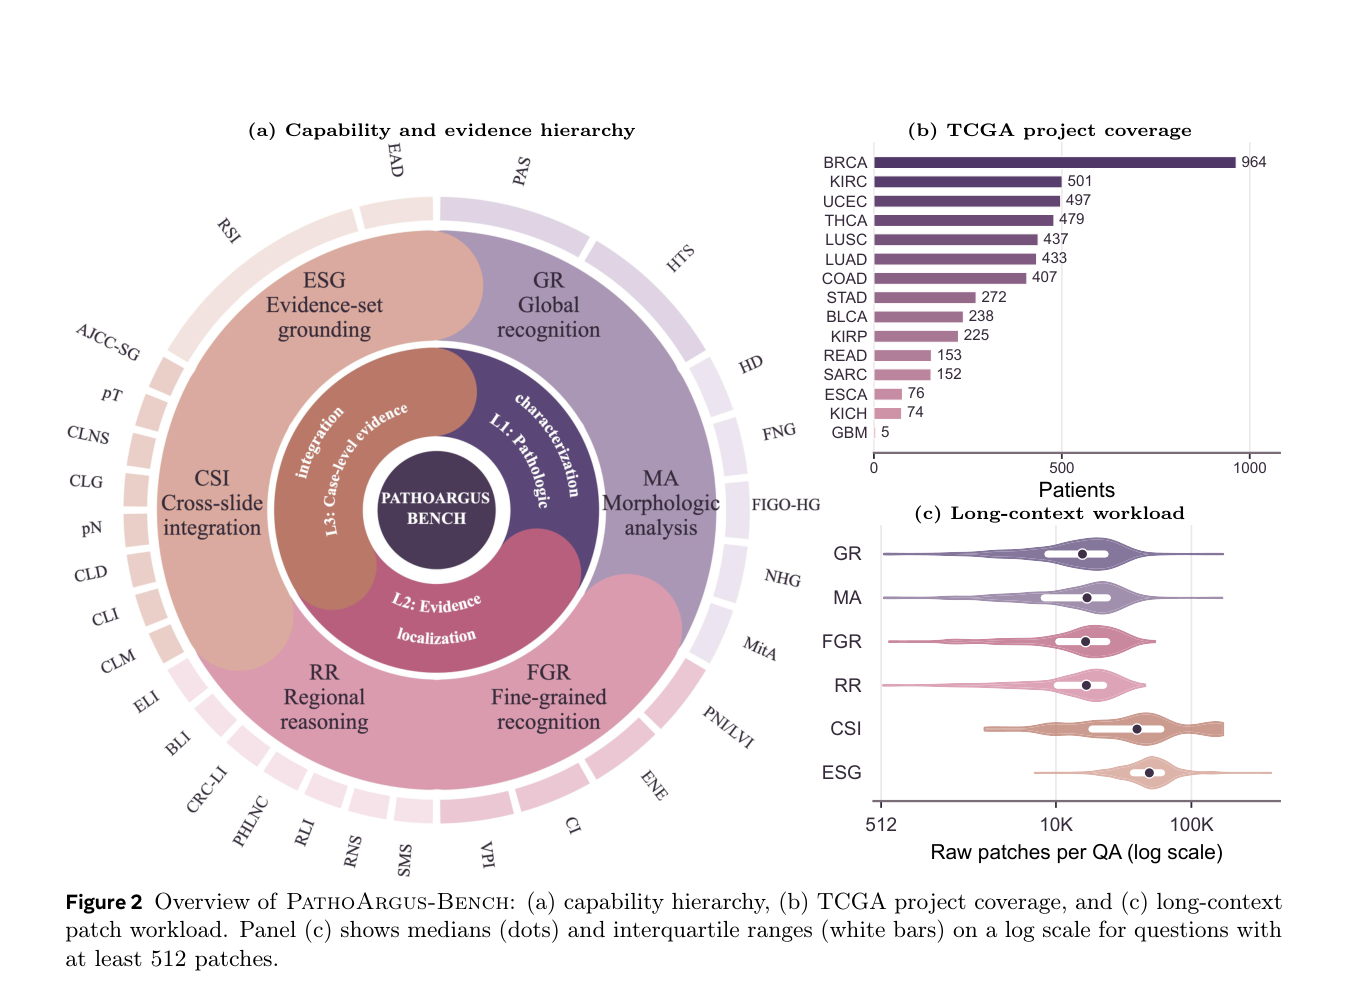
论文代表图:figure-02-p003-01

提出PathoArgus-Bench基准与PathoArgus读取器,系统评估并揭示当前MLLM在全切片病理问答中证据获取与证据响应之间的显著差距。
分类 CVPR三分钟 标签 CVPR三分钟、 MLLM、 PathoArgus、 PathoArgus-Bench、 人工智能、 深度学习、 计算机视觉 发表评论

GS-Voxel:免拟合体素化让百万级3DGS进入生成模型

23 8 月, 2026 作者 PengChao
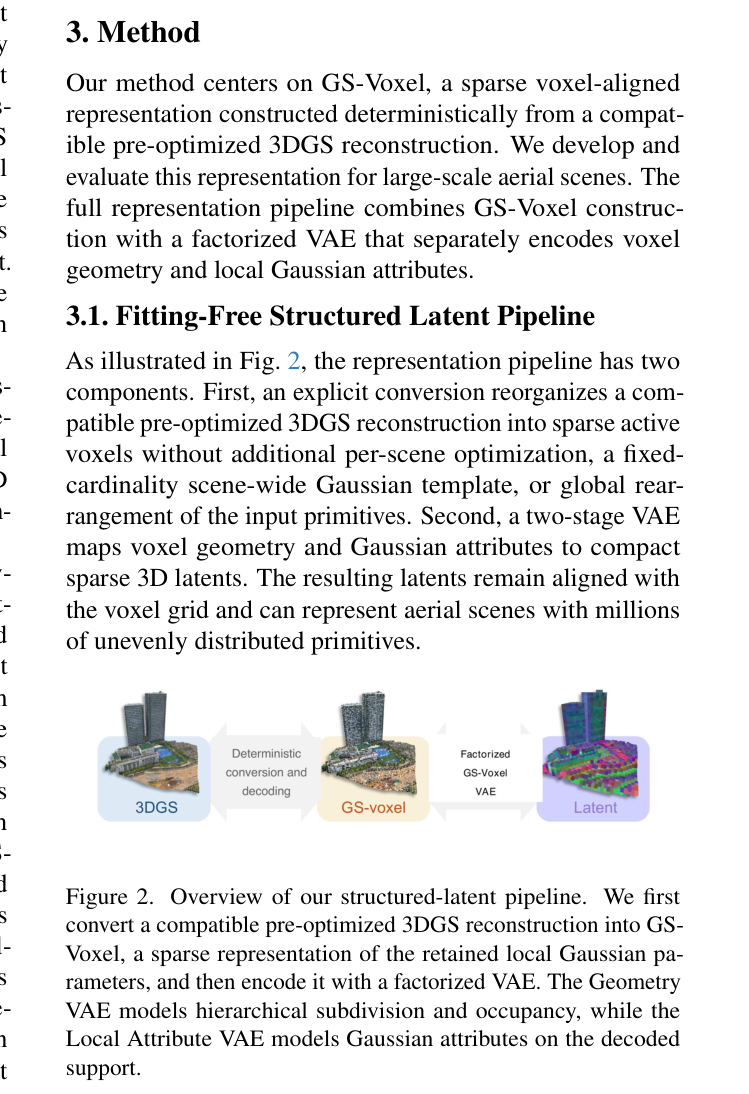
研究缺口:免拟合的结构化转换

GS-Voxel提出一种免拟合的稀疏体素结构化隐表示,将预优化的百万级3DGS重建确定性转换为体素对齐的稀疏latent,并通过分解式VAE和图像条件flow模型实现卫星图条件的大面积航空3DGS场景生成。
分类 CVPR三分钟 标签 3DGS、 CVPR三分钟、 GS-Voxel、 TRELLIS.2、 人工智能、 深度学习、 计算机视觉 发表评论

组合式指令视频编辑:从数据到模型的区域解耦

23 8 月, 2026 作者 PengChao
论文代表图:figure-04-p008-01

提出CoinVE-200K数据集、CoinVE-Bench基准和CoinVE-Edit模型,系统解决多指令组合式视频编辑中指令干扰、区域定位和时序一致性问题。
分类 CVPR三分钟 标签 CoinVE-200K、 CoinVE-Bench、 CoinVE-Edit、 CVPR三分钟、 人工智能、 深度学习、 计算机视觉 发表评论

能力优先,而非语料优先:通用图像生成的数据组织新逻辑

23 8 月, 2026 作者 PengChao
研究缺口

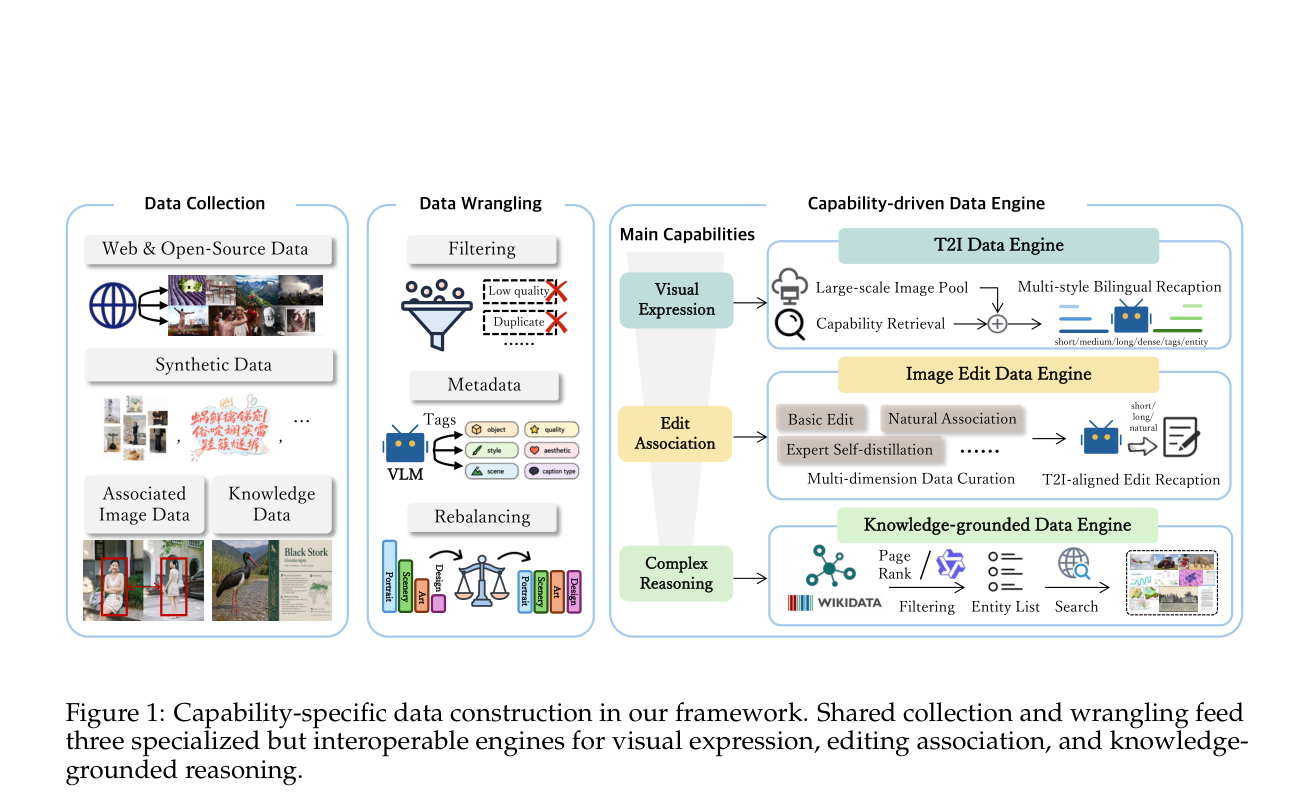
提出以能力为中心的数据基础设施,通过三个专用且互操作的数据引擎与能力对齐的分阶段课程调度,从零训练3B/6B多模态扩散模型。

分类 CVPR三分钟 标签 CVPR三分钟、 I2I、 Qwen3.5-27B、 T2I、 人工智能、 深度学习、 计算机视觉 发表评论
较早文章
较新文章
← 上一页 页面1 … 页面33 页面34 页面35 … 页面75 下一页 →
© 2026 pchao.org • Built with GeneratePress